

A cikk számos módszert vizsgál a lineáris (párhuzamos) regresszió matematikai egyenletének meghatározására.
Az itt vizsgált mindegyik megoldási módszer a legkisebb négyzetek módszerén alapul. Az alábbiakban a módszereket jelölni fogjuk:
- Analitikus megoldás
- Gradiens csökkenés
- Stochasztikus gradiens csökkenés
Mindegyik egyenletmegoldási módszerhez a cikk különféle funkciókat mutat be, amelyek főként a következőkre oszthatók: NumPy és azokra, amelyek számításokhoz alkalmazzák NumPy. Úgy tartják, hogy a megfelelő használat NumPy csökkentheti a számítási költségeket.
A cikkben szereplő összes kód a python 2.7 a Jupyter Notebooknyelven készült. A forráskód és a mintadatok fájlja elérhető a
A cikk főleg a kezdőknek és azoknak szól, akik már kezdik felfedezni a mesterséges intelligencia széleskörű területét — a gépi tanulást.
A tananyag illusztrálásához egy nagyon egyszerű példát használunk.
A példa feltételei
Öt értékünk van, amelyek jellemzik a Y tól X (1. táblázat):
1. táblázat „A példa feltételei”
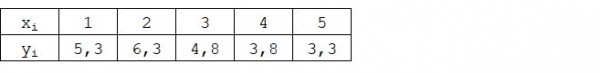
Feltételezzük, hogy az értékek  — az év hónapjai, míg
 — a hónap során elért bevétel. Más szavakkal, a bevétel a hónapoktól függ, és
 — az egyetlen jellemző, amely a bevételre hat.
A példa nem ideális, sem a bevétel és a hónap közötti feltételezett kapcsolat, sem az értékek számát tekintve — nagyon kevés. Azonban ez az egyszerűsítés lehetővé teszi, hogy a kezdők számára érthetően bemutassuk a nehezen elsajátítható anyagot. Emellett az egyszerű számok lehetőséget adnak arra, hogy jelentős erőfeszítés nélkül megoldják a példát „papíron”.
Tegyük fel, hogy a példában bemutatott kapcsolat meglehetősen jól közelíthető egy egyszerű (páros) regresszió matematikai egyenletével:

ahol  — a hónap, amikor a bevételt elérték,
 — a hónaphoz tartozó bevétel,
 és
 — a regressziós egyenes becsült együtthatói.
Megjegyezzük, hogy az együtthatót  gyakran a becsült egyenes dőlésszögének nevezik; azt a mennyiséget jelzi, amellyel megváltozik
 a változás során
 .
Nyilvánvaló, hogy a feladatunk az, hogy a példában olyan együtthatókat találjunk az egyenletben,  és
 , amelyek mellett a havi becsült bevételeink eltérése a valós értékektől, azaz a mintában szereplő számoktól minimális lesz.
Legkisebb négyzetek módszere
A legkisebb négyzetek módszere szerint az eltérést négyzetre kell emelni. Ez a módszer segít elkerülni az eltérések kölcsönös kiegyenlítését, ha ellentétes előjelűek. Például, ha az egyik esetben az eltérés +5 (plusz öt), a másik esetben -5 (mínusz öt), akkor az eltérések összege kölcsönösen el fog tűnni, és 0 (nulla) lesz. Az eltérést nem is szükséges négyzetre emelni, a modul tulajdonságát felhasználva mind az eltérések pozitívvá válnak, és felhalmozódnak. Erről a pontról nem állunk meg részletesen, csak annyit jegyzünk meg, hogy a számítások megkönnyítése érdekében elfogadott a négyzetre emelés.
Így néz ki a képlet, amellyel meghatározzuk az eltérések (hibák) legkisebb négyzetösszegét:

ahol  — ez az igazi válaszok közelítő függvénye (azaz a számított bevétel),
 — ezek az igazi válaszok (a mintában megadott bevétel),
 — ez a minta indexe (az a hónap, amelyben az eltérés meghatározása történik)
Diffrenciáljuk a függvényt, meghatározzuk a parciális deriváltak egyenleteit, és készen állunk az analitikai megoldásra. De először tegyünk egy kis kitérőt arról, hogy mi is a differenciálás, és emlékezzünk a derivált geometriai értelmére.
Differenciálás
A differenciálás a függvény deriváltjának megtalálására szolgáló művelet.
Mire van szükség a deriváltra? A függvény deriváltja a függvény változásának sebességét jellemzi, és megmutatja annak irányát. Ha a derivált adott pontban pozitív, a függvény növekszik, ha fordított esetben — csökken. Minél nagyobb az értéke a deriváltnak, annál gyorsabb a függvény értékeinek változási sebessége, és annál meredekebb a grafikonja.
Például, a Descartes-féle koordináta-rendszerben, a M(0,0) pontban a derivált értéke +25 azt jelenti, hogy az adott pontban, a  jobbra való eltolásakor az érték
 25 egységgel nő. Ez a grafikán úgy néz ki, mint egy meglehetősen meredek emelkedés.
 a megadott ponttól.
Egy másik példa. A derivált értéke -0,1 azt jelenti, hogy egy egységnyi elmozduláskor  csak 0,1 egységgel csökken az érték.
 Ezenkívül, a funkció grafikonján alig észlelhető enyhe lejtés figyelhető meg. Hasonlítsuk ezt a hegyhez, mintha nagyon lassan ereszkednénk le a hegy lankás oldalán, ellentétben az előző példával, ahol nagyon meredek csúcsokat kellett venni :)
Így tehát a függvény differenciálásával  a koefficiensek szerint
 és
 , meghatározzuk az 1. rendű parciális deriváltak egyenleteit. Az egyenletek meghatározása után kapunk egy két egyenletből álló rendszert, amelynek megoldásával olyan koefficienseket tudunk választani,
 és
 , amelyekben a megfelelő deriváltak értékei a megadott pontokban nagyon kis mértékben változnak, míg analitikus megoldás esetén egyáltalán nem változnak. Más szavakkal, a hiba függvény a megtalált koefficiensek mellett minimalizálni fogja, mivel a parciális deriváltak értékei ezekben a pontokban nullák lesznek.
Tehát a deriválási szabályok szerint az 1. rendű parciális derivált egyenlete a koefficiens szerint  a következőképpen alakul:

az 1. rendű parciális derivált egyenlete  a következőképpen alakul:

Az eredményül kapott egyenletrendszernek viszonylag egyszerű analitikus megoldása van:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Mielőtt megoldanánk az egyenletet, először töltsük fel, ellenőrizzük a feltöltés helyességét és formázzuk meg az adatokat.
Adatok feltöltése és formázása
Meg kell jegyezni, hogy az analitikus megoldás, valamint később a gradiens és a stochastic gradiens lépés végett két variációban fogjuk alkalmazni a kódot: a könyvtár használatával NumPy és anélkül, hogy ezt használnánk, ezért a megfelelő adatformázásra szükség van (lásd a kódot).
Adatok feltöltési és feldolgozási kódja
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Vizualizáció.
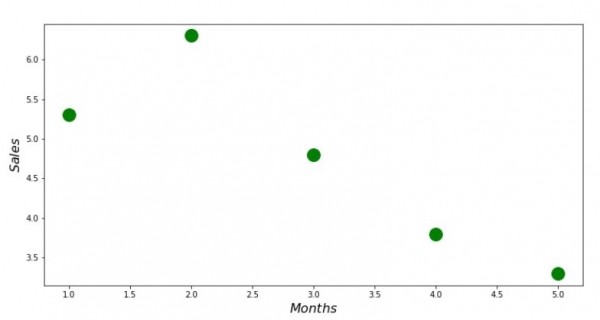
Most, hogy először is feltöltöttük az adatokat, másodszor ellenőriztük a feltöltés helyességét, és végül formáztuk az adatokat, végezzük el az első vizualizációt. Erre a célra gyakran a pairplot könyvtár Seaborn. A példánkban a számok korlátozottsága miatt nincs értelme könyvtárat alkalmazni. Seaborn. Egy szokványos könyvtárat fogunk használni. Matplotlib és csak a szórási diagramot fogjuk megnézni.
A szórási diagram kódja
print '1. ábra "A bevétel havi változása"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Hónapok$', size=16)
plt.ylabel('$Bevétel$', size=16)
plt.show()
1. ábra «A bevétel havi változása»
Analitikus megoldás
A legszokványosabb eszközöket fogjuk használni python és megoldunk egy egyenletrendszert:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Cramer-szabály szerint megtaláljuk a fődeterminánst, valamint a determinánsokat  és
 , majd a determinálokra osztva — megtaláljuk a koefficiens
 , hasonlóan megtaláljuk a koefficiens
 A analitikus megoldás kódja
 .
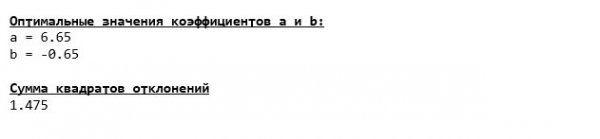
Itt van, amit kaptunk:
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
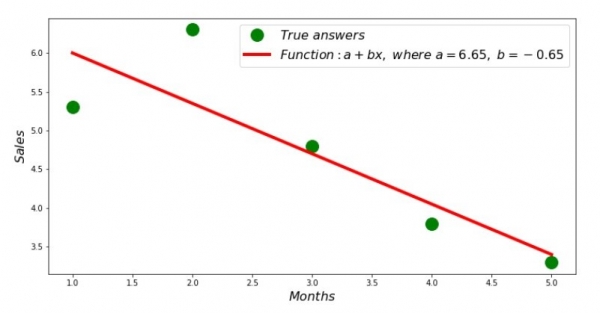
Tehát a koefficiens értékek megtalálva, a négyzetes eltérések összege megállapítva. Rajzoljuk meg a szórási hisztogramon a vonalat a megtalált koefficiensek szerint.
A regressziós vonal kódja
2. ábra «A helyes és számított válaszok»
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
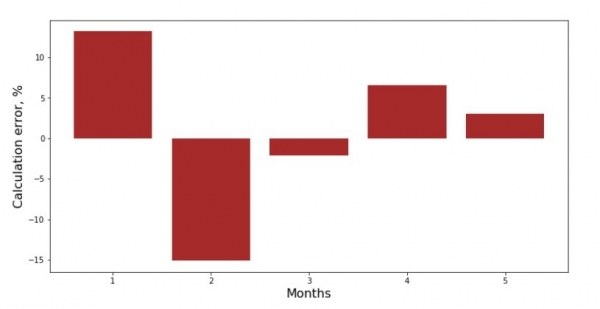
Meg lehet nézni a havi eltérések grafikonját. Esetünkben nem nyerünk belőle jelentős gyakorlati értéket, de kielégítjük a kíváncsiságunkat afelől, hogy milyen jól jellemzi a bevétel havi függését a egyszerű lineáris regresszió egyenlete.
A eltérések grafikonának kódja
3. ábra «Eltérések, %»
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Nem tökéletes, de a feladatunkat elvégeztük.
Írjunk egy függvényt, amely a koefficiensek meghatározására
felhasználja a könyvtárat  és
 , pontosabban — írjunk két függvényt: egyet a pseudoszorzott mátrix használatával (nem ajánlott a gyakorlatban, mert a számítási folyamat bonyolult és instabil), a másikat a mátrix egyenlet használatával. NumPyA analitikus megoldás kódja (NumPy)
Hasonlítsuk össze az időt, amelyet a koefficiensek meghatározására szántunk
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
, a 3 bemutatott mód szerint.  és
 A számítási idő kódja
print ' 33[1m' + ' 33[4m' + "A NumPy könyvtár használata nélkül a koefficiens számításának végrehajtási ideje:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "A pszeudo-inverz mátrix használatával a koefficiens számításának végrehajtási ideje:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "A mátrixos egyenlet használatával a koefficiens számításának végrehajtási ideje:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)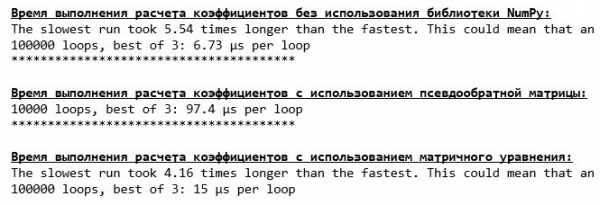
Kis adathalmaz esetén a saját készítésű funkció dominál, amely a Kramer-módszer segítségével találja meg a koefficienseket.
Most áttérhetünk más módszerekre a koefficiensek meghatározásához.  és
 .
Gradiens csökkenés
Először is határozzuk meg, mi is az a gradiens. Egyszerűen fogalmazva, a gradiens egy szakasz, amely a funkció maximális növekedési irányát mutatja. Analógiával élve, ahogyan a hegyre való felmászás során, ahová a gradiens mutat, ott van a legmeredekebb emelkedés a csúcs felé. Ha már a hegyről van szó, emlékezzünk, hogy valójában a legmeredekebb lejtőt keresik, hogy minél gyorsabban elérjük a mélypontot, tehát a minimumot — ott, ahol a funkció nem nő és nem csökken. Ezen a helyen a derivált zérus. Következésképpen nem gradiensre, hanem anti-gradiensre van szükség. Az anti-gradiens megtalálásához csak a gradienst kell megszorozni -1 (mínusz egy).
Fontos megjegyezni, hogy a funkcióknak több minimuma is lehet, és ha a javasolt algoritmus szerint leereszkedünk az egyikbe, lehet, hogy nem találunk másik minimumot, amely esetleg alacsonyabban van, mint az általa talált. Ne aggódjunk, ez nekünk nem fog gondot okozni! Az esetünkben egyetlen minimumról van szó, mivel a funkciónk  a grafikonon egy hagyományos parabolát képvisel. És ahogyan mindannyian tudjuk a középiskolai matematikai tananyagból – a parabolának csak egy minimuma van.
Miután tisztáztuk, hogy mire van szükségünk a gradiens segítségével, illetve hogy a gradiens egy szakasz, tehát egy vektor, amelynek meghatározott koordinátái vannak, amelyek pontosan azok a koefficiensek  és
 megvalósíthatjuk a gradiens csökkenést.
A futtatás előtt javaslom, hogy olvassunk el néhány mondatot a csökkentési algoritmusról:
- A koefficiensek koordinátáit pszeudo-véletlenszerűen határozzuk meg.
 és . A példánkban a nullához közeli együtthatókat fogjuk meghatározni. Ez elterjedt gyakorlat, azonban minden esetben lehet saját megoldás.
- A koordinátából kivonjuk az első rendű parciális derivált értékét a pontban . Így, ha a derivált pozitív, akkor a függvény növekszik. Tehát a derivált értékének kivonásával az növekedés irányával ellentétesen, tehát a csökkenés irányába haladunk. Ha a derivált negatív, akkor a függvény ebben a pontban csökken, és a derivált értékének kivonásával a csökkenés irányába haladunk.
- Hasonló műveletet végzünk a koordinátával : kivonjuk a parciális derivált értékét a pontban .
- Annak érdekében, hogy ne ugorjunk át a minimumon, és ne szaladjunk el a távoli űrbe, be kell állítanunk a lépés méretét a lejtés irányába. Összességében egy egész cikket lehetne írni arról, hogyan helyesebb beállítani a lépést és hogyan változtatni azt a leszállás során, hogy minimalizáljuk a számítási költségeket. De most egy kicsit más feladatunk van, és tudományos "tüzelés" módszerével, vagy ahogy a köznyelvben mondják, empirikus úton állapítjuk meg a lépés méretét.
- Miután a megadott koordinátákból és kivontuk a derivált értékeket, új koordinátákat kapunk és . Ezután újabb lépést teszünk (kivonás), már a kiszámított koordinátákból. Így a ciklus újra és újra elindul, amíg el nem érjük a kívánt konvergenciát.
 és
 . A példánkban a nullához közeli együtthatókat fogjuk meghatározni. Ez elterjedt gyakorlat, azonban minden esetben lehet saját megoldás.
 kivonjuk az első rendű parciális derivált értékét a pontban
 . Így, ha a derivált pozitív, akkor a függvény növekszik. Tehát a derivált értékének kivonásával az növekedés irányával ellentétesen, tehát a csökkenés irányába haladunk. Ha a derivált negatív, akkor a függvény ebben a pontban csökken, és a derivált értékének kivonásával a csökkenés irányába haladunk.
 : kivonjuk a parciális derivált értékét a pontban
 .
 és
 kivontuk a derivált értékeket, új koordinátákat kapunk
 és
 . Ezután újabb lépést teszünk (kivonás), már a kiszámított koordinátákból. Így a ciklus újra és újra elindul, amíg el nem érjük a kívánt konvergenciát.
Kész! Most már készen állunk, hogy elinduljunk a Mariana-árok legmélyebb szurdokának felkutatására. Kezdjük el.
A gradienslesiklási kód
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print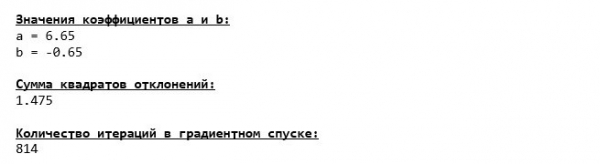
Mélyen merültünk a Mariana-árok fenekére, ahol ugyanazokat az együtthatóértékeket találtuk  és
 , amire alapvetően számítani is lehetett.
Tegyük meg még egy merülést, de ezúttal a mélytengeri járművünkben más technológiák lesznek, nevezetesen a NumPy.
Gradienslesiklási kód (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print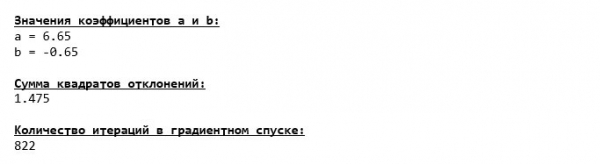
Az együttható értékek  és
 változatlanok.
Nézzük meg, hogyan változott a hiba a gradienslesiklás során, vagyis hogyan változott a négyzetes eltérések összege minden lépésnél.
A négyzetes eltérések összegének grafikája
print 'Grafikon №4 "A négyzetes eltérések összege lépésről lépésre"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Lépések (iteráció)', size=16)
plt.ylabel('A négyzetes eltérések összege', size=16)
plt.show()
4. ábra "A négyzetes eltérések összege a gradiens csökkenésnél"
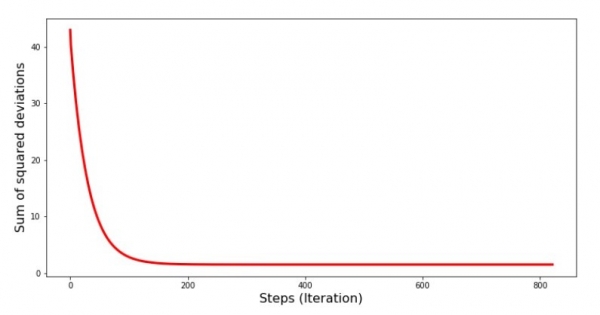
A grafikonon láthatjuk, hogy minden lépésnél csökken a hiba, és egy idő után gyakorlatilag vízszintes vonalat figyelhetünk meg.
Végül nézzük meg a kód futási idejének különbségét:
A gradiens csökkenés futási idejének meghatározására szolgáló kód
print ' 33[1m' + ' 33[4m' + "A gradiens csökkenés futási ideje NumPy könyvtár használata nélkül:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "A gradiens csökkenés futási ideje NumPy könyvtár használatával:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)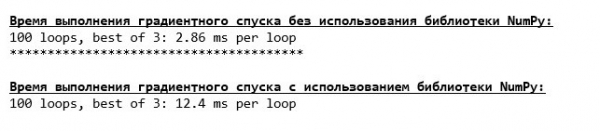
Lehet, hogy valamit rosszul csinálunk, de ismételten a "kézzel írt" egyszerű függvény, amely nem használja a könyvtárat, NumPy a könyvtárat használó függvényt megelőzi a futási idő tekintetében. NumPy.
De nem állunk meg, hanem tovább lépünk a lineáris regresszió egy másik izgalmas megoldásának tanulmányozása felé. Üdvözöljük!
Stochasztikus gradiens csökkenés
Ahhoz, hogy jobban megértsük a sztochasztikus gradiens csökkenés működésének elvét, érdemes meghatározni a különbségeit a normál gradiens csökkenéshez képest. A gradiens csökkenés esetén, a derivált egyenletekben  és
 a mintában található összes jellemző és valós válasz értékeinek összegét használtuk (azaz az összes
 és
 ). A sztochasztikus gradiens csökkenés esetén nem fogunk minden mintában lévő értéket felhasználni, hanem ehelyett véletlenszerűen választunk ki egy úgynevezett mintavételi indexet, és annak értékeit használjuk.
Például, ha az index 3 (három) számot határoz meg, akkor az értékeket vesszük  és
 , majd behelyettesítjük az értékeket a derivált egyenletekbe, és meghatározzuk az új koordinátákat. Ezután, miután meghatároztuk a koordinátákat, újra véletlenszerűen meghatározzuk a mintavételi indexet, a megfelelő értékeket behelyettesítjük a részleges derivált egyenletekbe, és újra meghatározzuk a koordinátákat
 és
 , stb. a konvergencia zöld jelzéséig. Első ránézésre úgy tűnhet, hogy ez hogyan működhet, de működik. Igaz, hogy nem minden lépésnél csökken a hiba, de a tendencia kétségtelenül megvan.
Mik az előnyei a sztochasztikus gradienscsökkenésnek a normál módszerhez képest? Ha a mintavételi méretünk nagyon nagy, és tízezrekben mérjük, sokkal egyszerűbb, ha például véletlenszerűen választunk ezer értéket közülük, mint az egész mintát feldolgozni. Ilyen esetben indul a sztochasztikus gradienscsökkenés. A mi esetünkben persze nem fogunk nagy különbséget észlelni.
Nézzük a kódot.
Kód a sztochasztikus gradienscsökkenéshez
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])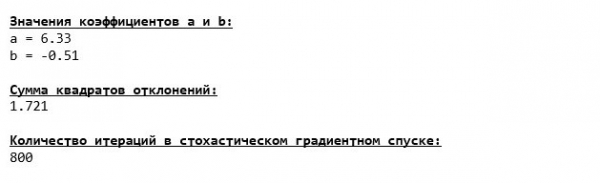
Nézzük alaposan a koefficienseket, és azon kapjuk magunkat, hogy "Hogyan lehetséges ez?". Más értékeket kaptunk a koefficiensekből.  és
 . Lehet, hogy a sztochasztikus gradienscsökkenés megtalálta a rókaegyenlet optimálisabb paramétereit? Sajnos nem. Elég ránézni a négyzetes eltérések összegére, és látni, hogy az új koefficiensértékekkel a hiba nagyobb. Ne siessünk az elkeseredéssel. Készítsünk grafikont a hiba változásáról.
Kód a négyzetes eltérések összegének grafikonjához a sztochasztikus gradienscsökkenés során
print 'Grafikon №5 "A négyzetes eltérések összege lépésről lépésre"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Lépések (Iteráció)', size=16)
plt.ylabel('A négyzetes eltérések összege', size=16)
plt.show()
Grafikon №5 „A négyzetes eltérések összege a sztochasztikus gradienscsökkenés során”
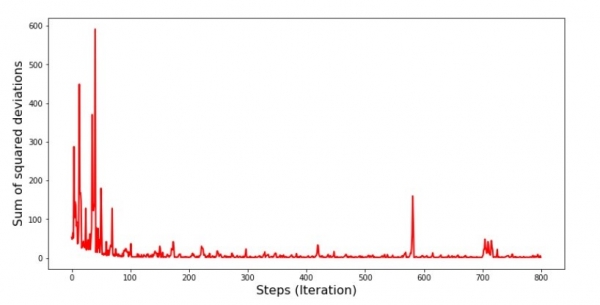
A grafikonra nézve minden a helyére kerül, és most mindent kijavítunk.
Tehát mi történt? A következő történt. Amikor véletlenszerűen választunk egy hónapot, az algoritmusunk pontosítani próbálja a bevételi hiba csökkentését az adott hónapra. Ezután választunk egy másik hónapot, és megismételjük a számítást, de most a második választott hónapra csökkentjük a hibát. Most emlékezzünk vissza, hogy az első két hónap lényegesen eltér a sima lineáris regresszió egyenletétől. Ez azt jelenti, hogy amikor bármelyik hónapot választjuk, a kérdéses hónap hibájának csökkentésével az algoritmusunk jelentősen növeli a hiba mértékét az egész mintában. De mit tegyünk? A válasz egyszerű: csökkentsük a csökkenés lépését. Hiszen ha csökkentjük a csökkenés lépését, a hiba sem fog „ugrálni” felfelé és lefelé. Valójában a hiba ugrálása nem fog megszűnni, de nem lesz ennyire heves :) Ellenőrizzük.
Kód az SGD futtatásához kisebb lépéssel
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()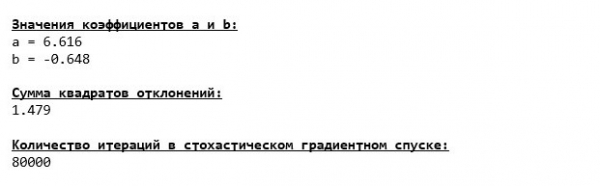
Grafikon №6 „A négyzetes eltérések összege a sztochasztikus gradienscsökkenés alatt (80 ezer lépés)”
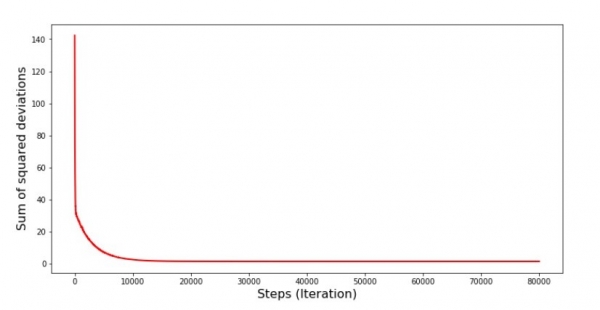
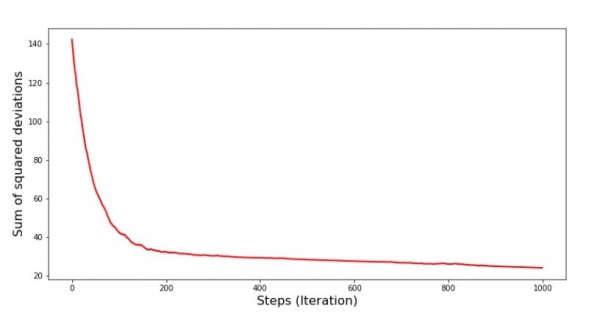
A koefficiens értékei javultak, de még mindig nem tökéletesek. Elméletileg így lehetne javítani. Válasszunk például az utolsó 1000 iterációból olyan koefficiens értékeket, amelyeknél a hiba minimális. Igaz, ehhez még az ön koefficiens értékeket is fel kellene jegyezni. Ezt azonban nem fogjuk megtenni, inkább figyeljük meg a grafikont. Zökkenőmentesnek tűnik, és úgy tűnik, hogy a hiba fokozatosan csökken. Valójában azonban ez nem így van. Nézzük meg az első 1000 iterációt, és hasonlítsuk össze őket az utolsókkal.
Kód a SGD grafikonhoz (első 1000 lépés)
print '7. ábra "A négyzetes eltérések összege lépésről lépésre. Első 1000 iteráció"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Lépések (Iteráció)', size=16)
plt.ylabel('A négyzetes eltérések összege', size=16)
plt.show()

print '7. ábra "A négyzetes eltérések összege lépésről lépésre. Utolsó 1000 iteráció"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Lépések (Iteráció)', size=16)
plt.ylabel('A négyzetes eltérések összege', size=16)
plt.show()
7. ábra «A négyzetes eltérések összege SGD (első 1000 lépés)»
8. ábra «A négyzetes eltérések összege SGD (utolsó 1000 lépés)»
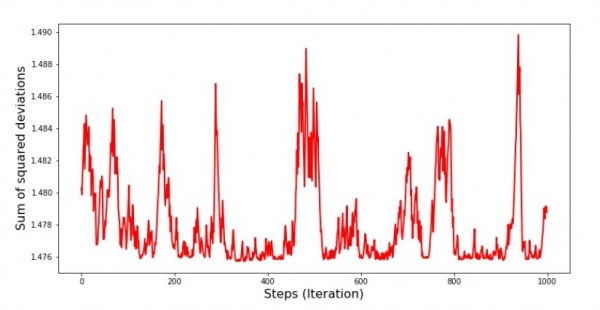
A kezdeti lépéseknél viszonylag egyenletes és meredek hiba csökkenést figyelhetünk meg. Az utolsó iterációk során azt látjuk, hogy a hiba körülbelül 1,475-ös érték körül ingadozik, és néhány pillanatban még ezzel az optimális értékkel is megegyezik, de aztán mégis visszaugrik… Ismétlem, rögzíthetjük a koefficiens értékeket  és
 , majd kiválaszthatjuk azokat, ahol a hiba minimális. Viszont komolyabb problémánk merült fel: 80 ezer lépést kellett megtennünk (lásd a kódot), hogy olyan értékeket kapjunk, amelyek közel állnak az optimálishoz. Ez pedig már ellentmond azzal az ötlettel, hogy a számítási időt meg kellene spórolni a stochasztikus gradiens csökkenés során a gradienshez képest. Mit lehetne javítani és fejleszteni? Könnyen észlelhető, hogy az első iterációkban magabiztosan lefelé haladunk, ezért célszerű lenne az első lépésekben nagyobb lépést tartani, és a haladás során fokozatosan csökkenteni a lépés mértékét. Ezt azonban nem fogjuk megtenni ebben a cikkben — már így is elnyújtottuk. Az érdeklődők pedig gondolkodhatnak, hogyan valósíthatják meg ezt, nem nehéz 🙂
Most hajtsuk végre a stochasztikus gradiens csökkentést a könyvtár használatával NumPy (és nem fogunk megbotlan erősebb köveken, amelyeket korábban azonosítottunk)
Kód a sztochasztikus gradienscsökkenéshez (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print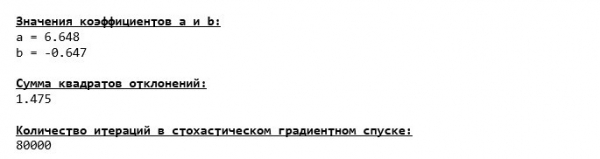
Az értékek majdnem ugyanazok lettek, mint a könyvtár használata nélkül NumPy. Ez azonban logikus.
Nézzük meg, mennyi időt vett igénybe a sztochasztikus gradienscsökkenés.
Kód a sztochasztikus gradienscsökkenés számítási idejének meghatározásához (80 ezer lépés)
print ' 33[1m' + ' 33[4m' +
"A sztochasztikus gradienscsökkenés végrehajtási ideje a NumPy könyvtár használata nélkül:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"A sztochasztikus gradienscsökkenés végrehajtási ideje a NumPy könyvtár használatával:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)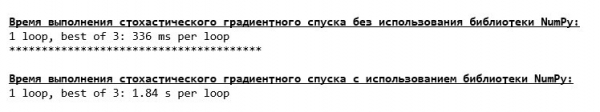
Minél beljebb megyünk az erdőbe, annál sötétebbek a felhők: ismét a "saját kézi" képlet mutatja a legjobb eredményt. Mindez arra késztet minket, hogy gondolkozzunk, léteznek-e még kifinomultabb módszerek a könyvtár használatára NumPy, amelyek valóban felgyorsítják a számítási műveleteket. Erről a cikkben már nem fogunk megtudni. Lesz mit átgondolni a szabadidőnkben :)
Összefoglalva
Mielőtt összefoglalnánk, szeretnénk válaszolni egy kérdésre, amely valószínűleg felmerült kedves olvasónkban. Miért is van szükség ezekre a "trükkökre" a csökkentésekhez, miért kell felfelé és lefelé másznunk (főleg lefelé), hogy megtaláljuk a rég áhított minimumot, amikor a kezünkben van egy ilyen erős és egyszerű eszköz, mint az analitikai megoldás, ami azonnal teleportál minket a megfelelő helyre?
A válasz erre a kérdésre nyilvánvaló. Jelenleg egy nagyon egyszerű példát vizsgáltunk, ahol az igazi válasz  egy mutatótól függ
 . Ilyen helyzetekkel az életben ritkán találkozunk, ezért képzeljük el, hogy két, harminc, ötven vagy annál több mutatónk van. Ezen kívül ezer, vagy akár tízezer értéket adunk minden egyes mutatóhoz. Ebben az esetben az analitikai megoldás nem biztos, hogy kiállja a próbát és hibához vezet. Ezzel szemben a gradienscsökkenés és annak változatai lassan, de biztosan közelítenek a célhoz — a függvény minimumához. A sebesség miatt ne aggódj — biztosan még egyszer átbeszéljük azokat a módszereket, amelyek lehetővé teszik számunkra a lépések hosszának (tehát a sebességnek) beállítását és szabályozását.
Most pedig itt a rövid összegzés.
Először is, remélem, hogy a cikkben bemutatott anyag segíti a kezdő "adat tudósokat" abban, hogy megértsék, hogyan oldják meg az egyszerű (és nemcsak) lineáris regresszió egyenleteit.
Másodszor, több megoldási módot is megvizsgáltunk az egyenlet megoldására. Most, a helyzettől függően, választhatjuk azt, amelyik a legjobban megfelel a feladat megoldásához.
Harmadszor, láthattuk a további beállítások erejét, különösen a gradienslés hosszát. Ezt a paramétert nem szabad figyelmen kívül hagyni. Ahogy korábban említettem, a számítási költségek csökkentése érdekében a lépés hosszát az ereszkedés során érdemes megváltoztatni.
Negyedszer, a mi esetünkben a "saját" funkciók a legjobb számítási időt mutatták. Valószínűleg ez a könyvtár lehetőségeinek nem túl szakszerű alkalmazásának tudható be. NumPy. De akármennyire is van ez, a következtetés egyértelmű. Egyrészt néha érdemes megkérdőjelezni a megszokott véleményeket, másrészt nem mindig érdemes bonyolítani a dolgokat — éppen ellenkezőleg, néha a legegyszerűbb megoldás hatékonyabbnak bizonyul. Mivel a célunk az volt, hogy három megközelítést vizsgáljunk az egyszerű lineáris regresszió egyenletének megoldására, a "saját" funkciók elegendőnek bizonyultak.
Irodalom (vagy valami ilyesmi)
1. Lineáris regresszió
2. Legkisebb négyzetek módszere
3. Derivált
4. Gradiens
5. Gradienslesés
6. NumPy könyvtár
Forrás: habr.com
