

Megcsináltuk!
"A kurzus célja, hogy felkészítsen titeket a technikai jövőtökre."
 Helló, Habr. Emlékeztek arra a nagyszerű cikkre? (+219, 2588 a kedvencek között, 429k olvasás)?
Hát, a Hammingnél (igen, igen, önellenőrző és önkorrektív ) van egy egész , amelyet az előadásain alapul írtak. Fordítjuk, mert a pasi tudja, miről beszél.
Ez a könyv nem csak az IT-ről szól, hanem a hihetetlenül briliáns emberek gondolkodásmódjáról. "Ez nem csak a pozitív gondolkodás megterhelése; a könyvben leírtak olyan körülményeket, amelyek növelik a nagy teljesítmény elérésének esélyeit."
A fordítást köszönjük Andrej Pahomovnak.
Az információ elméletét C. E. Shannon dolgozta ki az 1940-es évek végén. A Bell Laboratories vezetősége ragaszkodott ahhoz, hogy ezt nevezze "Kapcsolat elméletének", mivel ez sokkal pontosabb elnevezés. Nyilvánvaló okokból az "Információ elmélete" cím sokkal nagyobb hatást gyakorol a közönségre, ezért Shannon ezt választotta, és ez ismert számunkra a mai napig. Maga a név azt sugallja, hogy az elmélet az információval foglalkozik, ami fontos, mivel egyre mélyebbre hatolunk az információs korszakba. Ebben a fejezetben néhány alapvető következtetést érintek e elméletből, és intuícionális bizonyítékokat nyújtok néhány egyes tételekhez, hogy megértsétek, valójában mi is az "Információ elmélete", hol lehet alkalmazni, és hol nem.
Először is, mi is az "információ"? Shannon az információt a bizonytalansággal azonosítja. A valószínűség eseményének negatív logaritmusát választotta az esemény bekövetkezésekor kapott információ mennyiségi mértékeként, amelyet p valószínűséggel tapasztalsz. Például, ha azt mondom, hogy Los Angelesben ködös az időjárás, akkor p közel van az 1-hez, ami lényegében nem ad sok információt. De ha azt mondom, hogy júniusban Monterreyban esik az eső, akkor ebben az üzenetben lesz bizonytalanság, és több információt fog tartalmazni. A biztos esemény nem tartalmaz információt, mivel log 1 = 0.
Részletesebben is megvizsgáljuk ezt. Shannon azt gondolta, hogy az információ mennyiségi mértéke egy folyamatos függvény kell, hogy legyen az esemény valószínűségének p függvényében, és független események esetén additívnak kell lennie – az információ mennyisége, amely két független esemény bekövetkezésekor keletkezik, egyeznie kell a közös esemény bekövetkezésekor keletkező információ mennyiségével. Például a kockadobás és a pénzfeldobás eredményét általában független eseményeknek tekintik. Fordítsuk le a fentieket matematikai nyelvre. Ha I(p) az információ mennyisége, amely egy p valószínűségű eseményben található, akkor egy két független esemény x (p1 valószínűséggel) és y (p2 valószínűséggel) közös eseményének esetén azt kapjuk,
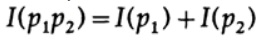
(x és y független események)
Ez a Cauchy-féle funkcionális egyenlet, amely minden p1 és p2 esetén igaz. E funkcionális egyenlet megoldásához tegyük fel, hogy
p1 = p2 = p,
ez adja
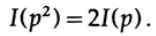
Ha p1 = p2 és p2 = p, akkor
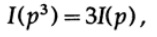
stb. E folyamat kiterjesztésével, a exponenciálisakra alkalmazott standard módszer segítségével, minden racionális számra m / n, a következő érvényes:
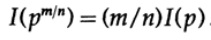
A feltételezett információs mérték folytonosságából következik, hogy a logaritmus függvény az egyetlen folytonos megoldása a Cauchy-féle funkcionális egyenletnek.
Az információ elméletében általában a logaritmus alapját 2-nek tekintjük, így a bináris választás pontosan 1 bit információt tartalmaz. Következésképpen az információt a következő képlettel mérjük:
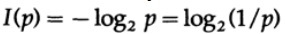
Álljunk meg egy pillanatra, és nézzük meg, mi történt az előbb. Először is, még nem adtunk definíciót az "információ" fogalmának, csak az információ mennyiségi mértékének képletét határoztuk meg.
Másodszor, ez a mérték a bizonytalanságtól függ, és bár elég jól alkalmazható gépek számára — például telefonrendszerek, rádió, televízió, számítógépek stb. — nem tükrözi a normális emberi hozzáállást az információhoz.
Harmadsorban, ez egy relatív mérték, amely a tudásod aktuális állapotától függ. Ha egy "véletlenszámok" áramlására nézel egy véletlenszám-generátorból, azt feltételezed, hogy minden következő szám bizonytalan, de ha tudod a "véletlenszámok" kiszámításának képletét, a következő szám ismertté válik, és így nem tartalmaz információt.
Így tehát Shannon által a információra adott meghatározás sok esetben megfelel a gépeknek, de úgy tűnik, nem felel meg az emberi értelemnek. Éppen ezért az "Információelméletet" "Kapcsolatelméletnek" kellett volna nevezni. Mindazonáltal már túl késő van a meghatározások megváltoztatására (amelyek lehetővé tették, hogy a teória kezdeti népszerűséget nyerjen, és amelyek még mindig azt a benyomást keltik, hogy ez a teória "információval" foglalkozik), ezért kénytelenek vagyunk belenyugodni, de közben világosan meg kell értened, hogy mennyire eltér Shannon információmeghatározása a hétköznapi jelentésétől. Shannon információja valami teljesen mással foglalkozik, nevezetesen a bizonytalansággal.
Ezen kell elgondolkodnod, amikor bármilyen terminológiát javasolsz. Mennyire egyezik a javasolt meghatározás, például Shannon által adott információmeghatározás a te eredeti ötleteiddel, és mennyire tér el attól? Szinte nincs olyan kifejezés, amely pontosan tükrözné a korábbi elképzelésedet, de végső soron az általad használt terminológia tükrözi a koncepció tartalmát, ezért valaminek a formális megfogalmazása világos meghatározásokkal mindig csekély zajt hoz maga után.
Vizsgáljuk meg a rendszert, amelynek ábécéje q szimbólumokból áll, valószínűségekkel pi. Ekkor az információ átlagos mennyisége a rendszerben (várható értéke) egyenlő:
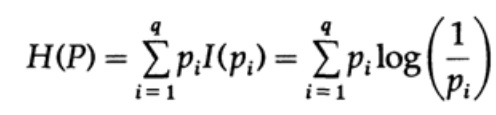
Ezt a rendszert a {pi} valószínűségi eloszlás entrópiájának nevezzük. Az „entrópia” kifejezést használjuk, mert ugyanez a matematikai forma jelenik meg a termodinamikában és a statisztikus mechanikában. Éppen ezért az „entrópia” kifejezés körül egyfajta fontosság aura alakul ki, amely végső soron nem indokolt. Az azonos matematikai forma rögzítése nem jelenti azt, hogy a szimbólumokat azonosan értelmezzük!
A valószínűségi eloszlás entrópiája fontos szerepet játszik a kódolás elméletében. A Gibbs egyenlőtlenség két különböző pi és qi valószínűségi eloszlás között e teória egyik fontos következménye. Tehát be kell bizonyítanunk, hogy
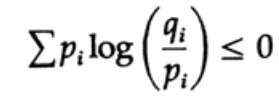
A bizonyítás a nyilvánvaló ábrára, a 13.I. számú ábrára támaszkodik, amely megmutatja, hogy
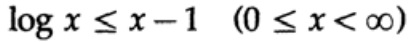
és az egyenlőség csak x = 1 esetén érhető el. Alkalmazzuk az egyenlőtlenséget a bal oldal összes tagjára:
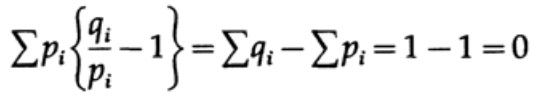
Ha a kommunikációs rendszer ábécéje q karakterből áll, akkor ha minden karakter küldésének valószínűsége qi = 1/q, és behelyettesítjük q-t, a Gibbs-egyenlőtlenségből kapjuk.
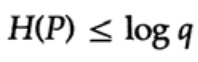
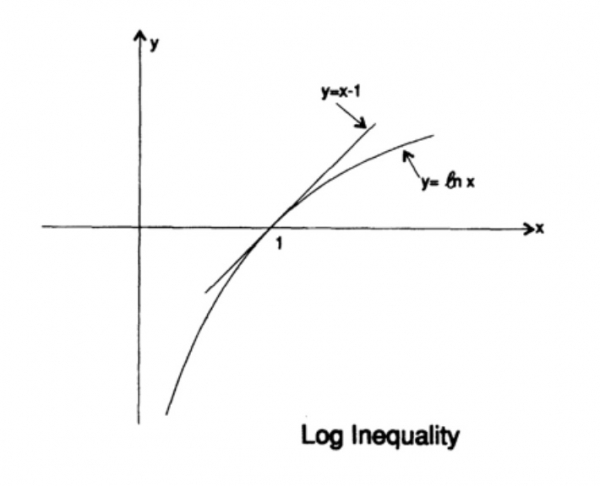
13. ábra.I
Ez azt jelenti, hogy ha az összes q karakter küldésének valószínűsége egyenlő, és megegyezik 1/q-val, akkor a maximális entrópia ln q, ellenkező esetben egyenlőtlenség áll fenn.
Egy egyértelműen dekódolható kód esetén a Kraft-egyenlőtlenséggel rendelkezünk.
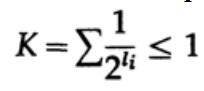
Most ha meghatározzuk a pszeudovalószínűségeket,
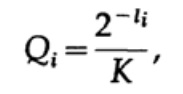
ahol természetesen 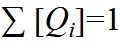 = 1, ami a Gibbs-egyenlőtlenségből következik,
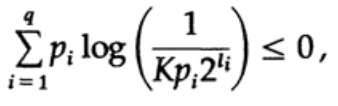
és alkalmazunk egy kis algebrát (ne felejtsük el, hogy K ≤ 1, ezért elhagyhatjuk a logaritmikus tagot, és esetleg később erősíthetjük az egyenlőtlenséget), akkor kapjuk
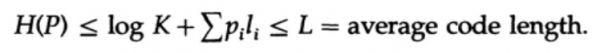
ahol L a kód átlagos hossza.
Így az entrópia a legkisebb határ bármely szimbólum-kódra, amelynek átlagos kódhossza L. Ez Shannon tétele a zajmentes csatornára.
Most nézzük meg a fő tételt a kommunikációs rendszerek korlátairól, ahol az információt független bitek áramlása formájában továbbítják, és zaj van jelen. Feltételezzük, hogy egy bit helyes átadásának valószínűsége P > 1/2, és a bit értékének átvitele során a valószínűség, hogy az érték megfordul (hiba lép fel), Q = 1 - P. Kényelmi szempontból feltételezzük, hogy a hibák függetlenek, és a hiba valószínűsége minden elküldött bitre azonos — azaz a kommunikációs csatornán „fehér zaj” van.
A hosszú, n bitből álló áramot egy üzenetként kódoljuk — az n dimenziós kiterjesztése egy bitkódnak. Az n értékét később határozzuk meg. Tekintsük az n-bites üzenetet egy pontként az n-dimenziós térben. Mivel van egy n dimenziós terünk — és egyszerűség kedvéért feltételezzük, hogy minden üzenetnek azonos a valószínűsége — létezik M lehetséges üzenet (M-et később szintén meghatározzuk), így bármilyen elküldött üzenet valószínűsége

(küldő)
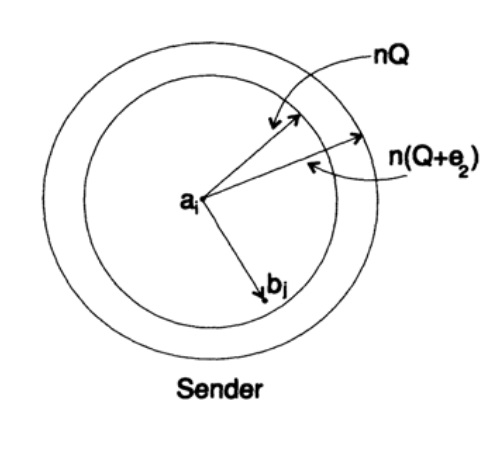
13. ábra.II
Ezután megvizsgáljuk a csatorna sávszélességének fogalmát. Részletekbe bocsátkozás nélkül a csatorna sávszélességét úgy határozzuk meg, mint azokat az információmennyiségeket, amelyeket megbízhatóan át lehet vinni a kommunikációs csatornán, figyelembe véve a leghatékonyabb kódolás alkalmazását. Nincs bizonyíték arra, hogy a kommunikációs csatornán több információt lehetne átvitelni, mint annak kapacitása. Ezt a bináris szimmetrikus csatornára vonatkozóan be tudjuk bizonyítani (amelyet az esetünkben használunk). A csatorna kapacitása, bitenkénti küldés esetén, a következőként van megadva:
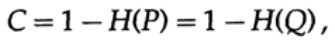
ahol, mint korábban, P a hiba hiányának valószínűsége bármely küldött bit esetében. Amikor n független bitet küldünk, a csatorna kapacitása a következőképpen határozható meg:
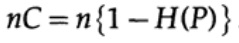
Ha a csatorna sávszélessége közelében vagyunk, akkor szinte annyi információt kell küldenünk minden egyes ai szimbólumhoz, i = 1, …, M. Figyelembe véve, hogy az ai szimbólumok előfordulásának valószínűsége 1 / M, a következőket kapjuk:
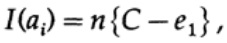
amikor bármelyik M egyenlő valószínűségű üzenetet ai küldünk, akkor azt tapasztaljuk, hogy
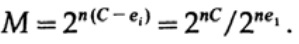
n bit küldésekor a nQ hibák várhatóan megjelennek. A gyakorlatban, ha az üzenet n bitből áll, körülbelül nQ hiba lesz a megkapott üzenetben. Nagy n esetén a relatív variáció (variáció = eloszlás szélessége,)
a hibák számának eloszlása egyre szűkebb lesz n növekedésével.
Tehát az adó oldaláról én veszem az ai üzenetet a küldéshez, és egy gömböt vonok köré, amelynek sugara
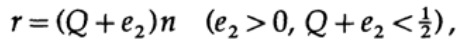
kicsit nagyobb, mint a Q hibák várható száma e2 mértékével (13. II. ábra). Ha n elég nagy, akkor bármilyen kicsi valószínűsége van annak, hogy a bj üzenetpont a vevő oldalán túllép ezen a gömbön. Ábrázold a helyzetet, ahogy én látom az adó szempontjából: bármilyen sugara van a küldött ai üzenettől a megkapott bj üzenetig, a hiba valószínűsége (vagy majdnem) normális eloszlást követ, amely eléri a maximumot nQ-nál. Bármely adott e2 esetén létezik olyan n, ami elég nagy, hogy a valószínűség, hogy a kapott bj pont túllép a gömböm határain, annyira kicsi legyen, amennyire csak akarod.
Most nézzük meg ezt a helyzetet az Ön oldaláról (lásd 13.III. ábra). A vevő oldalán van egy S(r) gömb ugyanazzal a r sugárral a bj elfogadott pont körül az n-dimenziós térben, úgy, hogy ha az elfogadott üzenet bj a gömbömön belül van, akkor az általam küldött üzenet ai a gömbödön belül van.
Hogyan léphet fel hiba? Hiba léphet fel az alábbi táblázatban leírt esetekben:
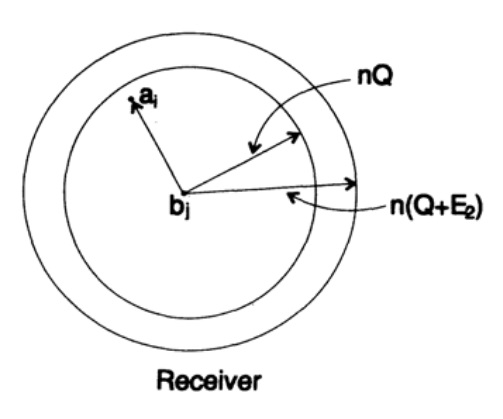
13.III. ábra
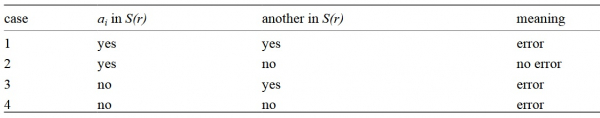
Itt látjuk, hogy ha a bj elfogadott pont körül épített gömbön belül van legalább még egy pont, ami egy lehetséges elküldött kódolatlan üzenetnek felel meg, akkor a továbbítás során hiba történt, mivel nem tudja meghatározni, hogy pontosan melyik üzenetet küldték el. Az elküldött üzenet csak akkor hibátlan, ha a hozzá tartozó pont a gömbön belül van, és nincsenek más pontok, amelyek a megadott kódban szintén ugyanabban a gömbben helyezkednek el.
Van egy matematikai egyenletünk a hiba valószínűségére P_e, ha az ai üzenetet küldték el.
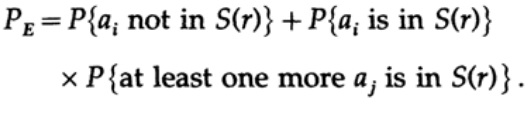
Az első szorzót elhanyagolhatjuk a második hozzáadott tagban, tekintve azt 1-nek. Így egy egyenlőtlenséget kapunk.
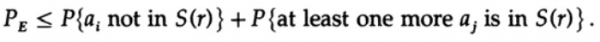
Nyilvánvaló, hogy
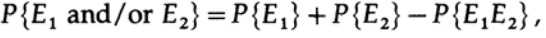
következésképpen
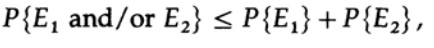
újra alkalmazzuk a legutolsó tagra jobbról
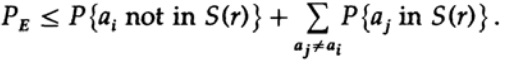
Ha n-t elég nagyra választjuk, az első tag olyan kicsi lehet, mondjuk, kisebb, mint egy d szám. Tehát azt kapjuk, hogy
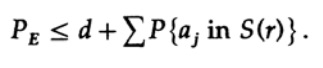
Most nézzük meg, hogyan lehet egyszerű helyettesítő kódot építeni M üzenet kódolására, amely n bitből áll. Miután nem tudjuk, hogyan kell a kódot felépíteni (a hibajavító kódokat még nem találták fel), Shannon véletlenszerű kódolást választott. Pörgesse meg a pénzérmét minden n bitre az üzenetben, és ismételje meg a folyamatot M üzenet esetén. Összesen nM pénzérme pörgetés szükséges, ezért lehetséges

kódolt szótárak, amelyeknek az valószínűsége ½nM. Természetesen a kódolt szótár véletlenszerű létrehozási folyamata azt jelenti, hogy van esély a duplikálódásra, valamint olyan kódolt pontokra, amelyek közel lesznek egymáshoz, ezért valószínű hibák forrásai lehetnek. Be kell bizonyítani, hogy ha ez a valószínűség nem haladja meg bármely kis kiválasztott hibaszintet, akkor a megadott n elég nagy.
A kulcsszó az, hogy Shannon összes lehetséges kódkönyvet átlagolt, hogy megtalálja az átlagos hibát! A [. ] szimbólumot fogjuk használni, hogy jelezzük az összes lehetséges véletlenszerű kódolvasó szótár átlagértékét. A d konstans átlagolása természetesen konstansot ad, mivel minden egyes tag azonos más tagokkal az összegben.
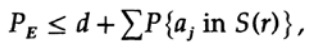
amely növelhető (M–1 M-re megy)
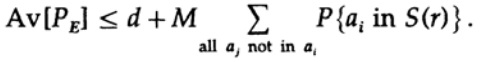
Bármely konkrét üzenet esetében, az összes kód könyv átlagolása során a kódolás minden lehetséges értéket átmegy, így az a valószínűség, hogy a pont a gömbben van, a gömb térfogatának aránya az összes térfogatnak. A gömb térfogata ekkor
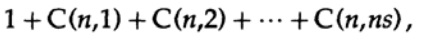
ahol s=Q+e2 <1/2 és ns-nak egész számnak kell lennie.
A legjobb jobbról az utolsó tag a legnagyobb ebben az összegben. Először értékeljük ki a Stirling-formula alapján a faktoriálisok értékét. Ezután megnézzük a nála előtte álló tag csökkentési együtthatóját, vegye észre, hogy ez az együttható növekszik balra haladva, így mi tudunk: (1) a kezdő együtthatós gépi haladással korlátozni az összeg értékét, (2) a gépi haladást ns tagtól végtelen számú tagnak kiterjeszteni, (3) kiszámítani a végtelen geometriai progresszió összegét (szokásos algebra, semmi lényeges), és végül megkapni a határértéket (elég nagy n esetén):
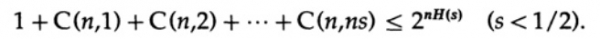
Vegye észre, hogyan jelent meg az entropia H(s) a binomiális azonosságban. Vegye észre, hogy a Taylor-sor H(s)=H(Q+e2) kifejtése értékbecslést ad, amely csak az első derivatívát veszi figyelembe, és elhanyagolja a többit. Most összegezzük a véges kifejezést:
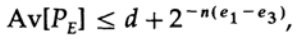
ahol
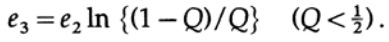
Mindent, amit tennünk kell, az az e2 választása, így e3 < e1, és a legutolsó tag tetszőlegesen kicsi lehet, ha n eléggé nagy. Tehát az átlagos PE hiba bármilyen kicsire szorítható, ha a csatorna sávszélessége a C-hez tetszőlegesen közel van.
Ha az összes kód átlagos értéke elég kicsi hibával rendelkezik, akkor legalább egy kódnak megfelelőnek kell lennie, tehát legalább egy megfelelő kódolási rendszer létezik. Ez egy fontos eredmény, amelyet Shannon nyert — a "Shannon-tétel a zajos csatornára", bár érdemes megjegyezni, hogy ő ezt sokkal általánosabb esetben bizonyította, mint az általam használt egyszerű bináris szimmetrikus csatorna. Az általános esetben a matematikai levezetés sokkal bonyolultabb, de az ötletek nem különböznek annyira, így gyakran a különleges eset példáján keresztül lehet feltárni a tétel igazi jelentését.
Nézzük meg a eredményt kritikával. Többször is hangsúlyoztuk: "Elég nagy n mellett". De mennyire nagy n-t kell tekinteni? Nagyon, nagyon nagyot, ha valóban szeretnél egyszerre közel lenni a csatorna sávszélességéhez és biztos lenni az adatok helyes átadásában! Olyan nagy, hogy valójában nagyon hosszú ideig kell várnod, hogy elegendő bitből álló üzenetet felhalmozz, hogy azt később kódolhasd. Közben a véletlen kód szótárának mérete egyszerűen óriási lesz (hiszen egy ilyen szótárat nem lehet rövidebb formában ábrázolni, mint az összes Mn bit teljes listájával, miközben n és M is nagyon nagy)!
A hibajavító kódok elkerülik a nagyon hosszú üzenetek várakozását, az ezeket követő kódolást és dekódolást a nagyon nagy kódolt könyvek révén, mert elkerülik a kódolt könyveket mint olyanokat, és helyettük hagyományos számításokat használnak. Egyszerű elméletben ezek a kódok általában elveszítik a sávszélességhez való közelítés képességét, miközben mégis elég alacsony hibafrekvenciát tartanak fenn, de amikor a kód sok hibát javít, jó eredményeket mutatnak. Más szavakkal, ha a csatorna kapacitását hibák kijavítására szánod, akkor a hibajavítás lehetőségét a legtöbb időben használnod kell, azaz minden elküldött üzenetnek jelentős hibákat kell kijavítania, különben ezt a kapacitást pazarolod.
A bizonyított tételek a fenti állításban még mindig nem értelmetlenek! Megmutatják, hogy a hatékony adatátviteli rendszereknek jól megtervezett kódolási séma alkalmazására van szükségük, amelyek nagyon hosszú bitláncokat használnak. Példa erre a Föld külső bolygói fölé távozó műholdak; ahogy távolodnak a Földtől és a Naptól, egyre több és több hibát kell javítaniuk az adatblokkokban: egyes műholdak 5 W körüli napenergia-akkumulátorokat használnak, míg mások atomenergiát használó forrásokat, amelyek hasonló teljesítményűek. Az alacsony energiaellátás, a kis adóantennák mérete, a földi vevőantennák korlátozott mérete, valamint a jel számára lefedett hatalmas távolság — mindezek magas szintű hibajavító kódok alkalmazását igénylik egy hatékony kommunikációs rendszer létrehozásához.
Térjünk vissza az n-dimenzionális térhez, amelyet a fenti bizonyításban használtunk. Ennek megvitatása során azt mutattuk, hogy a gömb térfogatának majdnem az egész része a külső felület körül összpontosul — így szinte biztos, hogy a küldött jel a valódi jel körül kialakított gömb felületén helyezkedik el, még viszonylag kis sugár mellett is. Ezért nem meglepő, hogy a megérkezett jel, miután tetszőleges számú hibát, nQ, kijavított, akár mennyire közel is kerül a hibátlan jelhez. Az adatátviteli csatorna kapacitása, amelyet korábban tárgyaltunk, ennek a jelenségnek a megértésének kulcsa. Vegye figyelembe, hogy a hibajavító Hamming-kódok esetén létrehozott hasonló gömbök nem fedik át egymást. Az n-dimenzionális térben lévő szinte ortogonális dimenziók nagy száma azt mutatja, miért tudunk M gömböt elhelyezni a térben kis átfedéssel. Ha feltételezzük a kis, akármilyen kicsi átfedést, amely csak kis számú hibához vezethet a dekódolás során, sűrű gömbelhelyezést lehet elérni a térben. Hamming garantálta egy bizonyos szintű hibajavítást, Shannon pedig az alacsony hibalehetőséget, de a tényleges átvitel kapacitásának megőrzése érdekében, amely bármennyire közel van az adatátviteli csatorna kapacitásához,amit a Hamming-kódok nem tudnak megvalósítani.
Az információelmélet nem arról szól, hogy hogyan kell hatékony rendszereket tervezni, de irányt mutat a hatékony kommunikációs rendszerek felé. Ez egy értékes eszköz a gépek közötti kommunikációs rendszerek felépítéséhez, de, ahogyan azt korábban is említettük, nem igazán kapcsolódik ahhoz, hogyan osztanak meg egymással információt az emberek. Az a mérték, amelyben a biológiai öröklődés hasonlít a technikai kommunikációs rendszerekhez, egyszerűen ismeretlen, így jelenleg nem világos, mennyire alkalmazható az információelmélet a génekre. Nem marad más nekünk, mint megpróbálni, és ha a siker gépszerű jellegét mutatja, akkor a kudarc más lényeges aspektusaira utal az információnak.
Hagyd, hogy egy kicsit eltérjünk. Láttuk, hogy minden kezdeti definíciónak valamilyen mértékig ki kell fejeznie alapvető meggyőződéseink lényegét, de e definícióknak van egy bizonyos torzítása, így végső soron alkalmazhatatlanná válnak. Hagyományosan elfogadott, hogy végső soron az a definíció, amelyet használunk, ténylegesen meghatározza a lényegét; de ez pusztán azt mutatja meg, hogyan kezeljük a dolgokat, és semmiféle értelmet nem ad nekünk. A posztulátoros megközelítés, amelyet a matematikai körökben annyira dicsérnek, a gyakorlatban még messze van a tökéletestől.
Most már egy IQ-teszt példáját vesszük számba, ahol a definíció annyira ciklikus, amennyire csak szeretnéd, így tévedésbe ejt. Készítenek egy tesztet, amelynek mérnie kellene az intelligenciát. Ezt követően felülvizsgálják, hogy a lehető legkonzisztensebbé tegyék, majd közzéteszik és egyszerű kalibrálási módszerrel kalibrálják, így a mért "intelligencia" normál eloszlású lesz (természetesen a kalibrálási görbe szerint). Minden definíciót újra kell ellenőrizni, nemcsak amikor először javasolják, hanem sokkal később is, amikor használják az elért következtetésekben. Mily mértékben felelnek meg a definíciók határai a megoldandó feladatnak? Milyen gyakran alkalmazzák a különböző körülmények között adott definíciókat eléggé eltérő körülmények között? Ez elég gyakran előfordul! A humán tudományokban, amelyekkel elkerülhetetlenül szembesülsz az életedben, ez gyakrabban történik.
Ebből kifolyólag az információelmélet ezen előadásának egyik célja, a hasznosságának bemutatása mellett, az volt, hogy figyelmeztessen benneteket erre a veszélyre, vagyis bemutassa, hogyan használjátok azt a kívánt eredmény elérésére. Régóta megfigyelték, hogy az eredeti definíciók nagymértékben befolyásolják, hogy mit találtok végül, sokkal inkább, mint ahogy az látszik. Az eredeti definíciók nagy figyelmet igényelnek nemcsak minden új helyzetben, hanem olyan területeken is, ahol már régóta dolgoztok. Ez lehetővé teszi, hogy megértsétek, mérték szerint a kapott eredmények tautológiát képeznek, és nem valami hasznosat.
Eddingottnak a története beszél arról, hogy emberek hogyan halásznak a tengerben hálóval. Miután megvizsgálták a megfogott halak méretét, meghatározták a minimális halméretet, amely a tengerben él! A következtetésüket az általuk használt eszköz alapozta meg, nem a valóság.
Folytatás következik…
Aki szívesen segítene a könyv fordításában, tördelésében és kiadásában — írjatok privát üzenetet vagy e-mailt a magisterludi2016@yandex.ru címre.
Egyébként elindítottunk egy újabb menő könyv fordítását — )
Különösen keresünk azokat, akik segítenek lefordítani . (10 percet fordítunk, az első 20 már megvan)
A könyv tartalma és a lefordított fejezetek
- Bevezetés a tudomány és mérnöki munka művészetébe: Tanulni tanulni (1995. március 28.)
- „A digitális (diszkrét) forradalom alapjai” (1995. március 30.)
- „A számítógépek története — Hardver” (1995. március 31.)
- „A számítógépek története — Szoftver” (1995. április 4.)
- „A számítógépek története — Alkalmazások” (1995. április 6.)
- „Mesterséges intelligencia — I. rész” (1995. április 7.)
- „Mesterséges intelligencia — II. rész” (1995. április 11.)
- „Mesterséges intelligencia III.” (1995. április 13.)
- „n-Dimenzionális Tér” (1995. április 14.)
- „Kódelmélet — Az információ reprezentációja, I. rész” (1995. április 18.)
- „Kódelmélet — Az információ reprezentációja, II. rész” (1995. április 20.)
- „Hibajavító kódok” (1995. április 21.)
- „Információelmélet” (1995. április 25.)
- „Digitális szűrők, I. rész” (1995. április 27.)
- „Digitális szűrők, II. rész” (1995. április 28.)
- „Digitális szűrők, III. rész” (1995. május 2.)
- „Digitális szűrők, IV. rész” (1995. május 4.)
- „Szimuláció, I. rész” (1995. május 5.)
- „Szimuláció, II. rész” (1995. május 9.)
- „Szimuláció, III. rész” (1995. május 11.)
- „Optikai szálak” (1995. május 12.)
- „Számítógéppel Segített Oktatás” (1995. május 16.)
- „Matematika” (1995. május 18.)
- „Kvantummechanika” (1995. május 19.)
- „Kreativitás” (1995. május 23.). Fordítás:
- „Szakértők” (1995. május 25.)
- „Megbízhatatlan adatok” (1995. május 26.)
- „Rendszertervezés” (1995. május 30.)
- „Amit mérsz, azt kapod” (1995. június 1.)
- (1995. június 2.) fordítunk 10 perces részekben
- Hamming, „Te és a kutatásod” (1995. június 6.).
Aki szívesen segítene a könyv fordításában, tördelésében és kiadásában — írjatok privát üzenetet vagy e-mailt a magisterludi2016@yandex.ru címre.
Forrás: habr.com
