

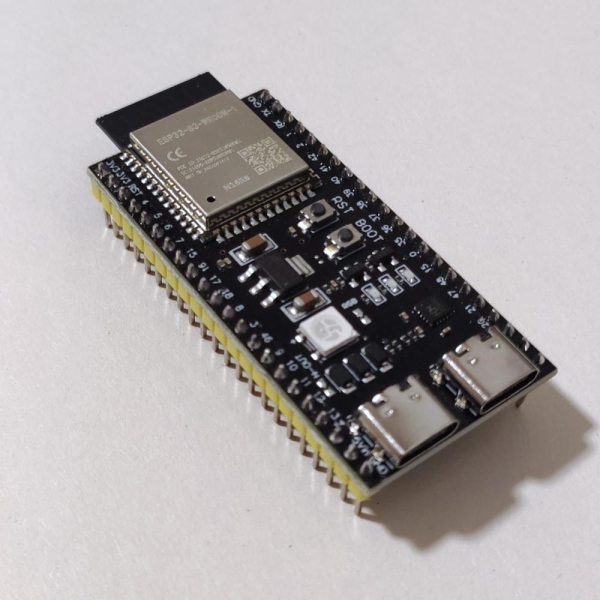
A fejlesztő, Vjacseszlav Serbov, aki slvDev álnéven szerepel, bemutatta teljesen lokális szöveggenerálást végez az ESP32-S3 mikrovezérlőn. Általa létrehozott nyelvi modell 28,9 millió paramétert tartalmaz, és másodpercenként körülbelül 9,9 tokent ad ki, anélkül, hogy szerverhez vagy más külső számítási erőforráshoz fordulna. A generált rövid történetek egy csatlakoztatott OLED-képernyőn jelennek meg.
Projekt esp32-ai az ESP32-S3 N16R8 modulon lett tesztelve, amely 512 KB beépített SRAM-mal, 8 MB PSRAM-mal és 16 MB flash memóriával rendelkezik. A négy bitre kvantált modell 14,9 MB-ot foglal el. A tárolóban közzé lett téve a C nyelvű futtatási kör forráskódja, a modell tanításához és kvantálásához szükséges eszközök, firmware, tesztek és a modulra való feltöltés szkriptjei.
A megadott 28,9 millió paramétert nem szabad közvetlenül összehasonlítani a hagyományos asztali LLM paramétereivel. A fejlesztő részletes jelentése szerint,, a modell egy sűrű számítási magból áll, körülbelül 559 ezer paraméterrel, egy kimeneti rétegből 3,1 millió paraméterrel és egy rétegenkénti vektorábrázolási táblázatból körülbelül 25 millió paraméterrel. Ez utóbbi biztosítja a modell formális méretének jelentős részét, de nem kerül teljes egészében feldolgozásra minden token generálásakor.
A modell elhelyezéséhez három memória szintet használnak. A leggyakrabban használt adatok a belső SRAM-ban találhatók, a kimeneti réteg, KV-cache és ideiglenes pufferek a PSRAM-ban, míg a 25 millió paraméterű táblázat flash memóriában marad és az adresstérbe térképezve érhető el. Minden tokenhez ebből körülbelül hat sor olvasható, összesen körülbelül 450 byte méretben.
Ez a készülék a Per-Layer Embeddings technológián alapul, amit a Google a Gemma 3n-ben alkalmazott. A Google dokumentációja szerint,, a PLE-paraméterek a modell munkamemóriáján kívül tárolhatók, és a kimeneti folyamat során hozzáadhatók, ahogy az egyes rétegek feldolgozása zajlik. Az esp32-ai ezt a megközelítést átültette a mikrovezérlő memóriahierarchiájára, ahol a gyors SRAM különösen korlátozott.
Az első teljesen helyes, C nyelven írt futtatási környezet csak 0,57 tokent adott másodpercenként. Miután a kimeneti réteget PSRAM-ra helyezték, áttértek a nyolc bitérintkezéses aktivációkra, elosztották a számításokat a két Xtensa LX7 mag között, és más optimalizálásokat végeztek, a késleltetés 94,9 ms-ra csökkent a modell lépésénél. A végső mért sebesség 9,88 token másodpercenként a teljes generálási folyamat figyelembevételével. A fő korlát most a PSRAM sávszélessége lett a kimeneti réteg olvasásánál.
A modell egy szintetikus adatállományon lett betanítva TinyStories, amely egyszerű angol nyelvű történetekből áll, korlátozott szókincsel. Ezért képes folytatni a mondatokat és kicsi, összefüggő történeteket alkotni, de nem alkalmas kérdésekre válaszolásra, utasítások végrehajtására, programozásra vagy tényszerű tudás előállítására. A fejlesztő ezt a munkát elsősorban a modell hatékony memóriakészítésének bemutatásaként tekinti, nem mint készen álló, önálló csevegőrobotot.
A legfrissebb dokumentációban a szerző külön hangsúlyozza, hogy az esp32-ai önálló fejlesztés. llama2.c Andrej Karpaty projektje és a 260 ezer paraméteres modell korábbi indítása ESP32-S3-on csak irányadó példák és előző munkák említése: a kód, a pontozások és a módszerek közvetlenül nem lettek átvéve tőlük. Az esp32-ai forráskódja MIT licenc alatt terjesztik..
Forrás: linux.org.ru
