

November 30 - December 1-ig Nizhniy Novgorodban zajlott. A résztvevőknek egy termékmegoldás prototípusát kellett létrehozniuk az Intel OpenVINO toolkit használatával. A szervezők egy példatémákból álló listát kínáltak, amely alapján a csapatok választhatták meg a feladatot, de a végső döntés a csapatok kezében maradt. Emellett ösztönözték a nem termékbe tartozó modellek használatát is.
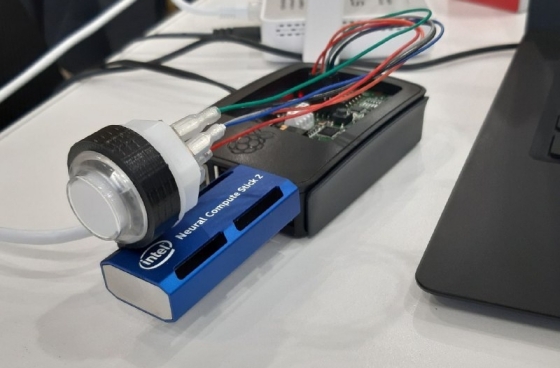
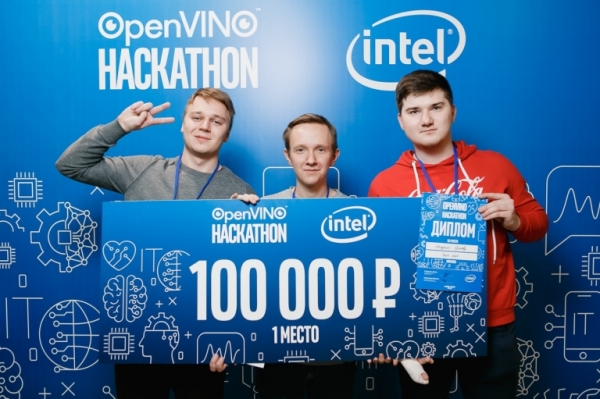
A cikkben arról beszélünk, hogyan készítettük el a saját termék prototípusunkat, amellyel végül az első helyet szereztük meg.
A hackathonon több mint 10 csapat vett részt. Kellemes meglepetés volt, hogy néhány csapat más régiókból érkezett. A hackathon helyszínéül a "Kreml a Pocsin" komplexumot választották, ahol régi fényképek voltak kiállítva Nizhniy Novgorodról, hangulatos! (Emlékeztetlek, hogy jelenleg az Intel központi irodája is Nizhniy Novgorodban található). A kód megírására 26 órát kaptak a résztvevők, a végén be kellett mutatniuk a megoldásukat. Külön előny volt, hogy demózási lehetőség volt, hogy megbizonyosodjanak arról, hogy minden, amit kitaláltak, valóban megvalósult, és nem csak elképzelések maradtak a bemutatóban. Áruk, snackek, ételek is voltak!
Ezen kívül az Intel kívánság szerint biztosított kamerákat, Raspberry PI-t, Neural Compute Stick 2-t.
A feladat kiválasztása
A szabad tematikájú hackathonra való felkészülés egyik legnehezebb része a feladatválasztás. Azonnal úgy döntöttünk, hogy valami olyat kell kitalálni, ami még nincs a termékben, mivel a bejelentés szerint ez minden esetben üdvözlendő.
Analizálva , amelyek a jelenlegi kiadásban a termékbe tartoznak, arra a következtetésre jutottunk, hogy a legtöbbjük különböző számítógépes látási feladatokat old meg. Nagyon nehéz olyan számítógépes látás területén lévő feladatot kitalálni, amelyet nem lehet OpenVINO használatával megoldani, és ha ilyet kitalálunk is, nehezen találhatók előképzett modellek nyílt hozzáférés alatt. Úgy döntöttünk, hogy más irányba is elindulunk - a beszédfeldolgozás és -elemzés irányába. Érdekes feladatként fontolóra vettük az érzelmek felismerését a beszéd alapján. Meg kell mondani, hogy az OpenVINO-ban már van egy modell, amely az arckifejezés alapján határozza meg az ember érzelmeit, de:
- Elméletileg létrehozhatunk egy kombinált algoritmust, amely mind a hang, mind a kép alapján működik, ami növelheti a pontosságot.
- A kamerák általában keskeny látószöggel rendelkeznek, ami azt jelenti, hogy több kamerára van szükség, a hangra viszont nincsenek ilyen korlátok.
Fejlesszük az ötletet: alapul vehetjük a kiskereskedelmi szektort. Meg lehet határozni a vásárlói elégedettséget a bolti pénztáraknál. Ha egy vásárló elégedetlen a szolgáltatással, és elkezd hangosabbá válni – azonnal lehet kérni az adminisztrátor segítségét.
Ebben az esetben szükség van a hangazonosítás hozzáadására, amely lehetővé teszi, hogy megkülönböztessük az üzlet alkalmazottait a vásárlóktól, és analitikát készítsünk minden egyes egyénről. Ezen kívül lehetőség nyílik az üzlet alkalmazottainak viselkedésének elemzésére, és az együttműködés légkörének értékelésére, ez jól hangzik!
Meghatározzuk a követelményeket a megoldásunkhoz:
- Kis méretű célkészülék
- Valós idejű működés
- Alacsony ár
- Könnyű skálázhatóság
Végül a célkészüléknek a Raspberry Pi 3-at választjuk .
Itt fontos megjegyezni egy lényeges jellemzőt az NCS-sel kapcsolatban – a legjobban a standard CNN architektúrákkal működik, ha viszont igény van egy egyedi rétegekkel rendelkező modell futtatására, akkor számítanunk kell a mély szintű optimalizálásra.
A dolog könnyen megoldható: szükség van egy mikrofonra. Egy átlagos USB-mikrofon is megfelelő, bár nem mutat jól együtt az RPI-vel. De itt van egy szó szerint ‘a közelben’ lévő megoldás. A hang rögzítésére a Voice Bonnet deszkát használjuk a , amelyen egy forrasztott sztereó mikrofon található.
Töltsük le a Raspbiant az és másoljuk fel egy USB-meghajtóra, majd teszteljük, hogy a mikrofon működik a következő parancs segítségével (ez 5 másodperces audiót rögzít és egy fájlba menti):
arecord -d 5 -r 16000 test.wavAzonnal megjegyzem, hogy a mikrofon nagyon érzékeny és jól érzékeli a zajokat. Ennek javításához lépjen be az alsamixerbe, válassza a Capture devices-t, és csökkentse a bemeneti jelszintet 50-60%-ra.
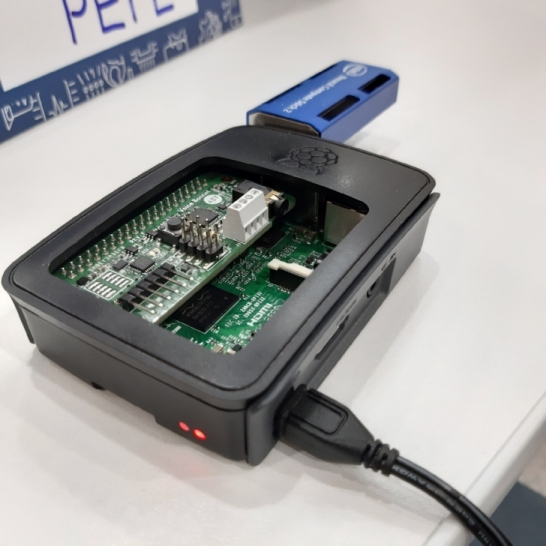
Finomítjuk a házat reszelővel, és minden elfér, még a fedél is zárható.
Hozzáadunk egy indikátor gombot.
A Google AIY Voice Kit részeinek szétszerelése közben eszünkbe jut, hogy van egy RGB-gomb, amelynek háttérvilágítása programozható. Keresünk “Google AIY Led”, és megtaláljuk a dokumentációt:
Miért ne használnánk ezt a gombot a felismert érzelem megjelenítésére, hiszen összesen 7 kategóriánk van, és a gomb 8 színnel rendelkezik, ami pont elegendő!
Csatlakoztassuk a gombot GPIO-n keresztül a Voice Bonnethez, töltsük be a szükséges könyvtárakat (ezek már telepítve vannak az AIY projectek disztribúciójában).
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Hozzunk létre egy dict-et, amelyben minden érzelem RGB Tuple formájában színhez van rendelve, valamint egy aiy.leds.Leds osztályú objektumot, amelyen keresztül frissíteni fogjuk a színt:
led_dict = {'semleges': (255, 255, 255), 'boldog': (0, 255, 0), 'szomorú': (0, 255, 255), 'dühös': (255, 0, 0), 'félelemmel teli': (0, 0, 0), 'undort keltő': (255, 0, 255), 'meglepett': (255, 255, 0)}
leds = Leds()
Végül, minden új érzelmi jóslás után frissítjük a gomb színét az érzelemnek megfelelően (a kulcs alapján).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))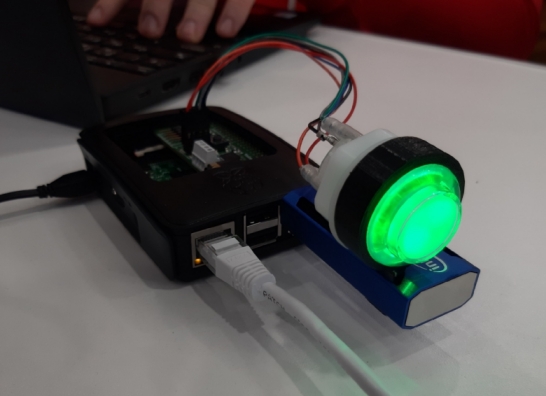
Gomb, világíts!
Dolgozunk a hanggal
A pyaudio-t fogjuk használni a mikrofonból érkező hangfolyam rögzítésére és a webrtcvad-t a zaj szűrésére és a hang detektálására. Emellett létrehozunk egy sorozatot, amelybe aszinkron módon fogjuk hozzáadni és eltávolítani a hangrészleteket.
Mivel a webrtcvad-nek méretkorlátozása van a beadott részletek számára — ami 10/20/30 ms kell legyen, és az érzelmek felismerésére szolgáló modell képzése (ahogy azt később látni fogjuk) 48 kHz-es adathalmazon zajlott, így 48000×20 ms/1000×1 (mono)=960 bájtnyi darabokban fogunk rögzíteni. A Webrtcvad True/False-t fog visszaadni az ilyen darabok számára, ami a hang jelenlétének vagy hiányának felel meg a darabban.
Következő logikával fogunk dolgozni:
- A listába azokba a darabokba fogjuk hozzáadni, ahol hang van, ha nincs hang, akkor növeljük az üres darabok számjegyét.
- Ha az üres darabok száma >=30 (600 ms), akkor megnézzük az összegyűjtött darabok listájának méretét, ha >250, akkor hozzáadjuk a sorhoz, ha nem, akkor úgy számolunk, hogy a rögzítési idő nem elegendő a beszélő azonosító modelljének beadásához.
- Ha az üres darabok száma még mindig < 30, de az összegyűjtött darabok listájának mérete meghaladta a 300-at, akkor hozzáadjuk a részletet a sorhoz pontosabb előrejelzés érdekében. (mivel az érzelmek idővel változhatnak)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Itt az ideje, hogy keresgéljünk a nyílt forráskódú előképzett modellek között, menjünk a github-ra, google-ozzunk, de ne feledjük, hogy van egy korlátozás az architektúrára, amit használhatunk. Ez egy meglehetősen összetett rész, mert a modellek tesztelése a saját bemeneti adataink alapján szükséges, és emellett konvertálni is kell az OpenVINO belső formátumába - IR (Intermediate Representation). Körülbelül 5-7 különböző megoldást próbáltunk ki github-on, és míg az érzelmek felismerésére szolgáló modell azonnal működni kezdett, a hang felismerésével több időt kellett eltölteni - ott bonyolultabb architektúrák használatosak.
A következőkre állunk meg:
- A hangból kinyert érzelmek -
A működése a következő elven alapul: az audiót meghatározott méretű darabokra szeleteljük, és mindegyik darabhoz kiemeljük és ezután ezeket a CNN bemenetére küldjük - A hang felismerése -
Itt az MFCC helyett spektrogrammal dolgozunk, miután FFT-t végeztünk, a jelet a CNN-be küldjük, ahol a kimeneten a hang vektoros reprezentációját kapjuk meg.
Most a modellek konvertálásáról lesz szó, kezdjük a teóriával. Az OpenVINO több modult tartalmaz:
- Open Model Zoo, amelyből modellek használhatók és beépíthetők a termékbe
- Model Optimizer, aminek segítségével a különböző keretrendszerek (Tensorflow, ONNX stb.) formátumaiból az Intermediate Representation formátumba konvertálhatók a modellek, amivel a továbbiakban dolgozni fogunk
- Inference Engine lehetővé teszi a modellek IR formátumban való futtatását Intel processzorokon, Myriad chipeken és Neural Compute Stick gyorsítókon
- A leghatékonyabb OpenCV verzió (Inference Engine támogatással)
Minden IR formátumú modellt két fájl ír le: .xml és .bin.
A modellek IR formátumba való konvertálása a Model Optimizer segítségével a következőképpen történik:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typelehetővé teszi a modell által használt adatformátum kiválasztását. Támogatott típusok: FP32, FP16, INT8. Az optimális adat típus kiválasztása jelentős teljesítményjavulást eredményezhet.
--input_shapemegadja a bemeneti adatok dimenzióját. A C++ API-ban állítólag van lehetőség a dinamikus változtatásra, de mi nem mélyültünk el ebben, és az egyik modell esetében csupán rögzítettük.
Ezután megpróbáljuk betölteni a már konvertált modellt IR formátumban az OpenCV DNN modulján keresztül, és végrehajtani rajta a forward folyamatot.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Az utolsó sor ebben az esetben lehetővé teszi a számítások áthelyezését a Neural Compute Stickre, alapértelmezés szerint a számítások a processzoron futnak, de Raspberry Pi esetén ez nem működik, szükséges lesz a stick.
Ezután a logika a következő: az audiofájlt meghatározott méretű ablakokra osztjuk (ez nálunk 0.4s), mindegyik ablakot MFCC-vé alakítjuk, amelyeket aztán a hálóra adunk:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Ezután az összes ablak közül a leggyakrabban előforduló osztályt vesszük. Egyszerű megoldás, de a hackathonra nem szükséges túlgondolni, csak ha van idő. Még sok munkánk van, ezért tovább lépünk — a hangfelismerésbe mélyedünk. Készítenünk kell egy adatbázist, amely tárolja a korábban rögzített hangok spektrográfiáit. Mivel már kevés időnk maradt, ezt a kérdést, ahogy tudjuk, megoldjuk.
Nevezetesen, egy szkriptet készítünk a hangrészlet rögzítésére (ugyanúgy működik, mint fentebb említettem, csak zárszó esetén elmenti a hangot egy fájlba).
Próbáljuk ki:
python3 voice_db/record_voice.py test.wavRögzítjük több ember hangját (esetünkben három csapattag hangját)
Ezután minden rögzített hang számára gyors Fourier-transzformációt hajtunk végre, spektrográfiát kapunk és numpy array (.npy) formátumban mentjük el:for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Részletesebben a fájlban
create_base.py
Végül, amikor az alap szkriptet futtatjuk, az elején embeddings-t kapunk ezekből a spektrográfiákból:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Az említett részletből származó beágyazás után meg tudjuk határozni, hogy kinek a tulajdonában van az, ha megmérjük a koszinusz távolságot a részlet és az összes hang között az adatbázisban (minél kisebb, annál valószínűbb) — a demóhoz 0.3-as küszöböt állítottunk be:
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
A végén megjegyzem, hogy az inferálási sebesség gyors volt, és lehetőséget adott még 1-2 modell hozzáadására (7 másodperces mintán 2.5 másodpercet vett igénybe az inferálás). Új modellek hozzáadására már nem volt időnk, ezért a webalkalmazás prototípusának megírására összpontosítottunk.
Webalkalmazás
Fontos pont: hozunk magunkkal egy routert otthonról, és beállítjuk a saját hálózatunkat, ami segít összekötni az eszközöket és a laptopokat a hálón.
A backend egy folytonos üzenetcsatorna, amely a frontend és a Raspberry Pi között működik, websocket technológián alapulva (http tcp protokollon keresztül).
Az első lépés a feldolgozott információ beszerzése a Raspberry Pi-ről, vagyis a json formátumban csomagolt predikciók, amelyek középen egy adatbázisba kerülnek, lehetővé téve a felhasználó érzelmi hátteréről szóló statisztika létrehozását egy időszakra. Ezt a csomagot a frontend kapja meg, amely előfizetést használ és csomagokat kap a websocket végponttól. Az egész backend mechanizmus go nyelven épül, mivel ez jól működik a aszinkron feladatoknál, amelyeket a goroutine-ok jól kezelnek.
Az végpont elérésénél a felhasználó regisztrál, és bekerül egy struktúrába, majd megkapja az üzenetét. Mind a felhasználó, mind az üzenet bekerül egy közös hubba, ahonnan az üzenetek továbbítódnak (az előfizetett frontendhez), és ha a felhasználó megszünteti a kapcsolatot (Raspberry Pi vagy frontend), az előfizetése érvénytelenné válik, és eltávolítják a hubból.
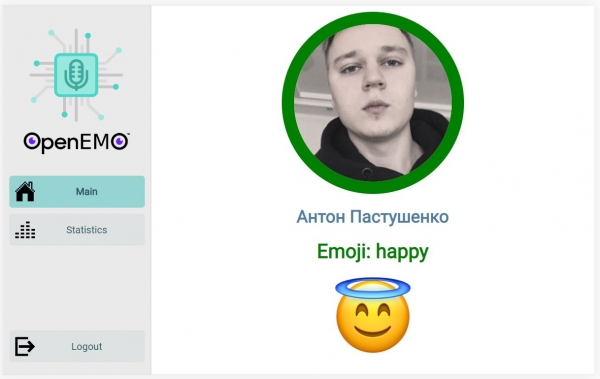
Várjuk a kapcsolatot a backenddelA front-end egy webalkalmazás, amely JavaScript nyelven íródott a React könyvtár segítségével, hogy felgyorsítsa és megkönnyítse a fejlesztési folyamatot. Az alkalmazás célja a Raspberry Pi-n futó back-end algoritmusok által generált adatok vizualizálása. Az oldalon a react-router segítségével valósul meg a szakaszok közötti navigáció, de a legnagyobb érdeklődés a főoldal iránt mutatkozik, ahol folyamatos adatáramlás érkezik a szerverről WebSocket technológia használatával. A Raspberry Pi észleli a hangot, meghatározza, hogy kihez tartozik az adott hang a regisztrált adatbázisban, és elküldi a valószínűségi listát az ügyfélnek. Az ügyfél megjeleníti a legfrissebb adatokat, megjeleníti azt az avatart, aki a legvalószínűbb, hogy a mikrofonba beszélt, valamint a kifejezés érzelmét, ahogyan beszél.

Főoldal frissített predikciókkalZárás
Sajnos nem tudtuk mindent befejezni a terveink szerint, egyszerűen nem volt elég időnk, ezért a fő reményünk a bemutatóra koncentrálódott, hogy minden jól működjön. A prezentáció során beszéltek arról, hogyan működik a rendszer, milyen modelleket használtak, és milyen problémákkal találkoztak. Ezt követően következett a demo része – a szakértők szabadon jártak a teremben, és minden csapatnál megnézték a működő prototípust. Kérdéseket tettek fel nekünk is, mindannyian válaszoltunk a saját részünkben, a laptopon weboldalt hagytunk, és minden tényleg úgy működött, ahogy vártuk.
Megjegyzem, hogy a megoldásunk teljes költsége 150$ volt:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (vagy vásárolhatsz Respeaker lapot) ~ 15$
- Intel NCS 2 ~ 100$
Hogyan lehetne javítani:
- Ügyféloldali regisztráció használata – kérjük, olvasson fel egy véletlenszerűen generált szöveget.
- További modellek hozzáadása: a hang alapján meg lehet határozni a nemet és az életkort.
- Egyszerre megszólaló hangok megkülönböztetése (diarizálás).
Tárhely:

Fáradtak, de boldogok vagyunk.Végül szeretnénk megköszönni a szervezőknek és a résztvevőknek. Más csapatok projektjeiből nekünk tetszett a szabad parkolóhelyek nyomon követése. Ez egy szuper izgalmas tapasztalat volt számunkra a termék mélyebb megértésében és a fejlesztésben. Remélem, hogy a régiókban egyre több izgalmas eseményt fognak szervezni, különösen az AI témában.
Forrás: habr.com
