

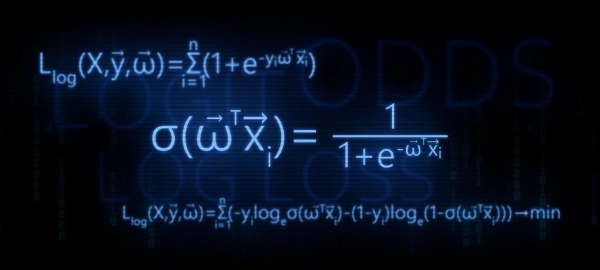
Ebben a cikkben a logisztikus regresszió átalakításainak elméleti megközelítéseit fogjuk elemezni. lineáris regressziós funkciók be. az inverz logit-transzformációs funkciót (más néven a logisztikus válaszfunkciónak is hívják). Ezután a maximum valószínűségi módszer eszközeivel, a logisztikus regresszió modellje szerint, levonjuk a veszteségfüggvényt Logistic Loss, vagy más szavakkal, meghatározzuk azt a funkciót, amelynek segítségével a logisztikus regresszió modelljében a súlyvektor paramétereit meghatározzák.  .
A cikk terve:
- Beszéljünk meg a két változó közötti lineáris kapcsolatról.
- Feltárjuk az átalakítás szükségességét. lineáris regressziós funkciók
 be. logisztikus válaszfunkció
- Elvégezzük az átalakításokat és megérkezünk logisztikus válaszfunkció
- Megpróbáljuk megérteni, miért nem megfelelő a legkisebb négyzetek módszere a paraméterek becslésére. funkciót Logistic Loss
- Használjuk maximális valószínűség módszere célja a paraméterek becslési funkciója :
5.1. Eset 1: funkció Logistic Loss osztálycímkével ellátott objektumokhoz 0 és 1:
5.2. Eset 2: funkció Logistic Loss osztálycímkével ellátott objektumokhoz -1 és +1:
 be. logisztikus válaszfunkció

 funkciót Logistic Loss
 :


A cikk egyszerű példákkal bővelkedik, ahol minden számítást könnyen el lehet végezni fejben vagy papíron, néhány esetben szükség lehet egy számológépre. Tehát készüljetek fel 🙂
Ez a cikk elsősorban kezdő szintű gépi tanulási ismeretekkel rendelkező adatkutatóknak szól.
A cikkben kód is található a grafikák és számítások elkészítésére. Az összes kód nyelven íródott python 2.7. Előzetesen elmagyarázom a használt verzió „újdonságát” — ez a feltétele a híres kurzus elvégzésének a Yandextől egy nem kevésbé híres online oktatási platformon Coursera, és, ahogy az várható, az anyag ennek a kurzusnak a mottójára készült.
01. Lineáris kapcsolat
Teljesen indokolt feltenni a kérdést — mi köze van a lineáris kapcsolatnak a logisztikus regresszióhoz?
Mindez egyszerű! A logisztikus regresszió egy olyan modell, amely a lineáris osztályozóhoz tartozik. Egyszerűbben fogalmazva, a lineáris osztályozó feladata a célértékek előrejelzése  a változókból (regresszorokból)
 . Úgy tekintjük, hogy a jellemzők közötti kapcsolat
 és a célértékek
 lineáris. Ebből ered az osztályozó neve — lineáris. Ha nagyon durván szeretnénk általánosítani, akkor a logisztikus regresszió modelljének alapja a jellemzők közötti lineáris kapcsolat feltevése.
 és a célértékek
 Itt van — a kapcsolat.
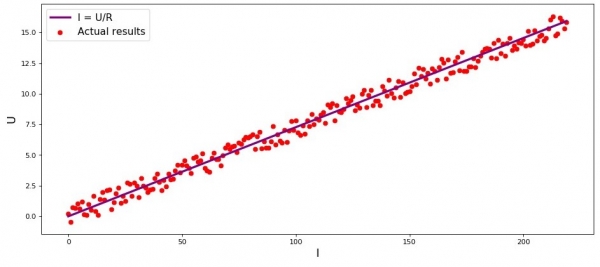
A stúdió első példája, amely helyesen a vizsgált mennyiségek közötti egyenes arányossági kapcsolatra vonatkozik. A cikk előkészítése során egy már sokak által unalmasnak tartott példára bukkantam — az áram erőssége és a feszültség közötti kapcsolat. („Alkalmazott regressziós elemzés”, N.Dreaper, G.Smith). Itt ezt is meg fogjuk vizsgálni.
A következő nyilatkozattal összhangban Ohm törvénye szerint:
 , ahol
 — áram erőssége,
 — feszültség,
 — ellenállás.
Ha nem tudnánk az Ohm törvényét,, akkor empirikusan ismehetnénk meg a kapcsolatot, ha változtatnánk  és mérnénk,
 , miközben
 állandó marad. Akkor látnánk, hogy a kapcsolat grafikonja
 tól
 többé-kevésbé egyenes vonalat ad, amely áthalad az origón. Azt mondtuk, hogy „többé-kevésbé”, mivel a kapcsolat valójában pontos, azonban a méréseink apró hibákat tartalmazhatnak, és emiatt a pontok a grafikonon véletlenszerűen eloszlva lehet, hogy nem esnek pontosan a vonalra.
1. ábra „Közvetett  tól
 »
A grafikon kirajzolásához szükséges kód
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(x_line,y_line,color='purple',lw=3,label='I = U/R')
plt.scatter(x_line,y_dot,color='red',label='Valós eredmények')
plt.xlabel('I', size=16)
plt.ylabel('U', size=16)
plt.legend(prop={'size': 14})
plt.show()
02. A lineáris regressziós egyenlet átalakításának szükségessége
Nézzünk meg egy újabb példát. Tegyük fel, hogy egy bankban dolgozunk, és az a feladatunk, hogy meghatározzuk a hitel visszafizetésének valószínűségét a hitelfelvevő által különböző tényezők függvényében. Az egyszerűség kedvéért csak két tényezőt veszünk figyelembe: a hitelfelvevő havi bérét és a hitel visszafizetésére szánt havi összeget.
A feladat nagyon elméleti, de ezen a példán megérthetjük, hogy miért nem elegendő a megoldásához a lineáris regressziós funkciók, valamint megtudjuk, hogy milyen átalakításokat kell végrehajtani a funkción.
Térjünk vissza a példához. Nyilvánvaló, hogy minél magasabb a fizetés, annál többet tud a hitelfelvevő havonta a hitel törlesztésére fordítani. Ezenkívül egy adott jövedelmi sávon belül ez a kapcsolat viszonylag lineáris lesz. Például vegyük a 60.000 Ft és 200.000 Ft közötti jövedelmi sávot, és tegyük fel, hogy ezen jövedelmi sávban a havi törlesztőrészlet és a jövedelem közötti összefüggés lineáris. Tegyük fel, hogy ezen a jövedelmi sávon belül megállapították, hogy a jövedelem és a törlesztőrészlet arányának nem szabad 3 alá csökkennie, és a hitelfelvevőnek 5.000 Ft-t is kell hagynia. Csak ebben az esetben fogjuk úgy tekinteni, hogy a hitelfelvevő visszafizeti a hitelt a banknak. Ekkor a lineáris regresszió egyenlete így fog kinézni:

ahol  ,
 ,
 ,
 — a hitelfelvevő jövedelme,
 a hitel törlesztőrészlete
 — a hitelfelvevő.
 Az egyenletbe behelyettesítve a jövedelmet és a törlesztőrészletet a rögzített paraméterekkel
döntést hozhatunk a hitelkihelyezésről vagy elutasításról.  Előre is jelezzük, hogy a megadott paraméterek mellett
a lineáris regresszió  a logisztikus válaszfüggvénybennagyon nagy értékeket fog adni, amelyek megnehezítik a hitel visszafizetésének valószínűségének meghatározását. Ezért javasolt a coefficienteinket, mondjuk, 25.000-szer csökkenteni. Ez a transzformáció a coefficientekben nem változtatja meg a hitel kihelyezéséről hozott döntést. Ezt fontold meg a jövőre nézve, most pedig, hogy még érthetőbb legyen, nézzük meg a három potenciális hitelfelvevő helyzetét. 1. táblázat "Potenciális hitelfelvevők" A táblázat létrehozásához szükséges kód
import pandas as pdr = 25000.0 w_0 = -5000.0/r w_1 = 1.0/r w_2 = -3.0/rdata = {'A hitelfelvevő':np.array(['Vaszilij', 'Fedya', 'Lesha']), 'Jövedelem':np.array([120000,180000,210000]), 'Törlesztőrészlet':np.array([3000,50000,70000])}df = pd.DataFrame(data)df['f(w,x)'] = w_0 + df['Jövedelem']*w_1 + df['Törlesztőrészlet']*w_2decision = [] for i in df['f(w,x)']: if i > 0: dec = 'Jóváhagyva' decision.append(dec) else: dec = 'Elutasítva' decision.append(dec) df['Döntés'] = decisiondf[['A hitelfelvevő', 'Jövedelem', 'Törlesztőrészlet', 'f(w,x)', 'Döntés']]
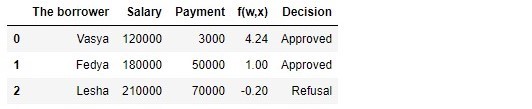
A táblázat adatai alapján Vaszilij, 120.000 Ft-os jövedelemmel, olyan hitelt szeretne felvenni, amelyet havonta 3.000 Ft-ot törleszt. Megállapítottuk, hogy a hitel jóváhagyásához Vaszilij jövedelmének háromszor meg kell haladnia a törlesztőrészletet, és maradnia kell 5.000 Ft-nak is. E követelménynek Vaszilij megfelel:
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'The borrower':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salary':np.array([120000,180000,210000]),
       'Payment':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salary']*w_1 + df['Payment']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Approved'
        decision.append(dec)
    else:
        dec = 'Refusal'
        decision.append(dec)

df['Decision'] = decision

df[['The borrower', 'Salary', 'Payment', 'f(w,x)', 'Decision']]
В соответствии с данными таблицы, Вася при зарплате в 120.000Р хочет получить такой кредит, чтобы ежемесячного гасить его по 3.000Р. Нами было определено, что для одобрения кредита, размер заработной платы Васи должен превышать в три раза размер платежа, и чтобы еще оставалось 5.000Р. Этому требованию Вася удовлетворяет:  Még 106.000 Ft is maradt. Annak ellenére, hogy a számításnál
 csökkentettük a coefficienseket
 25.000-szer, ugyanazt az eredményt kaptuk — a hitel jóváhagyható. Fedya is kap hitelt, de Ljóshának, aki a legjobban keres, mérsékelnie kell a vágyait.
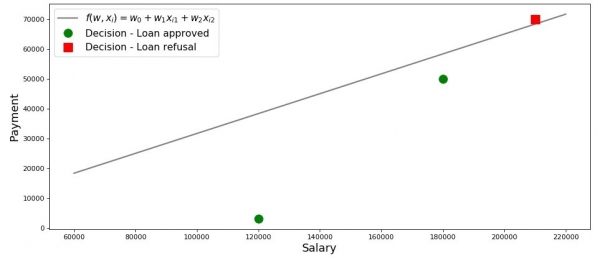
Készítsünk grafikont emiatt.
Grafikon 2 „Adósok osztályozása”
A grafikon rajzolásához szükséges kód
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize=(14,6), dpi=80)
plt.plot(salary, payment, color='grey', lw=2, label='$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color='green', markersize=12, label='Döntés - Hitel jóváhagyva')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color='red', markersize=12, label='Döntés - Hitel elutasítva')
plt.xlabel('Fizetés', size=16)
plt.ylabel('Törlesztés', size=16)
plt.legend(prop={'size': 14})
plt.show()
Tehát a vonalunk, amely a funkciónak megfelelően van felépítve  , elválasztja a „rossz” adósokat a „jóktól”. Azok az adósok, akiknek a vágyai nem egyeznek meg a lehetőségeikkel, a vonal felett állnak (Ljósha), míg azok, akik a modellünk paraméterei szerint képesek visszafizetni a hitelt, a vonal alatt (Vasja és Fedya) helyezkednek el. Másképp fogalmazva — a vonalunk két osztályra osztja az adósokat. Jelöljük meg őket a következőképpen: az osztályhoz
 azzal az adósokkal soroljuk, akik valószínűleg visszafizetik a hitelt, az osztályhoz
 vagy
 azzal az adósokkal soroljuk, akik valószínűleg nem tudják visszafizetni a hitelt.
Összefoglaljuk a következtetéseket ebből az egyszerű példából. Vegyük a pontot  és a pont koordinátáit behelyettesítve a vonal megfelelő egyenletébe
 , három lehetőséget vizsgáljunk meg:
- Ha a pont a vonal alatt van, és mi az osztályhoz soroljuk , akkor a függvény értéke pozitív lesz a tól . Tehát azt mondhatjuk, hogy a hitel törlesztésének valószínűsége a következő tartományban van . Minél nagyobb a függvény értéke, annál magasabb a valószínűség.
- Ha a pont a vonal felett van, és mi az osztályhoz soroljuk vagy , akkor a függvény értéke negatív lesz a tól . Akkor azt fogjuk mérlegelni, hogy a tartozás visszafizetésének valószínűsége a következő tartományban van , és minél nagyobb az érték abszolút értelemben, annál nagyobb a bizalmunk.
- A pont a vonalon van, a két osztály határán. Ilyen esetben a függvény értéke meg fog egyezni -t .
 , akkor a függvény értéke
 pozitív lesz a
 tól
 . Tehát azt mondhatjuk, hogy a hitel törlesztésének valószínűsége a következő tartományban van
 . Minél nagyobb a függvény értéke, annál magasabb a valószínűség.
 vagy
 , akkor a függvény értéke negatív lesz a
 tól
 . Akkor azt fogjuk mérlegelni, hogy a tartozás visszafizetésének valószínűsége a következő tartományban van
 , és minél nagyobb az érték abszolút értelemben, annál nagyobb a bizalmunk.
 meg fog egyezni
 -t
 .
és a hitel visszafizetésének valószínűsége egyenlő m-mérési síkkal és együtthatókkal  nálunk ez nem a levegőből jön, hanem minden szabály szerint, a visszafizetett vagy nem visszafizetett kölcsönökről szerzett adatok alapján határozzuk meg. Valóban, figyelje meg, hogy már most az ismert együtthatók alapján szűrjük a hitelfelvevőket
 . Valójában a logisztikus regressziós modell feladata éppen az, hogy meghatározza azokat a paramétereket
 , amelyek esetén a veszteségfüggvény értéke Logistic Loss minimálisra törekszik. De arról, hogyan számítjuk ki a vektort
 , még a cikk 5. részében fogunk tanulni. Most azonban térjünk vissza a megígért földre — a bankárunkhoz és három ügyfeléhez.
A  tudjuk, kinek érdemes hitelt adni, és kinek nem. De ilyen információval a vezetőhöz nem mehetünk, hiszen tőlünk a kölcsön visszafizetésének valószínűségeit kérték minden hitelfelvevőre vonatkozóan. Mi a teendő? A válasz egyszerű — valahogy át kell alakítanunk a
 , amelynek értékei a tartományban vannak
 egy olyan függvényre, amelynek értékei a tartományban lesznek
 . És ilyen függvény létezik, ezt hívják logisztikus válasz függvénynek vagy logit transzformációnak. Ismerkedjünk meg vele:

Nézzük meg lépésről lépésre, hogyan keletkezik a logisztikus válasz függvény.Megjegyezzük, hogy hátrafelé fogunk haladni, azaz feltételezzük, hogy tudjuk a valószínűség értékét, amely a  tól
 határain belül van, és aztán ezt az értéket az összes számra ki fogjuk „tekerni” a
 tól
 .
03. Kihozzuk a logisztikus válasz függvényt.
1. lépés. A valószínűségi értékeket átkonvertáljuk a tartományba

A függvény átalakításának idejére  be. logisztikus válaszfunkció
 most hagyjuk békén a hitelanalitikusunkat, és helyette ellátogatunk a fogadóirodákhoz. Nem, természetesen nem fogunk fogadni, amit ott érdekesnek találunk, az az értés, például egy 4:1-es esély. Az esélyek, amelyek minden fogadónak ismertek, a "sikerek" és "sikertelenségek" arányát jelentik. A valószínűségek szempontjából az esélyek — a következő esemény bekövetkezésének valószínűsége, osztva a valószínűséggel, hogy az esemény nem következik be. Írjuk fel az esemény bekövetkezésének esélyét:
 :

, ahol  — az esemény bekövetkezésének valószínűsége,
 — az esemény NEM bekövetkezésének valószínűsége
Például, ha a valószínűség, hogy a fiatal, erős és fürge "Szél" nevű ló megelőzi a versenyeken az öreg és gyenge "Matilda" nevű nénit, az egyenlő  , tehát a „Szellő” sikerének esélyei
 refs

 és fordítva, tudva az esélyeket, könnyedén kiszámíthatjuk a valószínűséget
 :

Így megtanultuk, hogyan „fordítsuk” át a valószínűséget esélyekké, amelyek értéke a következőkről szól:  tól
 . Lépjünk egyet tovább, és tanuljunk meg „fordítani” a valószínűséget az egész számok kiterjedésére:
 tól
 .
2. lépés. Alakítsuk a valószínűség értékeit tartományba

Ez a lépés nagyon egyszerű — logaritmizáljuk az esélyeket az Euler számának alapja szerint  és kapjuk:

Most már tudjuk, hogy ha  , akkor a
 érték kiszámítása nagyon egyszerű, és ami még fontosabb, pozitívnak kell lennie:
 . Így van.
Kíváncsiságból ellenőrizzük, hogy ha  , akkor várhatóan negatív értéket látunk
 . Ellenőrizzük:
 . Minden rendben van.
Most már tudjuk, hogyan kell a valószínűség értékét  tól
 átalakítani a számok kiterjedésére:
 tól
 . A következő lépésben mindezt fordítva fogjuk csinálni.
De addig is vegyük tudomásul, hogy a logaritmálási szabályok szerint, tudva a függvény értékét  , kiszámíthatjuk az esélyeket:

Ez a módszer az esélyek meghatározására hasznos lesz a következő lépésben.
3. lépés. Készítsük el a formulát az

meghatározásához.  Tehát megtanultuk, hogy ha tudjuk, hogy
 , akkor megtaláljuk a függvény értékeit
 . De valójában mindent pontosan fordítva kellene csinálnunk — tudva az értéket
 , meg kell találnunk

. Ehhez forduljunk a „fordított esélyfüggvény” fogalmához, amely szerint: A cikkben nem fogjuk elővezetni az említett formulát, de ellenőrizzük a fent említett példa adataival. Tudjuk, hogy 4:1 esélyek mellett (
 ), az esemény bekövetkezésének valószínűsége 0,8 (
 ). Helyettesítjük:
. Ez megfelel a korábban végzett számításainknak. Tovább lépünk.  Az előző lépésben megállapítottuk, hogy

, tehát a fordított esélyfüggvényben cserélhetünk. Kapjuk:  Osszuk el a számlálót és a nevezőt

, ilyen módon:  Biztonság kedvéért, hogy megbizonyosodjunk róla, hogy sehol sem hibáztunk, végezzünk még egy kis ellenőrzést. A 2. lépésben azt határoztuk meg, hogy
 . Tehát ha a
 értéket behelyettesítjük a logisztikus válaszfüggvénybe, azt várjuk, hogy kapunk
 . Helyettesítünk, és kapjuk:

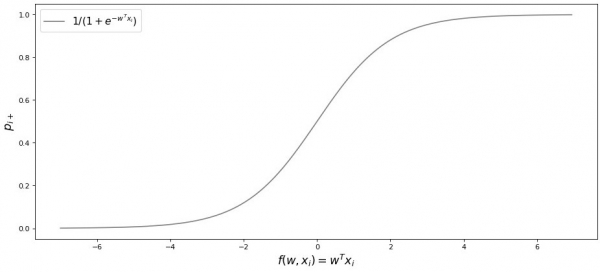
Gratulálok, kedves olvasó, éppen most állítottuk elő és teszteltük a logisztikus válaszfüggvényt. Nézzük meg a függvény grafikonját.
Grafikon 3 „A logisztikus válaszfüggvény”
A grafikon rajzolásához szükséges kód
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
A szakirodalomban ezt a funkciót szigmoid funkció néven is találhatjuk. szigmoid-funkció. A grafikon jól mutatja, hogy az objektum osztályhoz való tartozás valószínűsége viszonylag szűk tartományban változik,  valahol
 tól
 .
Javaslom, hogy térjünk vissza a hitelanalitikusunkhoz, és segítsünk neki a hitelfelmondás valószínűségének kiszámításában, különben kockáztatja, hogy nem kap prémiumot 🙂
2. táblázat „Potenciális kölcsönigénylők”
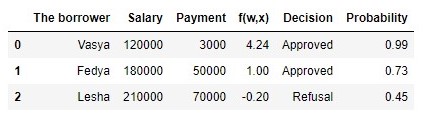
A táblázat adatai alapján Vaszilij, 120.000 Ft-os jövedelemmel, olyan hitelt szeretne felvenni, amelyet havonta 3.000 Ft-ot törleszt. Megállapítottuk, hogy a hitel jóváhagyásához Vaszilij jövedelmének háromszor meg kell haladnia a törlesztőrészletet, és maradnia kell 5.000 Ft-nak is. E követelménynek Vaszilij megfelel:
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Valószínűség'] = proba

df[['A kölcsönigénylő', 'Fizetés', 'Törlesztés', 'f(w,x)', 'Döntés', 'Valószínűség']]
Tehát meghatároztuk a hitel visszatérítésének valószínűségét. Összességében ez így tűnik helyesnek.
Valóban, annak valószínűsége, hogy Vasya havi 120.000 Ft-os fizetéssel havonta 3.000 Ft-ot tud visszafizetni, közel 100%-hoz van. Egyébként meg kell értenünk, hogy a bank akár Ljosának is nyújthat hitelt, amennyiben a bank politikája lehetővé teszi a hitelfelvevők számára, akinek a hitel visszafizetésének valószínűsége meghaladja, nos, mondjuk, a 0,3-at. Csak ilyen esetben a bank nagyobb tartalékot képez a lehetséges veszteségekre.
Meg kell jegyezni, hogy a fizetés és a törlesztés aránya nem lehet kevesebb, mint 3, és a 5.000 Ft-os tartalék is csupán kitalált adat. Ezért az eredeti súlyvektort nem használhattuk fel.  Sokat kellett csökkenteni a koefficiens értékét, és ezért minden koefficienset 25.000-rel osztottunk, ami lényegében azt jelenti, hogy a kimenetet igazítottuk. De ezt szándékosan tettük, hogy a tartalom megértését egyszerűsítsük a kezdeti szakaszban. Az életben azonban nem találni és passzolgatni kell a koefficiens értékeket, hanem meg kell találni azokat. A cikk következő részeiben éppen a paraméterek kiválasztásához szükséges egyenleteket fogjuk levezetni.
 .
04. Legkisebb négyzetek módszere a súlyvektor meghatározásához a logisztikus válaszfunkcióban
 a logisztikus válaszfunkcióban
Már ismerjük ezt a módszert a súlyvektor kiválasztására.  , mint legkisebb négyzetek módszere (MNK) és tulajdonképpen, miért ne használhatnánk ezt a bináris osztályozási problémákban? Valójában semmi sem gátolja. MNK, csak ez a módszer a klasszifikációs problémákban pontosabb eredményeket ad. Logistic LossEnnek elméleti alapja van. Nézzünk először egy egyszerű példát.
Tegyük fel, hogy a modelljeink (amelyek MSE és Logistic Loss) már megkezdték a súlyvektorok keresését  és mi valamilyen lépésnél leállítottuk a számítást. Nem számít, hogy a közepén, végén vagy elején, a lényeg, hogy van már néhány értékünk a súlyvektorokban, és feltételezhetjük, hogy ezen a lépésen
 a két modell súlyvektorai nem különböznek egymástól. Akkor vegyük a kapott súlyokat és illesszük be őket logisztikus válaszfunkció (
 ) egy olyan objektumhoz, amely a
 osztályhoz tartozik. Vizsgáljunk meg két esetet, amikor a kiválasztott súlyvektornak megfelelően a modellünk súlyosan téved, és ezzel ellentétben — a modell nagyon magabiztos abban, hogy az objektum a
 osztályhoz tartozik. Nézzük meg, milyen büntetések "lesznek kiállítva" a használatakor MNK és Logistic Loss.
A büntetések kiszámításához használt kód a választott veszteségfüggvény függvényében
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
A súlyos tévedés esete — a modell az objektumot a  osztályhoz sorolja 0,01 valószínűséggel.
A büntetés a MNK használatakor így alakul:

A büntetés a Logistic Loss használatakor így alakul:

A nagyfokú magabiztosság esete — a modell az objektumot a  0,99 valószínűséggel.
A büntetés a MNK használatakor így alakul:

A büntetés a Logistic Loss használatakor így alakul:

Ez a példa jól illusztrálja, hogy súlyos hiba esetén a veszteségfüggvény Log Loss jelentősen nagyobb büntetést szab ki a modellt, mint a MSE. Most nézzük meg, mik a veszteségfüggvény használatának elméleti előfeltételei Log Loss osztályozási feladatok esetén.
05. Maximális valószínűség módszere és logisztikus regresszió
Ahogy az elején ígértük, a cikk egyszerű példákból bővelkedik. Itt a következő példa és a régi ismerősök — a banki hitelfelvevők: Vasya, Fedya és Lesha.
Mielőtt tovább lépnénk a példával, emlékezzünk arra, hogy az életben tanuló adathalmazon ezreket vagy milliókat kezelünk, tucatnyi vagy száz számú jellemzővel. Itt azonban a számok olyanok, hogy kényelmesen emészthetők a kezdő adatkutató számára.
Térjünk vissza a példához. Tegyük fel, hogy a bank igazgatója úgy döntött, hogy hitelt ad mindenkinek, akinek szüksége van rá, annak ellenére, hogy az algoritmus azt javasolta, hogy ne adja ki Alexnek. És eltelik egy kis idő, és megtudjuk, hogy a három főszereplő közül ki törlesztette a hitelt, és ki nem. Ahogyan várható volt: Vasya és Fedya törlesztette a hitelt, Alex pedig nem. Most képzeljük el, hogy ez az eredmény új tanulási mintaként szolgál számunkra, és addig is mintha minden adatunk eltűnt volna a hitel törlesztésének valószínűségére ható tényezőkről (a kölcsönző havi jövedelme, a havi törlesztőrészlet nagysága). Akkor intuitíven úgy gondolhatjuk, hogy minden harmadik kölcsönző nem törleszti a hitelt, vagyis más szavakkal a hitel visszafizetési valószínűsége a következő kölcsönző esetében  . Ennek az intuitív feltételezésnek van elméleti megerősítése, amely a maximális valószínűség módszerén alapul, amit gyakran neveznek a maximális valószínűség elvének.
Először ismerkedjünk meg a fogalomkörrel.
A minta valószínűsége az a valószínűség, hogy pontosan ilyen mintát, pontosan ilyen megfigyeléseket / eredményeket kapunk, tehát a minta egyes eredményeinek valószínűségeinek szorzataként (például Vasya, Fedya és Alex hitelének egyidejű törlesztése vagy nem törlesztése).
A valószínűségi függvény összeköti a minta valószínűségét az eloszlás paramétereinek értékeivel.
A mi esetünkben a tanulási minta egy általánosított Bernoulli-sémát képvisel, amelyben a véletlen változó mindössze két értéket vehet fel:  vagy
 . Következésképpen a minta valószínűsége felírható a paraméter szerinti valószínűségi függvényként
 így:


A fenti felírás értelmezhető így. A valószínűsége annak, hogy Vasya és Fedya törlesztik a hitelt, egyenlő  , a valószínűsége annak, hogy Alex NEM törleszti a hitelt, egyenlő
 (hiszen a hitel NEM törlesztésére került sor), ezért a három esemény együttes valószínűsége egyenlő
 .
A maximális valószínűség módszere — ez a módszer az ismeretlen paraméter becslésére a valószínűségi függvénytmaximalizálásának módszerével  . A mi esetünkben meg kell találni azt az értéket,
 amelynél az elér egy maximumot.
Honnan is ered az elképzelés – a keresés az ismeretlen paraméter értéke után, amelynél a valószínűségi függvény eléri a maximumot? Az ötlet gyökerei abban a felfogásban rejlenek, hogy a minta az egyetlen, rendelkezésre álló ismeretforrásunk a teljes populációval kapcsolatban. Minden, amit a teljes populációról tudunk, a mintában van jelen. Ezért csak azt tudhatjuk, hogy a minta a legpontosabb tükröződése a teljes populációnak, ami számunkra hozzáférhető. Következésképpen meg kell találnunk azt a paramétert, amelynél a meglévő minta a legvalószínűbb.
Nyilvánvaló, hogy optimalizálási feladatról van szó, amely során egy függvény szélsőértékét kell megtalálnunk. A szélsőérték megtalálásához figyelembe kell venni az elsőrendű feltételt, azaz egyenlővé kell tenni a függvény deriváltját nullával, és megoldani az egyenletet a keresett paraméterre. Azonban a sok tényező szorzataként vett derivált keresése időigényes lehet, ezért egy különleges technikával elkerülhetjük ezt – a logaritmusra való áttéréssel. valószínűségi függvényt. Miért lehetséges ez az áttérés? Figyeljünk arra, hogy nem magát a függvény szélsőértékét keressük, , hanem a szélsőérték pontját, vagyis azt az ismeretlen paramétert,
 . A mi esetünkben meg kell találni azt az értéket,
 amely eléri a maximumot. A logaritmusra való áttéréssel a szélsőérték pontja nem változik (bár a szélsőérték magának eltérő lesz), mivel a logaritmus monoton függvény.
Folytassuk a már említett példát a hitelekkel Vanya, Fedya és Lesha esetében. Először térjünk át a valószínűségi függvény logaritmusára.:

Most már könnyedén deriválhatjuk a kifejezést a  :

Végül tekintsük az elsőrendű feltételt – egyenlővé tesszük a függvény deriváltját nullával:

Így intuitív valószínűségi értékelésünk a hitel visszafizetésére  elméletileg megalapozottá vált.
Remek, de mit kezdjünk most ezzel az információval? Ha azt feltételezzük, hogy minden harmadik kölcsönző nem fizeti vissza a pénzt a banknak, akkor az utóbbi elkerülhetetlenül csődbe megy. Bár így van, de ha a hitel visszafizetési valószínűsége egyenlő,  Nem vettük figyelembe a hitel visszafizetésére ható tényezőket: a kölcsönvevő fizetése és a havi törlesztőrészlet nagysága. Emlékezzünk arra, hogy korábban kiszámítottuk a hitel visszafizetésének valószínűségét minden ügyfél esetében e tényezők figyelembevételével. Logikus, hogy a valószínűségeink eltértek az állandó értékétől.
 .
Határozzuk meg a minták valószínűségét:
Kód a minták valószínűségeinek számításához
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'A minta valószínűsége állandó p=2/3 értéknél:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'A minta valószínűsége számított p értéknél:', round(likelihood(y,p_log_response),3)
A minta valószínűsége állandó értéknél  :

A minta valószínűsége a hitel visszafizetésének valószínűsége alapján, a tényezők figyelembevételével  :


A minta valószínűsége, amely a tényezők figyelembevételével lett kiszámítva, magasabb volt, mint a valószínűség állandó értéke. Mit jelent ez? Azt jelenti, hogy a tényezők ismerete lehetővé tette a hitel visszafizetési valószínűségének pontosabb meghatározását minden ügyfél számára. Ezért a következő hitel kiadása során helyesebb lenne a kötelezettség visszafizetési valószínűségének értékelési modelljét használni, amelyet a cikk 3. részének végén javasoltunk.
De akkor, ha maximalizálnunk kell a minta valószínűségi függvényét, akkor miért ne használhatnánk egy algoritmust, amely valószínűségeket adna Vasinek, Fédinek és Ljosának, például 0.99, 0.99 és 0.01 értékekkel. Lehetséges, hogy egy ilyen algoritmus jól teljesít a tanító mintán, mivel közelíti a minta valószínűségének értékét.  , Ám de először is, ennek az algoritmusnak valószínűleg nehézségei lesznek az általánosíthatósággal, másodszor pedig biztosan nem linearitás jellemzi. Ha a túltanulás elleni módszerek (éppúgy mint a gyenge általánosítóképesség) nyilvánvalóan nem része ennek a cikknek, akkor a második pontról nézzük meg részletesebben. Ehhez elég, ha egy egyszerű kérdésre válaszolunk. Vajon az, hogy a hitel visszafizetési valószínűsége Vasya és Fedya esetében megegyezik a tudomásunkra jutott tényezők figyelembevételével? Egészséges észjárás szempontjából természetesen nem, nem lehet. Hiszen Vasya a havi bérének 2,5%-át fogja a hitel visszafizetésére fordítani, míg Fedya majdnem 27,8%-át. A 2. ábra „Ügyfelek osztályozása” alapján láthatjuk, hogy Vasya jelentősen messzebb helyezkedik el a osztályokat elválasztó vonaltól, mint Fedya. Végül pedig tudjuk, hogy a funkció
 a Vasya és Fedya számára különböző értékeket vesz fel: 4,24 Vasya esetében és 1,0 Fedya esetében. Ha Fedya például lényegesen többet keresne, vagy kisebb hitelt kérne, akkor a Vasya és Fedya hitelvisszafizetési valószínűsége hasonló lenne. Más szóval, a lineáris függést nem lehet átejtni. Ha valóban kiszámoltuk volna a tényezőket
 , és nem csak úgy a levegőből vettük volna őket, akkor bátran állíthatnánk, hogy az értékeink
 a legjobban lehetővé teszik, hogy megbecsüljük a hitel visszafizetésének valószínűségét minden adós esetében, de mivel úgy beszéltük meg, hogy a tényezők meghatározását
 minden szabály szerint végeztük, így azt is fogjuk tartani – a tényezőink lehetővé teszik a legjobb becslés megadását a valószínűségről 🙂
De elkalandoztunk. Ebben a részben meg kell értenünk, hogyan határozzuk meg a súlyvektort  , amely szükséges a hitel visszafizetésének valószínűségének értékeléséhez minden adós esetében.
Röviden összefoglalva, milyen arsenállal indulunk a tényezők keresésére  :
1. Feltételezzük, hogy a célváltozó (előrejelzési érték) és az eredményre ható tényező közötti kapcsolat – lineáris. Ezért alkalmazzuk a logisztikus válaszfüggvényben a következő formát  , amelynek vonala a tárgyakat (ügyfeleket) osztályokba (képességek a hitel visszafizetésére és nem képességek) osztja. Esetünkben az egyenlet a következő formát öltötte
 és
 vagy
 2. Használjuk
 .
a logit-visszááltoztató függvényt a tárgy osztályhoz való tartozásának valószínűségének meghatározásához a következő formát  3. Az oktatási mintánkat a generalizált megvalósulásként tekintjük
 .
3. Мы рассматриваем нашу обучающую выборку как реализацию обобщенной Bernoulli sémák, azaz minden egyes objektumhoz generálódik egy véletlen változó, amelynek valószínűsége  (minden objektum számára a sajátja) 1 értéket vesz fel, és valószínűséggel
 – 0.
4. Tudjuk, hogy maximalizálni kell a minta valószínűségi függvényét figyelembe véve az elfogadott tényezőket, hogy a kapott minta a lehető legvalószínűbb legyen. Más szavakkal, olyan paramétereket kell kiválasztanunk, amelyek mellett a minta a legvalószínűbb. Az általunk kiválasztott paraméter a hitel visszafizetésének valószínűsége  , amely viszont ismeretlen együtthatóktól függ
 . Tehát meg kell találnunk egy olyan súlyvektort
 , amely mellett a minta valószínűsége maximális.
5. Tudjuk, hogy a maximalizáláshoz a minta valószínűségfüggvényét használhatunk maximális valószínűség módszere. És ismerjük az összes trükköt e metódus alkalmazásához.
Ilyen soklépcsős folyamat :)
Most emlékezzünk vissza, hogy a cikk elején kétféle veszteségi függvényt akartunk bemutatni Logistic Loss attól függően, hogy hogyan jelölik az objektumok osztályait. Az a megszokás, hogy a két osztályos klasszifikációs feladatokban az osztályokat  és
 vagy
 . A megnevezés függvényében a kimenet a megfelelő veszteségi függvény lesz.
1. eset. Az objektumok klasszifikálása és
 és

Korábban, a minta valószínűségének meghatározásakor, amelyben a hitel visszafizetésének valószínűségét a tényezők és megadásra kerülő együtthatók alapján számoltuk ki  , alkalmaztuk a következő képletet:

Valójában  ez az érték a logisztikus válaszfüggvény
 megadott súlyvektor mellett

Így semmi nem akadályoz meg minket abban, hogy a minta valószínűségfüggvényét így írjuk fel:

Előfordul, hogy néhány kezdő elemzőnek nehéz gyorsan megérteni, hogyan működik ez a függvény. Nézzük meg 4 rövid példát, amelyek mind világossá teszik:
1. Ha  (azaz a tanulási mintának megfelelően az objektum a +1 osztályhoz tartozik), míg algoritmusunk
 az objektum osztályhoz való hozzárendelésének valószínűségét
 0,9-re becsli, akkor ez a minta valószínűségének része így fog számolódni:

2. Ha  , és
 , akkor a számítás így fog alakulni:

3. Ha  , és
 , akkor a számítás így fog alakulni:

4. Ha  , és
 , akkor a számítás így fog alakulni:

Nyilvánvaló, hogy a valószínűségfüggvény maximalizálódni fog az 1-es és 3-as esetekben, vagy általánosan - a helyes osztályokhoz való hozzárendelési valószínűségek kitalálásakor  .
Mivel a valószínűség osztályhoz való hozzárendelésének meghatározásakor  Csak a koefficiensokról nem tudunk.
 , ezért őket fogjuk keresni. Ahogy fentebb említve lett, ez egy optimalizálási feladat, amelynek kezdetben meg kell találnunk a valószínűségi függvény deríváltját a súlyvektor mentén.
 . Azonban először érdemes leegyszerűsítenünk a feladatot: a deríváltat a logaritmus alapján keresjük. valószínűségi függvényt.

Miért a logaritmuzálás után, a logisztikai hiba függvényében, megváltoztattuk a jelet  Gyorsan emlékezzünk vissza, hogyan működik a moduláris aritmetika. Az óra már egy ismert koncepció. Az órák használata
 . Ez egyszerű, mivel a modell minőségének becslési feladatainál általában a függvény értékének minimalizálását célozzuk, ezért a kifejezés jobb oldalát
 megfordítva, most minimalizáljuk a függvényt.
Valójában, most, a szemeink előtt, egy szenvedélyes módon létrehozott veszteségfüggvényről van szó – Logistic Loss a két osztályos tanítómintához:  és
 .
Most, a koefficiens megtalálásához, csupán meg kell találnunk a deríváltat logisztikai hiba függvényében , és ezt követően, numerikus optimalizációs módszerekkel, mint például a gradienscsökkenés vagy a sztochasztikus gradienscsökkenés, meg kell találni a legoptimálisabb koefficienseket.  . De figyelembe véve a már nem kicsi cikk térfogatát, javasolt a differenciálás önálló elvégzése, vagy talán ez lesz a következő cikk témája, amely sok matematikát tartalmaz, részletes példák nélkül.
2. eset. Tárgyak klasszifikálása és
 és

A megközelítés ugyanaz lesz, mint a klasszifikációnál  és
 , de a veszteségfüggvényhez vezető út Logistic Loss, bonyolultabb lesz. Kezdjük. A valószínűségi függvényhez a „ha…, akkor…”. Tehát, ha
 -dik objektum az osztályba tartozik
 , akkor a minta valószínűségének kiszámításához a
 valószínűséget használjuk, ha az objektum az osztályhoz tartozik
 , akkor a valószínűségbe beillesztjük
 . Így néz ki a valószínűségi függvény:

Kézben áttekintjük, hogyan működik ez. Négy esetet vizsgálunk:
1. Ha  és
 , akkor a mintába a valószínűség „bekerül”

2. Ha  és
 , akkor a mintába a valószínűség „bekerül”

3. Ha  és
 , akkor a mintába a valószínűség „bekerül”

4. Ha  és
 , akkor a mintába a valószínűség „bekerül”

Nyilvánvaló, hogy az 1. és 3. esetben, amikor a valószínűségeket a változó helyesen határozta meg az algoritmus, a valószínűségi függvény maximalizálódik, ezt szerettük volna elérni. Azonban ez a megközelítés meglehetősen terjedelmes, és a következőket egy kompaktabb formát fogunk megvizsgálni. De először logaritmizáljuk a valószínűségi függvényt a jel megváltoztatásával, mivel most minimalizálni fogjuk azt.

Helyettesítsük be a  kifejezést.
 :

Egyszerűsítjük a logarithmus alatti jobb kifejezést egyszerű aritmetikai módszerekkel és megkapjuk:

Most pedig eljött az idő, hogy megszabaduljunk az operátortól „ha…, akkor…”. Vegyük észre, hogy amikor az objektum  az osztályhoz tartozik
 , akkor a logarithmus alatti kifejezés, a nevezőben,
 hatványra emelkedik
 valószínűséget használjuk, ha az objektum az osztályhoz tartozik
 , akkor $e$ hatványra emelkedik
 . Következésképpen a hatvány írását egyszerűsíthetjük — az eseteket egybe vonva:
 . Ekkor a logisztikai hiba funkció a következőképpen alakul:

A logarithmus tényezői szabályai szerint megfordítjuk a törtszámot és kivesszük a " " (mínusz) jelet a logarithmus elé, így kapjuk:

Előttetek áll a veszteségfüggvény logistic Loss, amely a tanulási mintával dolgozó objektumokkal alkalmazható, amelyek az alábbi osztályokhoz tartoznak:  és
 .
Nos, ebben a pillanatban búcsúzom, és befejezzük a cikket.
A szerző előző munkája — „A lineáris regresszió egyenlete mátrix formába hozva”
Segédanyagok
1. Irodalom
1) Alkalmazott regressziós elemzés / N. Draper, G. Smith – 2. kiadás – Moszkva: Pénzügyek és statisztika, 1986 (angolról fordítva)
2) Valószínűségi elmélet és matematikai statisztika / V.E. Gmurmán — 9. kiadás — Moszkva: Felsőoktatási intézmény, 2003
3) Valószínűségi elmélet / N.I. Csernova — Novoszibirszk: Novoszibirzki Állami Egyetem, 2007
4) Üzleti elemzés: az adatoktól a tudásig / Paklin N. B., Oreskov V. I. — 2. kiadás — Szentpétervár: Peter, 2013
5) Data Science: Az adatok tudománya nulláról / Joel Grass — Szentpétervár: BKHV Peterburg, 2017
6) Gyakorlati statisztika a Data Science szakemberek számára / P.Bruce, E.Bruce — Szentpétervár: BKHV Peterburg, 2018
2. Előadások, tanfolyamok (videó)
1)
2)
3)
4)
5)
3. Internetes források
1)
2)
3)
4)
5)
6)
7)
8)
Forrás: habr.com
