

Helló, Habr!
Tavaly ősszel a Kaggle-en zajlott a Quick Draw Doodle Recognition verseny, amelyen mások mellett részt vett a R-szakértők csapata is, amelynek tagjai: , és . A versenyt nem részleteznénk, erről már írtak a .
Ezúttal nem lett érmes a csapat, de sok értékes tapasztalatot szereztünk, ezért szeretnénk beszámolni a legérdekesebb és leghasznosabb dolgokról a Kaggle-en és a mindennapi munkában. A tárgyalt témák között szerepel: a nehéz élet a OpenCV, JSON-ok parsolása (ezekben a példákban a C++ kód integrációja R szkriptekbe vagy csomagokba a Rcppsegítségével), a szkriptek paraméterezése és a végső megoldás dokkerizálása. A bejegyzés teljes kódja futtatható formában elérhető a .
Tartalom:
1. Hatékony adatok betöltése CSV-ből a MonetDB adatbázisba
Ebben a versenyben az adatok nem kész képek formájában érkeztek, hanem 340 CSV-fájl formájában (minden osztályhoz egy fájl), amelyek JSON-okból állnak, amelyek a pontok koordinátáit tartalmazzák. Ezeket a pontokat összekötve vonalakkal megkapjuk a végső, 256x256 pixel méretű képet. Minden egyes bejegyzéshez meg van adva a címke, hogy a képet a gyűjtési időpontban használt klasszifikáló helyesen azonosította-e, az alkotó lakóhelyének kódja, egyedi azonosító, időbélyeg és a fájl nevével megegyező osztály neve. Az adatok egyszerűsített verziója 7.4 GB-ot nyom az archívumban és körülbelül 20 GB-ot a kibővítés után, a teljes adatok pedig kibővítve 240 GB-ot foglalnak el. A szervezők garantálták, hogy mindkét verzió ugyanazokat a rajzokat reprodukálja, tehát a teljes verzió redundáns. Mindenesetre 50 millió kép tárolása grafikai fájlokként vagy tömbökként azonnal nem bizonyult kifizetődőnek, és úgy döntöttünk, hogy az összes CSV-fájlt az archívumból train_simplified.zip az adatbázisba öntjük, és a szükséges méretű képeket „valós időben” generáljuk minden batch-hez.
Az adatbázis-kezelő rendszert jól bevált , saját ablakos funkciószabványát (a Segment Tree Aggregation algoritmus alapján), a lekérdezések végrehajtásához használt vektorizált motort (a Hyper-Pipelining Query Execution algoritmus alapján), valamint a reguláris kifejezések feldolgozóját a, nevezetesen a R-re vonatkozó megvalósítás csomag formájában . A csomag tartalmazza az adatbázis-szerver beágyazott verzióját, és lehetővé teszi a szerver közvetlen indítását egy R-munkamenetből, ahol dolgozhatunk vele. Az adatbázis létrehozása és a kapcsolódás egyetlen parancs végrehajtásával történik:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Két táblát kell létrehoznunk: egyet az összes adat számára, a másikat pedig a feltöltött fájlokkal kapcsolatos adminisztratív információ számára (ez hasznos lesz, ha valami nem úgy alakul, ahogy kellene, és a folyamatot több fájl feltöltése után újra kell kezdeni):
Táblák létrehozása
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Az adatok adatbázisba való feltöltésének leggyorsabb módja a CSV-fájlok közvetlen másolása SQL segítségével — a parancs COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, ahol tablename — a tábla neve és path — a fájl elérési útja. Az archívum használata során kiderült, hogy a beépített megvalósítás unzip R-ben nem működik megfelelően néhány fájllal, ezért a rendszeres unzip (a getOption("unzip")).
paraméter segítségével
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
A funkció, amelybe adatokat írunk Abban az esetben, ha a táblát meg kell változtatni az adatbázisba írás előtt, elegendő átadni az argumentumban a preprocess
funkciót, amely átalakítja az adatokat.
Kód az adatok folyamatos feltöltésére az adatbázisba:
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Az adatok feltöltési ideje változhat a használt tároló sebességétől függően. A mi esetünkben a SSD-n belüli olvasás és írás, vagy az USB flash meghajtóról (forrásfájl) SSD-re (adatbázis) kevesebb mint 10 percet vesz igénybe.
Néhány másodpercre van szükség ahhoz is, hogy létrehozzunk egy oszlopot a szöveges címke klaszterével és egy index oszlopot (ORDERED INDEX) a sorok számával, amelyet a megfigyelések kiválasztásához használnak a batch-ek létrehozásakor:
További oszlopok és index létrehozása
message("Generate lables")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)")
A feladat megoldásához, amely a "on-the-fly" batch létrehozását jelenti, maximális sebességet kellett elérnünk az adatbázis táblázataiból való véletlenszerű sorok kinyerésében. doodles. Ehhez három trükköt alkalmaztunk. Az első az volt, hogy csökkentettük azonosító megfigyelés tárolásához használt típus méretét. Az eredeti adathalmazon az ID tárolásához biginttípust használnak, de a megfigyelések száma lehetővé teszi, hogy azonosítóikat, amelyek sorszámokká egyenlők, a típusban tároljuk egész. A keresés ezáltal lényegesen gyorsabbá válik. A második trükk az volt, hogy ORDERED INDEX — ezt a megoldást empirikusan fejlesztettük ki, végigpróbálva minden elérhető . A harmadik az paraméterezett lekérdezések használatában rejlik. A módszer lényege, hogy egyszeri végrehajtással PREPARE parancsot adunk ki, majd ezt követően az előkészített kifejezés felhasználására kerül sor az azonos típusú lekérdezések sorozatának létrehozásakor, de valójában a nyereség a egyszerű SELECT körülbelül statisztikai hibahatáron belül volt.
Az adatok betöltési folyamata nem fogyaszt többet, mint 450 MB RAM. Ezért a leírt megközelítés lehetővé teszi gigabájtos méretű adatállományok kezelését szinte bármilyen költségvetés-barát hardveren, beleértve néhány egylapos számítógépet is, ami meglehetősen lenyűgöző.
Még el kell végezni a sebességméréseket (véletlenszerű) adatok kinyerésére, és értékelni kell a skálázhatóságot különböző méretű batchek esetén:
Adatbázis benchmark
library(ggplot2)

set.seed(0)
# Kapcsolódás az adatbázishoz
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# A lekérdezés előkészítésének funkciója a szerveroldalon
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Adatok kinyerésének funkciója
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Mérési folyamat
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# A benchmark paraméterei
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("medián idő, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 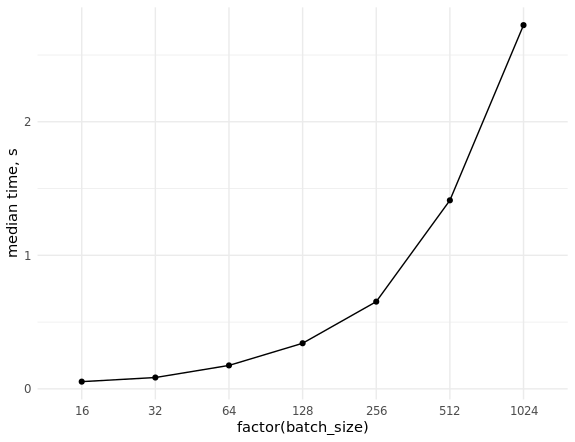
2. A batchek előkészítése
A batchek előkészítésének teljes folyamata a következő lépésekből áll:
- Több JSON-parsing, amelyek vektorokat tartalmaznak a pontok koordinátáival.
- Színes vonalak rajzolása a pontok koordinátái alapján a kívánt méretű képen (például 256×256 vagy 128×128).
- A kapott képek átalakítása tenzorra.
A Python kernel-ek közötti verseny keretében a feladatot főleg a következő eszközökkel oldották meg OpenCV. Az R nyelven a legnyilvánvalóbb analógja a következőképpen néz ki:
A JSON tenzorra való átalakításának megvalósítása R-ben
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # JSON elemzés
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Ideiglenes fájl törlése a függvény befejeztével
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Üres grafikon
  plot.new()
  # A grafikon ablak mérete
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Vonalak színei
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # A kép átalakítása 3 dimenziós tömbbé
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # 3 dimenziós képtömbök egyesítése 4 dimenziós tenzorrá
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
A rajzolás a R standard eszközeivel történik, ideiglenes PNG fájlba mentve, amely a memóriában (Linux alatt a R ideiglenes könyvtárai az /tmp, memóriában levő könyvtárban található). Ezután ezt a fájlt egy háromdimenziós tömbként olvassuk be, amely 0 és 1 közötti számokat tartalmaz. Ez fontos, mivel a megszokott BMP formátumot a szín hex kódokkal rendelkező raw tömbként olvasnák be.
Teszteljük az eredményt:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 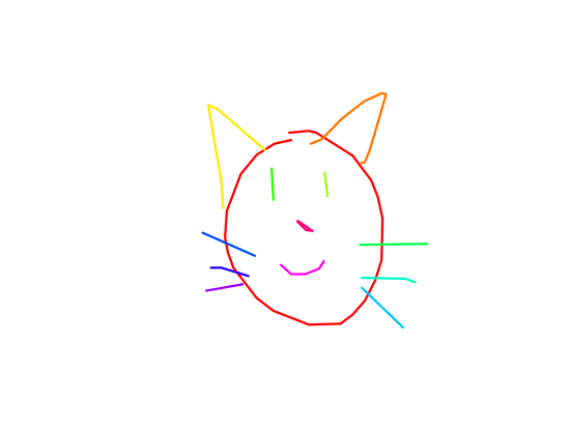
A batch így fog összeállni:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Ez a megvalósítás nem tűnt optimálisnak, mivel a nagyobb batch-ek létrehozása rendkívül sok időt vett igénybe, és úgy döntöttünk, hogy a kollégák tapasztalatát felhasználva igénybe vesszük egy erőteljes könyvtárat. OpenCVAkkoriban nem volt kész csomag R-hez (most sincs), ezért egy minimális implementációt írtunk a C++ nyelven a szükséges funkciók integrálásához R kódba. Rcpp.
A feladat megoldásához a következő csomagokat és könyvtárakat használtuk:
OpenCV a képek kezeléséhez és vonalak rajzolásához. Használtuk a már telepített rendszerkönyvtárakat és fejléc fájlokat, valamint dinamikus linkelést.
xtensor többszörös tömbök és tenzorok kezelésére. Az azonos nevű R-csomagban található fejléceket használtuk. A könyvtár lehetővé teszi a többszörös tömbök kezelését, akár sor- akár oszlop fő sorrendben.
ndjson JSON elemzésére. Ezt a könyvtárat a következő szolgáltatáshoz használják xtensor automatikusan a projektben lévő megfelelő fájlok esetén.
RcppThread a JSON-ból származó vektorok több szálon történő feldolgozásának megszervezésére. Az ehhez a csomaghoz biztosított fejléceket használtuk. A népszerűbb RcppParallel csomag többek között beépített ciklusmegszakítási mechanizmussal (interrupt) rendelkezik.
Érdemes megjegyezni, hogy xtensor egyszerűen kincsnek bizonyult: azon kívül, hogy széleskörű funkciókkal és magas teljesítménnyel bír, a fejlesztői meglehetősen figyelmesek voltak, és gyorsan, részletesen válaszoltak a felmerülő kérdésekre. Segítségükkel sikerült megvalósítani az OpenCV mátrixok xtensorba való átalakítását, valamint a háromdimenziós képtenzorok négydimenziós megfelelő méretű tenzorrá való egyesítését (tulajdonképpen egy batch).
Tanulmányi anyagok Rcpp, xtensor és RcppThread témakörben
A rendszerfájlokat és a telepített könyvtárakkal való dinamikus linkelést használó fájlok fordításához a csomagban megvalósított bővítménymechanizmust használtuk Rcpp. Az útvonalak és flagok automatikus megkereséséhez a népszerű linux-eszközt használtuk pkg-config.
Rcpp bővítmény megvalósítása az OpenCV könyvtár használatához
Rcpp::registerPlugin("opencv", function() {
  # Lehetséges csomagnevek
  pkg_config_name <- c("opencv", "opencv4")
  # A pkg-config eszköz bináris fájlja
  pkg_config_bin <- Sys.which("pkg-config")
  # Az eszköz ellenőrzése a rendszeren
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Az OpenCV pkg-config konfigurációs fájljának ellenőrzése
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV konfiguráció a pkg-config számára nem található", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
A bővítmény működése során a fordítás során a következő értékek kerülnek beillesztésre:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
A JSON parsing implementation and batch formation code for transmission to the model is provided under the spoiler. First, we add the local project directory to find header files (needed for ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementation of JSON to tensor conversion in C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
This code should be placed in a file src/cv_xt.cpp and compiled with the command Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); it will also require nlohmann/json.hpp a . The code is divided into several functions:
to_xt— a templated function for converting an image matrix (cv::Mat) into a tensorxt::xtensor;parse_json— function that parses a JSON string, extracts point coordinates, packing them into a vector;ocv_draw_lines— draws multi-colored lines from the resulting vector of points;process— combines the above functions and adds the ability to scale the resulting image;cpp_process_json_str— a wrapper around the functionprocess, which exports the result to an R object (multi-dimensional array);cpp_process_json_vector— a wrapper around the functioncpp_process_json_str, which allows processing a string vector in multi-threaded mode.
For drawing multi-colored lines, the HSV color model was used with subsequent conversion to RGB. Let's test the result:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 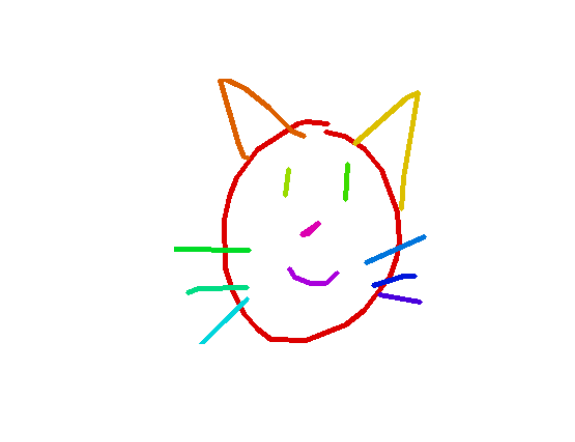
Comparison of the execution speed of implementations in R and C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Benchmark parameters
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Measuring
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("median time, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 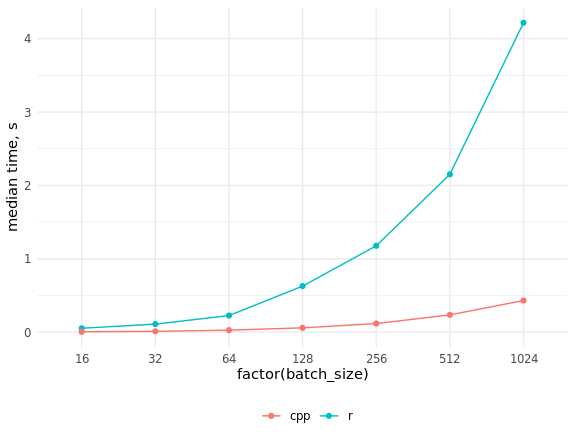
Ahogy látható, a sebességnövekedés jelentős volt, és a C++ kód párhuzamosításával nem lehet utolérni az R kódot.
3. Iterátorok az adatok batch-ből való kiolvasásához
A R nyelv megérdemelt hírnevének örvend az adatok RAM-ban való feldolgozása terén, míg a Pythonra inkább a folyamatban lévő adatok iteratív feldolgozása jellemző, amely lehetővé teszi a külső memórián végzett számítások egyszerű és kényelmes megvalósítását. A feladatunk szempontjából klasszikus és releváns példa ezekre a számításokra a mély neurális hálózatok, amelyeket a gradiensleszállítás módszerével tanítanak, minden lépésben a gradiens közelítésével, kis megfigyeléscsomagok, vagy mini-batch formájában.
A Pythonban írt mélytanulási keretrendszerek speciális osztályokat tartalmaznak, amelyek adatiterátorokat valósítanak meg: táblák, mappában található képek, bináris fájlformátumok stb. Kész megoldások is elérhetők, vagy saját megoldásokat is írhatunk specifikus feladatokhoz. Az R-ben ki tudjuk használni a Python könyvtárának összes lehetőségét mleap különböző backendjével az azonos nevű csomagon keresztül, amely viszont a reticulatecsomag fölött működik. Az utóbbi egy külön nagy cikket érdemel; nemcsak lehetővé teszi Python kód futtatását R-ből, hanem biztosítja az objektumok átvitelét az R- és Python-sessionök között automatikusan elvégezve az összes szükséges típuskonverziót.
A kötelező memória POZ-ban tartási szükségesség alól a MonetDBLite használatával megszabadultunk, az összes "neurális hálózati" munkát az eredeti Python-kód fogja végezni, nekünk csupán adatiterátort kell írni, mivel ezen a helyzeten nincs kész válasz sem R-re, sem Pythonra. Az elvárások lényegében csupán kettő: folyamatos ciklusban kell batch-eket visszaadnia, és meg kell őriznie az állapotát az iterációk között (az utóbbit R-ben a legegyszerűbb módon zárványok segítségével valósítható meg). Korábban az iterátor belsejében kifejezetten kellett átalakítani az R tömböket numpy tömbökké, de a csomag aktuális verziója mleap magától megteszi ezt.
A tanító és validáló adatokhoz az iterátor a következő lett:
Iterátor a tanító és validáló adatokhoz
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
A függvény bemeneti változóként fogadja a DB-vel való kapcsolatot, a felhasznált sorok számát, a kategóriák számát, a batch méretét, a skálát (scale = 1 ami a 256x256 képpont méretű képek megrajzolásának felel meg, scale = 0.5 - 128x128 képpont), a színesség jelzőt (color = FALSE ami a szürkeárnyalatos képek megrajzolását határozza meg, ha használják color = TRUE minden egyes vonás új színnel rajzolódik ki) és egy előfeldolgozási jelző a képfeldolgozó hálózatok számára, amelyeket az imagenet-en képeztek. Az utóbbira azért van szükség, hogy a pixelértékeket a [0, 1] intervallumról a [-1, 1] intervallumra skálázzuk, amelyet a beépített modellek tanításához használtak mleap modellek.
A külső függvény tartalmaz egy típusellenőrzést az argumentumok számára, táblázatot data.table véletlenszerűen kevert sorozatszámokból samples_index és a batch számokról, egy számlálóról és a maximális batch számról, valamint egy SQL-kifejezést az adatok betöltésére az adatbázisból. Ezen kívül definiáltunk egy gyors analógot a keras::to_categorical(). Az oktatáshoz szinte az összes adatot használtuk, hagyva fél százalékot az érvényesítésre, így az epoch mérete a steps_per_epoch a meghíváskor: keras::fit_generator(), és a feltétel if (i > max_i) csak az érvényesítő iterátorhoz lépett életbe.
A belső függvény a sorok indexeinek kiválasztásával foglalkozik a következő batch számára, az adatbázisból való rekordok betöltésével batch számláló növelésével, JSON-ok elemzésével (a cpp_process_json_vector(), C++ nyelven írt funkció) és megfelelő képi tömbök létrehozásával. Ezután one-hot vektorokat hozunk létre a class label-ekkel, a pixelértékek tömbjei és a címkék összevonásra kerülnek egy listába, amely a visszatérési érték. data.table A munka felgyorsítása érdekében indexek létrehozását és referencián keresztüli módosítást alkalmaztunk - ezek nélkül a csomag teljesítménye jelentősen csökkent a jelentős adatmennyiséggel való hatékony munkához R-ben. data.table A sebességmérések eredményei egy laptopos Core i5-ös gépen a következőképpen alakulnak:
A benchmark iterátor
Benchmark iterator
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indexes for the training sample
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indexes for the validation sample
val_ind <- ind[-train_ind]
rm(ind)
# Scale factor
scale <- 0.5

# Measurement execution
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 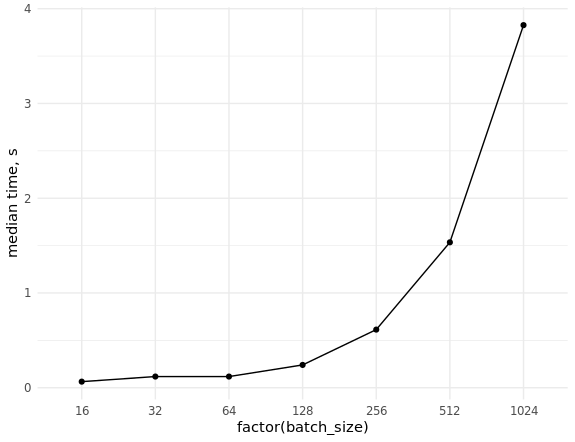
Ha elegendő memória áll rendelkezésre, a teljesítmény jelentősen növelhető az adatbázis RAM-ba való helyezésével (a mi feladatunkhoz 32 GB elegendő). Linuxban alapértelmezés szerint egy olyan partíciót csatolunk, /dev/shm, amely a RAM térfogatának akár felét is elfoglalja. További memória is kijelölhető a /etc/fstab, így a bejegyzés a következő formátumot kapja: tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Feltétlenül újra kell indítani és ellenőrizni kell az eredményt a parancs futtatásával. df -h.
A tesztadatok iterátora sokkal egyszerűbb, mivel a tesztadatok teljes egészében a RAM-ba kerülnek:
Tesztadatok iterátora
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. A modell architektúrájának kiválasztása
Az első használt architektúra a , amelynek jellemzői a bejegyzésben találhatók. Ez az alapértelmezett csomagban elérhető mleap , tehát a róla elnevezett R csomagban is megtalálható. De amikor megpróbáltuk használni az egysávos képekkel, furcsa dolog derült ki: a bemeneti tenzornak mindig a következő dimenzióval kell rendelkeznie: (batch, height, width, 3), tehát a csatornák számát nem lehet megváltoztatni. A Pythonban ilyen korlátozás nincs, ezért sietve írtuk meg a saját megvalósításunkat ennek az architektúrának az alapján, követve az eredeti cikket (dropout nélkül, ami a keras-os változatban megtalálható):
mobilenet v1 architektúra
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Ez a megközelítés nyilvánvaló hátrányokat rejt. Sok modellt szeretnénk tesztelni, de nem szeretnénk minden architektúrát kézzel újraírni. Emellett nem tudtuk használni az Imagenet-en előképzett modellek súlyait sem. Mint általában, a dokumentáció tanulmányozása segített. A " get_config() " lehetővé teszi a modell leírásának megszerzését szerkeszthető formátumban (base_model_conf$layers — a standard R-style list), and the function from_config() performs the reverse transformation to a model object:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Now it is easy to write a universal function for retrieving any of the available models with weights trained on imagenet or without: mleap Function to load ready architectures
get_model <- function(name = "mobilenet_v2", input_shape = NULL, weights = "imagenet", pooling = "avg", num_classes = NULL, optimizer = keras::optimizer_adam(lr = 0.002), loss = "categorical_crossentropy", metrics = NULL, color = TRUE, compile = FALSE) { # Argument check checkmate::assert_string(name) checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3) checkmate::assert_count(num_classes) checkmate::assert_flag(color) checkmate::assert_flag(compile)# Getting the object from the keras package model_fun <- get0(paste0("application_", name), envir = asNamespace("keras")) # Check for object presence in the package if (is.null(model_fun)) { stop("Model ", shQuote(name), " not found.", call. = FALSE) }base_model <- model_fun( input_shape = input_shape, include_top = FALSE, weights = weights, pooling = pooling )# If the image is not in color, change the input dimension if (!color) { base_model_conf <- keras::get_config(base_model) base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L base_model <- keras::from_config(base_model_conf) }predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax") model <- keras::keras_model( inputs = base_model$input, outputs = predictions )if (compile) { keras::compile( object = model, optimizer = optimizer, loss = loss, metrics = metrics ) }return(model) }
When using single-channel images, the pretrained weights are not used. This could be fixed: by using the functionget_weights() to get the model weights as a list of R arrays, change the dimension of the first element of this list (taking some color channel or averaging all three), and then load the weights back into the model using the function set_weights() . We did not add this functionality, as at this stage it was already clear that it was more productive to work with color images.. Мы этот функционал так и не добавили, поскольку на этом этапе уже было понятно, что продуктивнее работать с цветными картинками.
A legtöbb kísérletünket a mobilenet 1 és 2, valamint a resnet34 felhasználásával hajtottuk végre. Ezen a versenyen jól szerepeltek a modernebb architektúrák, mint a SE-ResNeXt. Sajnos rendelkezésünkre álló kész megvalósítások nem voltak, a sajátjainkat pedig még nem írtuk meg (de biztosan meg fogjuk).
5. A szkriptek paraméterezése
A kód kényelme érdekében az összes tanulási folyamat egyetlen szkriptbe lett rendezve, paraméterezve így:
doc <- '
Használat:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [opciók]

Opciók:
  -h --help                   Ez az üzenet jelenik meg.
  -l --list-models            Elérhető modellek listázása.
  -m --model=          A neurális hálózat modell neve [alapértelmezett: mobilenet_v2].
  -b --batch-size=      Adatcsomag mérete [alapértelmezett: 32].
  -s --scale-factor=   Skálázási arány [alapértelmezett: 0.5].
  -c --color                  Színes vonalak használata [alapértelmezett: HAMIS].
  -d --db-dir=          Az adatbázis könyvtárának elérési útja [alapértelmezett: Sys.getenv("db_dir")].
  -r --validate-ratio= Ellenőrző minta arány [alapértelmezett: 0.995].
  -n --n-gpu=         GPU-k száma [alapértelmezett: 1].
'
args <- docopt::docopt(doc)
Csomag docopt megvalósítása R-hez. Ennek segítségével a szkriptek egyszerű parancsokkal indíthatók, mint például Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db vagy ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, ha a fájl train_nn.R futtatható (ez a parancs elindítja a resnet50 modell tanulását 128x128 pixel méretű színes képeken; az adatbázisnak a mappában kell lennie /home/andrey/doodle_db). A listához hozzáadhatók a tanulási sebesség, az optimalizáló típusa és bármilyen egyéb testreszabható paraméter. A publikáció előkészítése során kiderült, hogy az architektúra mobilenet_v2 a legfrissebb verzióból mleap R-ben történő használata az R-csomagban nem figyelembe vett változások miatt — várjuk, hogy javítva legyen.
Ez a megközelítés jelentősen felgyorsította a különböző modellekkel való kísérletezés folyamatát a tradicionálisabb RStudio szkriptek indításához képest (mint lehetséges alternatívát említsük meg a ). De a legfőbb előny a szkriptek indításának könnyű kezelése a Docker-ben vagy egyszerűen a szerveren, anélkül hogy RStudiot kellene telepíteni.
6. Szkriptek dockerizálása
A Docker-t használtuk a modellek tanulási környezetének hordozhatósága érdekében a csapat tagjai között, és az operatív felhőbe történő telepítéshez. A R-programozók számára viszonylag szokatlan eszköz megismerését egy sorozat publikációval vagy egy .
A Docker lehetővé teszi, hogy saját képeket készítsünk „a nulláról”, valamint más képeket alapként használjunk a sajátunk létrehozásához. A rendelkezésre álló lehetőségek elemzése során arra a következtetésre jutottunk, hogy az NVIDIA, CUDA+cuDNN és a Python könyvtárainak telepítése meglehetősen nagy része a képeknek, ezért úgy döntöttünk, hogy az hivatalos képet használjuk alapként. tensorflow/tensorflow:1.12.0-gpu, hozzáadva a szükséges R-csomagokat.
A végső docker fájl a következő lett:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
A kényelem érdekében a használt csomagokat változókba helyeztük; a megírt szkriptek fő része másolásra kerül a konténerekbe a build folyamat során. Ezenkívül megváltoztattuk a parancssori héjat /bin/bash a tartalom kényelmesebb használata érdekében. /etc/os-release. Ez lehetővé tette, hogy elkerüljük az operációs rendszer verziójának megadását a kódban.
Továbbá írtunk egy kis bash-szkriptet, amely lehetővé teszi a konténer különböző parancsokkal való indítását. Például ezek lehetnek a szkriptek a neurális hálózatok betanítására, amelyeket korábban beágyaztunk a konténerbe, vagy pedig egy parancssor a konténer működésének hibakeresésére és figyelemmel kísérésére:
A konténer indító szkriptje
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Ha ezt a bash-skriptet paraméterek nélkül indítják el, a konténeren belül a skript az alapértelmezett értékekkel kerül végrehajtásra. train_nn.R Ha az első pozicionális argumentum "bash", akkor a konténer interaktív módba kapcsol át parancssorral. Minden egyéb esetben a pozicionális argumentumok értékei kerülnek helyettesítésre: CMD="Rscript /app/train_nn.R $@".
Fontos megjegyezni, hogy a bemeneti adatokkal és az adatbázissal rendelkező könyvtárat, valamint a betanított modellek tárolására szolgáló könyvtárat a hosztrendszerből csatolják a konténerhez, ami lehetővé teszi a skriptek eredményeinek hozzáférését felesleges műveletek nélkül.
7. Több GPU használata a Google Cloudon
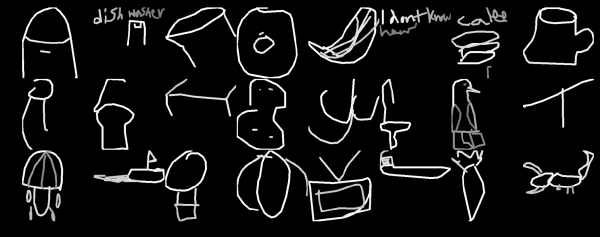
A verseny egyik sajátossága a meglehetősen zajos adatok voltak (ld. a főképet, amelyet @Leigh.plt kölcsönzött az ODS Slackből). Ellenállni ennek segít a nagy méretű batch-ek alkalmazása, és a 1 GPU-s PC-ken végzett kísérletek után úgy döntöttünk, hogy több GPU-ra tanítjuk a modelleket a felhőben. A GoogleCloudot használtuk () a széles választék, az elfogadható árak és a 300 dolláros bónusz miatt. A kapzsiság miatt egy 4xV100 SSD-vel rendelkező példányt rendeltünk, ami nagy hibának bizonyult. Egy ilyen gép gyorsan felemészti a pénzt, a nem jól megtervezett pipeline-nal végzett kísérletek könnyen csődbe juttathatnak. Oktatási célokra érdemes K80-ast választani. A sok RAM viszont jól jött — a felhő SSD nem volt lenyűgöző sebességben, ezért az adatbázist minden példányindításnál áthelyeztük a dev/shm.
A legnagyobb érdeklődés a több GPU használatára vonatkozó kód részletet övezi. Először a modellt CPU-n hozzák létre a kontextuskezelő használatával, pont mint a Pythonban:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Ezután a még nem lefordított (ez fontos) modellt átmásolják a rendelkezésre álló GPU-k számának megfelelő mennyiségben, és csak ezt követően kerül sor a fordításra:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
A klasszikus módszert, amely a rétegek befagyasztásának alkalmazását, a legutolsó réteg tanítását, a rétegek feloldását, valamint a modell teljes újratanítását server több GPU esetén nem sikerült megvalósítani.
A tanítást a tensorboard, korlátozva a naplók rögzítésére és az informatív nevű modellek eltárolására minden epizód után:
Visszahívások
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Zárás helyett
Számos probléma, amellyel szembesültünk, eddig nem sikerült megoldani:
- be. mleap nincs kész funkció az optimális tanulási sebesség automatikus keresésére (megfelelője a
lr_findera könyvtárban fast.ai); némi erőfeszítéssel harmadik felek megvalósításait lehet R-re portolni, például, ; - a korábbi ponthoz kapcsolódóan nem sikerült megfelelő tanulási sebességet beállítani több GPU használatakor;
- hiányoznak a modern neurális hálózatok architektúrái, különösen az ImageNet-en előképzett modellek;
- nincs one cycle policy vagy diszkrét tanulási sebességek (a cosinus annealing a kérésünkre volt , köszönöm ).
Milyen hasznos dolgot sikerült levonni ebből a versenyből:
- Relatív alacsony teljesítményű hardveren is fájdalommentesen lehet nagy mennyiségű (többszörösen meghaladó RAM méret) adatot kezelni. A csomag data.table memóriát takarít meg az in-place táblamódosítással, amely lehetővé teszi a másolás elkerülését, és helyes használat mellett szinte mindig a legnagyobb sebességet mutatja az általunk ismert skriptnyelvű eszközök között. Az adatok adatbázisba mentése sok esetben lehetővé teszi, hogy ne is kelljen gondolkodnunk a teljes adatállomány RAM-ba való belepréselésének szükségességén.
- A lassú R függvények c++-tal helyettesíthetők a Rcppcsomag segítségével. Ráadásul, ha használjuk RcppThread vagy RcppParallel, keresztplatformos, több szálas megvalósításokat kapunk, ezért az R szintű kódot nem szükséges párhuzamosítani.
- A csomaggal Rcpp komolyabb c++ ismeretek nélkül is használható, a szükséges minimumot vázolják . Számos klassz C-s könyvtár fejléc fájljai elérhetők a CRAN-on, tehát kialakul az infrastruktúra a projektek R-be való integrálásához, amelyek magasan hatékony c++ kódot tartalmaznak. További előny a szintaxis kiemelése és a statikus kódellenőrző C++-ban az RStudio ügyében. xtensor lehetővé teszi önálló szkriptek paraméterekkel való futtatását. Ez kényelmes a távoli szerveren való használathoz, beleértve a dockert is. Az RStudio-ban több órás kísérletezések neuralis hálózatok tanításával nem kényelmesek, és az IDE telepítése a szerveren nem mindig indokolt.
- docopt позволяет запускать самодостаточные скрипты с параметрами. Это удобно для использования на удаленном сервере, в т.ч. под докером. В RStudio проводить многочасовые эксперименты с обучением нейросетей неудобно, да и сама установка IDE на сервере не всегда оправдана.
- A Docker biztosítja a kód hordozhatóságát és az eredmények reprodukálhatóságát olyan fejlesztők között, akik különböző operációs rendszerek és könyvtárak verzióit használják, valamint megkönnyíti a szerverekre való telepítést. Az egész tanulási folyamatot mindössze egy parancs segítségével elindíthatjuk.
- A Google Cloud - költséghatékony módja, hogy drága hardveren kísérletezzünk, de érdemes megfontoltan választani a konfigurációkat.
- Nagyon hasznos a kód egyes részeinek sebességét mérni, különösen az R és C++ kombinációjával, és a csomaggal bench még nagyon egyszerű is.
Összességében ez a tapasztalat nagyon hasznos volt, és továbbra is dolgozunk néhány, említett probléma megoldásán.
Forrás: habr.com
