

A gépi tanulási szoftverek kódja gyakran bonyolult és meglehetősen zavaros. A hibák felfedezése és javítása erőforrás-igényes feladat. Még a legegyszerűbb komoly megközelítést igényel a hálózati architektúrához, a súlyok inicializálásához és a hálózat optimalizálásához. Egy apró hiba is kellemetlen problémákhoz vezethet.
Ez a cikk a neurális hálózatok hibajavítási algoritmusának szentelt.
A Skillbox ajánlja: Gyakorlati kurzus .
Emlékeztetjük: minden «Habr» olvasónak 10 000 rubeles kedvezmény jár bármely Skillbox kurzus jelentkezésekor a «Habr» promóciós kód felhasználásával.
Az algoritmus öt lépésből áll:
- egyszerű kezdés;
- a veszteségek megerősítése;
- közbenső eredmények és kapcsolatok ellenőrzése;
- a paraméterek diagnosztizálása;
- a munka ellenőrzése.
Ha van valami, ami érdekelt, azokat a szakaszokat azonnal megnyithatja.
Egyszerű kezdés
A bonyolult architektúrájú, regularizációval és tanulási sebességütemezővel rendelkező neurális hálózat hibakeresése nehezebb, mint egy hagyományosé. Kicsit okoskodunk, mert ez a pont a hibajavítás szempontjából közvetett kapcsolatban áll, de még mindig fontos ajánlás.
Az egyszerű kezdés lényege egy leegyszerűsített modell létrehozása és annak tanítása egy adathalmazon (pontra).
Először létrehozunk egy leegyszerűsített modellt
Gyors kezdethez egy kis hálózatot hozunk létre egy rejtett réteggel és ellenőrizzük, hogy minden helyesen működik. Ezután fokozatosan bonyolítjuk a modellt, ellenőrizve minden új aspektust a felépítéséből (plusz réteg, paraméter stb.), és haladunk tovább.
Tanítjuk a modellt egyetlen adathalmazon (pontra)
A projekt működésének gyors ellenőrzésére egy vagy két pontot használhatunk a tanításhoz, hogy megerősítsük, hogy a rendszer helyesen működik. A neurális hálózatnak 100%-os tanulási és teszti pontosságot kell mutatnia. Ha nem, akkor vagy a modell túl kicsi, vagy már van benne hiba.
Még ha minden jól is megy, készítse fel a modellt egy vagy több epoch áthaladására, mielőtt továbbhaladna.
A veszteségek értékelése
A veszteségek értékelése a modell teljesítményének finomításának alapvető módja. Győződjön meg arról, hogy a veszteség megfelel a feladatnak, és a veszteségfunkciók megfelelő skálán vannak értékelve. Ha többféle veszteség típust használ, ügyeljen arra, hogy mindegyik azonos rendben legyen és helyesen legyenek méretezve.
Fontos figyelni a kezdeti veszteségekre. Ellenőrizze, mennyire közelít a valódi eredmény a várt eredményhez, ha a modell véletlenszerű feltételezéssel indult. I : „Győződjön meg róla, hogy a várt eredményt kapja, amikor kis számú paraméterrel kezd dolgozni. Jobb azonnal ellenőrizni az adatvesztést (a regularizációs fok nullára állításával). Például a CIFAR-10 esetében, a Softmax klasszifikátorral, azt várjuk, hogy a kezdeti veszteség 2.302 legyen, mivel a várt diffúz valószínűség 0,1 minden osztályhoz (mivel 10 osztály van), és a Softmax veszteség a helyes osztály negatív logaritmikus valószínűsége, mint –ln (0.1) = 2.302.”
Binaris példa esetén egyszerűen elvégezhető a hasonló számítás minden osztályra. Például az adatok: 20% 0-ás és 80% 1-es. A várt kezdeti veszteség –0,2ln (0,5) –0,8ln (0,5) = 0,693147 lesz. Ha az eredmény nagyobb, mint 1, az jelezheti, hogy a neurális háló súlyai nem megfelelően kiegyensúlyozottak, vagy az adatok nincsenek normalizálva.
Ellenőrizzük az köztes eredményeket és kapcsolódásokat
A neurális háló debuggolásához meg kell értenünk a hálózaton belüli folyamatok dinamikáját és az egyes köztes rétegek szerepét, mivel ezek összefonódnak. Íme néhány tipikus hiba, amellyel szembesülhet:
- helytelen kifejezések a gradiensfrissítésekhez;
- nem alkalmaznak súlyfrissítéseket;
- eltűnő vagy robbanó gradiensek (exploding gradients).
Ha a gradiensértékek nullák, az azt jelenti, hogy az optimalizáló tanulási sebessége túl alacsony, vagy hogy helytelen kifejezéssel találkozott a gradiensfrissítéshez.
Ezenkívül figyelemmel kell kísérni az aktivációs függvények, súlyok és az egyes rétegek frissítéseinek értékeit. Például a paraméterek (súlyok és eltolások) frissítéseinek nagysága .
Van egy jelenség, amit „Dying ReLU”-nak vagy neveztünk el, amikor a ReLU neuronok nullát adnak vissza, miután egy nagy negatív értéket (eltolást) tanultak meg a súlyaikhoz. Ezek a neuronok soha többé nem aktiválódnak egyetlen adatpontban sem.
A gradiensellenőrzés segítségével észlelheti ezeket a hibákat a gradiens numerikus megközelítéssel való közelítésével. Ha a számított gradiens értékekhez közel áll, akkor a hátrafelé terjedés helyesen lett végrehajtva. A gradiensellenőrzés elkészítéséhez ismerkedjen meg ezekkel a nagyszerű forrásokkal a CS231-ből. és , valamint Andrew Nga témában.
három fő módszert említ a neurális hálózatok vizualizálására:
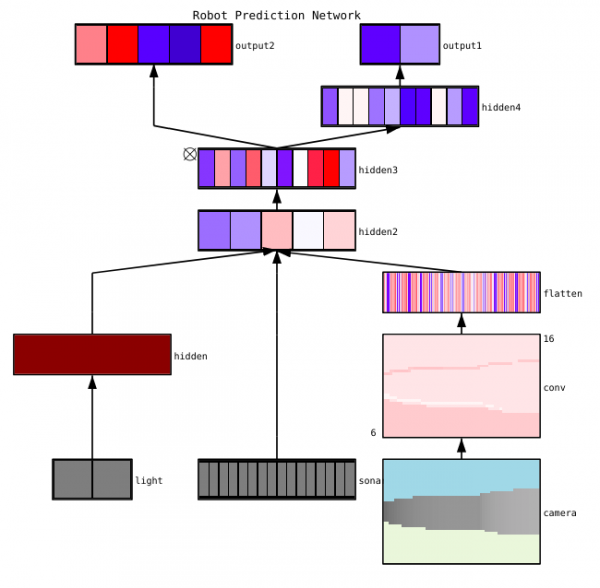
- Előzetes — egyszerű módszerek, amelyek bemutatják az oktatott modell általános struktúráját. Ezek közé tartozik az egyes rétegek kimeneti formáinak vagy szűrőinek megjelenítése, valamint a rétegenkénti paraméterek is.
- Aktivációkra épülőek. Ezekben a különböző idegsejtek vagy idegsejt-csoportok aktivációit dekódoljuk, hogy megértsük a funkcióikat.
- Gradiens alapúak. Ezek a módszerek hajlamosak manipulálni az előre- és hátramenet során képződő gradienseket a modell tanítása során (beleértve a jelentőségi és osztályaktiváló térképeket).
Számos hasznos eszköz áll rendelkezésre az aktivációk és az egyes rétegek kapcsolódásának vizualizálására, például és .
Paraméterdiagnosztika
A neurális hálózatokban rengeteg paraméter van, amelyek kölcsönhatásba lépnek egymással, ami bonyolítja az optimalizálást. Valójában ez a rész a szakemberek aktív kutatásának tárgya, ezért az alábbi javaslatokat csak tanácsként, kiindulópontként kell kezelni.
Batch méret (batch size) — gondoskodni kell arról, hogy a batch mérete elég nagy legyen a gradiens hibaértékek pontos becsléséhez, ugyanakkor elég kicsi ahhoz, hogy a Stochastic Gradient Descent (SGD) képes legyen rendezni a hálózatot. A kicsi batch méretek gyors konvergenciát eredményeznek a tanulási folyamat zajának köszönhetően, ezzel együtt további optimalizálási nehézségekhez vezethetnek. További részletezést talál erről. .
Tanulási sebesség — ha túl alacsony, lassú konvergenciát vagy veszélyt jelent, hogy a lokális minimumba ragadunk. Ugyanakkor a magas tanulási sebesség az optimalizálás eltérést okozhat, mivel kockázatot jelent, hogy "ugrunk" egy mély, de keskeny része a veszteségfüggvénynek. Próbálja meg alkalmazni a tanulási sebesség ütemezését, hogy csökkentse azt a neurális hálózat tanítása során. A CS231n kurzusban. .
Gradiens vágás— a gradiens paraméterek levágása a visszafelé terjedés alatt maximális érték vagy határnorma szerint. Hasznos minden robbanásszerű gradiens probléma megoldásához, amellyel a harmadik pontban találkozhat.
Csoportos normálás — az egyes réteg bemeneti adatainak normalizálására szolgál, amely lehetővé teszi a belső kovariancia eltolódás problémájának megoldását. Ha a Dropout és a Batch Norma együtt kerül alkalmazásra, .
Stochasztikus gradiens csökkenés (SGD) — létezik néhány változata az SGD-nek, amelyek impulzust, adaptív tanulási sebességeket és Nesterov-módszert használnak. Ezzel kapcsolatban egyikük sem rendelkezik egyértelmű előnnyel sem a tanulás hatékonysága, sem az általánosítás szempontjából ().
Regularizáció — elengedhetetlen egy általánosítható modell felépítéséhez, mivel büntetést ad a modell összetettsége vagy a paraméterek extrém értékei miatt. Ez egy olyan módszer, amellyel csökkenthető a modell varianciája anélkül, hogy lényegesen növelnénk annak elfogultságát. További .
Ahhoz, hogy mindent saját magunk értékeljünk, ki kell kapcsolni a regularizációt, és ellenőrizni kell a veszteségadatok gradiensét.
Dropout — egy másik módszer a hálózat rendezésére a túlkapacitás megelőzése érdekében. Az edzés során a dropout csak azzal valósul meg, hogy a neuronnak egy bizonyos valószínűséggel p (hiperparaméter) aktívnak kell lennie, vagy más esetben nullára állítják. Ennek eredményeként a hálózatnak minden tanító batchhez más paramétersorozatot kell használnia, ami csökkenti a bizonyos paraméterek dominálását.
Fontos: ha a dropoutot és a csoportos normálást együtt használja, legyen óvatos ezen műveletek sorrendjével vagy akár közös használatukkal kapcsolatban. Mindez még mindig aktívan vitatott és kiegészített. Itt van két fontos vita e témában és .
A működés ellenőrzése
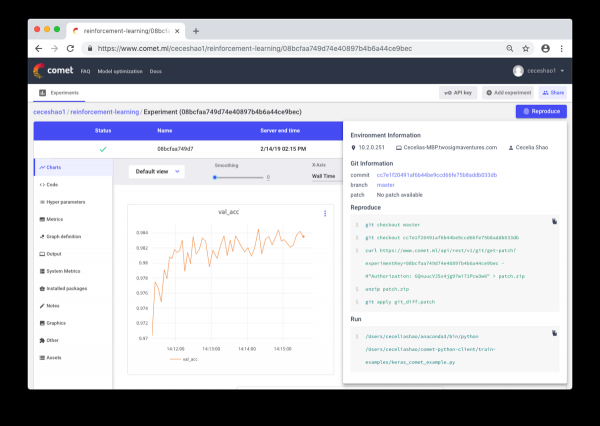
A folyamatok és kísérletek dokumentálásáról van szó. Ha semmit sem dokumentálunk, könnyen elfelejthetjük, például, hogy milyen tanulási sebességet vagy osztálytömeget használunk. A nyomon követés révén probléma nélkül áttekinthetjük és reprodukálhatjuk a korábbi kísérleteket. Ez csökkentheti a megismétlődő kísérletek számát.
Az igaz, hogy a kézi dokumentálás nehéz feladattá válhat nagy munkamennyiség esetén. Itt segítenek olyan eszközök, mint a Comet.ml, amelyek automatikusan logolják az adatokat, a kódváltozásokat, a kísérletek történetét és a gyártási modelleket, beleértve a modellel kapcsolatos kulcsfontosságú információkat (hiperparaméterek, a modell teljesítményének mutatói és a környezeti információk).
A neurális hálózatok nagyon érzékenyek lehetnek a kisebb változásokra, ami a modell teljesítményének csökkenéséhez vezethet. A munka nyomon követése és dokumentálása az első lépés, amelyet érdemes megtenni a környezet és a modellezés standardizálása érdekében.
Remélem, hogy ez a bejegyzés kiindulópontként szolgál, amellyel elkezdheti a neurális hálójának hibakeresését.
A Skillbox ajánlja:
- Kétéves gyakorlati tanfolyam .
- Online kurzus .
- Gyakorlati éves kurzus .
Forrás: habr.com
