

Ի՞նչը կարող է ստիպել այնպիսի խոշոր ընկերության, ինչպիսին է Lamoda-ն՝ լավ հաստատված գործընթացով և տասնյակ փոխկապակցված ծառայություններով, զգալիորեն փոխել իր մոտեցումը։ Մոտիվացիան կարող է լինել բոլորովին տարբեր՝ օրենսդրականից մինչև բոլոր ծրագրավորողներին բնորոշ փորձարկումներ անելու ցանկություն։
Սակայն սա չի նշանակում, որ դուք չեք կարող հույս դնել լրացուցիչ առավելությունների վրա։ Սերգեյ Զաիկան ձեզ կասի, թե ինչ կարող եք ստանալ Kafka-ում իրադարձությունների վրա հիմնված API ներդնելով ()։ Անպայման կլինեն նաև որոշ խոչընդոտներ և հետաքրքիր հայտնագործություններ՝ առանց դրանց ոչ մի փորձ չի կարող անել։
Հրաժարում պատասխանատվությունից. Այս հոդվածը հիմնված է Սերգեյի 2018 թվականի նոյեմբերին HighLoad++-ում կայացած հանդիպման նյութերի վրա: Լամոդայի Կաֆկայի հետ աշխատելու կենդանի փորձը գրավեց ունկնդիրներին ոչ պակաս, քան ծրագրի մյուս զեկույցները: Մենք կարծում ենք, որ սա հիանալի օրինակ է այն բանի, թե ինչպես կարելի է և պետք է միշտ գտնել համախոհ մարդկանց, և HighLoad++-ի կազմակերպիչները կշարունակեն փորձել ստեղծել դրան նպաստող մթնոլորտ:
Գործընթացի մասին
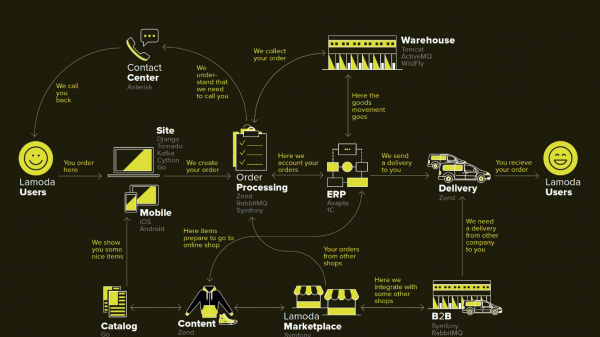
Lamoda-ն խոշոր էլեկտրոնային առևտրի հարթակ է, որն ունի իր սեփական կոնտակտային կենտրոնը, առաքման ծառայությունը (և բազմաթիվ գործընկերներ), լուսանկարչական ստուդիան, հսկայական պահեստը, և այս ամենը աշխատում է իր սեփական ծրագրաշարով: Կան տասնյակ վճարման մեթոդներ, b2b գործընկերներ, որոնք կարող են օգտվել այս ծառայություններից մի քանիսից կամ բոլորից և ցանկանում են իմանալ արդիական տեղեկատվություն իրենց ապրանքների մասին: Բացի այդ, Lamoda-ն գործում է Ռուսաստանի Դաշնությունից բացի երեք երկրներում, և այնտեղ ամեն ինչ մի փոքր այլ է: Ընդհանուր առմամբ, հավանաբար, կան հարյուրից ավելի եղանակներ նոր պատվեր կազմելու համար, որը պետք է մշակվի իր ձևով: Այս ամենը գործում է տասնյակ ծառայությունների օգնությամբ, որոնք երբեմն շփվում են ոչ ակնհայտ ձևերով: Կա նաև կենտրոնական համակարգ, որի հիմնական պատասխանատվությունը պատվերի կարգավիճակներն են: Մենք այն անվանում ենք BOB, ես աշխատում եմ դրա հետ:
Վերադարձի գործիք՝ իրադարձությունների վրա հիմնված API-ով
«Իրադարձությունների վրա հիմնված» բառը բավականին շատ է օգտագործվում, մենք ավելի մանրամասն կբացատրենք, թե ինչ է սա նշանակում մի փոքր ավելի ուշ։ Ես կսկսեմ այն համատեքստից, որում մենք որոշեցինք փորձարկել Kafka-ում իրադարձությունների վրա հիմնված API մոտեցումը։
Ցանկացած խանութում, բացի այն պատվերներից, որոնց համար հաճախորդները վճարում են, լինում են դեպքեր, երբ խանութը պարտավոր է վերադարձնել գումարը, քանի որ ապրանքը չի համապատասխանել հաճախորդին: Սա համեմատաբար կարճ գործընթաց է. մենք անհրաժեշտության դեպքում ճշտում ենք տեղեկատվությունը և փոխանցում գումարը:
Սակայն վերադարձն ավելի բարդացավ օրենսդրության փոփոխությունների պատճառով, և մենք ստիպված էինք դրա համար առանձին միկրոծառայություն ներդնել։
Մեր մոտիվացիան.
- Օրենք FZ-54 — կարճ ասած, օրենքը պահանջում է հարկային գրասենյակին հաշվետվություն ներկայացնել յուրաքանչյուր դրամական գործարքի մասին, լինի դա հաշվետվություն, թե անդորրագիր, բավականին կարճ՝ մի քանի րոպե տևողությամբ SLA-ի շրջանակներում: Մենք՝ որպես էլեկտրոնային առևտրի ոլորտ, բավականին շատ գործարքներ ենք իրականացնում: Տեխնիկապես սա նշանակում է նոր պատասխանատվություն (և, հետևաբար, նոր ծառայություն) և բարելավումներ բոլոր հարակից համակարգերում:
- BOB բաժանում — ընկերության ներքին նախագիծ՝ BOB-ը մեծ թվով ոչ հիմնական պարտականություններից ազատելու և դրա ընդհանուր բարդությունը նվազեցնելու համար։
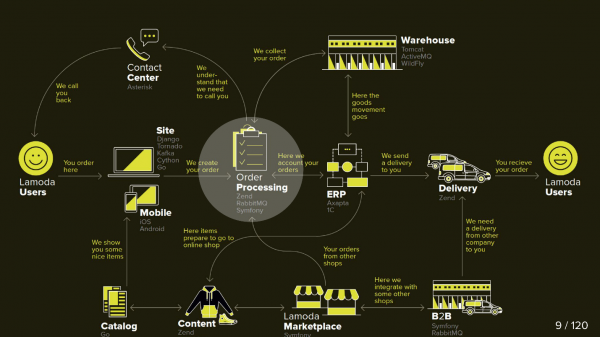
Այս դիագրամը ցույց է տալիս Lamoda-ի հիմնական համակարգերը։ Այժմ դրանց մեծ մասը բավականին 5-10 միկրոսերվիսների համաստեղություն՝ կծկվող մոնոլիտի շուրջԴրանք քիչ-քիչ մեծանում են, բայց մենք փորձում ենք դրանք փոքրացնել, քանի որ մեջտեղում հատկացված բեկորի տեղակայումը վախենալու է. մենք չենք կարող թույլ տալ, որ այն խափանվի: Մենք պետք է պահեստավորենք բոլոր փոխանակումները (նետերը) և պլանավորենք այն փաստը, որ դրանցից որևէ մեկը կարող է անհասանելի դառնալ:
BOB-ը նաև բավականին շատ փոխանակումներ ունի՝ վճարային համակարգեր, առաքում, ծանուցումներ և այլն։
Տեխնիկապես BOB-ը հետևյալն է.
- ~150k տող կոդ + ~100k տող թեստեր;
- php7.2 + Zend 1 և Symfony բաղադրիչներ 3;
- >100 API-ներ և մոտ 50 ելքային ինտեգրացիաներ;
- 4 երկիր՝ իրենց սեփական բիզնես տրամաբանությամբ։
BOB-ի տեղակայումը թանկ և ցավոտ է, այն լուծում է կոդի և խնդիրների այնպիսի քանակ, որ ոչ ոք չի կարող ամեն ինչ իր գլխում դնել։ Ընդհանուր առմամբ, կան բազմաթիվ պատճառներ այն պարզեցնելու համար։
Վերադարձի գործընթաց
Սկզբում գործընթացում ներգրավված են երկու համակարգ՝ BOB և Payment: Այժմ հայտնվում են ևս երկուսը.
- Ֆիսկալիզացիայի ծառայություն, որը կհոգա ֆիսկալիզացիայի հարցերը և արտաքին ծառայությունների հետ հաղորդակցությունը։
- Վերադարձի գործիք, որը պարզապես ընդունում է նոր փոխանակումներ՝ BOB-ը չուռճացնելու համար։
Հիմա գործընթացը այսպիսի տեսք ունի.
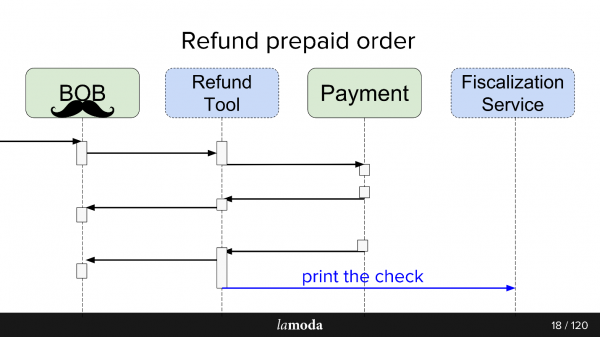
- BOB-ը ստանում է վերադարձի խնդրանք։
- BOB-ը խոսում է այս վերադարձի գործիքի մասին։
- Վերադարձի գործիքը վճարմանը տեղեկացնում է. «Վերադարձրեք գումարը»։
- Վճարումը վերադարձնում է գումարը։
- Վերադարձի գործիքը և BOB-ը համաժամեցնում են կարգավիճակները միմյանց հետ, քանի որ երկուսն էլ առայժմ դրա կարիքն ունեն։ Մենք դեռ պատրաստ չենք ամբողջությամբ անցնել Վերադարձի գործիքին, քանի որ BOB-ն ունի UI, հաշվապահական հաշվետվություններ և ընդհանուր առմամբ շատ տվյալներ, որոնք այդքան հեշտությամբ չեն կարող փոխանցվել։ Մենք ստիպված ենք նստել երկու աթոռի վրա։
- Հարկաբեկման հարցումն ուղարկվում է։
Վերջիվերջո, մենք Կաֆկայի վրա ստեղծեցինք մի տեսակ իրադարձությունների ավտոբուս՝ իրադարձությունների ավտոբուս, որի վրա ամեն ինչ կապված էր։ Ուռա՜, հիմա մենք ունենք ձախողման միակ կետ (սարկազմ)։
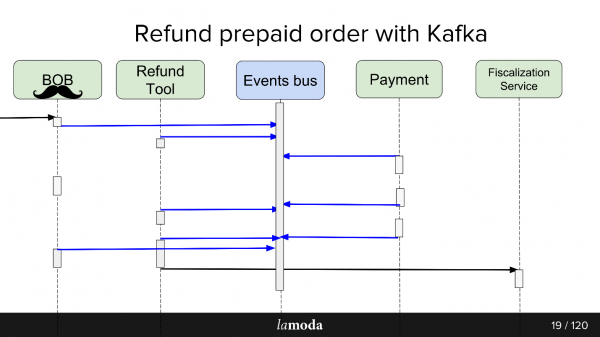
Դրական և բացասական կողմերը բավականին ակնհայտ են։ Մենք ստեղծեցինք ավտոբուս, ինչը նշանակում է, որ բոլոր ծառայությունները կախված են դրանից։ Սա պարզեցնում է դիզայնը, բայց համակարգում ներմուծում է ձախողման մեկ կետ։ Եթե kafka-ն խափանվի, գործընթացը կկանգնի։
Ի՞նչ է իրադարձություն-կառավարվող API-ը։
Այս հարցի լավ պատասխանը կարելի է գտնել Մարտին Ֆաուլերի զեկույցում (GOTO 2017): .
Հակիրճ, ահա թե ինչ արեցինք.
- Բոլոր ասինխրոն փոխանակումները փակվել են միջոցառումների պահեստՑանցում կարգավիճակի փոփոխության մասին յուրաքանչյուր հետաքրքրված սպառողին տեղեկացնելու փոխարեն, մենք վիճակի փոփոխության մասին հաղորդում ենք գրում կենտրոնացված պահեստ, և թեմայով հետաքրքրված սպառողները կարդում են այնտեղից հայտնվող ամեն ինչ։
- Այս դեպքում իրադարձությունը ծանուցում է (տեղեկացումներ) որ ինչ-որ տեղ ինչ-որ բան փոխվել է։ Օրինակ՝ պատվերի կարգավիճակը փոխվել է։ Սպառողը, որին անհրաժեշտ են կարգավիճակի փոփոխությանը ուղեկցող որոշ տվյալներ, որոնք չկան ծանուցման մեջ, կարող է ինքնուրույն պարզել իր կարգավիճակը։
- Առավելագույն տարբերակը լիարժեք միջոցառումների կազմակերպումն է, պետական փոխանցում, որում իրադարձությունը պարունակում է մշակման համար անհրաժեշտ ողջ տեղեկատվությունը. որտեղից է այն եկել և ինչ կարգավիճակի է հասել, ինչպես են տվյալները փոխվել և այլն: Միակ հարցը իրագործելիությունն է և այն տեղեկատվության քանակը, որը դուք կարող եք թույլ տալ ձեզ պահել:
Վերադարձի գործիքի գործարկման շրջանակներում մենք օգտագործեցինք երրորդ տարբերակը։ Սա պարզեցրեց իրադարձությունների մշակումը, քանի որ անհրաժեշտություն չկար մանրամասն տեղեկատվություն արդյունահանելու, բացի այդ, վերացրեց այն սցենարը, երբ յուրաքանչյուր նոր իրադարձություն սպառողներից պարզաբանող հարցումների պոռթկում էր առաջացնում։
Վերադարձի գործիքի ծառայություն բեռնված չէ, այնպես որ Kafka-ն այնտեղ ավելի շատ փորձնական ծրագիր է, քան անհրաժեշտություն։ Ես չեմ կարծում, որ եթե վերադարձի ծառայությունը դառնա ծանրաբեռնված նախագիծ, բիզնեսը գոհ կլինի։
Ասինխրոն փոխանակում ԻՆՉՊԵՍ ԿԱ
Ասինխրոն փոխանակումների համար PHP բաժինը սովորաբար օգտագործում է RabbitMQ: Մենք հավաքագրել ենք տվյալներ հարցման համար, տեղադրել այն հերթում, և նույն ծառայության սպառողը կարդացել է այն և ուղարկել (կամ չի ուղարկել): API-ի համար Lamoda-ն ակտիվորեն օգտագործում է Swagger-ը: Մենք նախագծում ենք API-ը, նկարագրում այն Swagger-ում, ստեղծում ենք հաճախորդի և սերվերի կոդ: Մենք նաև օգտագործում ենք մի փոքր ընդլայնված JSON RPC 2.0:
Որոշ տեղեր օգտագործում են esb ավտոբուսներ, որոշները՝ activeMQ-ով, բայց ընդհանուր առմամբ, RabbitMQ — ստանդարտ.
Ասինխրոն փոխանակում TO BE
Իրադարձությունների ավտոբուսի միջոցով փոխանակում նախագծելիս կարելի է անալոգիա գտնել։ Նմանապես, մենք նկարագրում ենք ապագա տվյալների փոխանակումը՝ իրադարձությունների կառուցվածքի նկարագրությունների միջոցով։ Yaml ձևաչափը, մենք ստիպված էինք ինքներս ստեղծել կոդը, գեներատորը ստեղծում է DTO-ներ՝ համաձայն սպեցիֆիկացիայի և սովորեցնում է հաճախորդներին ու սերվերներին աշխատել դրանց հետ։ Ստեղծումը երկու լեզվով է՝ Գոլանգ և PHPՍա թույլ է տալիս պահպանել գրադարանների համապատասխանությունը։ Գեներատորը գրված է golang լեզվով, որի համար էլ այն ստացել է gogi անվանումը։
Kafka-ում իրադարձությունների աղբյուրը բնորոշ բան է: Կա լուծում Kafka Confluent-ի հիմնական ձեռնարկության տարբերակից, կա , լուծում մեր «եղբայրներից» Zalando տիրույթի տարածքում։ Մեր Վանիլային Կաֆկայով սկսելու մոտիվացիա — լուծումը թողնել ազատ, մինչև վերջնականապես որոշենք՝ արդյոք այն կօգտագործենք ամենուր, ինչպես նաև մեզ որոշակի տարածք թողնել մանևրելու և բարելավումներ կատարելու համար. մենք ցանկանում ենք աջակցություն մեր JSON RPC 2.0, երկու լեզուների գեներատորներ և տեսնենք, թե ուրիշ ինչ։
Իրոնիկ է, որ նույնիսկ այս բախտավոր դեպքում, երբ կա մոտավորապես նմանատիպ բիզնես՝ Zalando-ն, որը մոտավորապես նմանատիպ որոշում է կայացրել, մենք չենք կարող այն արդյունավետորեն օգտագործել։
Մեկնարկի ճարտարապետական մոդելը հետևյալն է. մենք կարդում ենք անմիջապես Կաֆկայից, բայց գրում ենք միայն իրադարձությունների ավտոբուսի միջոցով: Կաֆկան ունի շատ պատրաստի բաներ ընթերցման համար՝ բրոքերներ, հավասարակշռիչներ, և այն ավելի կամ պակաս պատրաստ է հորիզոնական մասշտաբավորման համար, մենք ուզում էինք պահպանել սա: Ինչ վերաբերում է գրելուն, մենք ուզում էինք այն փաթեթավորել մեկ Gateway-ի, այսինքն՝ Events-bus-ի միջոցով, և ահա թե ինչու:
Միջոցառումների ավտոբուս
Կամ event bus: Այն պարզապես stateless http gateway է, որը կատարում է մի քանի կարևոր դերեր.
- Ստեղծելով վավերացում — մենք ստուգում ենք, որ իրադարձությունները համապատասխանում են մեր պահանջներին։
- Միջոցառումների գլխավոր համակարգ, այսինքն՝ սա ընկերության հիմնական և միակ համակարգն է, որը պատասխանում է այն հարցին, թե որ իրադարձությունները որ կառուցվածքներով են համարվում վավերական։ Հաստատումը ներառում է պարզապես տվյալների տեսակներ և համարակալումներ՝ բովանդակության խիստ ճշգրտման համար։
- Հեշ ֆունկցիա Շարդինգի համար՝ Կաֆկայի հաղորդագրության կառուցվածքը բանալի-արժեք է, և բանալիից ստացված հեշը օգտագործվում է այն տեղադրելու տեղը հաշվարկելու համար։
Ինչու
Մենք աշխատում ենք խոշոր ընկերությունում՝ լավ հաստատված գործընթացով։ Ինչո՞ւ փոխել որևէ բան։ Սա փորձ է։, և մենք ակնկալում ենք ստանալ մի շարք առավելություններ։
1:n+1 փոխանակումներ (մեկից շատ)
Kafka-ն շատ հեշտացնում է նոր սպառողներին ձեր API-ին միացնելը։
Ենթադրենք, որ դուք ունեք մի տեղեկատու, որը պետք է թարմացվի միաժամանակ մի քանի համակարգերում (և որոշ նորերում): Նախկինում մենք հորինել էինք մի փաթեթ, որը իրականացնում էր set-API, և գլխավոր համակարգին տրվում էին սպառողների հասցեները: Այժմ գլխավոր համակարգը ուղարկում է թեմայի թարմացումներ, և բոլորը, ովքեր հետաքրքրված են, կարդում են դրանք: Հայտնվել է նոր համակարգ՝ բաժանորդագրվել է այն թեմային: Այո, նույնպես փաթեթ, բայց ավելի պարզ:
Վերադարձի գործիքի դեպքում, որը, ըստ էության, BOB-ի մի մասն է, մեզ համար հարմար է դրանք համաժամեցնել Kafka-ի միջոցով: Վճարումը ցույց է տալիս, որ գումարը վերադարձվել է. BOB-ը, RT-ն իմացել են դրա մասին, փոխել են իրենց կարգավիճակները, հարկաբյուջետային ծառայությունը իմացել է դրա մասին և տրամադրել է չեկ:
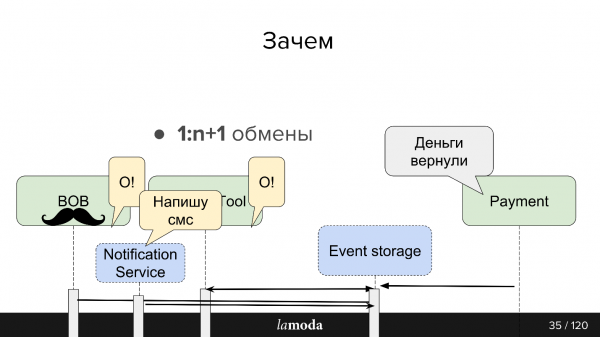
Մենք ծրագրեր ունենք ստեղծել միասնական ծանուցումների ծառայություն, որը կտեղեկացնի հաճախորդին իրենց պատվերի/վերադարձի վերաբերյալ նորությունների մասին: Ներկայումս այս պատասխանատվությունը բաշխված է համակարգերի միջև: Մեզ համար բավարար կլինի սովորեցնել ծանուցումների ծառայությանը Kafka-ից ստանալ համապատասխան տեղեկատվություն և արձագանքել դրան (և անջատել այդ ծանուցումները այլ համակարգերում): Նոր ուղղակի փոխանակումներ անհրաժեշտ չեն լինի:
Տվյալների վրա հիմնված
Համակարգերի միջև տեղեկատվությունը դառնում է թափանցիկ՝ անկախ նրանից, թե որքան «արյունոտ ձեռնարկություն» ունեք և որքան ծանրաբեռնված է ձեր կուտակված աշխատանքները: Lamoda-ն ունի տվյալների վերլուծության բաժին, որը հավաքում է տվյալներ համակարգերից և դրանք վերածում վերաօգտագործելի ձևի՝ թե՛ բիզնեսի, թե՛ ինտելեկտուալ համակարգերի համար: Kafka-ն թույլ է տալիս արագորեն տրամադրել նրանց մեծ քանակությամբ տվյալներ և պահպանել այս տեղեկատվության հոսքը արդիական:
Կրկնօրինակման գրանցամատյան
Հաղորդագրությունները չեն անհետանում կարդալուց հետո, ինչպես RabbitMQ-ում։ Երբ իրադարձությունը պարունակում է բավարար տեղեկատվություն մշակման համար, մենք ունենք օբյեկտի վերջին փոփոխությունների պատմությունը և, ցանկության դեպքում, այդ փոփոխությունները կիրառելու հնարավորություն։
Կրկնօրինակման գրանցամատյանի պահպանման ժամկետը կախված է այս թեմայի վերաբերյալ գրառման ինտենսիվությունից. Kafka-ն թույլ է տալիս ճկուն կերպով կարգավորել պահպանման ժամանակի և տվյալների ծավալի սահմանափակումները: Ինտենսիվ թեմաների համար կարևոր է, որ բոլոր սպառողները ժամանակ ունենան կարդալու տեղեկատվությունը, նախքան այն անհետանա, նույնիսկ կարճաժամկետ անգործունակության դեպքում: Սովորաբար հնարավոր է տվյալները պահպանել օրերի միավորներ, որը բավականին բավարար է աջակցության համար։
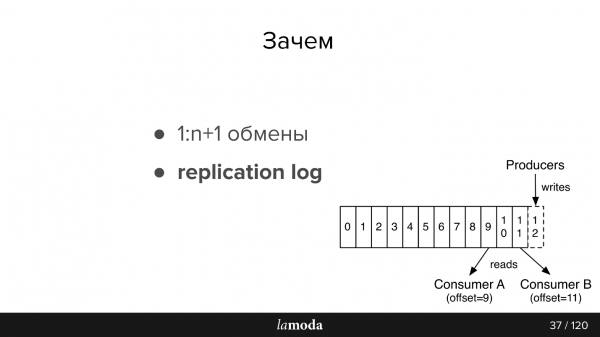
Ահա փաստաթղթերի մի փոքր վերապատմում նրանց համար, ովքեր ծանոթ չեն Կաֆկային (նկարը նույնպես փաստաթղթերից է):
AMQP-ն ունի հերթեր. մենք հաղորդագրություններ ենք գրում սպառողի համար հերթում: Որպես կանոն, մեկ հերթը մշակվում է մեկ համակարգի կողմից՝ նույն բիզնես տրամաբանությամբ: Եթե անհրաժեշտ է տեղեկացնել մի քանի համակարգերի, կարող եք սովորեցնել ծրագրին գրել մի քանի հերթերում կամ կարգավորել փոխանակում fanout մեխանիզմով, որն ինքնուրույն կլոնավորում է դրանք:
Կաֆկան նմանատիպ աբստրակցիա ունի թեմա, որտեղ դուք գրում եք հաղորդագրություններ, բայց դրանք չեն անհետանում կարդալուց հետո: Ըստ լռելյայնի, Kafka-ին միանալիս դուք ստանում եք բոլոր հաղորդագրությունները, և միևնույն ժամանակ կա հնարավորություն պահպանելու այն վայրը, որտեղ կանգ եք առել: Այսինքն՝ դուք կարդում եք հաջորդաբար, չեք կարող նշել հաղորդագրությունը որպես կարդացված, այլ պահպանել id-ն, որից հետո կշարունակեք կարդալ: id-ն, որտեղ դուք կանգ եք առել, կոչվում է offset, իսկ մեխանիզմը՝ commit offset:
Համապատասխանաբար, կարող է իրականացվել տարբեր տրամաբանություն։ Օրինակ, մենք ունենք BOB 4 դեպքերում՝ տարբեր երկրների համար՝ Lamoda-ն գտնվում է Ռուսաստանում, Ղազախստանում, Ուկրաինայում, Բելառուսում։ Քանի որ դրանք տեղակայված են առանձին, դրանք ունեն մի փոքր տարբեր կոնֆիգուրացիաներ և իրենց սեփական բիզնես տրամաբանությունը։ Մենք հաղորդագրության մեջ նշում ենք, թե որ երկրին է այն վերաբերում։ Յուրաքանչյուր երկրում յուրաքանչյուր BOB սպառող կարդում է տարբեր groupId-ով, և եթե հաղորդագրությունը չի վերաբերում դրան, այն բաց է թողնվում, այսինքն՝ այն անմիջապես կատարում է offset +1։ Եթե մեր վճարային ծառայությունը կարդում է նույն թեման, այն դա անում է առանձին խմբով, և, հետևաբար, offset-ները չեն հատվում։
Միջոցառման պահանջները՝
- Տվյալների ամբողջականությունը։ Ես կցանկանայի, որ միջոցառումն ունենա բավարար տվյալներ մշակման համար։
- Անկեղծություն։ Մենք Events-bus-ին ենք հանձնարարում ստուգել, որ իրադարձությունը հետևողական է և որ այն կարող է կարգավորել այն։
- Կարևոր է կարգը։ Վերադարձի դեպքում մենք պետք է աշխատենք պատմության հետ։ Ծանուցումների հերթականությունը կարևոր չէ, եթե դրանք միատարր ծանուցումներ են, էլ․ հասցեն նույնը կլինի՝ անկախ նրանից, թե որ պատվերն է առաջինը ժամանել։ Վերադարձի դեպքում կա հստակ գործընթաց, եթե դուք փոխեք պատվերը, ապա կառաջանան բացառություններ, վերադարձը չի ստեղծվի կամ մշակվի՝ մենք կհայտնվենք այլ կարգավիճակում։
- Հետևողականություն. Մենք ունենք պահեստ, և հիմա API-ի փոխարեն ստեղծում ենք իրադարձություններ։ Մեզ անհրաժեշտ է միջոց՝ նոր իրադարձությունների և առկա իրադարձությունների փոփոխությունների մասին տեղեկատվությունը մեր ծառայություններին արագ և մատչելի կերպով փոխանցելու համար։ Սա իրականացվում է առանձին git պահոցում և կոդի գեներատորներում ընդհանուր սպեցիֆիկացիայի միջոցով։ Հետևաբար, տարբեր ծառայությունների հաճախորդներն ու սերվերները համապատասխան են։
Կաֆկա Լամոդայում
Մենք ունենք Կաֆկայի երեք ինստալյացիա՝
- Գրանցամատյաններ;
- Հետազոտություն և զարգացում;
- Միջոցառումների ավտոբուս։
Այսօր մենք խոսում ենք միայն վերջին կետի մասին։ Events-bus-ում մենք շատ մեծ տեղադրումներ չունենք՝ 3 բրոքեր (սերվեր) և ընդամենը 27 թեմա։ Որպես կանոն, մեկ թեման մեկ պրոցես է։ Բայց սա նուրբ կետ է, և հիմա մենք դրան կանդրադառնանք։
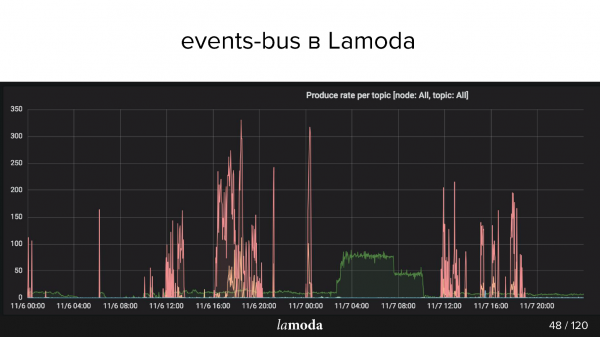
Վերևում RPS գրաֆիկն է։ Վերադարձի գործընթացը նշված է փիրուզագույն գծով (այո, X առանցքի վրա գտնվողը), իսկ բովանդակության թարմացման գործընթացը՝ վարդագույնով։
Lamoda կատալոգը պարունակում է միլիոնավոր ապրանքներ, և տվյալները անընդհատ թարմացվում են: Որոշ հավաքածուներ դուրս են գալիս նորաձևությունից, դրանց փոխարինելու համար թողարկվում են նորերը, կատալոգում անընդհատ հայտնվում են նոր մոդելներ: Մենք փորձում ենք կանխատեսել, թե վաղը ինչն է հետաքրքիր լինելու մեր հաճախորդների համար, ուստի անընդհատ գնում ենք նոր իրեր, լուսանկարում դրանք և թարմացնում ցուցափեղկը:
Վարդագույն գագաթները ապրանքի թարմացումներ են, այսինքն՝ ապրանքների փոփոխություններ։ Ակնհայտ է, որ տղաները լուսանկարում էին, լուսանկարում, իսկ հետո՝ բամ։ Նրանք մի շարք միջոցառումներ են վերբեռնել։
Lamoda Events-ի օգտագործման դեպքեր
Կառուցված ճարտարապետությունը մենք օգտագործում ենք հետևյալ գործողությունների համար՝
- Վերադարձի կարգավիճակների հետևումգործողության կոչ և կարգավիճակների հետևում բոլոր ներգրավված համակարգերից։ Վճարում, կարգավիճակներ, հարկաբյուջետային վճարումներ, ծանուցումներ։ Այստեղ մենք փորձարկեցինք մոտեցումը, ստեղծեցինք գործիքներ, հավաքեցինք բոլոր սխալները, գրեցինք փաստաթղթեր և գործընկերներին ասացինք, թե ինչպես օգտագործել այն։
- Ապրանքի քարտերի թարմացում. կոնֆիգուրացիա, մետատվյալներ, բնութագրեր։ Կարդացվում է մեկ համակարգի կողմից (որը ցուցադրում է), և գրվում է մի քանիսի կողմից։
- Էլ. փոստ, push և SMSպատվերը հավաքվել է, պատվերը ժամանել է, վերադարձը ընդունվել է և այլն, դրանցից շատերը կան:
- Պաշարների, պահեստի թարմացում — անվանումների քանակական թարմացում, միայն թվեր. պահեստում ստացում, վերադարձ։ Անհրաժեշտ է, որ ապրանքների ամրագրման հետ կապված բոլոր համակարգերը գործեն ամենաթարմ տվյալներով։ Այժմ պաշարների թարմացման համակարգը բավականին բարդ է, Kafka-ն այն կպարզեցնի։
- Տվյալների վերլուծություն (հետազոտությունների և զարգացման բաժին), մեքենայական ուսուցման գործիքներ, վերլուծություններ, վիճակագրություն: Մենք ցանկանում ենք, որ տեղեկատվությունը լինի թափանցիկ. Kafka-ն հիանալի է դրա համար:
Հիմա ավելի հետաքրքիր մասը վերաբերում է վերջին վեց ամիսների ընթացքում տեղի ունեցած խոչընդոտներին և հետաքրքիր հայտնագործություններին։
Դիզայնի խնդիրներ
Ենթադրենք, որ մենք ուզում ենք ինչ-որ նոր բան անել՝ օրինակ՝ ամբողջ առաքման գործընթացը տեղափոխել Kafka: Այժմ գործընթացի մի մասն իրականացվում է BOB-ի պատվերի մշակման մեջ: Պատվերի առաքման ծառայությանը փոխանցման, միջանկյալ պահեստ տեղափոխման և այլնի հետևում կա կարգավիճակի մոդել: Կա մի ամբողջ մոնոլիտ, նույնիսկ երկու, գումարած առաքմանը նվիրված մի շարք API-ներ: Նրանք շատ ավելին գիտեն առաքման մասին:
Թվում է, թե սրանք նմանատիպ ոլորտներ են, բայց BOB-ում պատվերի մշակման և առաքման համակարգի համար կարգավիճակները տարբեր են: Օրինակ, որոշ սուրհանդակային ծառայություններ չեն ուղարկում միջանկյալ կարգավիճակներ, այլ միայն վերջնական՝ «առաքված» կամ «կորած»: Մյուսները, ընդհակառակը, շատ մանրամասնորեն զեկուցում են ապրանքների տեղաշարժի մասին: Բոլորն ունեն իրենց սեփական վավերացման կանոնները. ոմանց համար էլ. փոստը վավեր է, ինչը նշանակում է, որ այն կմշակվի, ոմանց համար այն վավեր չէ, բայց պատվերը միևնույն է կմշակվի, քանի որ կա կապի համար հեռախոսահամար, և ինչ-որ մեկը կասի, որ նման պատվերը ընդհանրապես չի մշակվի:
Տվյալների հոսք
Կաֆկայի դեպքում առաջանում է տվյալների հոսքի կազմակերպման հարցը։ Այս խնդիրը կապված է մի քանի կետերի վերաբերյալ ռազմավարության ընտրության հետ, եկեք անդրադառնանք դրանցից յուրաքանչյուրին։
Մեկ թեմայում, թե՞ տարբեր թեմաներում։
Մենք ունենք իրադարձության սպեցիֆիկացիա։ BOB-ում մենք գրում ենք, որ այսինչ պատվերը պետք է առաքվի, և նշում ենք՝ պատվերի համարը, դրա կազմը, որոշ SKU-ներ և շտրիխ կոդեր և այլն։ Երբ ապրանքները հասնեն պահեստ, առաքումը կկարողանա ստանալ կարգավիճակներ, ժամանակային դրոշմանիշներ և այն ամենը, ինչ անհրաժեշտ է։ Բայց այդ դեպքում մենք ցանկանում ենք ստանալ թարմացումներ այս տվյալների վերաբերյալ BOB-ում։ Մենք ունենք առաքումից տվյալներ ստանալու հակադարձ գործընթաց։ Սա նույն իրադարձությունն է՞, թե՞ սա առանձին փոխանակում է, որը արժանի է առանձին թեմայի։
Ամենայն հավանականությամբ, դրանք շատ նման կլինեն, և մեկ թեմա դարձնելու գայթակղությունը անհիմն չէ, քանի որ առանձին թեմա նշանակում է առանձին սպառողներ, առանձին կոնֆիգուրացիաներ, այս ամենի առանձին գեներացիա։ Բայց դա փաստ չէ։
Նոր դաշտ, թե՞ նոր միջոցառում։
Սակայն, եթե մենք օգտագործենք նույն իրադարձությունները, առաջանում է մեկ այլ խնդիր։ Օրինակ, ոչ բոլոր առաքման համակարգերը կարող են ստեղծել այնպիսի DTO, որը կարող է ստեղծել BOB-ը։ Մենք նրանց ուղարկում ենք նույնականացուցիչներ, բայց նրանք չեն պահպանում դրանք, քանի որ դրանց կարիքը չունեն, և իրադարձությունների ավտոբուսի գործընթացը սկսելու տեսանկյունից այս դաշտը պարտադիր է։
Եթե մենք event-bus-ի համար ներդնենք կանոն, որ այս դաշտը պարտադիր է, ապա մենք ստիպված կլինենք BOB-ում կամ մեկնարկային event handler-ում սահմանել լրացուցիչ վավերացման կանոններ: Վավերացումը սկսում է տարածվել ամբողջ ծառայության վրա՝ սա շատ հարմար չէ:
Մեկ այլ խնդիր է աստիճանական մշակման գայթակղությունը։ Մեզ ասում են, որ մենք պետք է ինչ-որ բան ավելացնենք իրադարձությանը, և գուցե, եթե ուշադիր մտածենք, դա պետք է լիներ առանձին իրադարձություն։ Բայց մեր սխեմայում առանձին իրադարձությունը առանձին թեմա է։ Առանձին թեմա է վերևում նկարագրված ամբողջ գործընթացը։ Մշակողը գայթակղվում է պարզապես JSON սխեմային մեկ այլ դաշտ ավելացնել և վերականգնել։
Վերադարձի դեպքում մենք իրադարձությունների իրադարձությանը հասանք կես տարվա ընթացքում։ Մենք ունեինք մեկ մետա-իրադարձություն՝ «վերադարձի թարմացում» անվամբ, որն ուներ տիպի դաշտ, որը նկարագրում էր, թե իրականում ինչից է բաղկացած այս թարմացումը։ Դրանից մենք ունեինք «հրաշալի» անջատիչներ՝ վավերացուցիչներով, որոնք ասում էին, թե ինչպես վավերացնել այս իրադարձությունը այս տեսակի միջոցով։
Իրադարձությունների տարբերակում
Kafka-ում հաղորդագրությունները վավերացնելու համար կարող եք օգտագործել , բայց անհրաժեշտ էր անմիջապես դադարեցնել սա և օգտագործել Confluent-ը: Մեր դեպքում մենք պետք է զգույշ լինենք տարբերակների ընտրության հարցում: Միշտ չէ, որ հնարավոր կլինի վերընթերցել կրկնօրինակման գրանցամատյանից հաղորդագրությունները, քանի որ մոդելը «լքել է»: Հիմնականում պարզվում է, որ մոդելները պետք է կառուցվեն այնպես, որ դրանք հետադարձ համատեղելի լինեն. օրինակ՝ դաշտը ժամանակավորապես դառնում է ընտրովի: Եթե տարբերությունները չափազանց ուժեղ են, մենք սկսում ենք գրել նոր թեմայում և փոխանցում ենք հաճախորդներին, երբ նրանք ավարտեն հին թեմայի ընթերցումը:
Բաժանումների ընթերցման հերթականության երաշխիք
Kafka-ի ներսում թեմաները բաժանված են բաժինների։ Սա շատ կարևոր չէ, երբ մենք նախագծում ենք էական տարրեր և փոխանակումներ, բայց կարևոր է, երբ որոշում ենք, թե ինչպես դրանք սպառել և մասշտաբավորել։
Սովորական դեպքում դուք Կաֆկային գրում եք մեկ թեմա։ Ըստ լռելյայնի, օգտագործվում է մեկ բաժին, և այդ թեմայի բոլոր հաղորդագրությունները մտնում են դրա մեջ։ Եվ սպառողը համապատասխանաբար կարդում է այդ հաղորդագրությունները հաջորդաբար։ Ենթադրենք, որ հիմա դուք պետք է ընդլայնեք համակարգը, որպեսզի հաղորդագրությունները կարդան երկու տարբեր սպառողներ։ Եթե, օրինակ, ուղարկեք SMS, կարող եք Կաֆկային ասել ստեղծել լրացուցիչ բաժին, և Կաֆկան կսկսի հաղորդագրությունները բաժանել երկու մասի՝ կեսը՝ այնտեղ, կեսը՝ այստեղ։
Ինչպե՞ս է Կաֆկան բաժանում դրանք։ Յուրաքանչյուր հաղորդագրություն ունի մարմին (որտեղ մենք պահում ենք JSON-ը) և բանալի։ Այս բանալու վրա կարող է կիրառվել հեշ ֆունկցիա, որը կորոշի, թե որ բաժնում կհայտնվի հաղորդագրությունը։
Մեր դեպքում՝ վերադարձի դեպքում, սա կարևոր է, եթե մենք վերցնենք երկու բաժին, ապա կա հավանականություն, որ զուգահեռ սպառողը երկրորդ իրադարձությունը կմշակի առաջինից առաջ, և խնդիրներ կառաջանան։ Հեշ ֆունկցիան երաշխավորում է, որ նույն բանալիով հաղորդագրությունները կհայտնվեն նույն բաժնում։
Իրադարձություններ ընդդեմ հրամանների
Սա ևս մեկ խնդիր է, որին մենք բախվել ենք։ Իրադարձությունը որոշակի իրադարձություն է. մենք ասում ենք, որ ինչ-որ տեղ ինչ-որ բան է տեղի ունեցել (something_happened), օրինակ՝ ապրանքը չեղարկվել է կամ վերադարձ է կատարվել։ Եթե ինչ-որ մեկը լսի այս իրադարձությունները, ապա «item was uncelled» (իրը չեղարկվել է) դեպքում կստեղծվի վերադարձի միավոր, և «refund occurred» (վերադարձ տեղի է ունեցել) գրառումը կգրանցվի կարգավորումների որևէ տեղ։
Բայց սովորաբար, երբ դուք նախագծում եք միջոցառումներ, դուք չեք ուզում դրանք գրել ապարդյուն. դուք հույս ունեք, որ ինչ-որ մեկը կկարդա դրանք: Գայթակղիչ է գրել ինչ-որ բան, որը պետք է արվի, այլ ոչ թե ինչ-որ բան, որը տեղի է ունեցել (item_canceled, refund_refunded): Օրինակ՝ item is ready to refund.
Մի կողմից, այն ցույց է տալիս, թե ինչպես է օգտագործվելու իրադարձությունը։ Մյուս կողմից, այն շատ ավելի քիչ է նման սովորական իրադարձության անվան։ Եվ այն շատ հեռու չէ do_something հրամանից։ Բայց դուք երաշխիք չունեք, որ ինչ-որ մեկը կարդացել է իրադարձությունը. և եթե կարդացել է, ապա հաջողությամբ կարդացել է այն. և եթե կարդացել է, ապա ինչ-որ բան արել է, և այդ ինչ-որ բան հաջողությամբ է իրականացվել։ Այն պահին, երբ իրադարձությունը դառնում է do_something, հետադարձ կապը դառնում է անհրաժեշտ, և դա խնդիր է։
RabbitMQ-ում ասինխրոն հաղորդակցության դեպքում, երբ կարդում եք հաղորդագրություն, մտնում եք http, ստանում եք պատասխան՝ առնվազն այն մասին, որ հաղորդագրությունն ստացվել է։ Երբ գրում եք Կաֆկային, կա մի հաղորդագրություն, որը գրել եք Կաֆկային, բայց դուք ոչինչ չգիտեք այն մասին, թե ինչպես է այն մշակվել։
Հետևաբար, մեր դեպքում մենք ստիպված էինք ներդնել արձագանքման իրադարձություն և կարգավորել մոնիթորինգ, որպեսզի եթե այդքան իրադարձություններ ակտիվանային, նույնքան արձագանքման իրադարձություններ պետք է հասնեին այսքան ժամանակ անց։ Եթե դա տեղի չունեցավ, ապա, կարծես, ինչ-որ բան այն չէ։ Օրինակ, եթե մենք ուղարկեցինք «item_ready_to_refund» իրադարձությունը, մենք ակնկալում ենք, որ վերադարձը կստեղծվի, հաճախորդը կվերադարձնի իր գումարը, և մենք կստանանք «money_refunded» իրադարձությունը։ Բայց սա հաստատ չէ, ուստի մեզ անհրաժեշտ է մոնիթորինգ։
Նամակներ
Կա բավականին ակնհայտ խնդիր. եթե դուք թեմայից հետևողականորեն կարդում եք և ունեք որոշ վատ ուղերձ, սպառողը կկորցնի իր դիրքը, և դուք այլևս չեք կարողանա առաջ գնալ։ Ձեզ անհրաժեշտ է դադարեցնել բոլոր սպառողներին, commit offset next-ը սեղմել՝ ընթերցումը շարունակելու համար։
Մենք գիտեինք դրա մասին, մենք հույս ունեինք դրա վրա, և այն այնուամենայնիվ տեղի ունեցավ։ Եվ դա տեղի ունեցավ, քանի որ իրադարձությունը վավեր էր իրադարձությունների ավտոբուսի տեսանկյունից, իրադարձությունը վավեր էր ծրագրի վավերացուցիչի տեսանկյունից, բայց այն վավեր չէր PostgreSQL-ի տեսանկյունից, քանի որ մեկ համակարգում մենք ունեինք MySQL՝ UNSIGNED INT-ով, իսկ նոր գրված համակարգում կար PostgreSQL՝ պարզապես INT-ով։ Այն մի փոքր ավելի փոքր չափի էր, և Id-ն չէր տեղավորվում։ Symfony-ն մահացավ բացառության հետ։ Իհարկե, մենք բռնեցինք բացառությունը, քանի որ հույս ունեինք դրա վրա և պատրաստվում էինք կատարել այս offset-ը, բայց դրանից առաջ մենք ուզում էինք մեծացնել խնդրի հաշվիչը, քանի որ հաղորդագրությունը անհաջող մշակվեց։ Այս նախագծի հաշվիչները նույնպես տվյալների բազայում են, և Symfony-ն արդեն փակել է տվյալների բազայի հետ կապը, իսկ երկրորդ բացառությունը սպանեց ամբողջ գործընթացը՝ առանց offset-ը կատարելու հնարավորության։
Ծառայությունը որոշ ժամանակ անջատված էր. բարեբախտաբար, Կաֆկայի հետ այդքան էլ վատ չէ, քանի որ հաղորդագրությունները մնում են: Երբ աշխատանքը վերականգնվի, կարող եք ավարտել դրանց ընթերցումը: Հարմար է:
Կաֆկան ունի գործիքավորման միջոցով կամայական շեղում սահմանելու հնարավորություն։ Բայց դա անելու համար անհրաժեշտ է կանգնեցնել բոլոր սպառողներին՝ մեր դեպքում պատրաստել առանձին թողարկում, որում սպառողներ, վերաբաշխումներ չեն լինի։ Այնուհետև Կաֆկան կարող է տեղաշարժել շեղումը գործիքավորման միջոցով, և հաղորդագրությունը կանցնի։
Մեկ այլ նրբերանգ է Կրկնօրինակման գրանցամատյանը ընդդեմ rdkafka.so-ի — կապված է մեր նախագծի առանձնահատկությունների հետ։ Մենք ունենք PHP, և PHP-ում, որպես կանոն, բոլոր գրադարանները Kafka-ի հետ կապ են հաստատում rdkafka.so պահոցի միջոցով, և այդ դեպքում կա ինչ-որ փաթաթան։ Հնարավոր է՝ սրանք մեր անձնական դժվարություններն են, բայց պարզվեց, որ արդեն կարդացածի մի մասը պարզապես վերընթերցելը այդքան էլ պարզ չէ։ Ընդհանուր առմամբ, ծրագրային խնդիրներ կային։
Վերադառնալով բաժանմունքների հետ աշխատելու առանձնահատկություններին, այն գրված է հենց փաստաթղթերում սպառողներ >= թեմատիկ բաժիններԲայց ես այս մասին իմացա շատ ավելի ուշ, քան կցանկանայի։ Եթե ուզում եք մասշտաբավորվել և ունենալ երկու սպառող, ձեզ անհրաժեշտ է առնվազն երկու բաժին։ Այսինքն, եթե դուք ունեցել եք մեկ բաժին, որը կուտակել է 20 հազար հաղորդագրություն, և դուք ստեղծել եք նորը, հաղորդագրությունների քանակը շուտով չի հավասարվի։ Հետևաբար, երկու զուգահեռ սպառող ունենալու համար դուք պետք է պարզեք բաժինները։
Մոնիտորինգ
Կարծում եմ, որ մեր մոնիթորինգի հիման վրա ավելի պարզ կդառնա, թե ինչ խնդիրներ կան առկա մոտեցման մեջ։
Օրինակ, մենք հաշվարկում ենք, թե տվյալների բազայում քանի ապրանք է վերջերս փոխել իր կարգավիճակը, և, համապատասխանաբար, այդ փոփոխությունների համար պետք է տեղի ունենային իրադարձություններ, և այս թիվն ուղարկում ենք մեր մոնիթորինգի համակարգին: Այնուհետև Kafka-ից ստանում ենք երկրորդ թիվը, թե իրականում քանի իրադարձություն է գրանցվել: Ակնհայտ է, որ այս երկու թվերի միջև տարբերությունը միշտ պետք է զրո լինի:
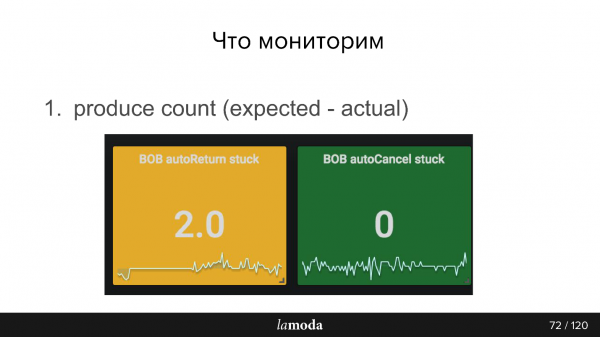
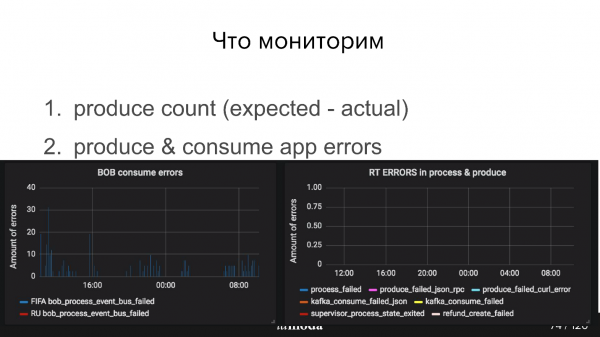
Բացի այդ, դուք պետք է հետևեք, թե ինչպես է արտադրողը գործում, արդյոք իրադարձությունների ավտոբուսը ստացել է հաղորդագրություններ և ինչպես է սպառողը գործում: Օրինակ, ստորև բերված գրաֆիկներում Refund Tool-ը լավ է գործում, բայց BOB-ն ակնհայտորեն որոշ խնդիրներ ունի (կապույտ գագաթներ):
Ես արդեն նշեցի սպառողական խմբի լագը։ Կոպիտ ասած, սա չկարդացված հաղորդագրությունների թիվն է։ Ընդհանուր առմամբ, մեր սպառողները արագ են աշխատում, ուստի լագը սովորաբար 0 է, բայց երբեմն կարող է լինել կարճաժամկետ գագաթնակետ։ Կաֆկան կարող է դա անել անմիջապես, բայց դուք պետք է սահմանեք որոշակի ժամանակահատված։
Նախագիծ կա , որը ձեզ ավելի շատ տեղեկություններ կտա Kafka-ի մասին: Այն պարզապես API-ի միջոցով տալիս է սպառողական խմբի կարգավիճակը, թե ինչպես է այս խումբը գործում: Բացի «Լավ» և «Չհաջողված» արտահայտություններից, կա նախազգուշացում, և դուք կարող եք պարզել, որ ձեր սպառողները չեն կարողանում հաղթահարել արտադրության տեմպը. նրանք ժամանակ չունեն կարդալու, թե ինչ է գրվում: Համակարգը բավականին խելացի է, հարմար է օգտագործման համար:
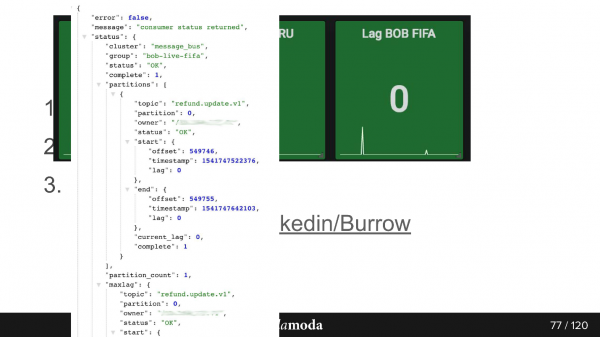
Ահա թե ինչ տեսք ունի API-ի պատասխանը։ Ահա bob-live-fifa խումբը, partition refund.update.v1, status OK, lag 0 — վերջին վերջնական offset-ը այսպես-այսպիսին է։
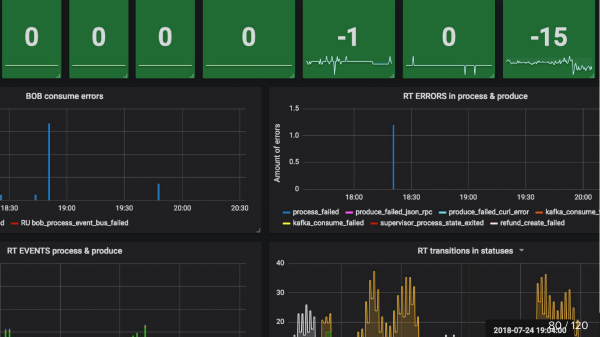
Մոնիտորինգ updated_at SLA (խրված է) Ես արդեն նշել եմ դա։ Օրինակ՝ ապրանքի կարգավիճակը փոխվել է վերադարձի համար պատրաստի։ Մենք ստեղծել ենք Cron, որը ասում է, որ եթե այս օբյեկտը 5 րոպեի ընթացքում չի փոխվել վերադարձի կարգավիճակի (մենք շատ արագ վերադարձնում ենք գումարը վճարային համակարգերի միջոցով), ապա ինչ-որ բան անկասկած այն չէ, և սա անկասկած աջակցության կարիք ունի։ Հետևաբար, մենք պարզապես վերցնում ենք Cron, որը կարդում է նման բաներ, և եթե դրանք մեծ են 0-ից, ապա այն ուղարկում է ահազանգ։
Ամփոփելով՝ իրադարձությունները օգտակար են, երբ:
- տեղեկատվությունը անհրաժեշտ է մի քանի համակարգերի համար։
- մշակման արդյունքը կարևոր չէ.
- իրադարձությունները քիչ են, կամ իրադարձությունները փոքր են։
Թվում է, թե հոդվածն ունի շատ կոնկրետ թեմա՝ ասինխրոն API Kafka-ի վրա, բայց դրա հետ կապված ես կցանկանայի միանգամից շատ բաներ խորհուրդ տալ։
Նախևառաջ, հաջորդը Մենք պարտավոր չենք սպասել մինչև նոյեմբեր, ապրիլին կլինի Սանկտ Պետերբուրգի տարբերակը, իսկ հունիսին կխոսենք Նովոսիբիրսկում բարձր բեռների մասին։
Երկրորդ, զեկույցի հեղինակը՝ Սերգեյ Զաիկան, գիտելիքների կառավարման մեր նոր համաժողովի ծրագրային կոմիտեի անդամ է։ Համաժողովը մեկօրյա է և տեղի կունենա ապրիլի 26-ին, սակայն ծրագիրը շատ խիտ է։
Եվ մայիսին կլինի ևս մեկը и (DevOpsConf-ը ներառյալ) - կարող եք նաև այնտեղ առաջարկել ձեր թեման, խոսել ձեր փորձի մասին և բողոքել ձեր այտուցներից ու կապտուկներից։
Source: www.habr.com
