

Introduzione
In questo articolo parlerò del noto algoritmo di Huffman e del suo utilizzo nella compressione dei dati.
Di conseguenza scriveremo un semplice archiver. Questo è già stato , ma senza implementazione pratica. Il materiale teorico di questo post è tratto dalle lezioni di informatica scolastica e dal libro di Robert Lafore "Data Structures and Algorithms in Java". Dunque, tutto sotto il tag!
Alcuni pensieri
In un file di testo normale, un carattere è codificato in 8 bit (codifica ASCII) o 16 (codifica Unicode). In seguito considereremo la codifica ASCII. Prendiamo ad esempio la stringa s1 = "SUSIE SAYS IT IS EASYn". In totale ci sono 22 caratteri nella stringa, inclusi naturalmente gli spazi e il simbolo di nuova riga - 'n'. Un file contenente questa stringa peserà 22*8 = 176 bit. Subito sorge la domanda: è razionale utilizzare tutti e 8 i bit per codificare 1 carattere? Non usiamo tutti i simboli della codifica ASCII. Anche se li usassimo, sarebbe più razionale dare alla lettera più comune - S - il codice più corto possibile, mentre per la lettera più rara - T (o U o 'n') - un codice più lungo. Questo è ciò che fa l'algoritmo di Huffman: trovare l'opzione di codifica ottimale in cui il file abbia il peso minimo. È perfettamente normale che i diversi caratteri abbiano lunghezze di codice diverse: è su questo che si basa l'algoritmo.
Codifica
Perché non dare al carattere 'S' un codice, ad esempio lungo 1 bit: 0 o 1. Facciamo che sia 1. Allora daremo 0 al secondo carattere più comune - ' ' (spazio). Immagina di aver iniziato a decodificare il tuo messaggio - la stringa codificata s1 - e noti che il codice inizia con 1. Quindi, cosa fare: è il simbolo S, o è un altro simbolo, ad esempio A? Pertanto, sorge una regola importante:
Nessun codice deve essere un prefisso di un altro
Questa regola è fondamentale nell'algoritmo. Pertanto, la creazione del codice inizia con una tabella delle frequenze, in cui è indicata la frequenza (il numero di occorrenze) di ciascun simbolo:
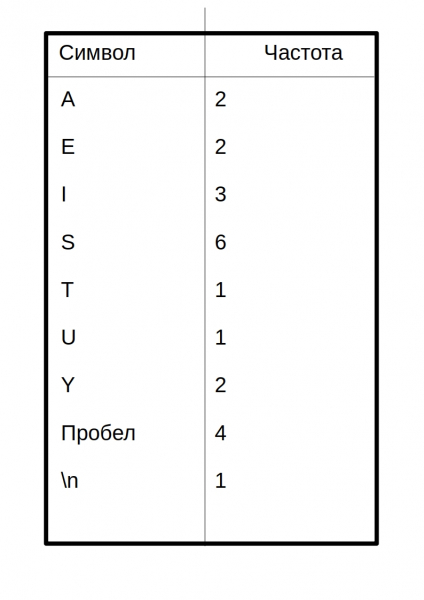 I simboli con il numero maggiore di occorrenze devono essere codificati con il minor numero possibile di bit. Ecco un esempio di una delle possibili tabelle dei codici:
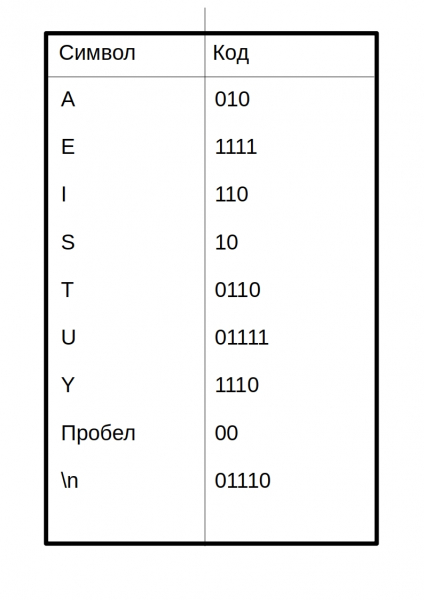 Pertanto, il messaggio codificato apparirà così:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Ho separato il codice di ciascun simbolo con uno spazio. In un file compresso reale non sarà così!
Sorge la domanda: come ha fatto questo novellino a inventare il codice per creare una tabella di codici? Di questo si parlerà più avanti.
Costruzione dell'albero di Huffman
Qui entrano in gioco gli alberi binari di ricerca. Non preoccupatevi, qui non saranno necessari metodi di ricerca, inserimento e cancellazione. Ecco la struttura dell'albero in java:
public class Node {
    private int frequenza;
    private char lettera;
    private Node figlioSinistro;
    private Node figlioDestro;
    ...
}
class BinaryTree {
    private Node radice;

    public BinaryTree() {
        radice = new Node();
    }
    public BinaryTree(Node radice) {
        this.radice = radice;
    }
    ...
}
Questo non è il codice completo, il codice completo verrà fornito più in basso.
Ecco l'algoritmo per costruire l'albero:
- Creare un oggetto Node per ogni simbolo del messaggio (stringa s1). In questo caso avremo 9 nodi (oggetti Node). Ogni nodo è composto da due campi dati: simbolo e frequenza.
- Creare un oggetto Albero (BinaryTree) per ciascuno dei nodi Node. Il nodo diventa la radice dell'albero.
- Inserire questi alberi in una coda di priorità. Maggiore è la frequenza, minore è la priorità. In questo modo, l'albero con la frequenza più bassa viene sempre estratto.
Successivamente, è necessario eseguire ciclicamente quanto segue:
- Estrarre due alberi dalla coda di priorità e fare di essi i figli di un nuovo nodo (il nodo appena creato senza lettera). La frequenza del nuovo nodo è la somma delle frequenze dei due alberi figli.
- Per questo nodo, creare un albero con la radice in questo nodo. Inserire di nuovo questo albero nella coda di priorità. (Poiché l'albero ha una nuova frequenza, probabilmente si sposterà in una nuova posizione nella coda.)
- Continuare a seguire i passi 1 e 2 finché nella coda non rimarrà un solo albero: l'albero di Huffman.
Consideriamo questo algoritmo sulla stringa s1:
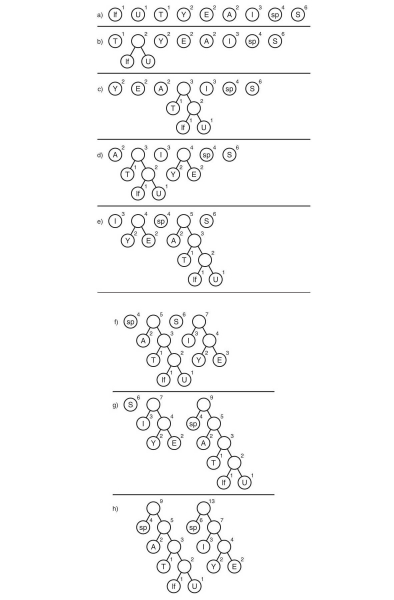
Qui il simbolo «lf» (linefeed) indica un cambio di riga, «sp» (space) è uno spazio.
E poi?
Abbiamo ottenuto l'albero di Huffman. Bene. E adesso cosa facciamo? Neppure gratuitamente lo prenderanno! Inoltre, è necessario tracciare tutti i possibili percorsi dalla radice alle foglie dell'albero. Conveniamo di designare un arco 0 se conduce a un figlio sinistro e 1 se a un destro. Strettamente parlando, in queste designazioni, il codice del simbolo è il percorso dalla radice dell'albero alla foglia che contiene quel simbolo.
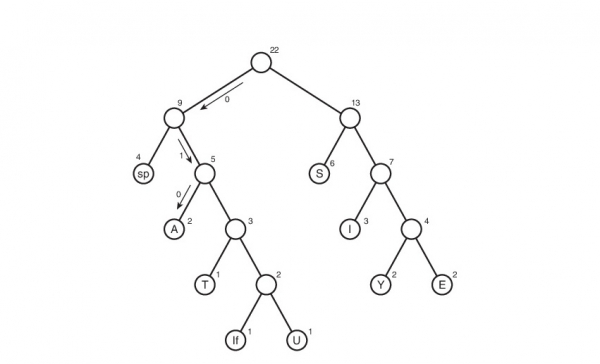
In questo modo si è ottenuta la tabella dei codici. Notiamo che se esaminiamo questa tabella, possiamo trarre delle conclusioni sul «peso» di ogni simbolo: è la lunghezza del suo codice. Quindi, in forma compressa, il file originale peserà: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bit. Inizialmente pesava 176 bit. Pertanto, lo abbiamo ridotto di ben 176/65 = 2,7 volte! Ma questa è utopia. È difficile ottenere tale coefficiente. Perché? Di questo parleremo più avanti.
Decodifica
Beh, forse è rimasto l'aspetto più semplice: la decodifica. Penso che molti di voi abbiano intuito che non è possibile creare un file compresso senza alcun indizio su come sia stato codificato: non saremo in grado di decodificarlo! Sì, è stato difficile accettarlo, ma sarà necessario creare un file di testo table.txt con la tabella di compressione:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Registrazione della tabella nella forma ‘simbolo’«codice simbolo». Perché 01110 senza simbolo? In realtà ha un simbolo, solo che gli strumenti Java che utilizzo per l'output nel file convertono il carattere di nuova riga — ‘n’ - in un vero e proprio ritorno a capo (per quanto stupido possa sembrare). Quindi la riga vuota sopra è il simbolo per il codice 01110. Per il codice 00, il simbolo è uno spazio all'inizio della riga. Dico subito che il nostro coefficiente rischia di tramontare: questo modo di memorizzare la tabella può essere considerato il meno razionale. Ma è semplice da comprendere e da realizzare. Sarò felice di ascoltare i vostri suggerimenti nei commenti riguardo all'ottimizzazione.
Avendo questa tabella, è molto semplice decodificare. Ricordiamo quale regola abbiamo seguito nella creazione della codifica:
Nessun codice dovrebbe essere un prefisso di un altro.
Ed è qui che giocano un ruolo semplificatore. Leggiamo bit per bit, e non appena la stringa d ottenuta, composta dai bit letti, corrisponde alla codifica associata al simbolo character, sappiamo subito che è stato codificato il simbolo character (e solo lui!). Poi registriamo character nella stringa di decodifica (la stringa che contiene il messaggio decodificato), azzeriamo la stringa d e continuiamo a leggere il file codificato.
Implementazione
È tempo di abbattere il mio codice e scrivere un compressore. Chiamerò questo compressore Compressor.
Iniziamo dall'inizio. Prima di tutto, scriviamo la classe Node:
public class Node {
    private int frequenza; // frequenza
    private char lettera; // lettera
    private Node figlioSinistro; // figlio sinistro
    private Node figlioDestro; // figlio destro

    public Node(char lettera, int frequenza) { // costruttore
        this.lettera = lettera;
        this.frequenza = frequenza;
    }

    public Node() {} // sovraccarico del costruttore per nodi senza nome (vedi sopra nella sezione sulla costruzione dell'albero di Huffman)
    public void aggiungiFiglio(Node nuovoNodo) { // aggiungere un figlio
        if (figlioSinistro == null) // se sinistro è vuoto => destro è anche vuoto => aggiungi a sinistro
            figlioSinistro = nuovoNodo;
        else {
            if (figlioSinistro.getFrequenza() <= nuovoNodo.getFrequenza()) // in generale, figlio sinistro
                figlioDestro = nuovoNodo; // diventerà quello con frequenza minore
            else {
                figlioDestro = figlioSinistro;
                figlioSinistro = nuovoNodo;
            }
        }

        frequenza += nuovoNodo.getFrequenza(); // frequenza totale
    }

    public Node getFiglioSinistro() {
        return figlioSinistro;
    }

    public Node getFiglioDestro() {
        return figlioDestro;
    }

    public int getFrequenza() {
        return frequenza;
    }

    public char getLettera() {
        return lettera;
    }

    public boolean isFoglia() { // controllo se è una foglia
        return figlioSinistro == null && figlioDestro == null;
    }
}
Ora l'alberello:
class BinaryTree {
    private Node radice;

    public BinaryTree() {
        radice = new Node();
    }

    public BinaryTree(Node radice) {
        this.radice = radice;
    }

    public int getFrequenza() {
        return radice.getFrequenza();
    }

    public Node getRadice() {
        return radice;
    }
}
Coda di priorità:
import java.util.ArrayList; // sì, sì, la coda sarà basata su una lista

class PriorityQueue {
    private ArrayList dati; // lista della coda
    private int nElem; // numero di elementi nella coda

    public PriorityQueue() {
        dati = new ArrayList();
        nElem = 0;
    }

    public void inserisci(BinaryTree nuovoAlbero) { // inserimento
        if (nElem == 0)
            dati.add(nuovoAlbero);
        else {
            for (int i = 0; i  nuovoAlbero.getFrequenza()) { // se la frequenza dell'albero inserito è minore
                    dati.add(i, nuovoAlbero); // spostiamo tutti gli alberi nelle posizioni a destra di 1 cella
                    break; // poi inseriamo il nuovo albero nella posizione corrente
                }
                if (i == nElem - 1)
                    dati.add(nuovoAlbero);
            }
        }
        nElem++; // aumentiamo il numero di elementi di 1
    }

    public BinaryTree rimuovi() { // rimozione dalla coda
        BinaryTree tmp = dati.get(0); // copiamo l'elemento da rimuovere
        dati.remove(0); // effettivamente rimuoviamo
        nElem--; // diminuiamo il numero di elementi di 1
        return tmp; // restituiamo l'elemento rimosso (l'elemento con la frequenza minore)
    }
}
Classe che crea un albero di Huffman:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // lunghezza della tabella di codifica
    private String myString; // messaggio
    private BinaryTree huffmanTree; // albero di Huffman
    private int[] freqArray; // tabella delle frequenze
    private String[] encodingArray; // tabella di codifica


    //----------------costruttore----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------tabella delle frequenze------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    //------------------------creazione dell'albero di Huffman------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmo descritto sopra
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // se il simbolo esiste nella stringa
                Node newNode = new Node((char) i, freqArray[i]); // quindi crea un Node per esso
                BinaryTree newTree = new BinaryTree(newNode); // e crea un BinaryTree per Node
                pq.insert(newTree); // inserire nella coda
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // estrarre dalla coda il primo albero.

            try {
                BinaryTree tree2 = pq.remove(); // estrarre dalla coda il secondo albero

                Node newNode = new Node(); // creare un nuovo Node
                newNode.addChild(tree1.getRoot()); // fare dei due alberi estratti i suoi figli
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode));
            } catch (IndexOutOfBoundsException e) { // rimane un solo albero nella coda
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    //-------------------tabella di codifica------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // riempire la tabella di codifica
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // per il debug
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Tabella di codifica====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Classe che codifica/decodifica:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; //lunghezza della tabella
    private HuffmanTree mainHuffmanTree; //albero di Huffman (utilizzato solo per la compressione)
    private String myString; //messaggio originale
    private int[] freqArray; //tabella delle frequenze
    private String[] encodingArray; //tabella di codifica
    private double ratio; //coefficiente di compressione

    public HuffmanOperator(HuffmanTree MainHuffmanTree) { //per compressione
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} //per estrarre;

    //---------------------------------------compression-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; //stringa intermedia (senza zeri aggiuntivi)
        //System.out.println("=============================Compression=======================");
        //displayEncodingArray();
        for (int i = 0; i
        //dobbiamo aggiungere zeri alla fine (può essere 1, non fa differenza)
        byte counter = 0; //numero di zeri aggiunti alla fine (un byte è sufficiente: 0<=counter<8<127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta; counter++) { //delta - numero di zeri aggiunti
            intermidiate += "0";
        }

        //unire il numero di zeri aggiuntivi nella rappresentazione binaria e la stringa intermedia
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        //coefficiente idealizzato
        setCompressionRatio();
        //System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { //calcolare il coefficiente idealizzato
        double sumA = 0, sumB = 0; //A - il totale originale
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { //compressone finale
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    //---------------------------------------end of compression----------------------------------------------------------------
    //------------------------------------------------------------extract-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        //displayEncodingArray();
        //ottenere il numero di zeri aggiunti
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            //i = 8, poiché il primo byte rappresenta il numero di zeri aggiunti
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { //se corrisponde
                    decompressed += (char)j; //allora aggiungiamo l'elemento
                    current = ""; //e azzeriamo la stringa corrente
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { //per debug
        System.out.println("======================Tabella di codifica====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            //if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            //}
        }
        System.out.println("========================================================");
    }
}
Classe che semplifica la scrittura su file:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Percorso non valido o file inesistente!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Classe che semplifica la lettura da file:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // se il file è finito
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
E, infine, la classe principale:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // Specifica l'istruzione tramite argomenti da riga di comando
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Formato di input degli argomenti non valido ");
            System.out.println("Leggi Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Percorso non valido o file non esistente!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Il formato di codifica del file non è supportato");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // crea file con tabella di codifica:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Percorso del file compresso: " + compressedFile.getAbsolutePath());
        System.out.println("Percorso della tabella di codifica " + table.getAbsolutePath());
        System.out.println("Senza tabella, il file non può essere estratto!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // rapporto idealizzato
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // rapporto reale

        System.out.println("Il rapporto di compressione idealizzato è " + idealRatio);
        System.out.println("Il rapporto di compressione includendo la tabella di codifica è " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // leggi il file compresso
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! verifica qui:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // il metodo restituisce EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // leggi la tabella di codifica:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // salta la prima stringa vuota
        	encodingArray[(byte)'n'] = fi.readLine(); // leggi il codice per 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // estrazione:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Percorso del file estratto " + extractedFile.getAbsolutePath());
    }
}
Il file con le istruzioni readme.txt dovrete scriverlo voi stessi 🙂
Conclusione
Forse è tutto ciò che volevo dire. Se avete qualcosa da dire riguardo alla mia incompetenza nei miglioramenti del codice, dell'algoritmo o in generale su qualsiasi ottimizzazione, scrivete pure. Se qualcosa non vi è chiaro, scrivete anche quello. Sarò felice di sentirvi nei commenti!
P.S.
Sì-sì, sono ancora qui, infatti non ho dimenticato il coefficiente. Per la stringa s1, la tabella di codifica pesa 48 byte — molto di più del file originale, e non dimentichiamo i zeri aggiuntivi (il numero di zeri aggiunti è 7) => il coefficiente di compressione sarà inferiore a uno: 176/(65 + 48*8 + 7)=0.38. Se anche voi l'avete notato, siete bravi. Sì, questa implementazione sarà estremamente inefficace per file piccoli. Ma cosa succede con file grandi? Le dimensioni del file superano di gran lunga le dimensioni della tabella di codifica. Qui l'algoritmo funziona come dovrebbe! Ad esempio, per il comprimente restituisce un coefficiente reale (non idealizzato) pari a 1.46 — quasi un volta e mezza! E sì, si presumeva che il file fosse in inglese.
Fonte: habr.com
