

KDB+, prodotto dell'azienda è un database colonnare ampiamente conosciuto in ambiti ristretti, estremamente veloce, progettato per l'archiviazione di serie temporali e calcoli analitici basati su di esse. Inizialmente ha goduto (e gode) di grande popolarità nell'industria finanziaria: è utilizzato da tutte le prime 10 banche d'investimento e da molti noti fondi hedge, borse e altre organizzazioni. Recentemente, KX ha deciso di ampliare la propria base clienti e ora offre soluzioni anche in altri settori dove sono disponibili grandi quantità di dati, organizzati nel tempo o in altro modo: telecomunicazioni, bioinformatica, produzione, ecc. Sono diventati anche partner del team Aston Martin Red Bull Racing in Formula 1, dove aiutano a raccogliere e analizzare dati dai sensori delle auto e a eseguire test in galleria del vento. In questo articolo, voglio spiegare quali caratteristiche rendono KDB+ estremamente performante, perché le aziende sono pronte a investire somme elevate su di essa e, infine, perché in realtà non è un database.
In questo articolo cercherò di spiegare nel complesso cosa rappresenta KDB+, quali opportunità e limitazioni presenta, quale sia il suo valore per le aziende che desiderano elaborare grandi volumi di dati. Non entrerò nei dettagli dell'implementazione di KDB+ e nei dettagli del suo linguaggio di programmazione Q. Entrambi questi argomenti sono molto vasti e meritano articoli separati. Molte informazioni su questi temi possono essere trovate sul sito code.kx.com, inclusa una guida su Q — Q For Mortals (vedi link qui sotto).
Alcuni termini
- Database in memoria. Un database che memorizza i dati nella memoria RAM per accelerare l'accesso. I vantaggi di tale database sono chiari, mentre gli svantaggi includono la possibilità di perdita di dati e la necessità di avere grande quantità di memoria sul server.
- Database colonnare. Un database in cui i dati vengono memorizzati a colonne, invece che riga per riga. Il principale vantaggio di questo tipo di database è che i dati di una singola colonna vengono memorizzati insieme su disco e in memoria, il che accelera notevolmente l'accesso a essi. Non è necessario caricare colonne che non vengono utilizzate nella query. Lo svantaggio principale è che è complicato modificare e eliminare le righe.
- Serie temporale. Dati con una colonna di tipo data o ora. In genere, per tali dati è importante l'ordinamento temporale, in modo da poter facilmente determinare quale record precede o segue quello attuale, o per applicare funzioni il cui risultato dipende dall'ordine dei record. Le banche dati classiche si basano su un principio completamente diverso: la rappresentazione di un insieme di record come un insieme, dove l'ordine dei record non è definito.
- Vettore. Nel contesto di KDB+ — è un elenco di elementi di un singolo tipo atomico, come i numeri. In altre parole, è un array di elementi. Gli array, a differenza delle liste, possono essere conservati in modo compatto e elaborati utilizzando istruzioni vettoriali del processore.
Nota storica
L'azienda KX è stata fondata nel 1993 da Arthur Whitney, che prima lavorava presso la Morgan Stanley sul linguaggio A+, erede di APL — un linguaggio molto originale e un tempo popolare nel mondo finanziario. Naturalmente, in KX Arthur ha continuato nello stesso spirito e ha creato il linguaggio vettoriale-funzionale K, seguendo idee di radicale minimalismo. I programmi in K appaiono come un insieme disordinato di segni di punteggiatura e simboli speciali, il significato dei segni e delle funzioni dipende dal contesto, e ogni operazione porta con sé un numero molto maggiore di significato rispetto a quanto avviene nei linguaggi di programmazione più consueti. In questo modo, un programma in K occupa il minimo spazio — alcune righe possono sostituire pagine di testo di un linguaggio prolisso come Java — ed è un'implementazione superconcentrata dell'algoritmo.
Funzione in K che implementa la maggior parte del generatore di parser LL1 in base a una grammatica data:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"\/1_r),"]";""]]}
Questa filosofia di efficienza estrema con il minimo movimento è stata realizzata da Arthur anche in KDB+, che è stata lanciata nel 2003 (penso che ora sia chiaro da dove provenga la lettera K nel nome) e non è altro che l'interprete della quarta versione del linguaggio K. Sopra K è stata aggiunta una versione più gradevole per l'utente chiamata Q. In Q è stata anche aggiunta la supporto per un dialetto SQL specifico — QSQL, e nell'interprete — supporto per tabelle, come tipo di dato sistemico, strumenti per lavorare con tabelle in memoria e su disco, ecc.
Pertanto, dal punto di vista dell'utente, KDB+ è semplicemente un interprete del linguaggio Q con supporto per tabelle ed espressioni simili a SQL nello stile di LINQ di C#. Questa è la principale distinzione di KDB+ dalle altre basi di dati e il suo principale vantaggio competitivo, che spesso viene trascurato. Non è un database + un linguaggio ausiliario, ma un linguaggio di programmazione potente + un supporto integrato per le funzionalità del database. Questa differenza avrà un ruolo determinante nel riassumere tutti i vantaggi di KDB+. Ad esempio…
Dimensione
Secondo i parametri moderni, KDB+ ha una dimensione semplicemente microscopica. È letteralmente un file eseguibile di dimensioni inferiori a un megabyte e un piccolo file di testo con alcune funzioni di sistema. In realtà, è inferiore a un megabyte e le aziende pagano decine di migliaia di dollari all'anno per un solo processore su un server.
- Una tale dimensione consente a KDB+ di funzionare perfettamente su qualsiasi hardware, dal microcomputer Pi ai server con terabyte di memoria. Questo non influisce sulla funzionalità, anzi Q si avvia istantaneamente, permettendone l'uso anche come linguaggio di scripting.
- Con una tale dimensione, l'interprete Q si adatta completamente nella cache del processore, accelerando l'esecuzione dei programmi.
- Con una tale dimensione del file eseguibile, il processo Q occupa uno spazio insignificante in memoria, e possono essere avviati anche centinaia di essi. Tuttavia, se necessario, Q può operare anche con decine o centinaia di gigabyte di memoria all'interno di un singolo processo.
Versatilità
Q è perfetto per una varietà di compiti. Il processo Q può fungere da database storico e fornire un accesso rapido a terabyte di informazioni. Per esempio, abbiamo decine di database storici, alcuni dei quali contengono un singolo giorno di dati non compressi che occupa più di 100 gigabyte. Tuttavia, con alcune limitazioni ragionevoli, la richiesta al database verrà eseguita in decine o centinaia di millisecondi. In generale, abbiamo un timeout universale per le richieste degli utenti di 30 secondi, e questo si attiva raramente.
Con la stessa facilità, Q può essere un database in-memory. L'aggiunta di nuovi dati alle tabelle in memoria avviene così rapidamente che il fattore limitante sono le richieste degli utenti. I dati nelle tabelle sono memorizzati per colonne, il che significa che qualsiasi operazione su una colonna utilizzerà il cache della CPU al massimo. Inoltre, in KX ci siamo sforzati di implementare tutte le operazioni di base come quelle aritmetiche tramite istruzioni vettoriali della CPU, massimizzando la loro velocità. Q può eseguire anche compiti non tipici dei database, come elaborare dati in streaming e calcolare in "tempo reale" (con un ritardo che va da decine di millisecondi a diversi secondi a seconda del compito) varie funzioni aggregative per strumenti finanziari su diversi intervalli di tempo o costruire un modello dell'impatto di una transazione sul mercato e condurne il profiling quasi immediatamente dopo averla eseguita. In tali compiti, spesso il principale ritardo temporale è causato non da Q, ma dalla necessità di sincronizzare i dati da diverse fonti. L'elevata velocità è raggiunta grazie al fatto che i dati e le funzioni che li elaborano si trovano nello stesso processo, e l'elaborazione si riduce all'esecuzione di alcune espressioni QSQL e join, che non vengono interpretati, ma eseguiti in codice binario.
Infine, è possibile scrivere su Q anche qualsiasi processo di servizio. Ad esempio, i processi Gateway, che distribuiscono automaticamente le richieste degli utenti ai database e ai server appropriati. Lo sviluppatore ha la completa libertà di implementare qualsiasi algoritmo per bilanciare, prioritizzare, garantire tolleranza agli errori, gestire i diritti di accesso, le quote e praticamente qualsiasi cosa desideri. Il problema principale qui è che dovrà realizzare tutto da solo.
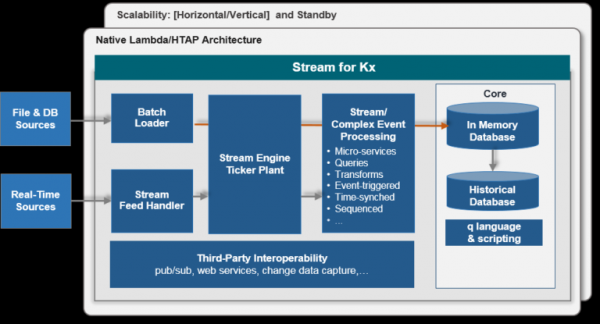
Per esempio, elencherò quali tipi di processi abbiamo. Tutti sono attivamente utilizzati e lavorano insieme, unendo in un unico insieme decine di diverse basi, elaborando dati da molteplici fonti e servendo centinaia di utenti e applicazioni.
- Connettori (feedhandler) per le fonti di dati. Questi processi utilizzano generalmente librerie esterne, che vengono caricate in Q. L'interfaccia C in Q è estremamente semplice e consente di creare senza sforzo funzioni proxy per qualsiasi libreria C/C++. Q è abbastanza rapido da gestire, ad esempio, l'elaborazione di flussi di messaggi FIX da tutte le borse europee simultaneamente.
- Distributori di dati (tickerplant), che fungono da anello intermedio tra i connettori e i consumatori. Nel contempo, scrivono i dati in ingresso in un registro binario speciale, assicurando resistenza per i consumatori a perdite di connessione o riavvii.
- Basi di dati in-memory (rdb). Queste basi garantiscono il massimo accesso rapido a dati freschi e grezzi, memorizzandoli in memoria. Di solito, accumulano dati in tabelle durante il giorno e li azzerano di notte.
- Basi di dati persistenti (pdb). Queste basi garantiscono la conservazione dei dati odierni in una base storica. Di solito, a differenza delle rdb, non memorizzano dati in memoria, ma utilizzano una speciale cache su disco durante il giorno e copiano i dati a mezzanotte nella base storica.
- Basi storiche (hdb). Queste basi forniscono accesso ai dati dei giorni, mesi e anni precedenti. La loro dimensione (in giorni) è limitata solo dalla capacità dei dischi rigidi. I dati possono trovarsi ovunque, in particolare su dischi diversi per accelerare l'accesso. È possibile comprimere i dati utilizzando diversi algoritmi a scelta. La struttura della base è ben documentata e semplice, i dati sono conservati in file normali, così che possano essere elaborati anche con i mezzi del sistema operativo.
- Basi con informazioni aggregate. Conservano diverse aggregazioni, di solito raggruppate per nome dello strumento e intervallo di tempo. Le basi in-memory aggiornano il loro stato con ogni messaggio in ingresso, mentre le storiche conservano dati pre-calcolati per accelerare l'accesso ai dati storici.
- Infine, processi gateway, che servono applicazioni e utenti. Q consente di implementare un'elaborazione completamente asincrona dei messaggi in ingresso, la loro distribuzione tra i database, la verifica dei diritti di accesso, ecc. Va detto che i messaggi non sono limitati e spesso non sono espressioni SQL, come accade in altri database. Nella maggior parte dei casi, l'espressione SQL è nascosta in una funzione speciale e viene costruita in base ai parametri richiesti dall'utente: viene eseguita la conversione temporale, la filtrazione, i dati vengono normalizzati (ad esempio, il prezzo delle azioni viene allineato se ci sono stati dividendi pagati) e così via.
Architettura tipica per un tipo di dati:
Velocità
Sebbene Q sia un linguaggio interpretato, è anche un linguaggio vettoriale. Ciò significa che molte funzioni incorporati, in particolare quelle aritmetiche, accettano argomenti di qualsiasi forma: numeri, vettori, matrici, liste, e ci si aspetta che il programmatore implementi il programma come operazioni su array. In un linguaggio di questo tipo, se si sommano due vettori di un milione di elementi, non importa che il linguaggio sia interpretato; la somma sarà eseguita da una funzione binaria superottimizzata. Poiché gran parte del tempo nei programmi in Q è dedicata alle operazioni con tabelle che utilizzano queste funzioni vettorializzate di base, il risultato è una velocità di esecuzione piuttosto buona, che consente di elaborare enormi volumi di dati anche in un solo processo. È simile alle librerie matematiche in Python: anche se Python stesso è un linguaggio piuttosto lento, ha molte librerie eccellenti come numpy, che permettono di elaborare dati numerici con la velocità di un linguaggio compilato (tra l'altro, numpy è ideologicamente vicino a Q).
In aggiunta, KX ha dedicato molta attenzione alla progettazione delle tabelle e all'ottimizzazione del loro utilizzo. In primo luogo, sono supportati vari tipi di indici, che possono essere applicati non solo alle colonne delle tabelle, ma anche a qualsiasi vettore: raggruppamento, ordinamento, attributo di unicità e raggruppamento speciale per le basi storiche. Gli indici vengono applicati in modo elementare e si correggono automaticamente quando vengono aggiunti elementi a una colonna/vettore. Gli indici possono essere applicati con successo alle colonne delle tabelle sia in memoria che su disco. Quando viene eseguita una query QSQL, gli indici vengono utilizzati automaticamente, se possibile. In secondo luogo, il lavoro con i dati storici viene gestito attraverso un meccanismo di mappatura dei file del sistema operativo (memory map). Tabelle di grandi dimensioni non vengono mai caricate in memoria; invece, le colonne necessarie vengono mappate direttamente in memoria e solo la parte che è realmente necessaria viene caricata (gli indici aiutano anche in questo caso). Per un programmatore non fa differenza se i dati sono in memoria o meno, il meccanismo di lavoro con mmap è completamente nascosto nel profondo di Q.
KDB+ è un database non relazionale, le tabelle possono contenere dati arbitrari, e l'ordine delle righe nella tabella non cambia con l'aggiunta di nuovi elementi, il che può e deve essere utilizzato nella scrittura delle query. Questa caratteristica è estremamente necessaria per lavorare con serie temporali (dati da borse, telemetria, log di eventi), poiché se i dati sono ordinati temporalmente, l'utente non deve applicare trucchi SQL per trovare nella tabella la prima o l'ultima riga per data o N righe, determinare quale riga segue la N-esima riga e così via. Anche i join delle tabelle sono notevolmente semplificati; ad esempio, trovare per 16000 transazioni VOD.L (Vodafone) l'ultima quotazione in una tabella di 500 milioni di elementi richiede circa un secondo su disco e una decina di millisecondi in memoria.
Un esempio di join temporale: la tabella quote viene mappata in memoria, quindi non è necessario specificare VOD.L nella clausola where; viene utilizzato implicitamente l'indice sulla colonna sym e il fatto che i dati siano ordinati temporalmente. Quasi tutti i join in Q sono funzioni normali, e non parte di un'espressione select:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Infine, va notato che gli ingegneri di KX, a partire da Arthur Whitney, sono veramente ossessionati dall'efficienza e si adoperano per massimizzare le funzionalità standard di Q e ottimizzare i modelli di utilizzo più comuni.
Risultato
KDB+ è popolare tra le aziende principalmente per la sua eccezionale versatilità: funge egregiamente sia da base in-memory che da archivio per terabyte di dati storici, nonché come piattaforma per l'analisi dei dati. Poiché l'elaborazione dei dati avviene direttamente nel database, si ottiene un'elevata velocità operativa e un risparmio di risorse. Un linguaggio di programmazione completo, integrato con le funzionalità del database, consente di realizzare su un'unica piattaforma l'intero stack dei processi necessari, dalla raccolta dei dati all'elaborazione delle richieste degli utenti.
Ulteriori informazioni
Svantaggi
Un significativо svantaggio di KDB+/Q è l'alta barriera d'ingresso. Il linguaggio ha una sintassi strana, alcune funzioni sono sovraccariche (value, ad esempio, ha circa 11 varianti d'uso). La cosa più importante è che richiede un approccio radicalmente diverso alla scrittura di programmi. In un linguaggio vettoriale, è necessario pensare costantemente in termini di trasformazioni degli array, implementare tutti i cicli attraverso varie funzioni map/reduce (chiamate avverbi in Q), e mai tentare di risparmiare sostituendo le operazioni vettoriali con quelle atomiche. Ad esempio, per trovare l'indice della N-esima occorrenza di un elemento in un array, si dovrebbe scrivere:
1. (where element=vector)[N]
anche se questo può sembrare estremamente inefficiente secondo gli standard di C/Java (= crea un vettore booleano, dove where restituisce gli indici degli elementi true in esso). Ma una tale scrittura rende più chiaro il significato dell'espressione e si utilizzano operazioni vettoriali rapide invece di quelle atomiche lente. La differenza concettuale tra linguaggio vettoriale e gli altri è comparabile alla differenza tra approcci imperativi e funzionali alla programmazione, e a questo bisogna essere pronti.
Alcuni utenti possono anche essere insoddisfatti di QSQL. Il fatto è che assomiglia solo a un vero SQL. In realtà, è solo un interprete di espressioni simili a SQL, che non supporta l'ottimizzazione delle query. L'utente deve scrivere da solo query ottimali, e per farlo deve usare Q, cosa a cui molti non sono pronti. D'altra parte, ovviamente, si può sempre scrivere personalmente una query ottimale, invece di fare affidamento su una black box-ottimizzatore.
Un altro aspetto positivo del libro su Q — Q For Mortals è disponibile gratuitamente su , dove si possono trovare anche molti altri materiali utili.
Un altro grande svantaggio è il costo della licenza. Si tratta di decine di migliaia di dollari all'anno per una CPU. Solo le grandi aziende possono permettersi tali spese. Ultimamente, KX ha reso la politica di licenza più flessibile e offre la possibilità di pagare solo per il tempo di utilizzo o di affittare KDB+ nei cloud di Google e Amazon. Inoltre, KX offre per il download (versione a 32 bit o 64 bit su richiesta).
Concorrenti
Esistono molte basi di dati specializzate, costruite su principi simili: colonne, in-memory e progettate per gestire enormi volumi di dati. Il problema è che queste sono precisamente basi di dati specializzate. Un esempio lampante è Clickhouse. Questa base di dati ha un principio di memorizzazione su disco e costruzione dell'indice molto simile a KDB+, eseguendo alcuni interrogazioni più rapidamente di KDB+, sebbene non in modo significativo. Tuttavia, come base di dati, Clickhouse è più specializzata di KDB+: analisi web vs serie temporali arbitrarie (questa differenza è molto importante: ad esempio, in Clickhouse non è possibile utilizzare l'ordinamento delle righe). Ma, soprattutto, Clickhouse non ha la versatilità di KDB+, un linguaggio che consente di elaborare dati direttamente nel database, senza doverli caricare preventivamente in un'applicazione separata, di costruire espressioni SQL arbitrarie, applicare funzioni arbitrarie nelle interrogazioni e creare processi non legati all'esecuzione di funzioni di un database storico. Pertanto, è difficile confrontare KDB+ con altre basi di dati: possono essere migliori in scenari d'uso specifici o semplicemente superiori se si parla di compiti di basi di dati classiche, ma non sono a conoscenza di un altro strumento altrettanto efficace e versatile per l'elaborazione di dati temporali.
Integrazione con Python
Per semplificare l'utilizzo di KDB+ per le persone non familiari con la tecnologia, KX ha creato librerie per un'integrazione stretta con Python all'interno di un unico processo. È possibile chiamare qualsiasi funzione Python da Q, e viceversa: chiamare qualsiasi funzione Q da Python (in particolare espressioni QSQL). Le librerie convertono, se necessario (per efficienza non sempre), i dati da un formato linguistico a un altro. Di conseguenza, Q e Python coesistono in una tale simbiosi che i confini tra di loro si sfumano. Così, il programmatore ha, da un lato, accesso completo a numerose utili librerie Python, e dall'altro, ha un database veloce integrato in Python per lavorare con grandi dati, cosa particolarmente utile per chi si occupa di apprendimento automatico o modellazione.
Lavorare con Q in Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Link
Sito web dell'azienda —
Sito per sviluppatori —
Libro Q For Mortals (in inglese) —
Articoli riguardanti l'applicazione di KDB+ / Q da parte dei dipendenti kx —
Fonte: habr.com
