

Nell'articolo precedente Abbiamo esaminato le basi teoriche dell'architettura reattiva. È giunto il momento di parlare dei flussi di dati, dei modi di implementazione dei sistemi reattivi Erlang/Elixir e dei modelli di scambio di messaggi in essi:
- Richiesta-risposta
- Risposta Richiesta-Chunked
- Risposta con Richiesta
- Pubblica-sottoscritta
- Pubblica-sottoscritta Inversa
- Distribuzione dei compiti
SOA, MSA e scambio di messaggi
SOA e MSA sono architetture di sistema che definiscono le regole per la costruzione dei sistemi, mentre il messaging fornisce i primitivi per la loro implementazione.
Non voglio promuovere un'architettura o l'altra per la costruzione dei sistemi. Sono a favore dell'adozione delle pratiche più efficienti e utili per il progetto e il business specifico. Qualunque paradigma scegliamo, è meglio creare i blocchi di sistema seguendo il modo Unix: componenti con una minima interconnessione, responsabili di entità separate. I metodi API eseguono azioni il più semplici possibile con le entità.
Il Messaging ‒ come suggerisce il nome ‒ è un broker di messaggi. Il suo obiettivo principale è ricevere e consegnare messaggi. Si occupa delle interfacce di invio delle informazioni, della formazione di canali logici di trasmissione delle informazioni all'interno del sistema, del routing e del bilanciamento, nonché della gestione dei guasti a livello di sistema.
Il messaging in fase di sviluppo non cerca di competere con rabbitmq o di sostituirlo. Le sue principali caratteristiche sono:
- Distributed.
I punti di scambio possono essere creati su tutti i nodi del cluster, il più vicino possibile al codice che li utilizza. - Semplicità.
Orientato alla minimizzazione del codice standard e alla facilità d'uso. - Migliore performance.
Non stiamo cercando di replicare la funzionalità di rabbitmq, ma isoliamo solo il livello architettonico e di trasporto, che integriamo nel OTP nel modo più semplice possibile, minimizzando i costi. - Flessibilità.
Ogni servizio può combinare molti modelli di scambio. - Resilienza, incorporata nel design.
- Scalabilità.
Il messaging cresce insieme all'applicazione. Con l'aumento del carico, è possibile spostare i punti di scambio su macchine separate.
Nota. Dal punto di vista dell'organizzazione del codice, per sistemi complessi su Erlang/Elixir, i meta-progetti sono molto adatti. Tutto il codice del progetto si trova in un unico repository ‒ un progetto ombrello. In questo modo, i microservizi sono massimamente isolati e svolgono operazioni semplici, responsabili di un'entità separata. Con questo approccio è facile mantenere l'API dell'intero sistema, apportare modifiche e scrivere test unitari e di integrazione in modo conveniente.
I componenti del sistema interagiscono direttamente o tramite un broker. Da un punto di vista del messaging, ogni servizio ha diverse fasi di vita:
- Inizializzazione del servizio.
In questa fase avviene la configurazione e l'avvio del processo di servizio eseguibile e delle dipendenze. - Creazione di un punto di scambio.
Il servizio può utilizzare un punto di scambio statico definito nella configurazione del nodo, oppure creare punti di scambio dinamicamente. - Registrazione del servizio.
Affinché il servizio possa gestire le richieste, deve essere registrato al punto di scambio. - Funzionamento normale.
Il servizio svolge lavoro utile. - Termine del lavoro.
Esistono 2 tipi di termine del lavoro: normale e anomalo. Nel primo caso, il servizio si disconnette dal punto di scambio e si ferma. In caso di anomalie, il messaging esegue uno dei percorsi di gestione degli errori.
Sembra piuttosto complesso, ma nel codice non è tutto così spaventoso. Esempi di codice con commenti saranno presentati nell'analisi dei template poco dopo.
Exchanges
Il punto di scambio è un processo di messaging che implementa la logica di interazione con i componenti nell'ambito del template di scambio di messaggi. In tutti gli esempi presenti di seguito, i componenti interagiscono tramite punti di scambio, la cui combinazione forma il messaging.
Schemi di scambio messaggi (MEPs)
Globalmente, gli schemi di scambio possono essere suddivisi in bidirezionali e unidirezionali. I primi implicano una risposta al messaggio ricevuto, i secondi no. Un esempio classico di schema bidirezionale nell'architettura client-server è il template Request-response. Esaminiamo il template e le sue modifiche.
Request–response o RPC
L'RPC viene utilizzato quando abbiamo bisogno di ricevere una risposta da un altro processo. Questo processo può essere avviato sullo stesso nodo o trovarsi su un altro continente. Di seguito è mostrato un schema di interazione tra il client e server attraverso il messaging.
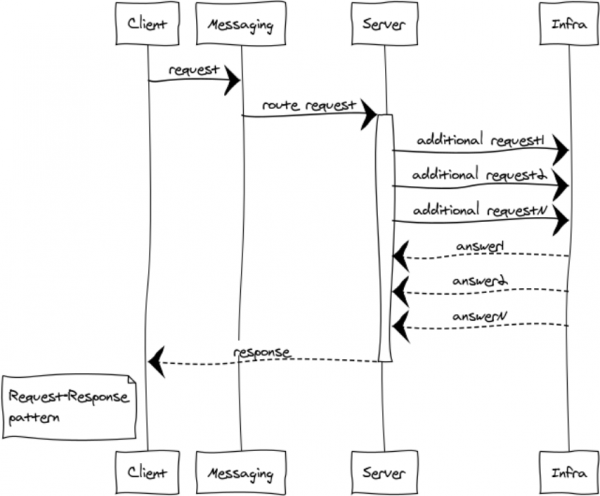
Poiché il messaging è completamente asincrono, per il client lo scambio si divide in 2 fasi:
Invio della richiesta
messaging:request(Exchange, ResponseMatchingTag, RequestDefinition, HandlerProcess).Scambio ‒ nome unico del punto di scambio
ResponseMatchingTag ‒ etichetta locale per l'elaborazione della risposta. Ad esempio, nel caso di invio di più richieste identiche, appartenenti a utenti diversi.
RequestDefinition ‒ corpo della richiesta
HandlerProcess ‒ PID del gestore. A questo processo arriverà la risposta dal server.Elaborazione della risposta
handle_info(#'$msg'{exchange = EXCHANGE, tag = ResponseMatchingTag,message = ResponsePayload}, State)ResponsePayload ‒ risposta del server.
Per il server, il processo consiste anche in 2 fasi:
- Inizializzazione del punto di scambio
- Elaborazione delle richieste in arrivo
Illustriamo questo modello con un codice. Supponiamo di dover implementare un semplice servizio che fornisce un unico metodo per l'orario esatto.
Codice del server
Portiamo la definizione dell'API del servizio in api.hrl:
%% =====================================================
%%  entità
%% =====================================================
-record(time, {
  unixtime :: non_neg_integer(),
  datetime :: binary()
}).

-record(time_error, {
  code :: non_neg_integer(),
  error :: term()
}).

%% =====================================================
%%  metodi
%% =====================================================
-record(time_req, {
  opts :: term()
}).
-record(time_resp, {
  result :: #time{} | #time_error{}
}).
Definiamo il controllore del servizio in time_controller.erl
%% L'esempio mostra solo il codice significativo. Inserendolo nel modello gen_server si può ottenere un servizio funzionante.

%% inizializzazione gen_server
init(Args) ->
  %% connessione al punto di scambio
  messaging:monitor_exchange(req_resp, ?EXCHANGE, default, self())
  {ok, #{}}.

%% elaborazione dell'evento di perdita di connessione con il punto di scambio. Questo stesso evento arriva se il punto di scambio non è ancora stato avviato.
handle_info(#exchange_die{exchange = ?EXCHANGE}, State) ->
  erlang:send(self(), monitor_exchange),
  {noreply, State};

%% elaborazione API
handle_info(#time_req{opts = _Opts}, State) ->
  messaging:response_once(Client, #time_resp{
result = #time{ unixtime = time_utils:unixtime(now()), datetime = time_utils:iso8601_fmt(now())}
  });
  {noreply, State};

%% conclusione del lavoro gen_server
terminate(_Reason, _State) ->
  messaging:demonitor_exchange(req_resp, ?EXCHANGE, default, self()),
  ok.
Codice del client
Per inviare una richiesta al servizio, in qualsiasi punto del client è possibile chiamare l'API di richiesta di messaging:
case messaging:request(?EXCHANGE, tag, #time_req{opts = #{}}, self()) of
    ok -> ok;
    _ -> %% logica di ripetizione o errore
end
In un sistema distribuito, la configurazione dei componenti può essere variabile e al momento della richiesta, messaging potrebbe non essere ancora avviato, oppure il controllore del servizio potrebbe non essere pronto a gestire la richiesta. Pertanto, è necessario controllare la risposta di messaging e gestire il caso di errore.
Dopo l'invio riuscito, al client arriverà una risposta o un errore dal servizio.
Gestiamo entrambi i casi in handle_info:
handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time{unixtime = Utime}}}, State) ->
  ?debugVal(Utime),
  {noreply, State};

handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time_error{code = ErrorCode}}}, State) ->
  ?debugVal({error, ErrorCode}),
  {noreply, State};
Risposta Richiesta-Chunked
È meglio evitare di inviare messaggi di grandi dimensioni. Questo influisce sulla reattività e sulla stabilità dell'intero sistema. Se la risposta a una richiesta occupa molta memoria, è obbligatorio suddividerla in parti.
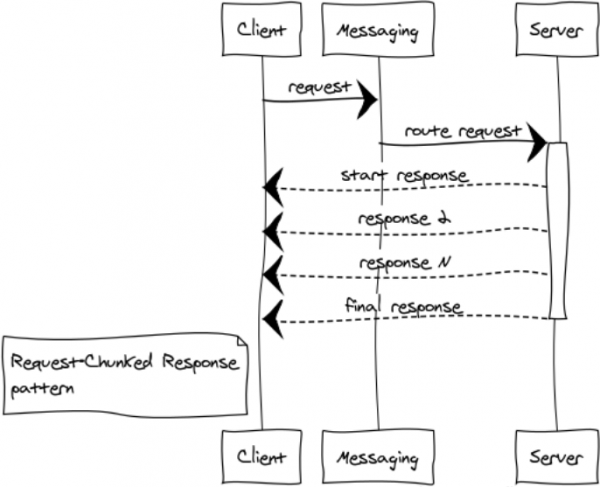
Ecco un paio di esempi di tali casi:
- I componenti scambiano dati binari, ad esempio file. Suddividere la risposta in piccole parti aiuta a lavorare in modo efficiente con file di qualsiasi dimensione senza incorrere in problemi di sovraccarico della memoria.
- Elencazioni. Ad esempio, dobbiamo selezionare tutte le righe da un enorme tavolo nel database e trasmetterle a un altro componente.
Chiamo queste risposte un treno. In ogni caso, 1024 messaggi da 1 MB sono migliori di un singolo messaggio di 1 GB.
In un cluster Erlang, otteniamo un ulteriore vantaggio: ridurre il carico sul punto di scambio e sulla rete, poiché le risposte vengono inviate immediatamente al destinatario, bypassando il punto di scambio.
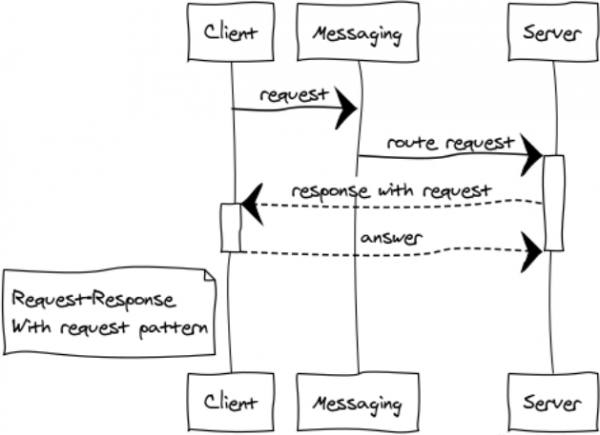
Risposta con Richiesta
Questa è una modifica abbastanza rara del pattern RPC per costruire sistemi di dialogo.
Pubblica-ritira (data distribution tree)
I sistemi eventi-oriented forniscono i dati ai consumatori man mano che diventano disponibili. In questo modo, questi sistemi sono più propensi a un modello push piuttosto che pull o poll. Questa caratteristica consente di non sprecare risorse richiedendo costantemente e aspettando i dati.
L'immagine mostra il processo di diffusione del messaggio ai consumatori che si sono iscritti a un determinato argomento.
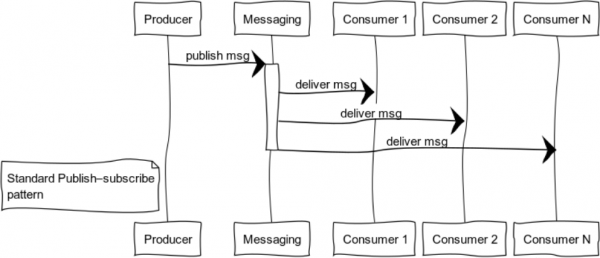
Esempi classici di utilizzo di questo modello includono la distribuzione di stati: del mondo di gioco nei videogiochi, dei dati di mercato nelle borse, delle informazioni utili nei data feed.
Consideriamo il codice dell'abbonato:
init(_Args) ->
  %% ci iscriviamo al punto di scambio, chiave = key
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {ok, #{}}.

handle_info(#exchange_die{exchange = ?SUBSCRIPTION}, State) ->
  %% se il punto di scambio non è disponibile, proviamo a riconnetterci
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {noreply, State};

%% trattiamo i messaggi in arrivo
handle_info(#'$msg'{exchange = ?SUBSCRIPTION, message = Msg}, State) ->
  ?debugVal(Msg),
  {noreply, State};

%% al fermo del consumatore - ci disconnettiamo dal punto di scambio
terminate(_Reason, _State) ->
  messaging:unsubscribe(?SUBSCRIPTION, key, tag, self()),
  ok.
La fonte può invocare la funzione di pubblicazione di un messaggio in qualsiasi punto conveniente:
messaging:publish_message(Exchange, Key, Message).Scambio ‒ nome del punto di scambio,
Key ‒ chiave di instradamento
Messaggio ‒ payload
Pubblica-sottoscritta Inversa
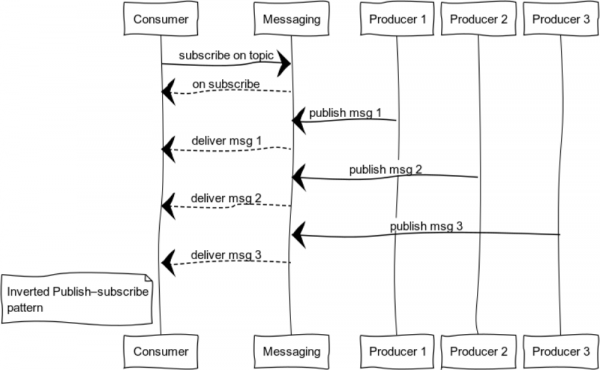
Attivando pub-sub, è possibile ottenere uno schema utile per il logging. L'insieme di fonti e consumatori può essere completamente diverso. Nella figura è presentato un caso con un solo consumatore e molte fonti.
Schema di distribuzione del carico
Quasi in ogni progetto si presentano attività di elaborazione posticipata, come la generazione di report, la consegna di notifiche, l'ottenimento di dati da sistemi esterni. La capacità del sistema che esegue queste attività è facilmente scalabile aggiungendo elaboratori. Tutto ciò che ci resta da fare è formare un cluster di elaboratori e distribuire uniformemente i compiti tra di essi.
Consideriamo le situazioni che si presentano con 3 elaboratori. Già nella fase di distribuzione dei compiti emerge la questione dell’equità nella distribuzione e del sovraccarico degli elaboratori. L'equità sarà garantita dalla distribuzione round-robin e per evitare situazioni di sovraccarico degli elaboratori, introdurremo un limite prefetch_limit. Nelle fasi transitorie prefetch_limit non permetterà a un elaboratore di ricevere tutti i compiti.
Messaging gestisce le code e la priorità di elaborazione. Gli elaboratori ricevono i compiti man mano che arrivano. L'esecuzione di un compito può concludersi con successo oppure con un fallimento:
messaging:ack(Tack)‒ viene chiamato in caso di elaborazione riuscita del messaggiomessaging:nack(Tack)‒ viene chiamato in tutte le situazioni anomale. Dopo il ritorno del compito, messaging lo passerà a un altro elaboratore.
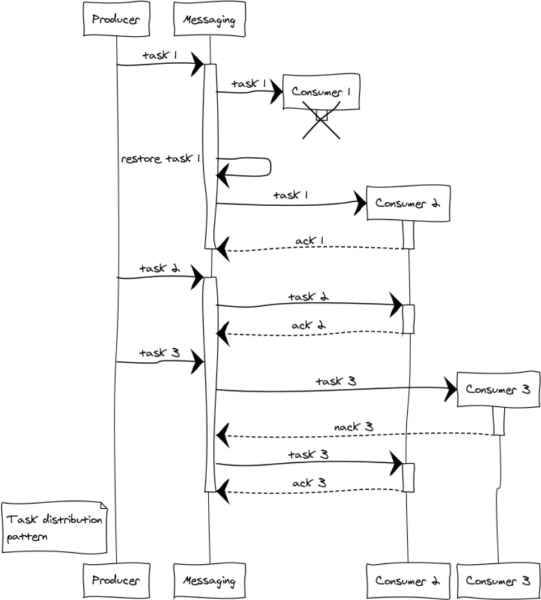
Supponiamo che, durante l'elaborazione di tre compiti, si verifichi un complesso fallimento: l'elaboratore 1, dopo aver ricevuto il compito, è andato in crash senza riuscire a comunicare nulla al punto di scambio. In questo caso, il punto di scambio, dopo il timeout di ack, passerà il compito a un altro elaboratore. L'elaboratore 3, per qualche motivo, ha rifiutato il compito e ha inviato nack, alla fine il compito è passato a un altro elaboratore che l'ha completato con successo.
Risultato preliminare
Abbiamo esaminato i principali elementi costitutivi dei sistemi distribuiti e abbiamo acquisito una comprensione di base della loro applicazione in Erlang/Elixir.
Combinando gli schemi di base, è possibile costruire paradigmi complessi per affrontare i compiti emergenti.
Nell'ultima parte del ciclo esamineremo questioni generali riguardanti l'organizzazione dei servizi, la routizzazione e il bilanciamento, e discuteremo anche l'aspetto pratico della scalabilità e della resilienza dei sistemi.
Fine della seconda parte.
Foto
Le illustrazioni sono state preparate con websequencediagrams.com
Fonte: habr.com
