

Introduzione
È giunto il momento di acquistare uno storage. Quale scegliere, chi ascoltare? Il fornitore A parla del fornitore B, e poi c'è l'integratore C, che racconta il contrario e consiglia il fornitore D. In una situazione del genere, anche un architetto esperto di sistemi di storage si sentirà confuso, specialmente con tutti i nuovi fornitori e le attuali mode come SDS e iperconvergenza.
Quindi, come districarsi in tutto questo senza sembrare degli scemi? Noi ( Anton Zhbankov e Evgeny Elizarov) cercheremo di spiegarlo in modo semplice.
Questo articolo è in gran parte un proseguimento, ed è infatti un'estensione di “” riguardo alla scelta dei sistemi di storage e alla panoramica delle tecnologie di storage. Daremo un breve sguardo alla teoria generale, ma raccomandiamo di consultare anche l'articolo indicato.
Perché
Spesso si osserva la situazione in cui una nuova persona entra in un forum o in una chat specializzata, come ad esempio Storage Discussions, e pone la domanda: “mi vengono proposti due modelli di storage - ABC SuperStorage S600 e XYZ HyperOcean 666v4, cosa mi consigliate?”.
E inizia il confronto su quali sono le caratteristiche terribili e incomprensibili che per una persona non preparata sono letteralmente un rompicapo.
Quindi, la domanda chiave e principale che bisogna porsi molto prima di confrontare le specifiche nelle offerte commerciali è: PERCHÉ? Perché ho bisogno di questo storage?
La risposta sarà inaspettata e molto nello stile di Tony Robbins — per archiviare i dati. Grazie, capitano! Eppure, a volte ci immergiamo così tanto nel confronto dei dettagli che dimentichiamo perché stiamo facendo tutto ciò.
Quindi, l'obiettivo di un sistema di storage è archiviare e fornire accesso a DATI con una determinata performance. Da questi dati inizieremo.
Dati
Tipo di dati
Quali dati prevediamo di archiviare? È una domanda molto importante, che può escludere molte soluzioni di storage dai considerazioni. Ad esempio, si prevede di memorizzare registrazioni video e foto. Si possono subito escludere i sistemi progettati per l'accesso casuale a blocchi piccoli, o i sistemi con funzioni proprietarie nella compressione / deduplicazione. Questi possono essere eccellenti sistemi, non vogliamo dire nulla di male. Ma in questo caso, i loro punti di forza diventano deboli (video e foto non si comprimono) o semplicemente aumentano significativamente il costo del sistema.
E viceversa, se l'uso previsto è un DBMS transazionale pesante, allora sistemi streaming eccellenti per multimedia, in grado di fornire gigabyte al secondo, saranno una cattiva scelta.
Volume dei dati
Quale quantità di dati prevediamo di archiviare? La quantità si trasforma sempre in qualità, non bisogna mai dimenticarlo, specialmente al giorno d'oggi, in un'epoca di crescita esponenziale del volume dei dati. I sistemi di classe petabyte non sono più una rarità, ma più grande è il volume in petabyte, più specifico diventa il sistema, meno funzionalità familiari dei sistemi a accesso casuale di piccolo e medio volume saranno disponibili. Banalmente perché anche solo le tabelle statistiche di accesso per blocchi superano il volume di memoria operativa disponibile nei controller. Per non parlare della compressione / tiering. Supponiamo di voler cambiare l'algoritmo di compressione in uno più potente e comprimere 20 petabyte di dati. Quanto tempo ci vorrà: sei mesi, un anno?
D'altra parte, perché complicarsi la vita se si devono archiviare e trattare 500 GB di dati? Solo 500. Gli SSD consumer (con basso DWPD) di questo volume costano poco. Perché costruire una fabbrica Fiber Channel e acquistare un sistema di storage esterno di alta classe al costo di un ponte di ferro?
Qual è la percentuale del volume totale di dati caldi? Quanto è irregolare il carico in base al volume dei dati? È proprio qui che la tecnologia di archiviazione multilivello o Flash Cache può essere molto utile, se la quantità di dati caldi è misera rispetto al totale. Al contrario, in caso di carico uniforme su tutto il volume, spesso presente nei sistemi in streaming (videosorveglianza, alcuni sistemi di analisi), tecnologie simili non porteranno a nulla e aumenteranno solo il costo / la complessità del sistema.
IS
Il retro dei dati è un sistema informativo che utilizza questi dati. L'IS ha un insieme di requisiti ereditati dai dati. Maggiori dettagli sull'IS si trovano in “Design del Data Center virtualizzato”.
Requisiti di tolleranza ai guasti / disponibilità
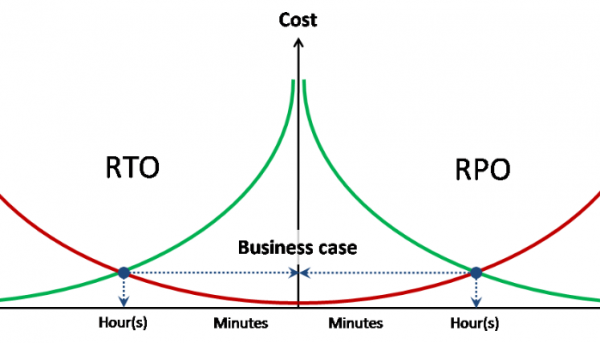
I requisiti di tolleranza ai guasti / disponibilità dei dati sono ereditati dall'IS che li utilizza e sono espressi in tre numeri — RPO, RTO, disponibilità.
Disponibilità — la quota per un intervallo di tempo specificato durante il quale i dati sono disponibili per l'uso. Di solito è espressa in numero di 9. Ad esempio, due nove in un anno significano che la disponibilità è pari al 99%, ovvero sono ammessi 95 ore di inattività in un anno. Tre nove — 9.5 ore all'anno.
RPO / RTO — sono indicatori non cumulativi, ma per ogni incidente (guasto), a differenza della disponibilità.
RPO — volume di dati persi durante un incidente (in ore). Ad esempio, se viene eseguito un backup una volta al giorno, allora RPO = 24 ore. Cioè, in caso di un guasto e completa perdita della SENSO, potrebbero andare persi dati per un volume fino a 24 ore (dal momento del backup). In base al RPO stabilito per l'IS, ad esempio, viene redatto un regolamento per il backup. Inoltre, in base al RPO, si può capire quanto sia necessaria la replica dati sincrona / asincrona.
RTO — tempo di recupero del servizio (accesso ai dati) dopo un guasto. In base al valore RTO stabilito, possiamo capire se è necessario un metrocluster, o se è sufficiente una replica unidirezionale. Se serve una SENSO di classe hi-end — anche.
Requisiti di prestazione
Nonostante sia una questione del tutto ovvia, è proprio con essa che sorgono la maggior parte delle difficoltà. A seconda che abbiate già un'infrastruttura o meno, verranno costruiti i percorsi per raccogliere le statistiche necessarie.
Hai già un SDC e stai cercando un suo sostituto o vuoi acquistarne un altro per espandere. Qui è tutto semplice. Comprendi quali servizi hai già e quali intendi implementare nel prossimo futuro. Basandoti sui servizi attuali, hai la possibilità di raccogliere statistiche sulle prestazioni. Devi stabilire il numero attuale di IOPS e i ritardi correnti: quali sono questi indicatori e sono sufficienti per le tue esigenze? Puoi farlo sia sul sistema di archiviazione dati stesso, sia dal lato degli host collegati ad esso.
Inoltre, è necessario monitorare non solo il carico attuale, ma per un certo periodo (meglio un mese). Osserva quali sono i picchi massimi durante il giorno, quale carico genera il backup, ecc. Se il tuo SDC o il software ad esso collegato non ti forniscono l'intero insieme di questi dati, puoi utilizzare il gratuito RRDtool, che è in grado di lavorare con la maggior parte dei SDC e degli switch più popolari e ti fornirà statistiche dettagliate sulle prestazioni. È anche utile monitorare il carico sugli host che lavorano con questo SDC, su macchine virtuali specifiche o su ciò che funziona specificamente su questo host.
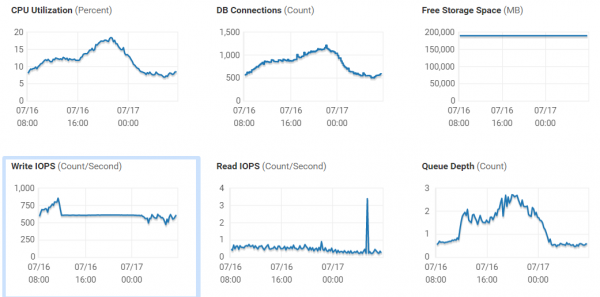
Vale la pena notare separatamente che se i ritardi sul volume e sul datastore, che si trova su questo volume, differiscono notevolmente, è opportuno prestare attenzione alla tua rete SAN; c'è una alta probabilità che ci siano problemi con essa e prima di acquistare un nuovo sistema è importante chiarire questa questione, poiché è molto probabile che si possa aumentare le prestazioni del sistema attuale.
Stai costruendo un'infrastruttura da zero, oppure stai acquistando un sistema per un nuovo servizio di cui non sei a conoscenza dei carichi. Ci sono diverse opzioni: parlare con colleghi su risorse specializzate per cercare di scoprire e prevedere il carico, contattare un integratore che ha esperienza nell'implementazione di servizi simili e che sarà in grado di calcolare il carico per te. E la terza opzione (di solito la più difficile, specialmente se riguarda applicazioni personalizzate o rare) è tentare di chiarire i requisiti di prestazione con gli sviluppatori del sistema.
E, attenzione, la soluzione più corretta dal punto di vista pratico è un pilota sull'attrezzatura attuale o su quella fornita per il test dal fornitore / integratore.
Requisiti speciali
I requisiti speciali sono tutto ciò che non rientra nei requisiti di prestazioni, affidabilità e funzionalità per l'elaborazione diretta e la fornitura dei dati.
Uno dei requisiti speciali più semplici per un sistema di archiviazione dei dati è quello dei 'supporti informatici trasferibili'. E diventa chiaro che questo sistema di archiviazione deve comprendere una libreria a nastro o semplicemente un'unità di nastro, su cui viene salvata una copia di backup. Dopodiché, una persona appositamente formata firma il nastro e lo porta orgogliosamente in una cassaforte speciale.
Un altro esempio di requisito speciale è l'esecuzione protetta e antimovimentale.
Dove
Il secondo elemento principale nella scelta di un SCD è l'informazione su DOVE verrà posizionato il SCD. A partire dalla geografia o dalle condizioni climatiche, fino al personale.
Committente
Per chi è previsto questo SCD? La domanda è supportata dai seguenti motivi:
Committente pubblico / commerciale.
Il committente commerciale non ha alcuna restrizione e non è nemmeno obbligato a indire gare, se non secondo i propri regolamenti interni.
Il committente pubblico è un'altra cosa. La legge 44 FZ e altre comodità riguardanti le gare e il capitolato, che possono essere contestati.
Committente sotto sanzioni
Qui la questione è molto semplice: la scelta è limitata solo alle offerte disponibili per questo committente.
Regolamenti interni / fornitori autorizzati per l'acquisto / modelli
Anche questa domanda è estremamente semplice, ma bisogna tenerne conto.
Dove fisicamente
In questa sezione esaminiamo tutte le questioni relative alla geografia, ai canali di comunicazione e al microclima nell'ambiente di collocamento.
Personale
Chi lavorerà con questo SCD? Questo è altrettanto importante quanto le capacità tecniche del SCD.
Per quanto possa essere promettente, stupefacente e fantastico un SCD del fornitore A, non ha molto senso installarlo se il personale sa lavorare solo con il fornitore B, e non sono previsti ulteriori acquisti o una collaborazione continua con A.
E naturalmente, il lato opposto della questione è quanto personale qualificato sia disponibile in questa posizione geografica, sia direttamente in azienda che potenzialmente sul mercato del lavoro. Per le regioni, può avere un significato notevole la scelta di un sistema di archiviazione dati con interfacce semplici o la possibilità di gestione centralizzata remota. Altrimenti, a un certo punto potrebbe diventare doloroso. Internet è pieno di storie di come un nuovo dipendente, un laureato di ieri, abbia configurato qualcosa che ha messo in ginocchio l'intera azienda.
Ambiente
Naturalmente, una domanda importante è in quale ambiente funzionerà questo sistema di archiviazione dati.
- Com'è l'alimentazione / il raffreddamento?
- Quale connessione
- Dove sarà installato
- Ecc.
Spesso queste domande sono considerate scontate e non vengono particolarmente esaminate, ma a volte sono proprio queste che possono ribaltare tutto.
Cosa
Fornitore
Ad oggi (metà 2019), il mercato russo dei sistemi di archiviazione dati può essere suddiviso in cinque categorie convenzionali:
- Prima divisione — aziende affermate con una vasta gamma prodotto che va dai più semplici scaffali a disco fino all'hi-end (HPE, DellEMC, Hitachi, NetApp, IBM / Lenovo)
- Seconda divisione — aziende con una gamma limitata, attori di nicchia, fornitori seri di SDS o neofiti emergenti (Fujitsu, Datacore, Infinidat, Huawei, Pure, ecc.)
- Terza divisione — soluzioni di nicchia nella fascia low end, SDS economico, assemblaggi fai-da-te su ceph e altri progetti open source (Infortrend, Starwind, ecc.)
- Segmento SOHO — piccoli e piccolissimi sistemi di archiviazione a livello domestico / piccolo ufficio (Synology, QNAP, ecc.)
- Sistemi di archiviazione dati a sostituzione delle importazioni — qui rientrano sia hardware della prima divisione con etichette rimaneggiate, sia rari rappresentanti della seconda (RAIDIX, diamo loro un anticipo per la seconda), ma in prevalenza è la terza divisione (Aerodisk, Baum, Depo, ecc.)
La suddivisione è piuttosto convenzionale e non significa affatto che il terzo segmento o il segmento SOHO siano scadenti e non utilizzabili. In progetti specifici con un insieme di dati e un profilo di carico chiaramente definiti, possono funzionare molto bene, superando di gran lunga la prima divisione in termini di rapporto qualità-prezzo. È importante prima stabilire i compiti, le prospettive di crescita, la funzionalità richiesta — e allora Synology vi servirà fedelmente, mentre i capelli diventeranno morbidi e setosi.
Uno dei fattori non trascurabili nella scelta di un fornitore è l'ambiente attuale. Quanti e quali sistemi di archiviazione dei dati (SCD) avete già, con quali SCD riescono a lavorare gli ingegneri. Avete bisogno di un altro fornitore, un altro punto di contatto, migrerete gradualmente tutto il carico dal fornitore A al fornitore B?
Non bisogna moltiplicare le entità oltre il necessario.
iSCSI / FC / File
Non esiste un'opinione unitaria tra gli ingegneri riguardo ai protocolli di accesso, e le dispute ricordano più delle discussioni teologiche che ingegneristiche. Tuttavia, in generale, si possono notare i seguenti punti:
FCoE è più morto che vivo.
FC vs iSCSI. Uno dei principali vantaggi del FC nel 2019 rispetto agli SCD IP, una rete dedicata per l'accesso ai dati, è ridimensionato da una rete IP dedicata. Non ci sono vantaggi globali per il FC rispetto alle reti IP e con IP è possibile costruire SCD di qualsiasi livello di carico, compresi i sistemi per carichi pesanti di DBMS per un grande banca. D'altra parte, la morte del FC viene pronosticata da diversi anni, ma qualcosa continua a ostacolarla. Ad esempio, oggi alcuni attori del mercato SCD stanno attivamente sviluppando lo standard NVMEoF. Se questo dividerà il destino del FCoE — solo il tempo lo dirà.
Accesso ai file non è nemmeno qualcosa di poco meritevole di attenzione. NFS / CIFS si dimostrano eccellenti in ambienti produttivi e, se progettati correttamente, non hanno più lamentele dei protocolli a blocchi.
Ibridi / All Flash Array
Gli SCD classici sono di 2 tipi:
- AFA (All Flash Array) — sistemi ottimizzati per l'uso di SSD.
- Ibridi — che consentono di utilizzare sia HDD che SSD o una loro combinazione.
La principale differenza tra di loro è l'efficienza della tecnologia di archiviazione supportata e il massimo livello di prestazioni (elevati valori di IOPS e basse latenze). Entrambi i sistemi (nella maggior parte dei loro modelli, escludendo il segmento low-end) possono funzionare sia come dispositivi a blocchi che come dispositivi di archiviazione a file. La funzionalità supportata dipende dal livello del sistema, e nei modelli inferiori è spesso ridotta al minimo. Questo è importante da considerare quando si esaminano le caratteristiche di un modello specifico, piuttosto che le capacità dell'intera gamma in generale. Inoltre, naturalmente, il livello del sistema influenzerà anche le sue specifiche tecniche, come il processore, la memoria, la cache, il numero e i tipi di porte, ecc. Dal punto di vista della gestione, le AFA si differenziano dai sistemi ibridi (a disco) solo nella realizzazione dei meccanismi di interazione con i dispositivi di archiviazione SSD, e anche se si utilizza un SSD in un sistema ibrido, non significa affatto che si possa ottenere un livello di prestazioni paragonabile a quello di un sistema AFA. Inoltre, nella maggior parte dei casi, i meccanismi inline per l'archiviazione efficiente nei sistemi ibridi sono disattivati, e la loro attivazione comporta una perdita di prestazioni.
Sistemi di archiviazione specializzati
Oltre ai sistemi di archiviazione generali, orientati principalmente all'elaborazione operativa dei dati, esistono sistemi di archiviazione specializzati con principi chiave che si differenziano radicalmente da quelli abituali (bassa latenza, elevati IOPS):
Media.
Questi sistemi sono progettati per l'archiviazione e l'elaborazione di file multimediali, che si distinguono per le loro grandi dimensioni. Pertanto, la latenza diventa praticamente irrilevante, mentre la capacità di inviare e ricevere dati a larghezza di banda ampia in molti flussi paralleli diventa fondamentale.
Sistemi di archiviazione deduplicanti per backup.
Poiché i backup si differenziano raramente tra loro in condizioni normali (un backup medio differisce da quello di ieri dell'1-2%), questa classe di sistemi comprime in modo estremamente efficace i dati memorizzati su una quantità relativamente ridotta di supporti fisici. Ad esempio, in alcuni casi, i coefficienti di compressione dei dati possono raggiungere 200 a 1.
Sistemi di archiviazione a oggetti.
In questi SCSI non ci sono volumi convenzionali con accesso a blocchi e file share, ma somigliano più a un enorme database. L'accesso a un oggetto memorizzato in un sistema simile avviene tramite un identificatore univoco o tramite metadati (ad esempio, tutti gli oggetti in formato JPEG, con data di creazione tra XX-XX-XXXX e YY-YY-YYYY).
Sistemi di conformità.
Non si trovano così spesso in Russia al giorno d'oggi, ma vale la pena menzionarli. Lo scopo di tali SCSI è garantire la conservazione dei dati per conformarsi alle politiche di sicurezza o ai requisiti dei regolatori. In alcuni sistemi (ad esempio EMC Centera) è stata implementata una funzione di divieto di cancellazione dei dati: una volta girata la chiave e il sistema è passato a questa modalità, né l'amministratore né qualcun altro possono fisicamente eliminare i dati già registrati.
Tecnologie proprietarie
Flash cache
Flash Cache è un termine generico per tutte le tecnologie proprietarie che utilizzano la memoria flash come cache di secondo livello. Quando si utilizza la flash cache, gli SCSI sono generalmente progettati per soddisfare un carico stabilito proveniente da dischi magnetici, mentre il picco è gestito dalla cache.
In questo caso è necessario comprendere il profilo del carico e il grado di localizzazione delle richieste ai blocchi dei volumi di storage. La flash cache è una tecnologia per carichi con alta localizzazione delle richieste, e praticamente non è applicabile a volumi uniformemente caricati (come ad esempio nei sistemi di analisi).
Sul mercato sono disponibili due implementazioni di flash cache:
- Read Only. In questo caso vengono memorizzati nella cache solo i dati in lettura, mentre la scrittura avviene direttamente sui dischi. Alcuni produttori, come ad esempio NetApp, ritengono che la scrittura sui loro SCSI avvenga già in modo ottimale e che la cache non possa migliorare la situazione.
- Read/Write. Viene memorizzata nella cache non solo la lettura, ma anche la scrittura, permettendo di bufferizzare il flusso e ridurre l'impatto del RAID Penalty, aumentando così le prestazioni complessive per gli SCSI con un meccanismo di scrittura non così ottimale.
Tiering
Lo storage multi-livello (tiering) è una tecnologia che combina in un unico pool disco livelli con prestazioni diverse, come ad esempio SSD e HDD. In caso di una marcata non uniformità nelle richieste ai blocchi di dati, il sistema sarà in grado di bilanciare automaticamente i blocchi di dati, spostando quelli sovraccarichi su un livello ad alte prestazioni e quelli freddi, viceversa, su un livello più lento.
I sistemi ibridi di classe bassa e media utilizzano lo storage multilivello con spostamento dei dati tra i livelli secondo un programma. In questo caso, la dimensione del blocco di storage multilivello dei migliori modelli è di 256 MB. Queste caratteristiche non permettono di considerare la tecnologia di storage multilivello come una tecnologia per migliorare le prestazioni, come erroneamente ritengono molti. Lo storage multilivello nei sistemi di classe bassa e media è una tecnologia di ottimizzazione dei costi di storage per sistemi con un carico di lavoro marcato e irregolare.
Snapshot
Per quanto possiamo parlare dell'affidabilità dei sistemi di archiviazione, esistono numerose opportunità di perdere dati che non dipendono da problemi hardware. Questi possono includere virus, hacker o qualsiasi altra cancellazione/corruzione accidentale di dati. Per questo motivo, il backup dei dati produttivi è una parte essenziale del lavoro di un ingegnere.
Uno snapshot è un'istantanea di un volume in un momento specifico. Nel funzionamento della maggior parte dei sistemi, come la virtualizzazione, i database, ecc., è necessario catturare tale istantanea da cui copieremo i dati per il backup, mentre i nostri sistemi informatici possono continuare a lavorare con quel volume. Ma è importante ricordare che non tutti gli snapshot sono ugualmente utili. Diversi fornitori hanno approcci diversi alla creazione di snapshot, legati alla loro architettura.
CoW (Copy-On-Write). Durante il tentativo di scrivere un blocco di dati, il contenuto originale viene copiato in un'area speciale, dopodiché la scrittura avviene normalmente. Ciò evita danneggiamenti ai dati all'interno dello snapshot. Naturalmente, tutte queste manipolazioni "parassitarie" dei dati comportano un carico aggiuntivo sui sistemi di archiviazione e per questo motivo i fornitori con tale implementazione sconsigliano di utilizzare più di una decina di snapshot, e di non usarli affatto sui volumi ad alta carico.
RoW (Redirect-on-Write). In questo caso, il volume originale viene naturalmente congelato, e durante il tentativo di scrivere un blocco di dati, il sistema di archiviazione scrive i dati in un'area speciale nello spazio libero, modificando la posizione di quel blocco nella tabella dei metadati. Questo permette di ridurre il numero di operazioni di riscrittura, il che in ultima analisi riduce il calo delle prestazioni e rimuove vincoli sugli snapshot e sul loro numero.
Gli snapshot sono anche di due tipi in relazione alle applicazioni:
Consistente per l'applicazione. Nel momento della creazione dello snapshot, il sistema di archiviazione interroga l'agente nel sistema operativo del consumatore, che forzatamente svuota le cache dei dischi dalla memoria al disco e costringe anche l'applicazione a farlo. In questo caso, quando si recupera dallo snapshot, i dati saranno consistenti.
Consistente durante il crash. In questo caso, nulla di simile accade e lo snapshot viene creato così com'è. In caso di recupero da un tale snapshot, la situazione è identica a quella in cui l'alimentazione si spegne improvvisamente e potrebbe esserci una certa perdita di dati rimasti nelle cache e che non sono mai arrivati al disco. Questi snapshot sono più facili da implementare e non causano cadute delle prestazioni nelle applicazioni, ma sono meno affidabili.
A cosa servono gli snapshot nei sistemi di archiviazione dei dati?
- Backup senza agente direttamente dal sistema di archiviazione
- Creazione di ambienti di test basati su dati reali
- Nel caso di sistemi di archiviazione file, possono essere utilizzati per creare ambienti VDI utilizzando gli snapshot del sistema di archiviazione anziché un hypervisor
- Garanzia di RPO bassi creando snapshot programmati con una frequenza significativamente superiore a quella di backup
Clonazione
La clonazione di un volume funziona secondo un principio simile a quello degli snapshot, ma serve non solo per leggere i dati, ma per lavorare pienamente con essi. Abbiamo la possibilità di ottenere una copia esatta del nostro volume, con tutti i dati in esso, senza creare una copia fisica, il che consente di risparmiare spazio. Di solito, la clonazione dei volumi è utilizzata o in Test&Dev o se si desidera testare la funzionalità di alcuni aggiornamenti nel proprio sistema informatico. La clonazione consentirà di farlo nel modo più rapido ed economico in termini di risorse disco, poiché verranno scritti solo i blocchi di dati modificati.
Replica / journaling
La replica è un meccanismo per creare una copia dei dati su un altro sistema di archiviazione fisico. Di solito esiste una tecnologia proprietaria di ciascun fornitore, che funziona solo all'interno della propria linea. Ma ci sono anche soluzioni di terze parti, incluse quelle che operano a livello di hypervisor, come ad esempio VMware vSphere Replication.
Le funzionalità delle tecnologie proprietarie e la facilità d'uso superano di gran lunga quelle universali, ma risultano inapplicabili quando, ad esempio, è necessario effettuare una replica da NetApp a HP MSA.
La replica si divide in due sotto-categorie:
Sincrona. Nel caso della replica sincrona, l'operazione di scrittura viene inviata immediatamente al secondo sistema di archiviazione e non viene confermata finché il sistema remoto non conferma. Ciò aumenta il ritardo di accesso, ma consente di avere una copia speculare esatta dei dati. Cioè, RPO = 0 in caso di perdita del sistema di archiviazione principale.
Asincrona. Le operazioni di scrittura vengono eseguite solo sul sistema di archiviazione principale e vengono confermate immediatamente, accumulandosi parallelamente in un buffer per una trasmissione in blocco al sistema di archiviazione remoto. Questo tipo di replica è rilevante per dati meno preziosi, oppure per canali a bassa larghezza di banda o caratterizzati da alta latenza (tipica per distanze superiori ai 100 km). Di conseguenza, RPO = alla frequenza di invio dei pacchetti.
Spesso, insieme alla replica esiste un meccanismo di journaling delle operazioni su disco. In questo caso viene dedicata un'area speciale per il journaling e vengono memorizzate le operazioni di scrittura a una certa profondità temporale, oppure limitate dal volume del journal. Per alcune tecnologie proprietarie, come ad esempio EMC RecoverPoint, esiste un'integrazione con il software di sistema che consente di associare determinati segnalibri a una specifica voce nel journal. Questo rende possibile ripristinare lo stato di un volume (o creare un clone) non semplicemente al 23 aprile alle 11:59:13.013, ma a un momento precedente al “DROP ALL TABLES; COMMIT”.
Metro cluster
Il metro cluster è una tecnologia che consente di creare una replica sincrona bidirezionale tra due sistemi di archiviazione in modo tale che questa coppia appaia come un unico sistema di archiviazione. Viene utilizzata per creare cluster con bracci geograficamente separati su distanze metropolitane (meno di 100 km).
Nel caso di utilizzo in un ambiente di virtualizzazione, il metro cluster consente di creare uno datastore con macchine virtuali, accessibile in scrittura immediatamente da due datacenter. In tal caso, viene creato un cluster a livello di hypervisor, composto da host in diversi datacenter fisici, collegati a questo datastore. Questo consente di fare quanto segue:
- Automazione completa del processo di ripristino dopo la morte di uno dei data center. Senza alcun mezzo aggiuntivo, tutte le VM che operavano nel data center estinto verranno automaticamente riavviate in quello rimanente. RTO = timeout del cluster ad alta disponibilità (15 secondi per VMware) + tempo di avvio del sistema operativo e avvio dei servizi.
- Disaster avoidance o, in russo, evitamento delle catastrofi. Se sono programmati lavori sull'alimentazione nel data center 1, abbiamo la possibilità di migrare in anticipo tutto il carico importante nel data center 2 senza interruzioni.
Virtualizzazione
La virtualizzazione dello storage è tecnicamente l'uso di volumi da un altro storage come dischi. Il virtualizzatore dello storage può semplicemente inoltrare un volume esterno al consumatore come se fosse proprio, mentre lo specchia su un altro storage, o persino creare un RAID da volumi esterni.
I rappresentanti classici nel campo della virtualizzazione dello storage sono EMC VPLEX e IBM SVC. E naturalmente gli storage con funzionalità di virtualizzazione come NetApp, Hitachi, IBM / Lenovo Storwize.
A cosa può servire?
- Ridondanza a livello di storage. Viene creato uno specchio tra i volumi, dove una parte può trovarsi su HP 3Par e l'altra su NetApp. E il virtualizzatore di EMC.
- Spostamento di dati con un minimo di inattività tra storage di diversi produttori. Supponiamo che i dati debbano essere migrati da un vecchio 3Par, che verrà dismesso, a un nuovo Dell. In questo caso, i consumatori vengono scollegati da 3Par, i volumi vengono inoltrati tramite VPLEX e ripresentati ai consumatori. Poiché non è cambiato alcun bit sul volume, il lavoro continua. In background viene avviato il processo di mirroring del volume sul nuovo Dell e, al termine, lo specchio viene rotto e 3Par viene disconnesso.
- Organizzazione di metrocluster.
Compressione / deduplicazione
La compressione e la deduplicazione sono tecnologie che ti permettono di risparmiare spazio su disco nel tuo storage. È opportuno menzionare subito che non tutti i dati possono essere compressi e/o deduplicati in linea di principio; alcuni tipi di dati si comprimono e si deduplicano meglio, mentre altri - al contrario.
La compressione e la deduplicazione si dividono in 2 tipi:
Inline La compressione e la deduplicazione dei blocchi di dati avviene prima della scrittura di questi dati su disco. In questo modo, il sistema calcola solo l'hash del blocco e lo confronta con la tabella di quelli già esistenti. Innanzitutto, questo viene eseguito più rapidamente rispetto alla semplice scrittura su disco, inoltre non sprechiamo spazio su disco non necessario.
Post quando queste operazioni vengono effettuate su dati già registrati, che si trovano sui dischi. Di conseguenza, i dati vengono prima scritti su disco, e solo dopo si calcola l'hash e si procede con l'eliminazione dei blocchi superflui e il rilascio delle risorse di archiviazione.
Vale la pena dire che la maggior parte dei fornitori utilizza entrambe le modalità, il che consente di ottimizzare questi processi e quindi aumentare la loro efficienza. La maggior parte dei fornitori di storage ha a disposizione strumenti che consentono di analizzare i vostri set di dati. Questi strumenti operano secondo la stessa logica implementata negli storage, quindi il livello di efficienza stimato sarà coincidente. Inoltre, non bisognerebbe dimenticare che molti fornitori hanno programmi di garanzia di efficienza, che promettono un livello di almeno quello dichiarato per un certo (o per tutti) tipi di dati. E non bisogna trascurare questo programma, poiché progettando un sistema in base alle proprie esigenze, tenendo conto del coefficiente di efficienza del sistema specifico, si possono risparmiare spazio. Si deve anche tenere presente che questi programmi sono progettati per i sistemi AFA, ma grazie all'acquisto di una quantità inferiore di SSD rispetto agli HDD nei sistemi tradizionali, ciò permetterà di abbattere i costi, e se non si raggiungerà il costo del sistema di archiviazione, ci si avvicinerà notevolmente.
Modello
E qui arriviamo alla domanda correttamente formulata.
“Mi vengono offerti due modelli di storage — ABC SuperStorage S600 e XYZ HyperOcean 666v4, cosa mi consigliate?”
Diventa “Mi vengono offerti due modelli di storage — ABC SuperStorage S600 e XYZ HyperOcean 666v4, cosa mi consigliate?
Il carico previsto è costituito da macchine virtuali miste VMware sui contorni produttivo / test / sviluppo. Test = produttivo. 150 TB per ciascuno con prestazioni di picco di 80.000 IOPS con blocchi da 8kb, 50% di accesso casuale 80/20 lettura-scrittura. 300 TB per lo sviluppo, 50.000 IOPS sono sufficienti, 80 casuale, 80 scrittura.
Il produttivo sarà presumibilmente in un metrocluster RPO = 15 minuti RTO = 1 ora, lo sviluppo in replica asincrona RPO = 3 ore, il test in un solo sito.
Ci saranno 50 TB di DB, sarebbe utile per loro il logging.
Abbiamo server Dell ovunque, il sistema di storage Hitachi è vecchio e stenta a stare al passo, prevediamo un aumento del 50% del carico in termini di volume e prestazioni.
Come si suol dire, in una domanda ben formulata c'è l'80% della risposta.
Informazioni aggiuntive
A cosa vale la pena prestare ulteriore attenzione secondo gli autori
Libri
- Oliter e Oliter "Reti Computer". Il libro aiuterà a sistematizzare e forse a comprendere meglio come funziona l'ambiente di trasmissione dati per sistemi di storage IP/Ethernet.
- "EMC Information Storage and Management". Un ottimo libro sulle basi dei sistemi di storage, perché, come e per cosa.
Forum e chat
Raccomandazioni generali
Prezzi
Ora, per quanto riguarda i prezzi — in generale, i prezzi per i sistemi di storage, se ci sono, di solito sono il List price, dal quale ogni cliente riceve uno sconto individuale. L'importo dello sconto è composto da molti parametri, rendendo impossibile prevedere quale sarà il prezzo finale per la tua azienda senza richiesta al distributore. Tuttavia, recentemente, i modelli low-end sono iniziati a comparire in normali negozi di informatica, come ad esempio o . Qui puoi acquistare immediatamente il sistema che ti interessa a un prezzo fisso, come qualsiasi componente per computer.
È importante sottolineare che un confronto diretto per TB/$ non è corretto. Se ci si avvicina da questo punto di vista, la soluzione più economica sarà un semplice JBOD + server, il che non offre la flessibilità né l'affidabilità che garantisce un sistema di storage completo a due controller. Questo non significa affatto che il JBOD sia una pessima scelta; è fondamentale capire chiaramente come e per quali scopi utilizzerai questa soluzione. Spesso si sente dire che nel JBOD non ci sia nulla da rompere, poiché c'è solo un backplane. Tuttavia, anche i backplane possono guastarsi. Qualsiasi cosa si rompe prima o poi.
Totale
Bisogna confrontare i sistemi non solo in base al prezzo, o solo in base alle prestazioni, ma in base a un insieme di tutte le caratteristiche.
Acquista HDD solo se sei sicuro di averne bisogno. Per carichi leggeri e tipi di dati non comprimibili, in caso contrario, dovresti considerare i programmi di garanzia di efficienza dello storage su SSD, attualmente offerti dalla maggior parte dei fornitori (e funzionano veramente, anche in Russia), ma tutto dipende dalle applicazioni e dai dati che verranno posizionati su questo sistema di archiviazione.
Non inseguire il prezzo basso. Spesso si nascondono molti problemi sgradevoli, uno dei quali Evgenij Elizàrov ha descritto nei suoi articoli su . E, in fin dei conti, questo risparmio potrebbe ritorcersi contro di te. Non dimenticare — "chi risparmia paga due volte".
Fonte: habr.com
