

D'estate tradizionalmente diminuisce sia l'attività degli acquirenti che l'intensità dei cambiamenti infrastrutturali dei progetti web, ci dice Capitan Evidente. Semplicemente perché anche gli informatici, a volte, vanno in vacanza. E anche i CTO. Più difficile per chi resta al lavoro, ma ora non è di questo che vogliamo parlare: forse è proprio per questo che l'estate è il periodo migliore per riflettere con calma sul sistema di riservazione esistente e pianificare il suo miglioramento. E in questo ti sarà utile l'esperienza di Egor Andreev di , di cui ha parlato alla conferenza .
Nella costruzione di aree di riserva, ci sono diverse trappole in cui è facile cadere. E cadere in esse è assolutamente da evitare. E ciò che ci rovina in tutto questo, così come in molte altre cose, è il perfezionismo e... la pigrizia. Cerchiamo di fare tutto, tutto, tutto in modo perfetto, ma non dobbiamo farlo in modo perfetto! Dobbiamo solo fare determinate cose, ma farle nel modo giusto, portarle a termine, affinché funzionino correttamente.
Il failover non è una cosa divertente o un gadget 'giusto per avere'; è qualcosa che deve fare esattamente una cosa: ridurre il tempo di inattività, affinché il servizio, l'azienda, perda meno soldi. E in tutti i metodi di riservazione, propongo di pensare nel seguente contesto: dove ci sono i soldi?
La prima trappola: quando costruiamo grandi sistemi affidabili e ci occupiamo di riservazione, riduciamo il numero di guasti. Questo è un terribile malinteso. Quando ci occupiamo di riservazione, il numero di guasti, molto probabilmente, aumenta. E se facciamo tutto correttamente, complessivamente ridurremo il tempo di inattività. Ci saranno più guasti, ma si verificheranno con minori conseguenze. Infatti, cos'è la riservazione? — è un complicamento del sistema. Qualsiasi complicazione è negativa: abbiamo più viti, più ingranaggi, insomma, più elementi — e, di conseguenza, maggior rischio di rottura. E si romperanno davvero. E si romperanno più frequentemente. Un semplice esempio: supponiamo di avere un certo sito web, con PHP, MySQL. E deve essere urgentemente riservato.
Dunque (c) Prendiamo un secondo ambiente, costruiamo un sistema identico... La complessità raddoppia: abbiamo due entità. E in più sovrapporremo una logica specifica per il trasferimento dei dati da un ambiente all'altro, ossia la replica dei dati, la copia della statica e così via. Ecco, la logica di replica è solitamente molto complessa, e quindi la complessità complessiva del sistema può essere non 2, ma 3, 5, 10 volte maggiore.
Il secondo tranello: quando costruiamo sistemi veramente grandi e complessi, fantastichiamo su cosa vogliamo ottenere alla fine. Voilà: vogliamo un sistema super affidabile, che funzioni senza alcun tempo di inattività, che faccia il switch in mezzo secondo (meglio ancora, immediatamente), e iniziamo a trasformare i sogni in realtà. Ma c'è anche un aspetto da considerare: minore è il tempo di switch desiderato, più complessa diventa la logica del sistema. Più sarà complessa questa logica, più frequentemente il sistema avrà problemi. E si può cadere in una situazione molto spiacevole: ci sforziamo di ridurre il tempo di inattività, ma in realtà stiamo complicando tutto, così quando qualcosa va storto, il tempo di inattività alla fine sarà maggiore. Qui ti sorprendi a pensare: beh... sarebbe stato meglio non avere riserve. Sarebbe stato meglio che funzionasse uno solo con un tempo di inattività chiaro.
Come possiamo combattere tutto questo? Dobbiamo smettere di mentire a noi stessi, smettere di compiacere noi stessi dicendo che stiamo costruendo un razzo spaziale, ma comprendere realisticamente quanto tempo il progetto può rimanere inattivo. E in base a questo tempo massimo sceglieremo quali metodi utilizzare per aumentare l'affidabilità del nostro sistema.
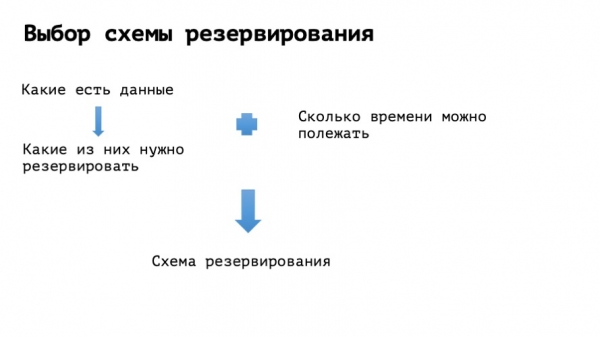
È il momento per "storie dalla vita"... dalla vita reale, naturalmente.
Esempio numero uno
Immaginate un sito di presentazione della fabbrica di tubi n. 1 della città di N. Su di esso è scritto a caratteri giganti: FABBRICA DI TUBI N. 1. Poco più in basso, lo slogan: «I nostri tubi sono i tubi più rotondi di N». E in fondo, il numero di telefono del direttore generale e il suo nome. Comprendiamo che è necessario prenotare—è una questione molto importante! Iniziamo a capire di cosa si tratta. Statico HTML—cioè una coppia di immagini, dove il direttore, in realtà, è seduto al tavolo in sauna con il suo partner a discutere qualche affare imminente. Iniziamo a pensare al tempo di inattività. Viene in mente: è necessario restare lì per cinque minuti, non di più. E qui la domanda: quante vendite sono state fatte tramite questo nostro sito? Quante? Cosa significa «zero»? Questo significa: perché tutte e quattro le transazioni dello scorso anno il direttore le ha fatte allo stesso tavolo, con le stesse persone, con cui vanno in sauna a sedere al tavolo. E comprendiamo che anche se il sito rimane inattivo per un giorno, non succederà niente di grave.
In base alle informazioni fornite, abbiamo un giorno per alzare questa situazione. Iniziamo a pensare a uno schema di prenotazione. E scegliamo lo schema di prenotazione più ideale per questo esempio: non utilizziamo la prenotazione. Tutta questa cosa può essere attivata da qualsiasi amministratore in mezz'ora con una pausa caffè. Installare un server web, caricare i file—è tutto. Funzionerà. Non è necessario monitorare nulla, non c'è nulla a cui prestare particolare attenzione. Quindi, la conclusione dall'esempio numero uno è piuttosto ovvia: i servizi che non necessitano di prenotazione—non necessitano di prenotazione.
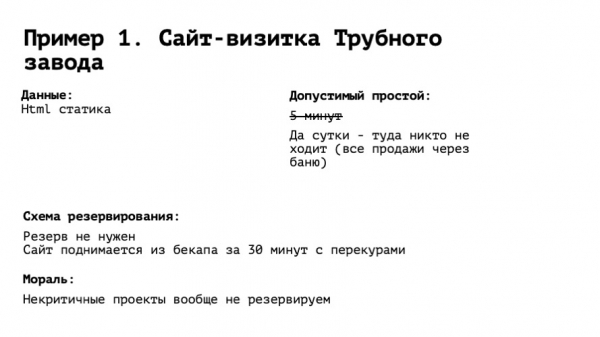
Esempio numero due
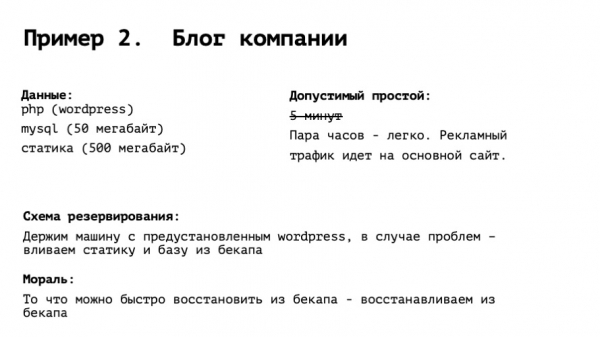
Blog dell'azienda: scrupolosamente addestrati scrivono notizie lì, come noi abbiamo partecipato a una certa fiera, ecco che abbiamo lanciato un altro nuovo prodotto e così via. Diciamo che si tratta di un PHP standard con WordPress, un piccolo database e un po' di statico. Naturalmente, torna in mente che non possiamo semplicemente stare fermi — «non più di cinque minuti!», e così via. Ma pensiamo oltre. Cosa fa questo blog? Riceve visitatori da Yandex, da Google per alcune ricerche, organicamente. Ottimo. E le vendite sono in qualche modo collegate? Epifania: non tanto. Il traffico pubblicitario va sul sito principale, che è su un'altra macchina. Cominciamo a pensare a un piano di riserva per il blog. Idealmente, dovrebbe essere attivato in poche ore, e sarebbe bene prepararsi per questo. Sarebbe ragionevole prendere un'altra macchina in un altro data center, installare l'ambiente, cioè web server, PHP, WordPress, MySQL, e lasciarlo inattivo. Nel momento in cui ci rende conto che è tutto rotto, dobbiamo fare due cose: ripristinare un dump MySQL da 50 megabyte, ci metterà un minuto, e ripristinare un certo numero di immagini dal backup. Anche questo non è molto. In questo modo, in mezz'ora tutta questa cosa si riattiva. Niente replicazione, o per favore non parlare di failover automatico. Conclusione: ciò che possiamo ripristinare rapidamente dal backup non necessita di essere riservato.
Esempio numero tre, un po' più complesso
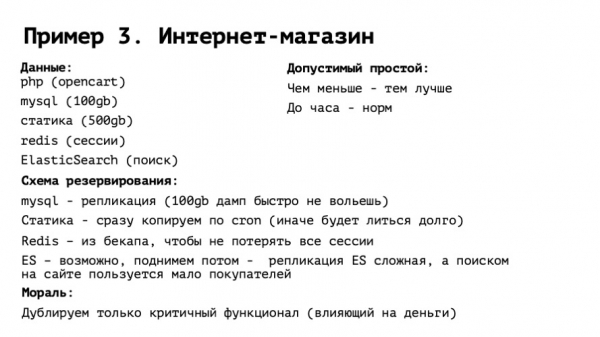
Negozio online. PhP con open heart leggermente modificato, MySQL con un database solido. Abbastanza statico (dopotutto, nei negozi online ci sono belle immagini HD e tutto il resto), Redis per le sessioni e Elasticsearch per la ricerca. Cominciamo a pensare al tempo di inattività. E qui, naturalmente, è chiaro che un giorno senza problemi il negozio online non può rimanere inattivo. Infatti, più a lungo rimane inattivo, più soldi perdiamo. È tempo di accelerare. E di quanto? Credo che se rimaniamo inattivi per un'ora, nessuno impazzirà. Sì, perderemo qualcosa, ma inizieremo a sforzarci — peggiorerà solo. Determiniamo il piano di inattività accettabile in un'ora.
Come si può prenotare tutto questo? L'auto è necessaria in ogni caso: un'ora di tempo è piuttosto poco. Mysql: qui è necessaria una replica, una replica live, perché in un'ora 100 GB in un dump probabilmente non ci staranno. Statico, immagini: di nuovo, in un'ora 500 GB potrebbero non riuscire a entrare. Pertanto, è meglio copiare subito le immagini. Redis: qui è più interessante. In Redis ci sono le sessioni — non possiamo semplicemente prenderlo e distruggerlo. Perché non sarebbe una cosa molto positiva: tutti gli utenti si troverebbero disconnessi, i carrelli svuotati e così via. Le persone sarebbero costrette a reinserire il proprio login e la propria password, e molte persone potrebbero allontanarsi e non completare l'acquisto. Inoltre, la conversione diminuirebbe. D'altra parte, Redis è davvero aggiornato, con gli ultimi utenti collegati, probabilmente non è nemmeno necessario. E un buon compromesso sarebbe prendere Redis e ripristinarlo da un backup, di ieri, oppure, se è fatto ogni ora, di un'ora fa. Fortunatamente, ripristinarlo da un backup significa copiare un file. La storia più interessante è Elasticsearch. Chi ha mai attivato la replica di MySQL? Chi ha mai attivato la replica di Elasticsearch? E a chi ha mai funzionato bene dopo? A cosa mi riferisco: vediamo nella nostra sistema una certa entità. Sembra utile, ma è complessa.
Complicato nel senso che i nostri colleghi ingegneri non hanno esperienza con esso. Oppure hanno esperienza negativa. Oppure capiamo che finora è una tecnologia piuttosto nuova con sfumature o incompletezze. Pensiamo... Accidenti, anche elastic è grande, ci vuole tempo per ripristinarlo da un backup, cosa fare? Comprendiamo che elastic viene utilizzato in questo caso per la ricerca. Ma come vende il nostro negozio online? Ci rivolgiamo ai marketer e chiediamo da dove arrivano le persone. Rispondono: "Il 90% arriva direttamente dalla scheda prodotto di Yandex Market". E comprano, oppure no. Pertanto, la ricerca è necessaria per il 10% degli utenti. E mantenere la replicazione di elastic, soprattutto tra diversi data center in diverse zone, ha davvero molte sfide. Qual è l'uscita? Prendiamo elastic su una piattaforma riservata e non facciamo nulla con esso. Se la questione tarderà, magari lo riporteremo su un giorno, ma non è certo. In effetti, la conclusione è più o meno la stessa: i servizi che non influenzano i soldi, di nuovo, non li riserviamo. Per mantenere lo schema più semplice.
Esempio numero quattro, ancora più complicato
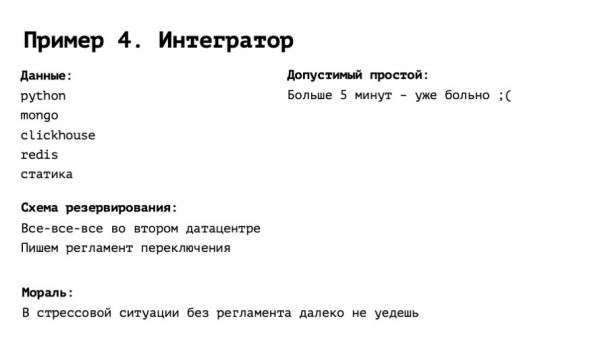
Integratore: vendite di fiori, chiamate di taxi, vendite di prodotti, insomma, di tutto. Una cosa seria che funziona 24/7 per un grande numero di utenti. Con un stack interessante e completo, dove ci sono database interessanti, soluzioni, carichi elevati, e la cosa più importante è che rimanere inattiva per più di 5 minuti è doloroso. Non solo perché la gente non comprerà, ma perché le persone vedranno che questa cosa non funziona, si sentiranno deluse e potrebbero non tornare mai più.
Ok. Cinque minuti. Cosa faremo al riguardo? In questo caso, ci comportiamo in modo maturo, investiamo realmente in una vera piattaforma di riserva, con replica di tutto e di più, e forse anche automatizziamo il passaggio a questa piattaforma al massimo. E in aggiunta a questo, non dobbiamo dimenticare di fare una cosa importante: scrivere il regolamento per il passaggio. Il regolamento, anche se avete automatizzato tutto, può essere molto semplice. Del tipo "eseguire questo particolare scenario ansible", "cliccare quella casella in route 53" e così via—ma deve essere un elenco preciso di azioni.
E sembra tutto chiaro. Passare la replicazione è un compito triviale, oppure si switcha da solo. Riscrivere il nome di dominio nel DNS è della stessa serie. Il problema è che quando un progetto del genere fallisce, inizia il panico, e anche gli amministratori più esperti e più navigati possono esserne colpiti. Senza un'istruzione chiara "apri il terminale, accedi qui, l'indirizzo del nostro server è ancora questo" è difficile rispettare i 5 minuti concessi per la rianimazione. In aggiunta, quando utilizziamo questo regolamento, è facile registrare eventuali modifiche nell'infrastruttura, ad esempio, e modificare il regolamento di conseguenza.
E se il sistema di backup è molto complesso e in un certo momento abbiamo commesso un errore, potremmo compromettere anche il nostro sito di riserva, e in aggiunta i dati diventerebbero inutilizzabili su entrambi i siti — sarebbe davvero triste.
Esempio numero cinque, hardcore completo
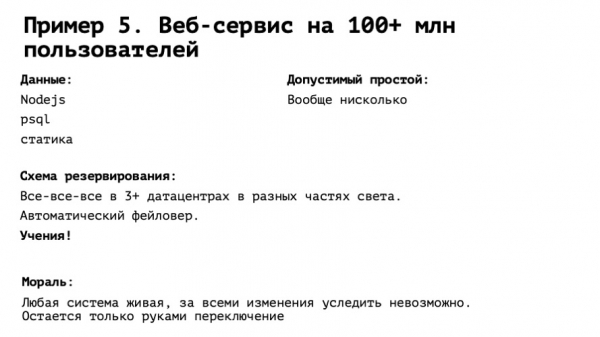
Un servizio internazionale con centinaia di milioni di utenti in tutto il mondo. Tutti i fusi orari, il massimo del highload, non ci si può permettere di essere giù. Un minuto — e sarà triste. Cosa fare? Riservare, soprattutto, a regola d'arte. Abbiamo fatto tutto ciò di cui ho parlato nell'esempio precedente, e anche qualcosina di più. Un mondo ideale, e la nostra infrastruttura è, per tutti i versi, DevOps IaaC. Cioè, tutto è in git, e basta premere un pulsante.
Cosa manca? Una cosa: esercitazioni. Senza di esse non è possibile. Sembra che tutto sia perfetto, e che abbiamo tutto sotto controllo. Premi un pulsante, tutto si verifica. Anche se fosse così — e sappiamo che così non è — il nostro sistema interagisce con altri sistemi. Per esempio, c'è il DNS di Route 53, gli archivi S3, l'integrazione con alcune API. Non possiamo prevedere tutto in questo esperimento teorico. E finché non tireremo fisicamente la leva non sapremo se funzionerà o meno.
Probabilmente è tutto. Non siate pigri e non esagerate. Che la disponibilità sia con voi!
Fonte: habr.com
