

Immaginiamo. In una stanza ci sono 5 gatti, e per andare a svegliare il padrone devono accordarsi tutti insieme, dato che possono aprire la porta solo tutti insieme. Se uno dei gatti è il gatto di Schrödinger, mentre gli altri gatti non conoscono la sua decisione, sorge la domanda: «Come possono farlo?»
In questo articolo, spiegherò in termini semplici la componente teorica del mondo dei sistemi distribuiti e i principi del loro funzionamento. Esplorerò anche superficialmente l'idea principale alla base di Paxos.
Quando gli sviluppatori utilizzano infrastrutture cloud, diversi database e lavorano in cluster di nodi, sono certi che i dati saranno integri, sicuri e sempre accessibili. Ma da dove vengono queste garanzie?
Fondamentalmente, le garanzie che abbiamo sono quelle del fornitore. Sono descritte nella documentazione più o meno in questo modo: «Questo servizio è abbastanza affidabile, ha un SLA definito, non preoccuparti, tutto funzionerà in distribuzione come ti aspetti».
Tendiamo a credere nel meglio, poiché signori intelligenti di grandi aziende ci hanno assicurato che andrà tutto bene. Non ci poniamo la domanda: perché, in realtà, tutto ciò potrebbe funzionare? Esiste una qualche giustificazione formale per la correttezza di tali sistemi?
Recentemente sono andato a e sono rimasto molto ispirato da questo tema. Le lezioni della scuola somigliavano più a corsi di analisi matematica che a qualcosa legato ai sistemi informatici. Ma è proprio così che un tempo venivano dimostrati gli algoritmi più importanti che utilizziamo ogni giorno senza neanche accorgercene.
Nella maggior parte dei moderni sistemi distribuiti si utilizza l'algoritmo di consenso Paxos e le sue varie modifiche. La cosa più interessante è che la validità e, in generale, la stessa possibile esistenza di questo algoritmo possono essere dimostrate semplicemente con carta e penna. Nel frattempo, nella pratica, l'algoritmo viene applicato in grandi sistemi operanti su un numero enorme di nodi nelle nuvole.
Un'illustrazione leggera di ciò di cui si parlerà dopo: il problema dei due generaliPer riscaldarci, analizziamo .
Abbiamo due eserciti: uno rosso e uno bianco. Le forze bianche si trovano nella città assediata. Le forze rosse, guidate dai generali A1 e A2, si sono dislocate ai due lati della città. Il compito dei rossi è attaccare la città bianca e vincere. Tuttavia, l'esercito di ciascun generale rosso è più piccolo di quello dei bianchi.
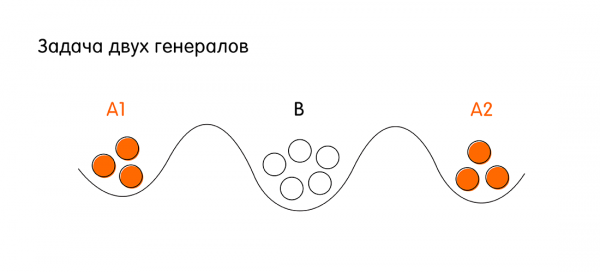
Le condizioni per la vittoria dei rossi: entrambi i generali devono attaccare simultaneamente per avere un vantaggio numerico sui bianchi. Per farlo, i generali A1 e A2 devono accordarsi tra loro. Se ciascuno attacca separatamente, i rossi perderanno.
Per accordarsi, i generali A1 e A2 possono inviare messaggeri l'uno all'altro attraverso il territorio della città bianca. Un messaggero può raggiungere con successo il generale alleato o può essere intercettato dal nemico. Il problema è: esiste una sequenza di comunicazioni tra i generali rossi (sequenza di invio di messaggeri da A1 a A2 e viceversa da A2 a A1) che garantisca che si accordino per attaccare all'ora X? Qui, per garanzie, si intende che entrambi i generali riceveranno una conferma inequivocabile che l'alleato (l'altro generale) attaccherà esattamente all'orario stabilito X.
Supponiamo che A1 invii un messaggero a A2 con il seguente messaggio: «Attacchiamo oggi a mezzanotte!». Il generale A1 non può attaccare senza la conferma del generale A2. Se il messaggero di A1 è arrivato, il generale A2 invia una conferma con il messaggio: «Sì, attacchiamo oggi a fracassare i bianchi». Ma ora il generale A2 non sa se il suo messaggero è arrivato o no, non ha garanzie che l'attacco sarà simultaneo. Ora, il generale A2 ha di nuovo bisogno di una conferma.
Se si approfondisce ulteriormente la loro comunicazione, si scoprirà quanto segue: non importa quante volte si scambino messaggi, non esiste un modo per garantire che entrambi i generali siano informati che i loro messaggi sono stati ricevuti (dato che qualunque messaggero può essere intercettato).
Il problema dei due generali è un'eccellente illustrazione di un sistema distribuito molto semplice, dove ci sono due nodi con una comunicazione inaffidabile. Questo significa che non abbiamo la garanzia al 100% che si sincronizzeranno. Di problemi simili, ma su una scala più ampia, si parlerà più avanti nell'articolo.
Introduciamo il concetto di sistemi distribuiti.
Un sistema distribuito è un gruppo di computer (che chiameremo nodi) in grado di scambiarsi messaggi. Ogni singolo nodo è un'entità autonoma. Un nodo può elaborare compiti in modo indipendente, ma per interagire con altri nodi deve inviare e ricevere messaggi.
Come vengono implementati i messaggi, quali protocolli vengono utilizzati, non ci interessa in questo contesto. È importante che i nodi del sistema distribuito possano scambiarsi dati inviando messaggi tra loro.
La definizione stessa non è molto complessa, ma è necessario considerare che un sistema distribuito ha una serie di attributi che saranno importanti per noi.
Attributi dei sistemi distribuiti
- Concorrenza – è la possibilità che si verifichino eventi simultanei o concorrenti nel sistema. Inoltre, considereremo che gli eventi che si verificano su due nodi diversi sono potenzialmente concorrenti finché non abbiamo un ordine chiaro nella loro apparizione. E, di solito, non lo abbiamo.
- Assenza di orologi globali. Non abbiamo un ordine chiaro degli eventi a causa dell'assenza di orologi globali. Nel mondo degli esseri umani siamo abituati ad avere orologi e tempo assoluto. Tutto cambia quando si parla di sistemi distribuiti. Anche gli orologi atomici super precisi hanno un drift, e ci possono essere situazioni in cui non possiamo dire quale dei due eventi si sia verificato per primo. Pertanto, non possiamo nemmeno fare affidamento sul tempo.
- Guasto indipendente dei nodi del sistema. C'è un'altra problematica: qualcosa può andare storto semplicemente perché i nostri nodi non sono eterni. Un disco rigido può guastarsi, una macchina virtuale nel cloud può riavviarsi, la rete può avere dei problemi e i messaggi possono andare persi. Inoltre, ci possono essere situazioni in cui i nodi funzionano, ma agiscono contro il sistema. Quest'ultima classe di problemi ha persino ricevuto un nome specifico: il problema . L'esempio più popolare di sistema distribuito con questo problema è il Blockchain. Ma oggi non parleremo di questa specifica classe di problemi. Ci interesseremo a situazioni in cui uno o più nodi possono andarsene in tilt.
- Modelli di comunicazione (modelli di scambio di messaggi) tra nodiAbbiamo già stabilito che i nodi comunicano attraverso lo scambio di messaggi. Ci sono due modelli di scambio di messaggi noti: sincrono e asincrono.
Modelli di comunicazione tra nodi nei sistemi distribuiti
Modello sincrono – sappiamo esattamente che c'è una delta di tempo finita nota, entro la quale il messaggio arriva garantito da un nodo all'altro. Se questo tempo scade e il messaggio non è arrivato, possiamo dire con certezza che il nodo è guasto. In questo modello abbiamo un tempo di attesa prevedibile.
Modello asincrono – nei modelli asincroni, consideriamo che il tempo di attesa sia finito, ma non esiste una delta di tempo dopo la quale possiamo garantire che il nodo è guasto. Cioè, il tempo di attesa per un messaggio da un nodo può essere arbitrariamente lungo. Questa è una definizione importante, e ne parleremo ulteriormente.
Il concetto di consenso nei sistemi distribuiti
Prima di definire formalmente il concetto di consenso, consideriamo un esempio di situazione in cui ci serve, ovvero – Replica della macchina di stato.
Abbiamo un certo log distribuito. Vorremmo che fosse coerente e contenesse dati identici su tutti i nodi del sistema distribuito. Quando uno dei nodi apprende un nuovo valore che intende registrare nel log, il suo compito è proporre questo valore a tutti gli altri nodi, affinché il log si aggiorni su tutti i nodi e il sistema passi a un nuovo stato coerente. È importante che i nodi si mettano d'accordo tra di loro: tutti i nodi concordano che il nuovo valore proposto sia corretto, tutti i nodi accettano questo valore, e solo in questo caso possono tutti registrare il nuovo valore nel log.
In altre parole: nessuno dei nodi ha obiettato di avere informazioni più aggiornate, e che il valore proposto è errato. L'accordo tra i nodi e il consenso su un unico valore accettato corretto è il consenso in un sistema distribuito. Successivamente parleremo degli algoritmi che permettono a un sistema distribuito di raggiungere garantito il consenso.
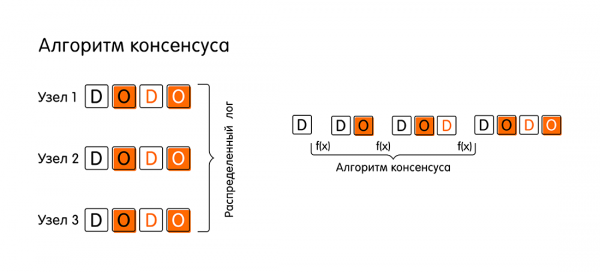
In modo più formale, possiamo definire l'algoritmo di consenso (o semplicemente algoritmo di consenso) come una funzione che trasforma un sistema distribuito da uno stato A a uno stato B. Questo stato è accettato da tutti i nodi, e tutti i nodi possono confermarlo. Si scopre che questa operazione non è così banale come sembra a prima vista.
Proprietà dell'algoritmo di consenso
L'algoritmo di consenso deve avere tre proprietà affinché il sistema possa continuare ad esistere e avere qualche progresso nel passaggio da uno stato all'altro:
- Accordo – tutti i nodi funzionanti devono accettare lo stesso valore (in articoli questa proprietà è talvolta indicata come proprietà di sicurezza). Tutti i nodi attualmente operativi (che non sono offline e non hanno perso il contatto con gli altri) devono arrivare a un accordo e accettare un certo valore finale comune.
È importante capire che i nodi nel sistema distribuito che stiamo considerando vogliono mettersi d'accordo. Vale a dire, stiamo parlando di sistemi in cui qualcosa potrebbe semplicemente guastarsi (ad esempio, un nodo potrebbe guastarsi), ma in questo sistema non ci sono nodi che lavorano intenzionalmente contro gli altri (il problema dei generali bizantini). Grazie a questa proprietà, il sistema rimane consistente.
- Integrità – se tutti i nodi funzionanti offrono lo stesso valore v, allora ogni nodo funzionante deve accettare questo valore v.
- Terminazione – tutti i nodi funzionanti alla fine accetteranno un certo valore (proprietà di vivacità), il che consente all'algoritmo di progredire nel sistema. Ogni singolo nodo funzionante deve, prima o poi, accettare un valore finale e confermarlo: "Per me, questo valore è vero, sono d'accordo con l'intero sistema".
Esempio di funzionamento dell'algoritmo di consenso
Finché le proprietà dell'algoritmo potrebbero non essere del tutto chiare. Illustriamo quindi, con un esempio, quali fasi attraversa il più semplice algoritmo di consenso in un sistema con un modello di scambio messaggi sincrono, in cui tutti i nodi funzionano come previsto, i messaggi non vengono persi e niente si rompe (è davvero possibile che accada?).
- Tutto inizia con la proposta di matrimonio (Propose). Supponiamo che un cliente si sia connesso al nodo chiamato "Nodo 1" e abbia avviato una transazione, inviando al nodo un nuovo valore – O. Da questo momento in poi, chiameremo "Nodo 1" proposer. Come proposer, "Nodo 1" deve ora notificare l'intero sistema che ha nuovi dati e invia a tutti gli altri nodi messaggi: "Guardate! Ho ricevuto il valore 'O' e voglio scriverlo! Vi chiedo di confermare che lo scriverete anch'esso nel vostro registro."

- La fase successiva è il voto sul valore proposto (Voting). A cosa serve? Può accadere che ad altri nodi siano arrivati dati più aggiornati, e che abbiano informazioni relative alla stessa transazione.
Quando il nodo "Nodo 1" invia la sua proposta, gli altri nodi controllano nei loro registri i dati relativi a questo evento. Se non ci sono contraddizioni, i nodi dichiarano: "Sì, non ho altri dati relativi a questo evento. Il valore 'O' è l'informazione più recente che abbiamo ricevuto."In ogni altro caso, i nodi possono rispondere a "Nodo 1": "Ascolta! Ho dati più aggiornati su questa transazione. Non 'O', ma qualcosa di migliore."
Nella fase di voto, i nodi giungono a una decisione: o tutti accettano un valore, oppure qualcuno di essi vota contro, indicando di avere dati più recenti.
- Se il round di voto ha avuto successo e tutti sono stati favorevoli, il sistema passa a una nuova fase: l'accettazione del valore (Accept). "Nodo 1" raccoglie tutte le risposte degli altri nodi e comunica: "Tutti hanno concordato sul valore 'O'! Ora dichiaro ufficialmente che 'O' è il nostro nuovo valore, unico per tutti! Annotatevi questo, non dimenticatelo. Scrivetelo nel vostro registro!"
- Gli altri nodi inviano conferma (Accepted) che hanno annotato il valore 'O', che nel frattempo non è arrivato nulla di nuovo (una sorta di commit in due fasi). Dopo questo evento significativo, consideriamo che la transazione distribuita sia stata completata.
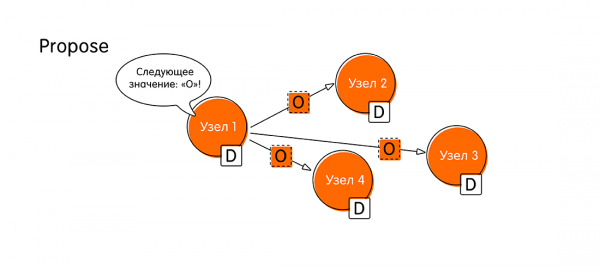
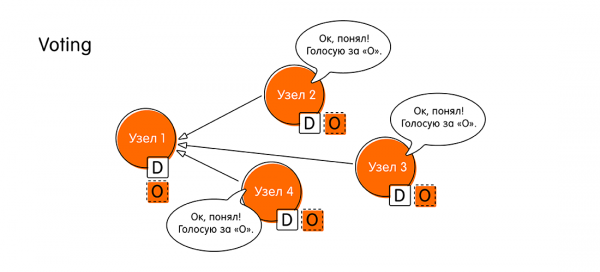
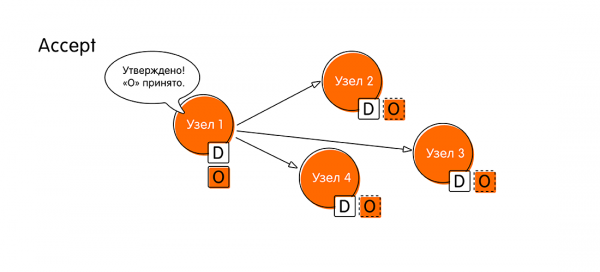
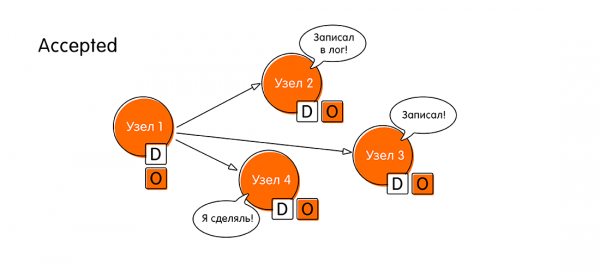
Pertanto, l'algoritmo di consenso in un caso semplice consiste in quattro passaggi: propose, voto (voting), accettazione (accept), conferma dell'accettazione (accepted).
Se in qualche fase non riusciamo a raggiungere un consenso, l'algoritmo viene riavviato, tenendo conto delle informazioni fornite dai nodi che hanno rifiutato di confermare il valore proposto.
L'algoritmo di consenso in un sistema asincrono
Fino a questo momento tutto andava bene, poiché stavamo trattando un modello di scambio di messaggi sincrono. Ma sappiamo che nel mondo moderno siamo abituati a fare tutto in modo asincrono. Come funziona quindi un algoritmo simile in un sistema con un modello di scambio di messaggi asincrono, dove consideriamo che il tempo di attesa per una risposta da un nodo possa essere arbitrariamente lungo (per inciso, l'uscita di un nodo fuori gioco può anche essere vista come un esempio in cui un nodo potrebbe rispondere con arbitraria lentezza).
Ora, quando sappiamo come funziona in linea di principio l'algoritmo di consenso, la domanda per i lettori curiosi che sono arrivati a questo punto è: quanti nodi in un sistema di N nodi con un modello di messaggi asincroni possono uscire fuori gioco affinché il sistema possa comunque raggiungere il consenso?
La risposta corretta e la motivazione sono nel spoiler.Risposta corretta: 0. Se almeno un nodo in un sistema asincrono esce fuori gioco, il sistema non potrà raggiungere il consenso. Questa affermazione è dimostrata nel noto teorema FLP (1985, Fischer, Lynch, Paterson, link all'originale alla fine dell'articolo): "L'impossibilità di raggiungere un consenso distribuito in caso di guasto di almeno un nodo".
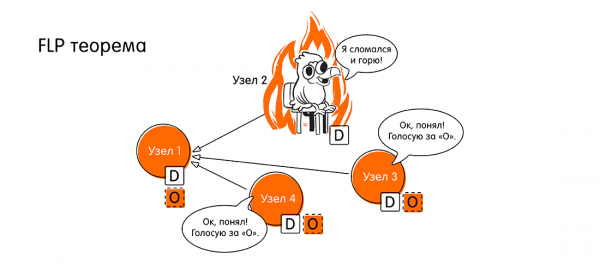
Ragazzi, allora abbiamo un problema, siamo abituati a fare tutto in modo asincrono. E ora ci troviamo in questa situazione. Come andiamo avanti?
Abbiamo parlato della teoria, della matematica. Cosa significa "il consenso non può essere raggiunto", traducendo dal linguaggio matematico al nostro – ingegneristico? Significa che "non sempre può essere raggiunto", cioè esiste un caso in cui il consenso non è raggiungibile. Ma quale è questo caso?
È proprio la violazione della proprietà di vivacità, descritta sopra. Non abbiamo consenso comune e il sistema non può avere progresso (non può completarsi in un tempo finito) nel caso in cui non riceviamo risposta da tutti i nodi. Perché in un sistema asincrono non abbiamo un tempo di risposta prevedibile e non possiamo sapere se un nodo è fuori gioco o semplicemente sta rispondendo lentamente.
Ma in pratica possiamo trovare una soluzione. Supponiamo che il nostro algoritmo possa funzionare a lungo in caso di guasti (potenzialmente può funzionare indefinitamente). Ma nella maggior parte delle situazioni, quando la maggior parte dei nodi funziona correttamente, avremo progresso nel sistema.
Nella pratica, abbiamo a che fare con modelli di comunicazione parzialmente sincroni. La parziale sincronicità è intesa come segue: generalmente abbiamo un modello asincrono, ma si introduce formalmente il concetto di "tempo di stabilizzazione globale" in un certo momento.
Questo momento potrebbe non verificarsi per un tempo indefinito, ma un giorno deve arrivare. Suonerà la sveglia virtuale e da quel momento possiamo prevedere la delta temporale per cui i messaggi arriveranno. Da quel momento, il sistema passa da asincrono a sincrono. Nella pratica, trattiamo proprio con sistemi di questo tipo.
L'algoritmo Paxos risolve problemi di consenso
– è una famiglia di algoritmi che risolvono il problema del consenso per sistemi parzialmente sincroni, a condizione che alcuni nodi possano guastarsi. L'autore di Paxos è . Ha proposto una dimostrazione formale dell'esistenza e correttezza dell'algoritmo nel 1989.
Ma la dimostrazione si è rivelata tutt'altro che banale. La prima pubblicazione è stata rilasciata solo nel 1998 (33 pagine) con la descrizione dell'algoritmo. Si è rivelata estremamente difficile da comprendere, e nel 2001 è stata pubblicata una spiegazione dell'articolo che ha occupato 14 pagine. Le dimensioni delle pubblicazioni sono indicate per dimostrare che in realtà il problema del consenso è piuttosto complesso e dietro a tali algoritmi c'è un enorme lavoro delle menti più brillanti.
È interessante notare che lo stesso Leslie Lamport nella sua lezione ha osservato che nella seconda articolo di spiegazione c'è un'affermazione, una riga (non ha specificato quale), che può essere interpretata in modi diversi. E per questo motivo, un gran numero di implementazioni moderne di Paxos non funzionano del tutto correttamente.
Un'analisi dettagliata del funzionamento di Paxos richiederebbe più di un articolo, quindi cercherò di trasmettere molto brevemente l'idea principale dell'algoritmo. Nei collegamenti alla fine del mio articolo troverete materiali per un ulteriore approfondimento su questo tema.
Ruoli in Paxos
Nell'algoritmo Paxos c'è il concetto di ruoli. Consideriamo i tre principali (ci sono modifiche con ruoli aggiuntivi):
- Proposers (possono anche essere utilizzati i termini: leader o coordinatori)Questi sono i ragazzi che apprendono un nuovo valore dall'utente e svolgono il ruolo di leader. Il loro compito è avviare un round per proporre un nuovo valore e coordinare le ulteriori azioni dei nodi. Inoltre, Paxos consente la presenza di più leader in determinate situazioni.
- Accettatori (Votanti)Questi sono i nodi che votano per l'accettazione o il rifiuto di un certo valore. Il loro ruolo è molto importante, poiché dipende da loro la decisione su quale stato passerà (o non passerà) il sistema dopo la fase successiva dell'algoritmo di consenso.
- ApprendistiI nodi che semplicemente accettano e registrano il nuovo valore accettato quando lo stato del sistema è cambiato. Non prendono decisioni, ma ricevono dati e possono fornirli all'utente finale.
Un nodo può ricoprire più ruoli in diverse situazioni.
Il concetto di quorum
Presupponiamo di avere un sistema costituito da N nodi. E di questi, al massimo F nodi possono guastarsi. Se F nodi si guastano, allora nel nostro cluster devono esserci almeno 2F + 1 nodi accettatori.
Questo è necessario affinché abbiamo sempre, anche nella situazione peggiore, un numero maggiore di nodi "buoni", funzionanti correttamente. Cioè, abbiamo bisogno di F + 1 nodi "buoni" che abbiano concordato, e il valore finale sarà accettato. Altrimenti, potrebbe verificarsi una situazione in cui diversi gruppi locali accettano valori diversi e non possono accordarsi tra loro. Pertanto, abbiamo bisogno di una maggioranza assoluta per vincere nella votazione.
L'idea generale del funzionamento dell'algoritmo di consenso Paxos
L'algoritmo Paxos prevede due grandi fasi, ciascuna delle quali è suddivisa in due passaggi:
- Fase 1a: Preparare. Durante la fase di preparazione, il leader (proposer) informa tutti i nodi: «Iniziamo una nuova fase di voto. Abbiamo un nuovo turno. Il numero di questo turno è n. Adesso iniziamo a votare». Finora ha solo comunicato l'inizio di un nuovo ciclo, senza fornire un nuovo valore. L'obiettivo di questa fase è avviare un nuovo turno e comunicare a tutti il suo numero unico. Il numero del turno è importante, deve essere un valore maggiore rispetto a tutti i numeri di voto precedenti da tutti i leader precedenti. Infatti, è grazie al numero del turno che gli altri nodi nel sistema capiranno quanto siano aggiornati i dati del leader. Probabilmente, altri nodi hanno già risultati di voti provenienti da turni molto più recenti e semplicemente informeranno il leader che è rimasto indietro.
- Fase 1b: Promessa. Quando i nodi-acceptor ricevono il numero del nuovo turno di voto, possono verificarsi due esiti:
- Il numero n del nuovo voto è maggiore di qualsiasi numero di voti precedenti a cui l'acceptor ha partecipato. In questo caso, l'acceptor invia al leader una promessa di non partecipare a ulteriori votazioni con un numero inferiore a n. Se l'acceptor ha già votato per qualcosa (cioè è già nella seconda fase ha accettato un valore), allora allega alla sua promessa il valore accettato e il numero di voto a cui ha partecipato.
- Altrimenti, se l'acceptor è già a conoscenza di una votazione con un numero maggiore, può semplicemente ignorare la fase di preparazione e non rispondere al leader.
- Fase 2a: Accettazione. Il leader deve attendere la risposta dal quorum (maggioranza dei nodi nel sistema) e, se riceve il numero necessario di risposte, ha due possibili sviluppi:
- Alcuni degli acceptor hanno inviato valori per cui hanno già votato. In questo caso, il leader sceglie il valore dalla votazione con il numero massimo. Chiamiamo questo valore x, e invia a tutti i nodi un messaggio del tipo: «Accept (n, x)», dove il primo valore è il numero di voto del proprio passaggio Propose, e il secondo valore è quello per cui ci si è riuniti, cioè il valore per cui, in sostanza, si sta votando.
- Se nessuno degli acceptor ha inviato alcun valore e ha semplicemente promesso di votare in questo turno, il leader può chiedere loro di votare per il proprio valore, quello per cui è diventato leader. Chiamiamolo y. Egli invia a tutti i nodi un messaggio del tipo: «Accept (n, y)», in analogia con l'output precedente.
- Fase 2b: Accettato. Successivamente, i nodi-acceptor, al ricevimento del messaggio «Accept(…)» dal leader, concordano con esso (inviando a tutti i nodi una conferma che sono d'accordo con il nuovo valore) solo se non hanno promesso a un (altro) leader di partecipare alle votazioni con numero di turno n’ > n, altrimenti ignorano la richiesta di conferma.
Se il leader ha ricevuto la risposta della maggioranza dei nodi, e tutti hanno confermato il nuovo valore, allora il nuovo valore viene considerato accettato. Evviva! Se invece non viene raggiunta la maggioranza o ci sono nodi che si rifiutano di accettare il nuovo valore, tutto ricomincia da capo.
Ecco come funziona l'algoritmo Paxos. Ogni fase di questi ha molte sfumature, non abbiamo praticamente esaminato i vari tipi di guasti, i problemi dei molteplici leader e molto altro, ma lo scopo di questo articolo è semplicemente introdurre il lettore al mondo dei calcoli distribuiti a un livello elevato.
Vale anche la pena notare che Paxos non è l'unico nel suo genere, ci sono altri algoritmi, ad esempio , ma questo è un tema per un altro articolo.
Link a materiali per ulteriori studi
Livello «principiante»:
- , Preethi Kasireddy, articolo di blog su Medium
- , Adi Kancherla, articolo di blog su Medium
- , Ittai Abraham, blog
- , Ittai Abraham, articolo di blog
Livello «Leslie Lamport»:
- , Fischer, Lynch e Paterson, articolo di ricerca, 1985
- , Leslie Lamport, articolo di ricerca, 1998
- , Leslie Lamport, articolo di ricerca, 2001
Fonte: habr.com
