

Con il database Apache Cassandra e la necessità di gestirlo nell'infrastruttura basata su Kubernetes, ci troviamo di fronte a questa situazione regolarmente. In questo articolo condivideremo la nostra visione dei passaggi necessari, dei criteri e delle soluzioni esistenti (inclusa una panoramica degli operatori) per la migrazione di Cassandra in K8s.
«Chi può gestire una donna, gestirà anche uno stato»
Chi è Cassandra? È un sistema distribuito di archiviazione progettato per gestire grandi volumi di dati, garantendo al contempo un'elevata disponibilità senza un singolo punto di guasto. Il progetto non ha bisogno di una lunga presentazione, quindi cito solo le caratteristiche principali di Cassandra, che saranno pertinenti per il presente articolo:
- Cassandra è scritta in Java.
- La topologia di Cassandra include diversi livelli:
- Node — un'istanza di Cassandra distribuita;
- Rack — un gruppo di istanze di Cassandra unite da qualche criterio, che si trova in un unico data center;
- Datacenter — l'insieme di tutti i gruppi di istanze di Cassandra che si trovano in un unico data center;
- Cluster — l'insieme di tutti i data center.
- Per identificare il nodo, Cassandra utilizza l'indirizzo IP.
- Per velocizzare le operazioni di scrittura e lettura, parte dei dati di Cassandra viene memorizzata in memoria volatile.
Ora, passiamo al potenziale trasferimento in Kubernetes.
Checklist per la migrazione
Parlando della migrazione di Cassandra in Kubernetes, ci auguriamo che la gestione diventi più comoda con il trasferimento. Di cosa abbiamo bisogno per questo, e cosa ci aiuterà?
1. Archiviazione dei dati
Come già specificato, parte dei dati di Cassandra è memorizzata in memoria — in Memtable. Ma c'è anche un'altra parte dei dati, che viene salvata su disco, — sotto forma di SSTable. A questi dati si aggiunge l'entità Commit Log — registrazioni di tutte le transazioni, che vengono anch'esse salvate su disco.
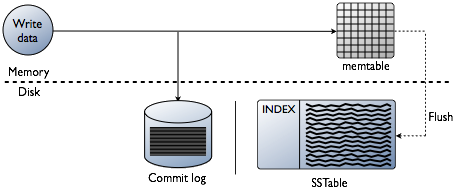
Schema delle transazioni di scrittura in Cassandra
In Kubernetes possiamo utilizzare PersistentVolume per la memorizzazione dei dati. Grazie ai meccanismi collaudati, lavorare con i dati in Kubernetes diventa ogni anno più semplice.
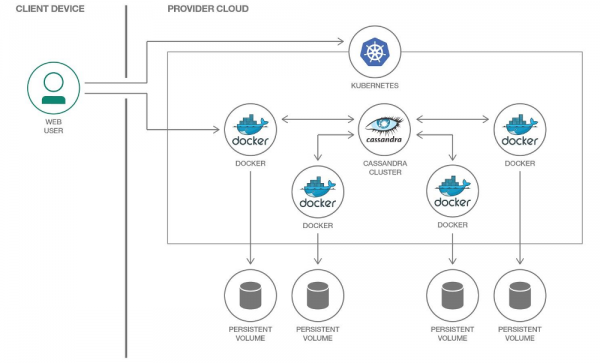
A ciascun pod di Cassandra assegneremo il proprio PersistentVolume
È importante notare che Cassandra in sé implica la replicazione dei dati, offrendo a tal fine meccanismi integrati. Pertanto, se stai costruendo un cluster Cassandra composto da un gran numero di nodi, non è necessario utilizzare sistemi distribuiti per l'archiviazione dei dati come Ceph o GlusterFS. In questo caso, sarà logico memorizzare i dati sul disco del nodo tramite o montaggio hostPath.
Un'altra questione è se desideri creare un ambiente separato per gli sviluppatori per ogni ramo di funzionalità. In questo caso, l'approccio corretto sarebbe avviare un nodo Cassandra e memorizzare i dati in uno storage distribuito, cioè i già citati Ceph e GlusterFS diventeranno una tua opzione. Così lo sviluppatore sarà sicuro di non perdere dati di test anche in caso di perdita di uno dei nodi del cluster Kubernetes.
2. Monitoraggio
Una scelta praticamente senza alternative per implementare il monitoraggio in Kubernetes è Prometheus (di questo abbiamo parlato in dettaglio nel ). Come se la cava Cassandra con gli exporter di metriche per Prometheus? E, cosa ancor più importante, con i relativi dashboard per Grafana?
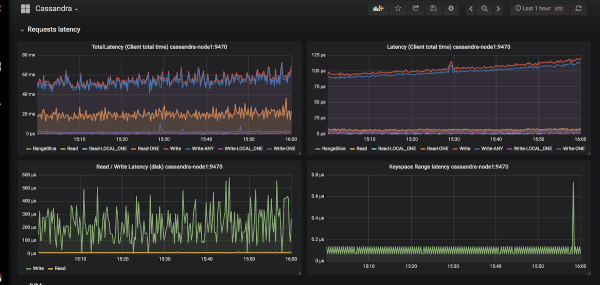
Esempio di grafici in Grafana per Cassandra
Ci sono solo due exporter: e .
Abbiamo scelto il primo perché:
- JMX Exporter sta crescendo e sviluppandosi, mentre Cassandra Exporter non riesce a ottenere il giusto supporto dalla comunità. Cassandra Exporter non supporta ancora la maggior parte delle versioni di Cassandra.
- È possibile avviarlo come javaagent aggiungendo il flag
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Per questo esiste un , che non è compatibile con Cassandra Exporter.
3. Scelta dei primitivi Kubernetes
In base alla struttura del cluster Cassandra sopra descritta, proviamo a tradurre tutto ciò che è descritto in terminologia Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → pool di StatefulSets
- Cassandra Cluster → ???
Risulta quindi che manca qualche entità aggiuntiva per gestire l'intero cluster Cassandra contemporaneamente. Ma se qualcosa non c'è, possiamo crearlo! In Kubernetes esiste un meccanismo per la definizione di risorse personalizzate — .
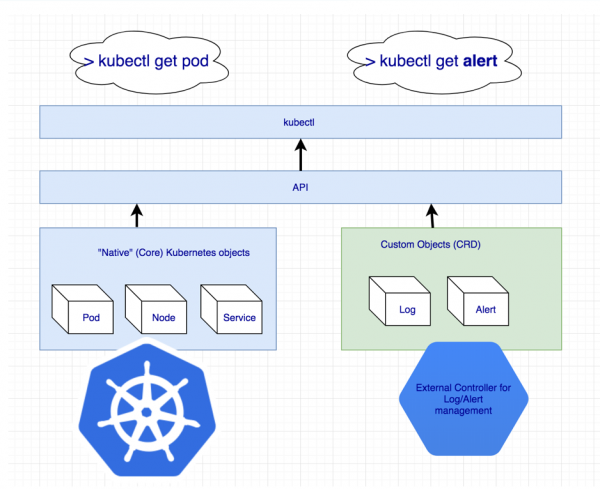
Dichiarazione di risorse aggiuntive per log e notifiche
Ma una risorsa personalizzata di per sé non significa nulla: infatti, ha bisogno di controllore. Potrebbe essere necessario ricorrere all'aiuto di un …
4. Identificazione dei pod
Ci siamo accordati nel punto precedente che un nodo Cassandra corrisponde a un pod in Kubernetes. Tuttavia, gli indirizzi IP dei pod saranno diversi ogni volta. E l'identificazione del nodo in Cassandra avviene proprio sulla base dell'indirizzo IP... Quindi, dopo ogni eliminazione di un pod, il cluster Cassandra aggiungerà un nuovo nodo.
Esistono delle soluzioni, e più di una:
- Possiamo tenere traccia degli identificatori degli host (UUID, che identificano univocamente le istanze di Cassandra) o degli indirizzi IP e salvare tutto ciò in alcune strutture/tabelle. Questo metodo presenta due principali svantaggi:
- Rischio di una condizione di race se due nodi si guastano contemporaneamente. Dopo il ripristino, i nodi Cassandra inizieranno a richiedere un indirizzo IP dalla tabella e a competere per la risorsa.
- Se un nodo Cassandra perde i suoi dati, non saremo più in grado di identificarlo.
- La seconda soluzione sembra un piccolo hack, ma comunque: possiamo creare un Service con ClusterIP per ogni nodo Cassandra. I problemi di questa implementazione sono:
- Se nel cluster Cassandra ci sono molti nodi, dovremo creare un numero elevato di Service.
- La funzionalità ClusterIP è realizzata tramite iptables. Questo potrebbe diventare un problema se ci sono molti nodi nel cluster Cassandra (1000... o anche 100?). Anche se può risolvere questo problema.
- La terza soluzione consiste nell'utilizzare la rete dei nodi per i nodi Cassandra invece di una rete dedicata per i pod attivando l'impostazione
hostNetwork: true. Questo metodo impone alcune limitazioni:- Sostituzione dei nodi. È necessario che il nuovo nodo abbia lo stesso indirizzo IP di quello precedente (nelle nuvole come AWS o GCP, questo è praticamente impossibile);
- Utilizzando la rete dei nodi del cluster, iniziamo a competere per le risorse di rete. Di conseguenza, posizionare più di un pod Cassandra su un singolo nodo del cluster sarà problematico.
5. Backup
Vogliamo salvare una versione completa dei dati di un nodo Cassandra secondo un programma prestabilito. Kubernetes offre una comodità con l'uso di , ma qui ci sono delle difficoltà con la stessa Cassandra.
Ricordo che parte dei dati di Cassandra è memorizzata in memoria. Per effettuare un backup completo, è necessario spostare i dati dalla memoria (Memtables) sul disco (SSTables). In questo momento, il nodo Cassandra smette di accettare connessioni, disconnettendosi completamente dal lavoro del cluster.
Dopo viene eseguito il backup (snapshot) e viene salvato lo schema (keyspace). E qui si scopre che una semplice copia di backup non ci aiuta: è necessario mantenere gli identificatori dei dati per i quali il nodo Cassandra era responsabile, ossia i token speciali.
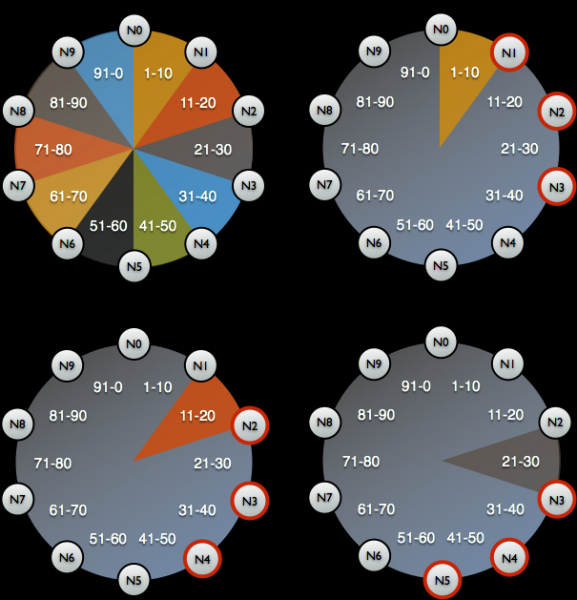
Distribuzione dei token per identificare i dati responsabili dei nodi Cassandra
Un esempio di script per effettuare un backup di Cassandra da Google in Kubernetes è disponibile su . L'unico aspetto che lo script non considera è il ripristino dei dati sul nodo prima di creare lo snapshot. In altre parole, il backup viene eseguito non per lo stato attuale, ma per uno stato precedente. Tuttavia, questo permette di non mettere il nodo offline, il che appare molto logico.
set -eu

if [[ -z "$1" ]]; then
  info "Si prega di fornire uno spazio dei nomi"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Errore durante la creazione dello snapshot"
  exit 1
fi

timestamp=$(echo "$result" | awk '/Snapshot directory: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Esempio di script bash per eseguire un backup da un singolo nodo Cassandra
Soluzioni pronte per Cassandra in Kubernetes
Cosa viene attualmente utilizzato per implementare Cassandra in Kubernetes e cosa si adatta meglio ai requisiti specificati?
1. Soluzioni basate su StatefulSet o Helm charts
Utilizzare le funzionalità di base degli StatefulSet per eseguire un cluster Cassandra è una buona opzione. Utilizzando un Helm chart e modelli Go, è possibile fornire all'utente un'interfaccia flessibile per implementare Cassandra.
Di solito funziona tranquillamente… fino a quando non succede qualcosa di imprevisto, come il guasto di un nodo. Gli strumenti standard di Kubernetes semplicemente non possono tener conto di tutte le complessità sopra descritte. Inoltre, questo approccio è molto limitato in termini di quanto può essere esteso per usi più complessi: sostituzione dei nodi, backup, ripristino, monitoraggio, ecc.
Rappresentanti:
- ;
- .
Entrambi i chart sono altrettanto validi, ma entrambi soffrono dei problemi descritti sopra.
2. Soluzioni basate su Kubernetes Operator
Queste opzioni sono più interessanti poiché offrono ampie possibilità di gestione del cluster. Per progettare un operatore Cassandra, come per qualsiasi altro database, un buon modello appare come Sidecar Controller CRD:
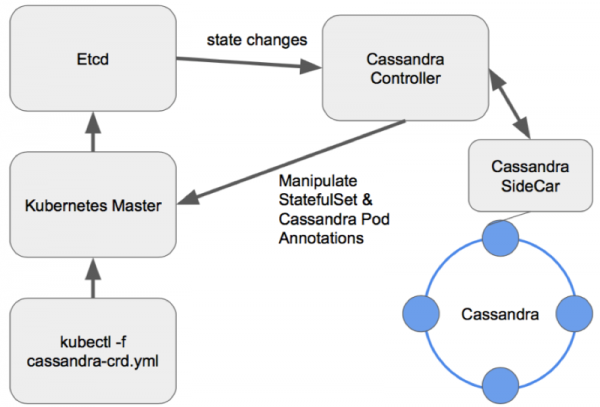
Schema di gestione dei nodi in un operatore Cassandra progettato correttamente
Consideriamo gli operatori esistenti.
1. Cassandra-operator di instaclustr
- Prontezza: Alpha
- Licenza: Apache 2.0
- Implementato in: Java
Questo è davvero un progetto molto promettente e in continua evoluzione da parte di un'azienda che offre implementazioni gestite di Cassandra. Utilizza, come descritto in precedenza, un container sidecar che riceve comandi tramite HTTP. È scritto in Java, quindi a volte gli manca una funzionalità più avanzata della libreria client-go. Inoltre, l'operatore non supporta rack diversi per un singolo datacenter.
Tuttavia, l'operatore ha vantaggi come il supporto alla monitorizzazione, una gestione ad alto livello del cluster tramite CRD e anche documentazione per il backup.
2. Navigator di Jetstack
- Prontezza: Alpha
- Licenza: Apache 2.0
- Implementato in: Golang
Un operatore progettato per implementare DB-as-a-Service. Attualmente supporta due database: Elasticsearch e Cassandra. Ha soluzioni interessanti, come il controllo degli accessi al database tramite RBAC (per questo viene sollevato un proprio navigator-apiserver). È un progetto interessante che meriterebbe attenzione, tuttavia l'ultimo commit risale a un anno e mezzo fa, il che riduce chiaramente il suo potenziale.
3. Cassandra-operator di vgkowski
- Prontezza: Alpha
- Licenza: Apache 2.0
- Implementato in: Golang
Non è stato considerato "seriamente", poiché l'ultimo commit nel repository risale a più di un anno fa. Lo sviluppo dell'operatore è stato abbandonato: l'ultima versione di Kubernetes dichiarata come supportata è la 1.9.
4. Cassandra-operator di Rook
- Prontezza: Alpha
- Licenza: Apache 2.0
- Implementato in: Golang
Un operatore il cui sviluppo non procede così rapidamente come ci si aspetterebbe. Ha una struttura CRD ben progettata per la gestione del cluster e risolve il problema dell'identificazione dei nodi tramite Service con ClusterIP (quello che viene definito "hack")… ma per ora è tutto. Attualmente non ci sono monitoraggio e backup out-of-the-box (a proposito, per il monitoraggio ci ). Un punto interessante è che con questo operatore è possibile implementare anche ScyllaDB.
NB: Abbiamo utilizzato questo operatore con alcune modifiche in uno dei nostri progetti. Non sono stati riscontrati problemi nel funzionamento dell'operatore durante tutto il periodo di utilizzo (~4 mesi di attività).
5. CassKop di Orange
- Prontezza: Alpha
- Licenza: Apache 2.0
- Implementato in: Golang
L'operatore più giovane nella lista: il primo commit è stato fatto il 23 maggio 2019. Già ora ha a disposizione molte funzionalità della nostra lista, con le quali è possibile approfondire consultando il repository del progetto. L'operatore è costruito sulla base del popolare operator-sdk. Supporta il monitoraggio "out-of-the-box". La sua principale differenza rispetto ad altri operatori è l'utilizzo , realizzato in Python e utilizzato per la comunicazione tra i nodi Cassandra.
Conclusioni
Il numero di approcci e possibili varianti per trasferire Cassandra in Kubernetes parla da sé: l'argomento è richiesto.
In questa fase, provare qualcosa di quanto sopra è a proprio rischio e pericolo: nessuno degli sviluppatori garantisce il funzionamento al 100% della propria soluzione in ambiente di produzione. Ma già ora molti prodotti sembrano promettenti per essere provati in ambienti di sviluppo.
Penso che in futuro questa donna sulla nave sarà utile!
P.S.
Leggi anche nel nostro blog:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
