

A tutti buona giornata!
Mi chiamo Nikita, sono il team leader del gruppo ingegneri di Cian. Una delle mie responsabilità in azienda è ridurre il numero di incidenti legati all'infrastruttura in produzione a zero.
Quello di cui parleremo nei prossimi paragrafi ci ha causato molta sofferenza, e l'obiettivo di questo articolo è non far ripetere ad altre persone i nostri errori o almeno minimizzare il loro impatto.
Premessa
Molto tempo fa, quando Cian era composto da monoliti e non c'erano tracce di microservizi, misuravamo la disponibilità del servizio controllando 3-5 pagine.
Se le pagine rispondevano, tutto andava bene; se non rispondevano per molto tempo, scattava un alert. Quanto tempo dovevano rimanere inattive per essere considerato un incidente, lo decidevano le persone in riunione. Il team di ingegneri partecipava sempre all'indagine sull'incidente. Quando l'indagine era conclusa, scrivevano un post mortem — una sorta di rapporto via email nel formato: cosa è successo, quanto è durato, cosa è stato fatto nel momento e cosa faremo in futuro.
Le pagine principali del sito o come comprendiamo di aver toccato il fondo
Per poter capire in qualche modo la priorità dell'errore, abbiamo identificato le pagine più critiche per le funzionalità aziendali del sito. Su queste pagine calcoliamo il numero di richieste andate a buon fine/non andate a buon fine e i timeout. In questo modo misuriamo l'uptime.
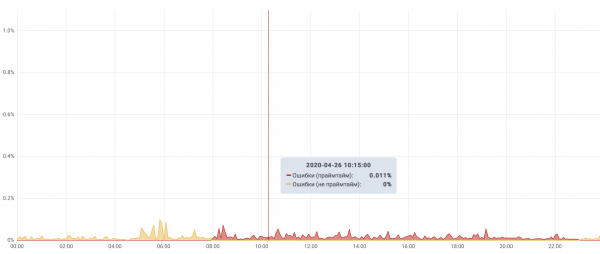
Supponiamo di aver scoperto che ci sono diverse sezioni super importanti del sito che sono responsabili del servizio principale — ricerca e invio di annunci. Se il numero di richieste che si sono concluse con un errore supera l'1%, è un incidente critico. Se durante 15 minuti nelle ore di punta la percentuale di errori supera lo 0,1%, è considerato anch'esso un incidente critico. Questi criteri coprono la maggior parte degli incidenti, gli altri esulano da questo articolo.
I migliori incidenti di Cian
Quindi, abbiamo sicuramente imparato a riconoscere il fatto che si è verificato un incidente.
Ora ogni incidente è descritto in dettaglio e riflesso nell'epica di Jira. A proposito: per questo abbiamo creato un progetto separato, chiamato FAIL — al suo interno si possono creare solo epiche.
Se raccogliamo tutti i fallimenti degli ultimi anni, i più frequenti sono:
- incidenti legati a mssql;
- incidenti causati da fattori esterni;
- errori dell'amministratore.
Fermiamoci a esaminare più in dettaglio gli errori degli amministratori, così come alcuni altri fallimenti interessanti.
Quinto posto — "Mettiamo in ordine il DNS"
Era un martedì tempestoso. Abbiamo deciso di mettere in ordine il cluster DNS.
Ci è venuta voglia di migrare i server DNS interni da bind a powerdns, dedicando a questo completamente server separati, dove non c'è nulla oltre al DNS.
Abbiamo posizionato un server DNS in ciascuna delle nostre località nei DC, e è arrivato il momento di migrare le zone da bind a powerdns e di passare l'infrastruttura sui nuovi server.
Nel momento più intenso della migrazione, di tutti server, che erano stati indicati nei bind di caching locali su tutti i server, ne è rimasto solo uno, che si trovava nel data center di San Pietroburgo. Questo DC era stato inizialmente dichiarato come non critico per noi, ma è diventato improvvisamente un punto unico di guasto.
Proprio in quel periodo di migrazione, la connessione tra Mosca e San Pietroburgo è caduta. Siamo rimasti effettivamente senza DNS per cinque minuti e ci siamo rialzati quando un hoster ha risolto i problemi.
Conclusioni:
Se prima trascuravamo i fattori esterni durante la preparazione ai lavori, ora li abbiamo inclusi nella lista di ciò per cui ci prepariamo. Ora ci sforziamo di avere tutti i componenti riservati a n-2, e durante i lavori possiamo abbassare questo livello a n-1.
- Durante la stesura del piano d'azione, annota i punti in cui il servizio può cadere e prevedi uno scenario in cui tutto va "peggio di così", in anticipo.
- Distribuisci i server DNS interni in diverse geolocalizzazioni/data center/rack/switch/ingressi.
- Su ciascun server, installa un server DNS locale di caching che reindirizza le richieste ai server DNS principali, e nel caso in cui non sia disponibile, risponderà dal cache.
Quarto punto — "Mettiamo in ordine Nginx"
Un bel giorno, il nostro team ha deciso che "è ora di smettere di tollerarlo", e è iniziato il processo di refactoring delle configurazioni di nginx. L'obiettivo principale è rendere le configurazioni più intuitive. Prima tutto era "storicamente consolidato" e non aveva alcuna logica. Ora ogni server_name è stato spostato in un file omonimo e tutte le configurazioni sono state distribuite in cartelle. A proposito — la configurazione contiene 253949 righe o 7836520 caratteri e occupa quasi 7 megabyte. Il livello superiore della struttura:
Struttura Nginx
├── access
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
È migliorato significativamente, ma durante il processo di rinominazione e distribuzione delle configurazioni, alcune di esse avevano estensioni errate e non sono state incluse nella direttiva include *.conf. Di conseguenza, alcuni host sono diventati non disponibili e restituivano 301 alla home page. Poiché il codice di risposta non era 5xx/4xx, non ce ne siamo accorti subito, ma solo all'alba. Dopo ciò, abbiamo iniziato a scrivere test per controllare i componenti infrastrutturali.
Conclusioni:
- Struttura correttamente le configurazioni (non solo nginx) e progetta la struttura fin dalle fasi iniziali del progetto. In questo modo, le renderai più comprensibili per il team, il che a sua volta ridurrà il Time To Market.
- Per alcuni componenti infrastrutturali scrivi dei test. Ad esempio: verifica che tutti i server_name chiave restituiscano lo stato corretto, insieme al corpo della risposta. È sufficiente avere a disposizione alcuni script che controllano le funzioni principali del componente, per non dover ricordare in modo affannoso a tre di notte cosa altro bisogna controllare.
Terzo posto – "Improvvisamente lo spazio in Cassandra è finito"
I dati sono cresciuti costantemente, e tutto andava bene fino al momento in cui nel cluster Cassandra sono iniziati a fallire i repair dei grandi keyspace, perché non può eseguire la compaction.
Un giorno di maltempo, il cluster è quasi diventato una zucca, cioè:
- c'era circa il 20% di spazio residuo complessivamente nel cluster;
- non era possibile aggiungere nodi in modo completo, poiché non passava il cleanup dopo l'aggiunta del nodo a causa della mancanza di spazio sulle partizioni;
- le prestazioni stavano lentamente diminuendo, poiché la compaction non funzionava;
- il cluster funzionava in modalità di emergenza.
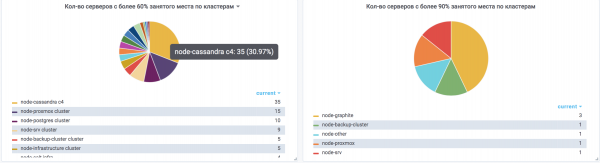
L'uscita — abbiamo aggiunto altre 5 nodi senza cleanup, dopo di che abbiamo iniziato a rimuovere progressivamente dal cluster e a reinserire, come nodi vuoti, quelli che non avevano più spazio. Il tempo impiegato è stato molto più del previsto. C'era il rischio di una parziale o totale indisponibilità del cluster.
Conclusioni:
- Su tutti i server cassandra non dovrebbe essere occupato più del 60% dello spazio su ciascuna partizione.
- Devono essere caricati non più del 50% della capacità CPU.
- Non bisogna trascurare il capacity planning e deve essere elaborato per ogni componente, in base alla sua specificità.
- Più nodi ci sono nel cluster — meglio è. I server che contengono un piccolo volume di dati si ripristinano più rapidamente, e un cluster del genere è più facile da ripristinare.
Secondo posto — «Dati scomparsi dal consul key-value storage»
Per la discovery dei servizi utilizziamo, come molti, consul. Ma il nostro key-value viene usato anche per il deployment blue-green del monolite. Qui si trova l'informazione sugli upstream attivi e inattivi, che cambiano posizione durante il deployment. È stato scritto un servizio di deployment che interagiva con KV. A un certo punto, i dati da KV sono scomparsi. Li abbiamo ripristinati dalla memoria, ma con alcuni errori. Di conseguenza, durante il deployment, il carico sugli upstream si è distribuito in modo irregolare, e abbiamo ricevuto molti errori 502 a causa del sovraccarico dei backend per CPU. Alla fine siamo passati da consul KV a postgres, da dove eliminarli non è così semplice.
Conclusioni:
- I servizi senza alcuna autorizzazione non dovrebbero contenere dati critici per il funzionamento del sito. Ad esempio, se non hai autorizzazione in ES — sarebbe meglio vietare l'accesso a livello di rete ovunque non sia necessario, mantenere solo quelli necessari e impostare action.destructive_requires_name: true.
- Testate prima il meccanismo di backup e ripristino. Ad esempio, preparate in anticipo uno script (ad esempio in python) che possa effettuare sia il backup che il ripristino.
Primo posto — «Capitano non evidente»
Ad un certo punto abbiamo notato una distribuzione irregolare del carico sugli upstream di nginx nei casi in cui c'erano più di 10 server nel backend. Poiché il round-robin inviava le richieste dall'upstream 1 fino all'ultimo in ordine, e ogni ricarica di nginx iniziava da capo, i primi upstream ricevevano sempre più richieste rispetto agli altri. Di conseguenza, funzionavano più lentamente e l'intero sito ne risentiva. Questo diventava sempre più evidente con l'aumentare del traffico. Aggiornare nginx per attivare la modalità casuale non era sufficiente: era necessario riscrivere un sacco di codice lua, che non funzionava con la versione 1.15 (in quel momento). Abbiamo dovuto patchare il nostro nginx 1.14.2, integrando il supporto random. Questo ha risolto il problema. Questo bug vince il premio per il "capitano dell'ovvietà".
Conclusioni:
È stato molto interessante e coinvolgente esplorare questo bug).
- Imposta il monitoraggio in modo da aiutarti a individuare rapidamente tali fluttuazioni. Ad esempio, puoi utilizzare ELK per monitorare l'rps di ogni backend di ciascun upstream, tenendo d'occhio i loro tempi di risposta dal punto di vista di nginx. In questo caso, ci ha aiutato a identificare il problema.
La maggior parte dei fallimenti sarebbe stata evitabile con un approccio più scrupoloso a ciò che si fa. Bisogna sempre tenere a mente la legge di Murphy: Tutto ciò che può andare storto andrà storto, e costruire i componenti seguendo questo principio.
Fonte: habr.com
