

Sono passati i giorni in cui non c'era bisogno di preoccuparsi dell'ottimizzazione delle prestazioni dei database. Il tempo non si ferma. Ogni nuovo imprenditore nel settore delle tecnologie avanzate vuole creare un nuovo Facebook, cercando di raccogliere tutti i dati a cui può accedere. Questi dati sono necessari per un migliore addestramento dei modelli, che aiutano a generare profitti. In queste condizioni, i programmatori devono creare API che consentano di lavorare in modo rapido e affidabile con enormi quantità di informazioni.
Se hai già passato un po' di tempo a progettare parti server delle applicazioni o database, probabilmente hai scritto codice per eseguire richieste con paginazione. Ad esempio, qualcosa di simile:
SELECT * FROM table_name LIMIT 10 OFFSET 40
È davvero così?
Ma se hai eseguito la paginazione in questo modo, devo con rammarico segnalare che lo hai fatto in modo tutt'altro che efficiente.
Vuoi controbattere? . , e già utilizza le tecniche di cui voglio parlare oggi.
Nomina almeno un sviluppatore backend che non abbia mai utilizzato OFFSET e LIMIT per eseguire richieste con paginazione. Nel MVP (Minimum Viable Product, prodotto minimo valido) e nei progetti in cui si utilizzano piccole quantità di dati, questo approccio è del tutto applicabile. In un certo senso, "funziona semplicemente".
Ma se è necessario creare da zero sistemi affidabili ed efficienti, è opportuno preoccuparsi in anticipo dell'efficienza nell'esecuzione delle richieste ai database utilizzati in tali sistemi.
Oggi parleremo dei problemi associati alle implementazioni ampiamente utilizzate (purtroppo è così) dei meccanismi di esecuzione delle richieste con paginazione, e di come ottenere elevate prestazioni nell'esecuzione di tali richieste.
Cosa c'è di sbagliato in OFFSET e LIMIT?
Come già detto, OFFSET e LIMIT si comportano bene nei progetti in cui non è necessario lavorare con grandi volumi di dati.
Il problema sorge quando il database cresce a tal punto da non poter più essere contenuto nella memoria del server. Ma nel corso del lavoro con questo database, è necessario utilizzare richieste con paginazione.
Affinché questo problema si manifesti, è necessario che si verifichi una situazione in cui il DBMS ricorre a un'operazione inefficace di scansione completa della tabella (Full Table Scan) durante l'esecuzione di ogni query con paginazione (mentre nel frattempo possono avvenire operazioni di inserimento e cancellazione di dati, e i dati obsoleti non ci servono!).
Cos'è la "scansione completa della tabella" (o "scansione sequenziale della tabella", Sequential Scan)? È un'operazione in cui il DBMS legge sequenzialmente ogni riga della tabella, ovvero i dati che contiene, e li verifica rispetto a una condizione specificata. È noto che questo tipo di scansione delle tabelle è il più lento. Infatti, durante la sua esecuzione si effettuano molte operazioni di input/output che coinvolgono il sistema di archiviazione del server. La situazione è aggravata dai ritardi associati alla gestione dei dati archiviati sui dischi e dal fatto che il trasferimento di dati dal disco alla memoria è un'operazione che richiede molte risorse.
Ad esempio, avete registrazioni su 100000000 utenti e state eseguendo una query con la struttura OFFSET 50000000. Questo significa che il DBMS dovrà caricare tutte queste registrazioni (e non ci servono nemmeno!), collocarle in memoria e solo dopo prendere, ad esempio, 20 risultati, come riportato in LIMIT.
Diciamo che potrebbe apparire così: "selezionare righe da 50000 a 50020 su 100000". Cioè, il sistema per eseguire la query dovrà prima caricare 50000 righe. Vedete quanta lavorazione superflua dovrà eseguire?
Se non ci credete, date un'occhiata all'esempio che ho creato utilizzando le funzionalità di .
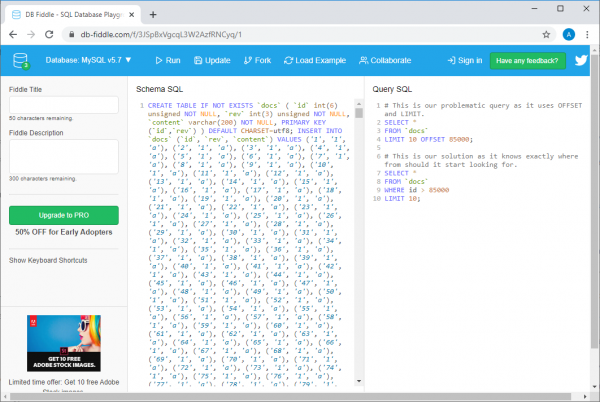
Esempio su db-fiddle.com
Lì, a sinistra, nel campo Schema SQL, c'è un codice che esegue l'inserimento nel database di 100000 righe, mentre a destra, nel campo Query SQL, sono mostrati due interrogativi. Il primo, lento, appare così:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
E il secondo, che rappresenta una soluzione efficiente dello stesso compito, è:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Per eseguire queste query, basta premere il pulsante Esegui nella parte superiore della pagina. Facendo ciò, confronteremo le informazioni sul tempo di esecuzione delle query. Risulta che per eseguire una query inefficace ci vuole, almeno, 30 volte più tempo che per eseguire la seconda (da un'esecuzione all'altra, questo tempo varia; ad esempio, il sistema può riportare che per eseguire la prima query ci sono voluti 37 ms, mentre per la seconda — 1 ms).
E se i dati fossero di più, tutto sarebbe ancora peggio (per verificarlo — dai un'occhiata al mio con 10 milioni di righe).
Quello che abbiamo appena discusso dovrebbe darti un'idea di come, in realtà, vengono elaborate le query nei database.
Tieni presente che più è alto il valore OFFSET più a lungo ci vorrà per eseguire la query.
Cosa utilizzare invece della combinazione OFFSET e LIMIT?
Invece della combinazione OFFSET e LIMIT dovresti usare una costruzione basata su questo schema:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Questo è l'esecuzione di una query con paginazione basata su cursore (Cursor based pagination).
Invece di memorizzare localmente gli attuali OFFSET e LIMIT e passarli con ogni query, è necessario memorizzare l'ultimo ID principale ricevuto (di solito è ID) e LIMIT, e così si ottengono query simili a quelle sopra.
Perché? Il motivo è che specificando esplicitamente l'identificatore dell'ultima riga letta, informi il tuo DBMS su dove deve iniziare a cercare i dati necessari. Inoltre, la ricerca, grazie all'uso di una chiave, sarà effettuata in modo efficace, senza che il sistema debba distrarsi con righe al di fuori dell'intervallo specificato.
Diamo un'occhiata al seguente confronto delle prestazioni di diverse query. Ecco una query inefficace.
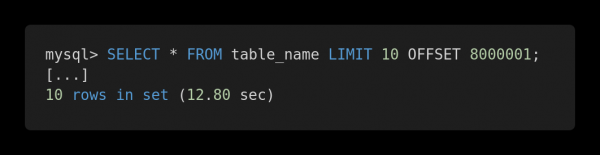
Richiesta lenta
E questa è la versione ottimizzata di questa query.
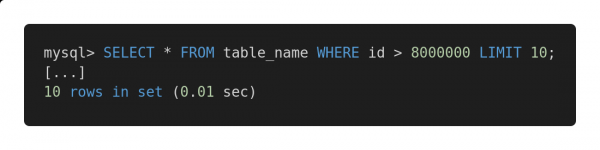
Query veloce
Entrambe le query restituiscono esattamente lo stesso volume di dati. Ma la prima richiede 12,80 secondi, mentre la seconda — 0,01 secondi. Senti la differenza?
Problemi potenziali
Per garantire il funzionamento efficace del metodo proposto per l'esecuzione delle query, è necessario che nella tabella sia presente una colonna (o colonne) contenente indici unici e sequenziali, come un identificatore intero. In alcuni casi specifici, questo può determinare il successo nell'applicazione di tali query per aumentare la velocità di lavoro con il database.
Naturalmente, nel costruire le query, è necessario tenere conto delle peculiarità dell'architettura delle tabelle e scegliere i meccanismi che si dimostrano più efficaci sulle tabelle esistenti. Ad esempio, se è necessario lavorare con grandi volumi di dati correlati nelle query, potrebbe risultarti interessante l'articolo.
Se ci troviamo di fronte al problema dell'assenza di una chiave primaria, ad esempio, se abbiamo una tabella con un rapporto "molti-a-molti", allora l'approccio tradizionale che prevede l'uso OFFSET e LIMIT, sarà garantitamente adatto a noi. Tuttavia, il suo utilizzo può portare all'esecuzione di query potenzialmente lente. In tali casi, consiglierei di utilizzare una chiave primaria con auto-incremento, anche se è necessaria solo per organizzare l'esecuzione di query con paginazione.
Se sei interessato a questo tema — , e — alcuni materiali utili.
Conclusioni
La conclusione principale che possiamo trarre è che, a prescindere dalle dimensioni dei database di cui si parla, è sempre necessario analizzare la velocità di esecuzione delle query. Al giorno d'oggi, la scalabilità delle soluzioni è estremamente importante, e se sin dall'inizio del lavoro su un certo sistema progetti tutto correttamente, questo può liberare lo sviluppatore da molti problemi in futuro.
Come analizzi e ottimizzi le query ai database?
Fonte: habr.com
