

Se gestisci un'infrastruttura virtuale basata su VMware vSphere (o su qualsiasi altra tecnologia), sicuramente sentirai spesso dagli utenti lamentele del tipo: «La macchina virtuale è lenta!». In questo ciclo di articoli analizzerò le metriche delle prestazioni e spiegherò cosa e perché «rallenta» e come risolvere il problema.
Considererò i seguenti aspetti delle prestazioni delle macchine virtuali:
- CPU,
- RAM,
- DISCO,
- Rete.
Inizierò con la CPU.
Per analizzare le prestazioni avremo bisogno di:
- Contatori delle prestazioni di vCenter – i contatori delle prestazioni, i cui grafici possono essere visualizzati tramite il vSphere Client. Le informazioni relative a questi contatori sono disponibili in qualsiasi versione del client (il client “fat” in C#, client web in Flex e client web in HTML5). In questi articoli utilizzeremo screenshot dal client C#, solo perché si vedono meglio nelle miniature :)
- ESXTOP – uno strumento che si avvia da riga di comando su ESXi. Con esso è possibile ottenere i valori dei contatori delle prestazioni in tempo reale o esportare questi valori per un certo periodo in un file .csv per ulteriori analisi. In seguito parlerò di questo strumento in modo più dettagliato e fornirò alcuni link utili alla documentazione e agli articoli sull'argomento.
Un po' di teoria
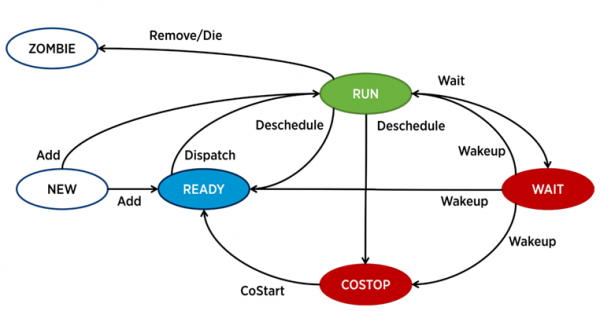
In ESXi, ogni vCPU (nucleo della macchina virtuale) è gestito da un processo separato – world nella terminologia VMware. Ci sono anche processi di servizio, ma ai fini dell'analisi delle prestazioni delle VM sono meno interessanti.
Un processo in ESXi può trovarsi in uno dei quattro stati:
- Esegui – il processo sta eseguendo un lavoro utile.
- Aspetta – il processo non sta eseguendo alcun lavoro (idle) o sta aspettando operazioni di input/output.
- Costop – uno stato che si verifica nelle macchine virtuali multicores. Esso si manifesta quando il pianificatore CPU del hypervisor (ESXi CPU Scheduler) non riesce a pianificare l'esecuzione simultanea su tutti i core fisici del server per tutti i core attivi della macchina virtuale. Nel mondo fisico, tutti i core del processore lavorano in parallelo, quindi il sistema operativo ospite all'interno della VM si aspetta un comportamento simile. Pertanto, l'hypervisor deve rallentare i core della VM che potrebbero completare il ciclo più rapidamente. Nelle versioni moderne di ESXi, il pianificatore CPU utilizza un meccanismo chiamato relaxed co-scheduling: l'hypervisor considera la deviazione tra il core virtuale più
- Pronto – il processo entra in questo stato quando l'hypervisor non è in grado di allocare risorse per la sua esecuzione. Valori elevati di ready possono causare problemi di prestazioni alla VM.
I principali contatori di prestazioni della CPU della macchina virtuale
Uso della CPU, %. Mostra la percentuale di utilizzo della CPU su un dato periodo.
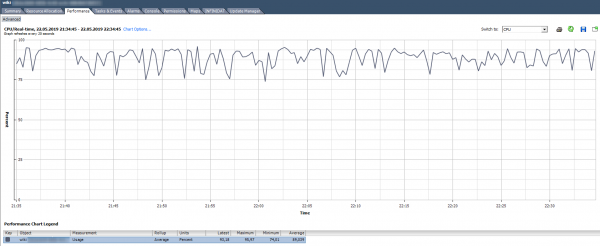
Come analizzare? Se la VM utilizza stabilmente la CPU al 90% o ci sono picchi fino al 100%, abbiamo un problema. I problemi possono manifestarsi non solo con un funzionamento 'lento' dell'applicazione all'interno della VM, ma anche con la mancanza di accesso alla VM tramite rete. Se il sistema di monitoraggio mostra che la VM si disconnette periodicamente, fai attenzione ai picchi nel grafico dell'uso della CPU.
C'è un allerta standard che mostra il carico della CPU della macchina virtuale:
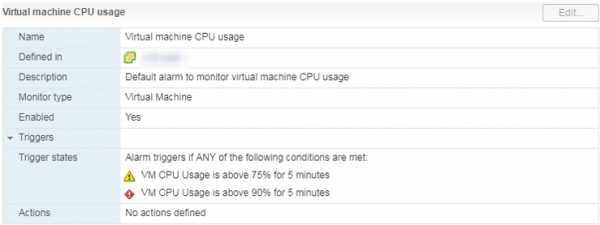
Cosa fare? Se la VM ha costantemente un utilizzo della CPU che supera le aspettative, è opportuno considerare l'aumento del numero di vCPU (sfortunatamente, ciò non sempre aiuta) o il trasferimento della VM su un server con processori più performanti.
Uso della CPU in Mhz
Nei grafici di vCenter, l'uso in % può essere visualizzato solo per l'intera macchina virtuale, mentre non ci sono grafici per singoli core (in Esxtop i valori in % per i core ci sono). Per ogni core si può vedere l'uso in MHz.
Come analizzare? Capita che l'applicazione non sia ottimizzata per un'architettura multi-core: utilizza al 100% solo un core, mentre gli altri rimangono inattivi. Ad esempio, con le impostazioni predefinite di backup, MS SQL avvia il processo solo su un core. Di conseguenza, il backup richiede tempo non a causa della lenta velocità dei dischi (è su questo che l'utente si è inizialmente lamentato), ma perché il processore non riesce a gestire il carico. Il problema è stato risolto modificando i parametri: il backup è stato avviato in parallelo in più file (di conseguenza, in più processi).
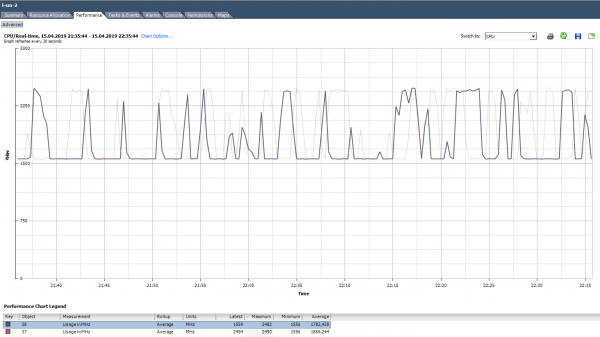
Esempio di carico non uniforme dei core.
Può anche capitare (come nel grafico sopra) che i core siano caricati in modo non uniforme e che alcuni di essi presentino picchi del 100%. Come per il caricamento di un solo core, l'allerta per l'utilizzo della CPU non scatta (è su tutta la VM), ma ci saranno problemi di prestazioni.
Cosa fare? Se il software nella macchina virtuale carica i core in modo non uniforme (utilizza solo un core o alcuni core), non ha senso aumentare il numero di core. In tal caso, è meglio spostare la VM su un server con processori più potenti.
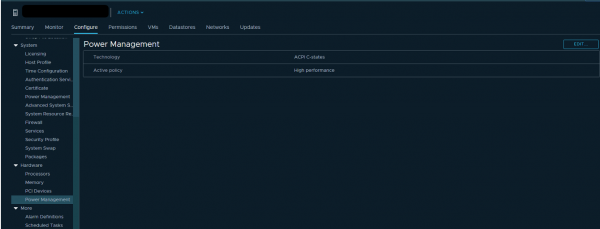
Inoltre, si può provare a controllare le impostazioni di alimentazione nel BIOS del server. Molti amministratori attivano nel BIOS la modalità High Performance disattivando le tecnologie di risparmio energetico C-states e P-states. Nei moderni processori Intel si utilizza la tecnologia Turbo Boost, che aumenta la frequenza di alcuni core del processore a scapito di altri core. Tuttavia, questa funzionalità funziona solo se le tecnologie di risparmio energetico sono attive. Se le disattiviamo, il processore non può ridurre il consumo energetico dei core che non sono sotto carico.
VMware raccomanda di non disattivare le tecnologie di risparmio energetico sui server, ma di scegliere modalità che restituiscano al hypervisor il massimo controllo sul consumo energetico. In tal modo, nelle impostazioni di alimentazione dell'hypervisor si deve scegliere la modalità High Performance.
Se nella vostra infrastruttura ci sono VM (o core di VM) che richiedono una maggiore frequenza della CPU, una corretta configurazione dell'alimentazione può migliorare significativamente le loro prestazioni.
CPU Ready (Prontezza)
Se il core della VM (vCPU) è nello stato di Ready, non sta svolgendo lavoro utile. Questo stato si verifica quando l'hypervisor non trova un core fisico libero a cui assegnare il processo vCPU della macchina virtuale.
Come analizzare? Di solito, se i core della macchina virtuale rimangono in stato di Ready per oltre il 10% del tempo, noterai problemi di prestazioni. In termini semplici, oltre il 10% del tempo la VM attende la disponibilità delle risorse fisiche.
In vCenter puoi visualizzare 2 contatori legati alla CPU Ready:
- Readiness,
- Ready.
I valori di entrambi i contatori possono essere visualizzati sia per l'intera VM che per i singoli core.
La Readiness mostra il valore immediatamente in percentuale, ma solo in tempo reale (dati dell'ultima ora, intervallo di misurazione di 20 secondi). Questo contatore è meglio utilizzato solo per la ricerca di problemi "sul momento".
I valori del contatore Ready possono essere visualizzati anche in prospettiva storica. Questo è utile per identificare schemi e fare un'analisi più approfondita del problema. Ad esempio, se una macchina virtuale inizia a riscontrare problemi di prestazioni in un certo momento, è possibile confrontare gli intervalli di valore elevato della CPU Ready con il carico complessivo del server su cui opera tale VM e adottare misure per ridurre il carico (se DRS non ha funzionato).
A differenza della Readiness, il Ready non è mostrato in percentuali, ma in millisecondi. Questo è un contatore di tipo Summation, ovvero mostra quanto tempo durante il periodo di misurazione la VM è stata in stato di Ready. È possibile convertire questo valore in percentuali con una formula semplice:
(valore di somma CPU ready / (intervallo di aggiornamento predefinito della chart in secondi * 1000)) * 100 = % CPU ready
Ad esempio, per la VM nel grafico qui sotto, il valore massimo di Ready per l'intera macchina virtuale sarà il seguente:

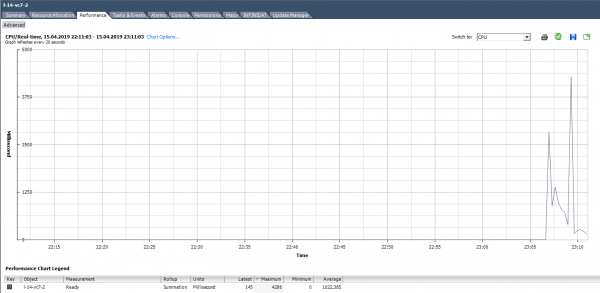
Quando si calcola il valore di Ready in percentuali, è importante prestare attenzione a due aspetti:
- Il valore di Ready per l'intera VM è la somma di Ready per i core.
- Intervallo di misurazione. Per il tempo reale, è di 20 secondi, mentre, ad esempio, nei grafici giornalieri, è di 300 secondi.
Durante il troubleshooting attivo, è facile trascurare questi semplici aspetti e spendere tempo prezioso nella risoluzione di problemi inesistenti.
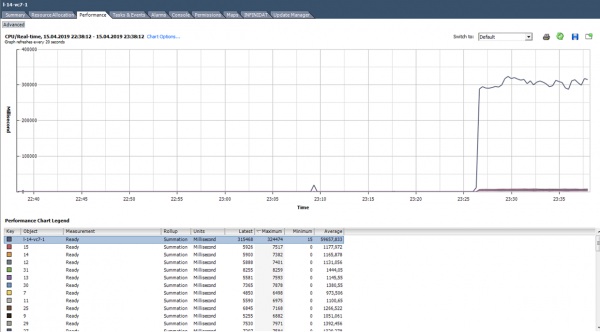
Calcoliamo il valore di Ready sulla base dei dati del grafico sottostante. (324474/(20*1000))*100 = 1622% per l'intera VM. Se consideriamo il numero di core, risulta meno allarmante: 1622/64 = 25% per core. In questo caso, rilevare un inganno è abbastanza semplice: il valore di Ready è irrealistico. Ma se si parla di un 10-20% per l'intera VM con più core, per ogni core il valore può rientrare nella norma.
Cosa fare? Un valore elevato di Ready indica che il server non ha sufficienti risorse di CPU per far funzionare correttamente le macchine virtuali. In questa situazione, l'unica soluzione è ridurre il sovraccarico della CPU (vCPU:pCPU). È ovvio che ciò può essere ottenuto riducendo i parametri delle VM esistenti o migrando parte delle VM su altri server.
Co-stop
Come analizzare? Questo contatore ha anch'esso un tipo di Somma e viene tradotto in percentuali in modo analogo a Ready:
(valore della somma co-stop CPU / (intervallo di aggiornamento predefinito del grafico in secondi * 1000)) * 100 = percentuale di co-stop CPU
Qui è necessario prestare attenzione al numero di core sulla VM e all'intervallo di misurazione.
In uno stato di co-stop, il core non svolge lavoro utile. Con una corretta selezione delle dimensioni della VM e un carico normale sul server, il contatore co-stop dovrebbe essere vicino a zero.
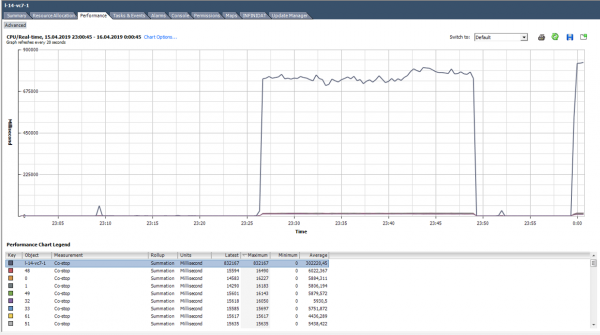
In questo caso, il carico è chiaramente anormale :)
Cosa fare? Se su un hypervisor operano più VM con un gran numero di core e c'è un sovraccarico della CPU, il contatore co-stop può aumentare, comportando problemi di prestazioni per queste VM.
Anche il co-stop aumenterà se per i core attivi di una VM vengono utilizzati thread su un solo core fisico del server con hyper-threading attivato. Questa situazione può verificarsi, ad esempio, se la VM ha più core di quanti fisicamente presenti sul server in cui opera, oppure se per la VM è abilitata l'impostazione «preferHT». Informazioni su questa impostazione possono essere lette .
Per evitare problemi di prestazioni della VM a causa di un elevato co-stop, scegliete le dimensioni della VM secondo le raccomandazioni del fornitore del software in esecuzione su questa VM e in base alle capacità del server fisico che esegue la VM.
Non aggiungete core per riserva, in quanto ciò potrebbe causare problemi di prestazioni non solo alla VM stessa, ma anche alle sue vicine sul server.
Altre metriche utili della CPU
Esegui – quanto tempo (ms) durante il periodo di misurazione la vCPU si è trovata in stato di RUN, cioè ha effettivamente eseguito lavoro utile.
Idle – quanto tempo (ms) il vCPU è stato in stato di inattività durante il periodo di misurazione. Valori elevati di Idle non sono un problema, semplicemente il vCPU non aveva «nulla da fare».
Aspetta – quanto tempo (ms) il vCPU è stato in stato di attesa durante il periodo di misurazione. Poiché in questo contatore è incluso l'IDLE, valori elevati di Wait non indicano necessariamente un problema. Tuttavia, se IDLE è basso mentre Wait è alto, significa che la VM stava aspettando il completamento delle operazioni di input/output, il che può indicare un problema con le prestazioni del disco rigido o di alcuni dispositivi virtuali della VM.
Max limitato – quanto tempo (ms) il vCPU è stato in stato di Pronto a causa di un limite impostato sulle risorse. Se le prestazioni sono inspiegabilmente basse, è utile controllare il valore di questo contatore e il limite della CPU nelle impostazioni della VM. Potrebbero essere stati impostati limiti sulla VM di cui non sei a conoscenza. Ad esempio, ciò accade quando la VM è stata clonata da un modello in cui era imposto un limite sulla CPU.
Attesa di swap – quanto tempo durante il periodo di misurazione il vCPU ha atteso operazioni con VMkernel Swap. Se i valori di questo contatore sono superiori a zero, significa sicuramente che la VM ha problemi di prestazioni. Parleremo più dettagliatamente dello SWAP nell'articolo sui contatori della memoria.
ESXTOP
Se i contatori di prestazioni in vCenter sono utili per analizzare dati storici, un'analisi operativa del problema è meglio effettuata in ESXTOP. Qui tutti i valori sono presentati in forma pronta (non è necessario tradurre nulla), e il periodo di misurazione minimo è di 2 secondi.
Lo schermo ESXTOP per CPU viene richiamato premendo il tasto «c» e appare come segue:

Per comodità, è possibile lasciare solo i processi delle macchine virtuali premendo Shift-V.
Per visualizzare le metriche per i singoli core della VM, premi «e» e inserisci il GID della VM di interesse (30919 nello screenshot qui sotto):
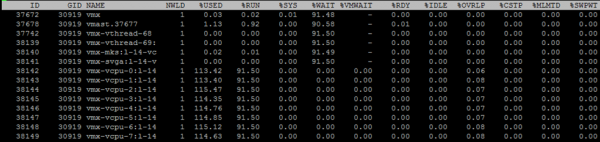
Passerò brevemente in rassegna le colonne presenti di default. Colonne aggiuntive possono essere aggiunte premendo «f».
NWLD (Numero di Mondi) – numero di processi nel gruppo. Per espandere il gruppo e vedere le metriche per ogni processo (ad esempio, per ogni core di una VM multicore), premi «e». Se nel gruppo ci sono più di un processo, i valori delle metriche per il gruppo sono pari alla somma delle metriche per i singoli processi.
%USED – quanti cicli CPU il server utilizza per il processo o il gruppo di processi.
%RUN – quanto tempo durante il periodo di misurazione il processo è stato in stato RUN, ovvero ha svolto lavoro utile. Si differenzia da %USED in quanto non tiene conto dell'hyper-threading, dello scaling della frequenza e del tempo speso per attività di sistema (%SYS).
%SYS – tempo speso per attività di sistema, ad esempio: gestione delle interruzioni, input/output, lavoro di rete, ecc. Il valore può essere alto se la VM ha un elevato input/output.
%OVRLP – quanto tempo il nucleo fisico su cui viene eseguito il processo VM ha speso per compiti di altri processi.
Queste metriche sono correlate tra loro nel seguente modo:
%USED = %RUN + %SYS — %OVRLP.
Di solito, la metrica %USED è più informativa.
%WAIT – quanto tempo durante il periodo di misurazione il processo è stato in stato Wait. Comprende IDLE.
%IDLE – quanto tempo durante il periodo di misurazione il processo è stato in stato IDLE.
%SWPWT – quanto tempo durante il periodo di misurazione la vCPU ha atteso operazioni con VMkernel Swap.
%VMWAIT – quanto tempo durante il periodo di misurazione la vCPU è stata in attesa di un evento (di solito input/output). Non esiste un contatore analogo in vCenter. Valori elevati indicano problemi di input/output sulla VM.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Se la VM non utilizza VMkernel Swap, allora nell'analisi dei problemi di prestazioni è utile osservare il %VMWAIT, poiché questa metrica non tiene conto del tempo in cui la VM non ha fatto nulla (%IDLE).
%RDY – quanto tempo durante il periodo di misurazione il processo è stato in stato Ready.
%CSTP – quanto tempo durante il periodo di misurazione il processo è stato in stato costop.
%MLMTD – quanto tempo durante il periodo di misurazione la vCPU è stata in stato Ready a causa di un limite di risorse impostato.
%WAIT + %RDY + %CSTP + %RUN = 100% – il nucleo della VM è sempre in uno di questi quattro stati.
CPU sull'iper-v
In vCenter ci sono anche contatori delle prestazioni della CPU per l'iper-v, ma non offrono nulla di interessante: sono semplicemente la somma dei contatori per tutte le VM sul server.
È più facile osservare lo stato della CPU sul server nella scheda Riepilogo:
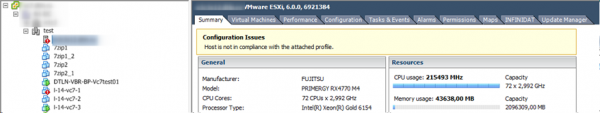
Per il server, come per la macchina virtuale, esiste un allerta standard:
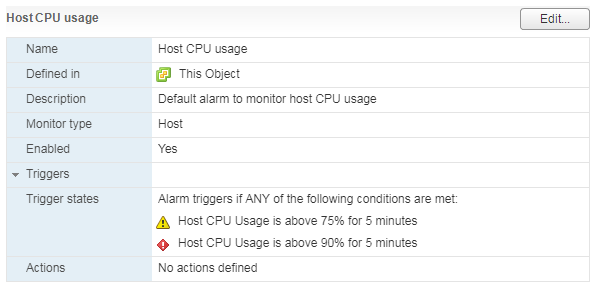
Con un alto carico sulla CPU del server, le VM che girano su di esso iniziano ad avere problemi di prestazioni.
In ESXTOP, i dati sul caricamento della CPU del server sono visualizzati nella parte superiore dello schermo. Oltre al carico standard della CPU, che è poco informativo per i hypervisor, ci sono altre tre metriche:
CORE UTIL(%) – utilizzo del core del server fisico. Questo contatore mostra quanto tempo, nel periodo di misurazione, il core ha eseguito lavoro.
PCPU UTIL(%) – se l'hyper-threading è abilitato, ogni core fisico ha due thread (PCPU) associati. Questa metrica mostra quanto tempo ogni thread ha eseguito lavoro.
PCPU USED(%) – equivalente a PCPU UTIL(%), ma tiene conto dello scaling della frequenza (riduzione della frequenza del core per risparmio energetico o aumento della frequenza del core tramite tecnologia Turbo Boost) e dell'hyper-threading.
PCPU_USED% = PCPU_UTIL% * frequenza efficace del core / frequenza nominale del core.
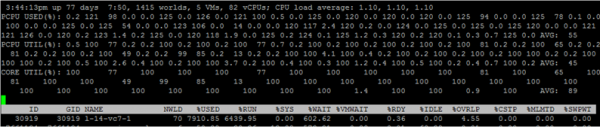
In questo screenshot, per alcuni core, a causa del funzionamento del Turbo Boost, il valore USED supera il 100%, poiché la frequenza del core è superiore a quella nominale.
Due parole su come viene considerato l'hyper-threading. Se i processi vengono eseguiti al 100% del tempo su entrambi i thread del core fisico del server, e il core funziona alla frequenza nominale, allora:
- CORE UTIL per il core sarà 100%,
- PCPU UTIL per entrambi i thread sarà 100%,
- PCPU USED per entrambi i thread sarà 50%.
Se entrambi i thread non hanno lavorato al 100% del tempo nel periodo di misurazione, nei momenti in cui i thread hanno lavorato in parallelo, PCPU USED per i core viene diviso a metà.
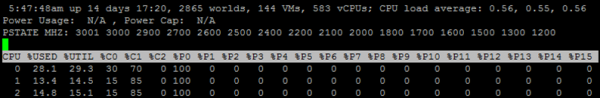
In ESXTOP c'è anche uno schermo con i parametri di consumo energetico della CPU del server. Qui puoi vedere se il server utilizza tecnologie di risparmio energetico: C-states e P-states. Attivato dal tasto «p»:
Problemi standard di prestazioni della CPU
Per finire, vorrei rivedere le ragioni tipiche delle problematiche di prestazioni della CPU delle VM e dare brevi consigli su come risolverle:
Mancanza di frequenza del core. Se non è possibile trasferire la VM a core più potenti, si può provare a modificare le impostazioni di consumo energetico per far funzionare meglio il Turbo Boost.
Misurazione errata della VM (troppi pochi/core). Se si assegnano pochi core, l'utilizzo della CPU della VM sarà elevato. Se troppi, si verificherà un alto co-stop.
Eccessiva sottoscrizione della CPU sul server. Se sulla VM c'è un alto valore di Ready, riduci la sottoscrizione della CPU.
Topologia NUMA scorretta su VM di grandi dimensioni. La topologia NUMA vista dalla VM (vNUMA) deve corrispondere alla topologia NUMA del server (pNUMA). Per la diagnostica e le possibili soluzioni a questo problema, è scritto, ad esempio, nel libro . Se non vuoi approfondire e non hai limitazioni di licenza sul sistema operativo installato sulla VM, crea sulla VM molti socket virtuali con un singolo core. Non perderai molto 🙂
Qui finisco sul CPU. Fai domande. Nella prossima parte parlerò della memoria RAM.
Link utili
Fonte: habr.com
