

Ciao a tutti! Mi chiamo Dmitrij Samsonov, lavoro come amministratore di sistema senior su "Odnoklassniki". Abbiamo più di 7.000 server fisici, 11.000 container nel nostro cloud e 200 applicazioni che, in varie configurazioni, formano 700 cluster diversi. La stragrande maggioranza dei server opera sotto CentOS 7.
Il 14 agosto 2018 è stata pubblicata un'informazione su una vulnerabilità chiamata FragmentSmack
() e SegmentSmack (). Queste sono vulnerabilità con un vettore d'attacco di rete e un punteggio piuttosto elevato (7.5), che potrebbe portare a un'interruzione del servizio (DoS) a causa dell'esaurimento delle risorse (CPU). La correzione nel kernel per FragmentSmack non era stata proposta all'epoca, oltretutto è stata rilasciata molto dopo la pubblicazione delle informazioni sulla vulnerabilità. Per correggere SegmentSmack, era consigliato aggiornare il kernel. Il pacchetto di aggiornamento è stato rilasciato lo stesso giorno, restava solo da installarlo.
No, non siamo affatto contrari all'aggiornamento del kernel! Tuttavia, ci sono delle peculiarità…
Come aggiorniamo il kernel in produzione
In realtà non è nulla di complicato:
- Scaricare i pacchetti;
- Installarli su un certo numero di server (inclusi i server che ospitano il nostro cloud);
- Assicurarci che nulla si sia rotto;
- Verificare che tutte le impostazioni standard del kernel siano state applicate senza errori;
- Aspettare qualche giorno;
- Controllare le prestazioni dei server;
- Passare al deployment di nuovi server sul nuovo kernel;
- Aggiornare tutti i server nei data center (uno alla volta, per ridurre al minimo l'impatto sugli utenti in caso di problemi);
- Riavviare tutti i server.
Ripetere per tutti i rami del kernel attualmente a nostra disposizione. Al momento sono:
- CentOS 7 stock 3.10 – per la maggior parte dei server ordinari;
- Vanilla 4.19 – per il nostro , perché abbiamo bisogno di BFQ, BBR, ecc.;
- Elrepo kernel-ml 5.2 – per , perché 4.19 in precedenza si comportava in modo instabile, mentre le funzionalità sono le stesse.
Come potreste immaginare, il maggior tempo viene impiegato per il riavvio di migliaia di server. Poiché non tutte le vulnerabilità sono critiche per tutti i server, riavviamo solo quelli accessibili direttamente da Internet. Nel cloud, per non limitare la flessibilità, non colleghiamo i contenitori accessibili dall'esterno a server specifici con un nuovo kernel, ma riavviamo tutti i host senza eccezioni. Fortunatamente, lì la procedura è più semplice rispetto ai server tradizionali. Ad esempio, i contenitori stateless possono semplicemente spostarsi su un altro server durante il riavvio.
Tuttavia, il lavoro è comunque molto e può richiedere diverse settimane, e in caso di problemi con la nuova versione, anche diversi mesi. I malintenzionati lo comprendono perfettamente, quindi è necessario un piano "B".
FragmentSmack/SgmentSmack. Workaround
Fortunatamente, per alcune vulnerabilità esiste un piano "B", chiamato Workaround. Di solito si tratta di modifiche alle impostazioni del kernel/applicazioni che consentono di minimizzare l'effetto possibile o di escludere completamente lo sfruttamento delle vulnerabilità.
Nel caso di FragmentSmack/SgmentSmack il seguente Workaround:
«Si possono modificare i valori predefiniti 4MB e 3MB in net.ipv4.ipfrag_high_thresh e net.ipv4.ipfrag_low_thresh (e i loro analoghi per ipv6 net.ipv6.ipfrag_high_thresh e net.ipv6.ipfrag_low_thresh) a 256 kB e 192 kB rispettivamente o inferiori. I test mostrano un abbassamento del consumo della CPU che va da poco a significativo durante l'attacco in base all'hardware, alle impostazioni e alle condizioni. Tuttavia, potrebbe esserci un certo impatto sulle prestazioni a causa di ipfrag_high_thresh=262144 bytes, poiché solo due frammenti da 64K possono entrare nella coda di ricomposizione contemporaneamente. Ad esempio, c'è il rischio che le applicazioni che lavorano con pacchetti UDP di grandi dimensioni si rompano.».
I parametri sono descritti come segue:
ipfrag_high_thresh - INTERO LUNGO
     Memoria massima utilizzata per riassemblare i frammenti IP.
ipfrag_low_thresh - INTERO LUNGO
     Memoria massima utilizzata per ricomporre i frammenti IP prima che il kernel
     inizi a rimuovere le code di frammenti incompleti per liberare risorse.
     Il kernel accetta ancora nuovi frammenti per la deframmentazione.
Non abbiamo servizi UDP di grandi dimensioni in produzione. Nel LAN, il traffico frammentato è assente, nel WAN c'è, ma non significativo. Nulla lo preannuncia: si può applicare il Workaround!
FragmentSmack/SgmentSmack. Prima sangue
Il primo problema che abbiamo incontrato era che i container cloud a volte applicavano solo parzialmente le nuove impostazioni (solo ipfrag_low_thresh) e talvolta non le applicavano affatto, bloccandosi all'avvio. Non siamo riusciti a riprodurre il problema in modo stabile (tutte le impostazioni venivano applicate senza alcuna difficoltà manualmente). Capire perché un container si blocca all'avvio non è nemmeno semplice: non sono stati trovati errori. Una cosa era certa: tornare alle impostazioni precedenti risolveva il problema dei container che si bloccavano.
Perché non è sufficiente applicare Sysctl sull'host? Il container vive nel proprio Namespace di rete dedicato, quindi almeno nel container potrebbe differire da quelli dell'host.
Come vengono applicate le impostazioni Sysctl nel container? Poiché i nostri container sono non privilegiati, non è possibile modificare alcuna impostazione Sysctl accedendo al container stesso: non ci sono diritti sufficienti. Per avviare i container, il nostro cloud utilizzava a quel tempo Docker (ora già ). I parametri del nuovo container, comprese le impostazioni Sysctl necessarie, venivano passati a Docker tramite l'API.
Durante il controllo delle versioni, è emerso che l'API di Docker non restituiva tutti gli errori (almeno nella versione 1.10). Quando abbiamo cercato di avviare il container tramite “docker run”, abbiamo finalmente visto qualcosa:
write /proc/sys/net/ipv4/ipfrag_high_thresh: argomento non valido docker: Risposta di errore dal demone: Impossibile avviare il container : [9] Errore di sistema: impossibile sincronizzarsi con il processo del container.
Il valore del parametro non è valido. Ma perché? E perché non è valido solo a volte? È emerso che Docker non garantisce l'ordine di applicazione dei parametri Sysctl (l'ultima versione controllata è la 1.13.1), quindi a volte ipfrag_high_thresh cercava di impostarsi su 256K, mentre ipfrag_low_thresh era ancora a 3M, il che significa che il limite superiore era al di sotto di quello inferiore, causando l'errore.
A quel tempo avevamo già un nostro meccanismo di riconfigurazione del container dopo l'avvio (sospensione del container tramite e esecuzione di comandi nel namespace del container tramite ), e abbiamo aggiunto in questa parte anche l'impostazione dei parametri Sysctl. Il problema è stato risolto.
FragmentSmack/SegmentSmack. Prima il sangue 2
Non abbiamo fatto in tempo a capire l'applicazione del Workaround nel cloud che sono arrivate le prime rare segnalazioni dagli utenti. A quel punto erano passate alcune settimane dall'inizio dell'applicazione del Workaround sui primi server. Le indagini preliminari hanno mostrato che le segnalazioni riguardavano determinati servizi, e non tutti i server di questi servizi. Il problema ha ripreso un carattere estremamente indefinito.
Innanzitutto, abbiamo cercato di ripristinare le impostazioni di Sysctl, ma questo non ha dato alcun effetto. Varie manovre sulle impostazioni del server e dell'applicazione non hanno aiutato. Un riavvio ha risolto la situazione. Riavviare per Linux è tanto innaturale quanto era una condizione normale per lavorare con Windows nei tempi passati. Tuttavia, ha funzionato e abbiamo attribuito tutto a un 'bug nel kernel' con le nuove impostazioni in Sysctl. Che leggerezza...
Dopo tre settimane, il problema si è ripresentato. La configurazione di questi server era piuttosto semplice: Nginx in modalità proxy/balancer. Il traffico era ridotto. Nuovo aspetto: il numero di errori 504 sui client aumentava di giorno in giorno (). Nel grafico è mostrato il numero di errori 504 al giorno per questo servizio:
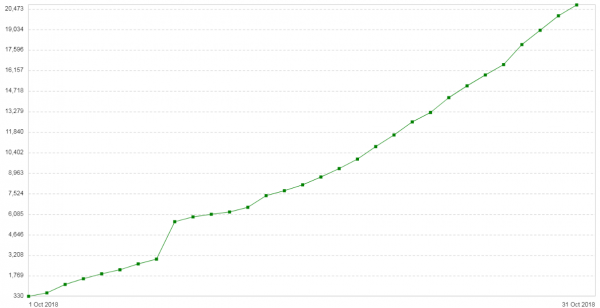
Tutti gli errori riguardano lo stesso backend — quello situato nel cloud. Il grafico del consumo di memoria per i frammenti dei pacchetti su questo backend appariva come segue:
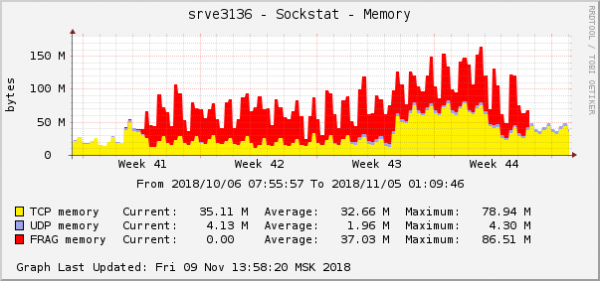
Questa è una delle manifestazioni più evidenti del problema nei grafici del sistema operativo. Proprio in quel periodo, nel cloud è stata risolta un'altra problematica di rete riguardante le impostazioni di QoS (Traffic Control). Il grafico del consumo di memoria per i frammenti dei pacchetti appariva esattamente come questo:
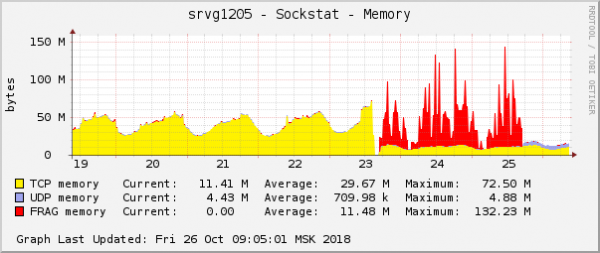
L'ipotesi era semplice: se nei grafici sembrano identici, anche la causa è la stessa. Tant'è che problemi con questo tipo di memoria si verificano estremamente raramente.
La sostanza del problema risolto era che stavamo utilizzando nel QoS lo scheduler di pacchetti fq con impostazioni predefinite. Di default consente di aggiungere in coda 100 pacchetti per una singola connessione e alcune connessioni, in situazioni di scarsità della banda, hanno iniziato a riempire la coda fino all'inceppamento. In questo caso i pacchetti vengono scartati. Nelle statistiche tc (tc -s qdisc) questo si vede in questo modo:
qdisc fq 2c6c: genitore 1:2c6c limite 10000p flow_limit 100p bucket 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Inviati 454701676345 byte 491683359 pkt (persi 464545, oltre limiti 0 riaggiustamenti 0)
  backlog 0b 0p riaggiustamenti 0
   1024 flussi (1021 inattivi, 0 limitati)
   0 gc, 0 alta priorità, 0 limitati, 464545 flussi_plimit
«464545 flows_plimit» è il numero di pacchetti scartati a causa del superamento del limite della coda di una connessione, mentre «dropped 464545» è la somma di tutti i pacchetti scartati di questo scheduler. Dopo aver aumentato la lunghezza della coda a 1.000 e riavviato i contenitori, il problema ha smesso di manifestarsi. Ora possiamo rilassarci e bere un frullato.
FragmentSmack/SemgmentSmack. Ultima goccia di sangue
Innanzitutto, dopo alcuni mesi dall'annuncio delle vulnerabilità nel kernel, finalmente è stato rilasciato un fix per FragmentSmack (ricordo che insieme all'annuncio di agosto era uscito solo un fix per SegmentSmack), dando la possibilità di abbandonare il workaround che ci ha causato parecchi disagi. Nel frattempo, abbiamo già aggiornato alcune macchine al nuovo kernel, quindi dovevamo ricominciare da capo. Perché abbiamo aggiornato il kernel senza aspettare il fix per FragmentSmack? Il motivo è che il processo di protezione da queste vulnerabilità si è sovrapposto (e fuso) con il processo di aggiornamento di CentOS stesso (che richiede ancora più tempo rispetto all'aggiornamento del solo kernel). Inoltre, SegmentSmack è una vulnerabilità più pericolosa, e il fix per essa è arrivato immediatamente, quindi valeva la pena farlo in ogni caso. Tuttavia, non potevamo semplicemente aggiornare il kernel su CentOS, perché la vulnerabilità FragmentSmack, emersa con CentOS 7.5, è stata corretta solo nella versione 7.6; quindi ci siamo dovuti fermare per aggiornare a 7.5 e iniziare tutto da capo aggiornando a 7.6. È successo anche questo.
In secondo luogo, ci sono tornate rare segnalazioni di utenti su problemi. Ora sappiamo con certezza che tutte sono collegate all'upload di file dai clienti su alcuni dei nostri server. E dobbiamo notare che attraverso questi server c'era un numero molto ristretto di upload rispetto al totale.
Come ricordiamo dal racconto precedente, il rollback di Sysctl non ha aiutato. Ci ha aiutato riavviare, ma solo temporaneamente.
I sospetti su Sysctl non erano stati completamente fugati, ma questa volta era necessario raccogliere quante più informazioni possibile. Inoltre, ci mancava estremamente la possibilità di riprodurre il problema di upload dal lato del cliente, per poter studiare più nel dettaglio ciò che stava accadendo.
L'analisi di tutte le statistiche e dei log disponibili non ci ha avvicinato alla comprensione di quanto stesse accadendo. Manca severamente la possibilità di riprodurre il problema, per poter 'toccare' una connessione specifica. Finalmente, agli sviluppatori su una versione speciale dell'applicazione è riuscito ottenere una riproduzione stabile dei problemi su un dispositivo di test quando collegato tramite Wi-Fi. Questo è stato un passo avanti nell'indagine. Il cliente si collegava a Nginx, che a sua volta inoltrava al backend, che era la nostra applicazione Java.
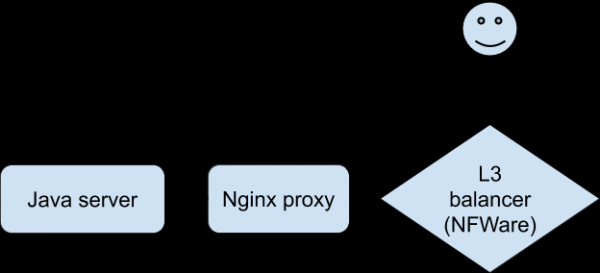
Il dialogo durante i problemi era il seguente (registrato dal lato del proxy Nginx):
- Cliente: richiesta di informazioni sul download del file.
- Server Java: risposta.
- Cliente: POST con file.
- Server Java: errore.
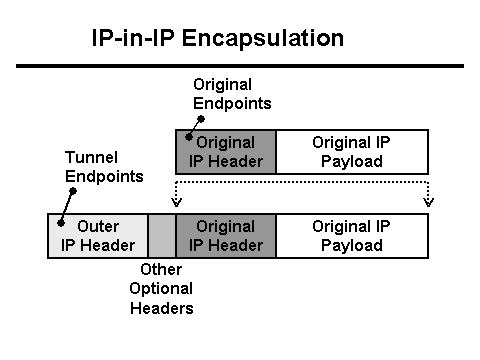
Il server Java scrive nel log che ha ricevuto 0 byte di dati dal cliente, mentre il proxy Nginx indica che la richiesta ha impiegato più di 30 secondi (30 secondi è il tempo di timeout per l'applicazione client). Perché quindi il timeout e perché 0 byte? Dal punto di vista di HTTP tutto funziona come dovrebbe, ma il POST con il file sembra scomparire dalla rete. Infatti, scompare tra il cliente e Nginx. È tempo di armarsi di Tcpdump! Ma prima dobbiamo comprendere la configurazione della rete. Il proxy Nginx si trova dietro un bilanciatore L3. . Viene utilizzato il tunneling per la consegna dei pacchetti dal bilanciatore L3 al server, il quale aggiunge le proprie intestazioni ai pacchetti:
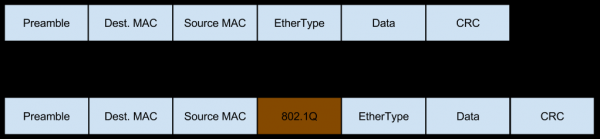
Inoltre, il traffico a questo server arriva come traffico VLAN tagging, che aggiunge anch'esso i propri campi ai pacchetti:
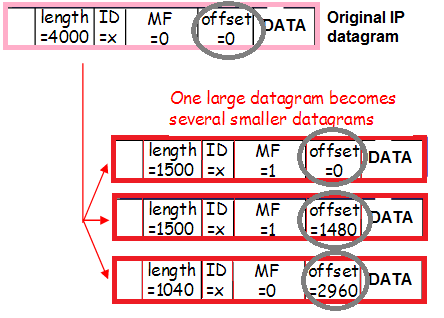
E questo traffico può anche essere frammentato (quella piccola percentuale di traffico in ingresso frammentato di cui parlavamo nella valutazione dei rischi da Workaround), il che cambia anche il contenuto delle intestazioni:
Ancora una volta: i pacchetti sono incapsulati con un tag VLAN, incapsulati in un tunnel, frammentati. Per comprendere meglio come avviene ciò, seguiamo il percorso di un pacchetto dal cliente al proxy Nginx.
- Il pacchetto arriva al bilanciatore L3. Per una corretta instradamento all'interno del data center, il pacchetto viene incapsulato in un tunnel e inviato alla scheda di rete.
- Poiché il pacchetto + intestazioni del tunnel non rientrano nell'MTU, il pacchetto viene suddiviso in frammenti e inviato nella rete.
- Lo switch dopo il bilanciatore L3, al ricevimento del pacchetto, aggiunge un tag VLAN e lo invia oltre.
- Lo switch davanti al proxy Nginx vede (in base alle impostazioni della porta) che il server si aspetta un pacchetto incapsulato in Vlan, quindi lo invia così com'è, senza rimuovere il tag Vlan.
- Linux riceve frammenti di singoli pacchetti e li unisce in un grande pacchetto.
- Il pacchetto successivo entra nell'interfaccia Vlan, dove viene rimosso il primo strato: l'incapsulamento Vlan.
- Poi Linux lo invia all'interfaccia Tunnel, dove viene rimosso un altro strato: l'incapsulamento Tunnel.
La difficoltà sta nel trasmettere tutto ciò come parametri a tcpdump.
Iniziamo dalla fine: ci sono pacchetti IP puri (senza intestazioni superflue) dai client, con l'incapsulamento vlan e tunnel rimosso?
tcpdump host
No, non ci sono stati pacchetti di quel tipo sul server. Pertanto, il problema deve trovarsi prima. Ci sono pacchetti con solo l'incapsulamento Vlan rimosso?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx è l'indirizzo IP del client in formato esadecimale.
32:4 è l'indirizzo e la lunghezza del campo in cui è registrato l'IP SCR nel pacchetto Tunnel.
L'indirizzo del campo è stato trovato per tentativi, poiché in rete si parla di 40, 44, 50, 54, ma non c'erano indirizzi IP lì. Puoi anche guardare uno dei pacchetti in esadecimale (parametro -xx o -XX in tcpdump) e contare a quale indirizzo corrisponde l'IP a te noto.
Ci sono frammenti di pacchetti senza l'incapsulamento Vlan e Tunnel rimossi?
tcpdump ((ip[6:2] > 0) e (non ip[6] = 64))
Questa magia ci mostrerà tutti i frammenti, incluso l'ultimo. Probabilmente, lo stesso può essere filtrato per IP, ma non ho provato, poiché non ci sono molti pacchetti di quel tipo e nel flusso generale ho facilmente trovato quello che mi serviva. Eccoli:
14:02:58.471063 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), lunghezza 1516: (tos 0x0, ttl 63, id 53652, offset 0, flags [+], proto IPIP (4), lunghezza 1500)
     11.11.11.11 > 22.22.22.22: ip-troncato - 20 byte mancanti! (tos 0x0, ttl 50, id 57750, offset 0, flags [DF], proto TCP (6), lunghezza 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.], seq 0:1448, ack 1, win 343, opzioni [nop,nop,TS val 11660691 ecr 2998165860], lunghezza 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 In 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), lunghezza 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), lunghezza 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Questi sono due frammenti di un pacchetto (ID identico 53652) con fotografia (si vede la parola Exif nel primo pacchetto). Poiché a questo livello i pacchetti ci sono, mentre nella versione unita nei dump non ci sono, il problema è chiaramente nella ricomposizione. Finalmente c'è una conferma documentale di ciò!
Il decodificatore dei pacchetti non ha trovato problemi che impedissero la ricomposizione. Ho provato qui: . All'inizio, tentando di inserire qualcosa, al decoder non piaceva il formato del pacchetto. Si è scoperto che c'erano due ottetti extra tra Srcmac ed Ethertype (non relativi alle informazioni sui frammenti). Dopo la loro rimozione, il decoder ha iniziato a funzionare. Tuttavia, non ha mostrato alcun problema.
In fin dei conti, oltre a quei Sysctl, non si è trovato nient'altro. Resta da trovare un modo per identificare i server problematici, per comprendere l'entità e prendere decisioni sulle azioni future. È stato relativamente facile trovare il contatore necessario:
netstat -s | grep "packet reassembles failed"
È presente anche in snmpd sotto OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«Il numero di fallimenti rilevati dall'algoritmo di riunificazione IP (per qualsiasi motivo: timeout, errori, ecc.)».
Tra il gruppo di server su cui è stato studiato il problema, su due questo contatore aumentava più rapidamente, su due più lentamente, e su altri due non aumentava affatto. Il confronto della dinamica di questo contatore con la dinamica degli errori HTTP sul server Java ha rivelato una correlazione. In altre parole, il contatore poteva essere inserito nel monitoraggio.
Avere un indicatore affidabile dei problemi è molto importante, per capire se il rollback del Sysctl ha avuto effetto, poiché da quanto detto in precedenza sappiamo che non è possibile capirlo immediatamente dall'applicazione. Questo indicatore permetterebbe di identificare tutti i punti critici in produzione prima che gli utenti se ne accorgano.
Dopo il rollback del Sysctl, gli errori di monitoraggio sono cessati, dimostrando così che la causa dei problemi era stata accertata, così come che il rollback è stato utile.
Abbiamo ripristinato le impostazioni di frammentazione su altri server, dove era stato avviato un nuovo monitoraggio, e in alcuni casi abbiamo anche allocato più memoria per i frammenti rispetto a quanto fosse stato impostato di default prima (si trattava di statistiche udp, la cui perdita parziale non era evidente nel contesto generale).
Le domande principali
Perché i pacchetti vengono frammentati sul nostro bilanciatore L3? La maggior parte dei pacchetti che arrivano dagli utenti ai bilanciatori sono SYN e ACK. Le dimensioni di questi pacchetti sono piccole. Ma poiché la quota di tali pacchetti è molto alta, non abbiamo notato l'esistenza di pacchetti più grandi che sono stati frammentati.
La causa è stato uno script di configurazione malfunzionante su server con interfacce Vlan (in quel momento in produzione c'erano pochissimi server con traffico etichettato). Advmss consente di comunicare al cliente che i pacchetti nella nostra direzione devono essere di dimensioni più piccole, in modo che, dopo l'aggiunta degli header del tunnel, non sia necessario frammentarli.
Perché il rollback di Sysctl non ha funzionato, mentre il reboot ha funzionato? Il rollback di Sysctl modificava la quantità di memoria disponibile per unire i pacchetti. A quanto pare, il semplice fatto che la memoria per i frammenti fosse piena portava a rallentamenti nelle connessioni, causando ritardi prolungati dei frammenti nella coda. Insomma, il processo si bloccava.
Il reboot azzerava la memoria e tutto tornava in ordine.
Si poteva fare a meno del Workaround? Sì, ma c'era un alto rischio di lasciare gli utenti senza assistenza in caso di attacco. Certo, l'applicazione del Workaround ha portato a vari problemi, tra cui il rallentamento di uno dei servizi per gli utenti, ma riteniamo comunque che le azioni siano state giustificate.
Un grande ringraziamento ad Andrey Timofeev () per l'aiuto nelle indagini, e anche ad Alexey Krenyev () — per il lavoro titanico di aggiornamento di Centos e dei kernel sui server. Un processo che in questo caso è stato più volte ripreso dall'inizio, allungandosi per molti mesi.
Fonte: habr.com
