

Le professioni di Data Scientist e Data Engineer vengono spesso confuse. Ogni azienda ha la propria specificità nella gestione dei dati, obiettivi di analisi diversi e una propria visione su quale specialista debba occuparsi di quali aspetti del lavoro, pertanto ogni azienda ha le proprie esigenze.
Analizziamo qual è la differenza tra questi specialisti, quali problemi aziendali risolvono, quali competenze possiedono e quale sia il loro stipendio. Il materiale è piuttosto ampio, quindi lo abbiamo diviso in due pubblicazioni.
Nel primo articolo, Elena Gerasimova, direttrice del dipartimento "" di Netology, spiega qual è la differenza tra Data Scientist e Data Engineer e con quali strumenti lavorano.
Come si differenziano i ruoli degli ingegneri e dei scientist
L'ingegnere dei dati è uno specialista che, da un lato, sviluppa, testa e mantiene l'infrastruttura per la gestione dei dati: database, archiviazione e sistemi di elaborazione di massa. D'altro canto, è colui che pulisce e 'pulisce' i dati per l'uso da parte di analisti e data scientist, ovvero crea pipeline di elaborazione dei dati.
Il Data Scientist crea e addestra modelli predittivi (e non solo) utilizzando algoritmi di machine learning e reti neurali, aiutando le aziende a trovare schemi nascosti, prevedere l'evoluzione degli eventi e ottimizzare i processi aziendali chiave.
La principale differenza tra Data Scientist e Data Engineer è che di solito hanno obiettivi diversi. Entrambi lavorano affinché i dati siano accessibili e di qualità. Ma il Data Scientist cerca risposte alle proprie domande e verifica le ipotesi nell'ecosistema dei dati (ad esempio, su una base Hadoop), mentre il Data Engineer crea la pipeline per il supporto dell'algoritmo di machine learning sviluppato dal data scientist, all'interno di un cluster Spark nello stesso ecosistema.
L'ingegnere dei dati porta valore all'azienda lavorando in squadra. Il suo compito è quello di fungere da anello importante tra i vari partecipanti: dagli sviluppatori agli utilizzatori aziendali dei report, aumentando la produttività degli analisti — da quelli di marketing e prodotto a quelli di BI.
Il Data Scientist, al contrario, partecipa attivamente alla strategia aziendale e all'estrazione di intuizioni, nel processo decisionale, nell'implementazione di algoritmi di automazione, modellazione e generazione di valore dai dati.
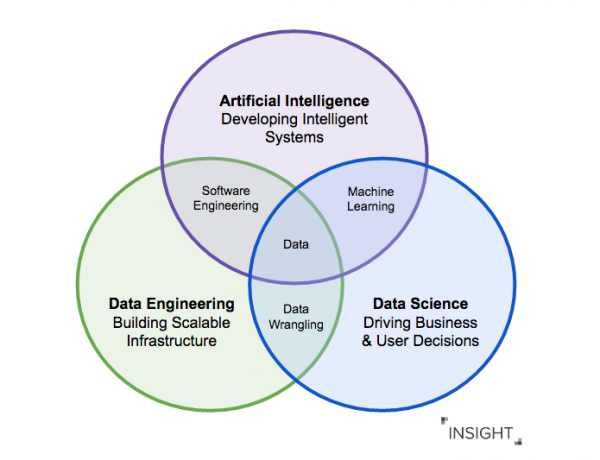
Il lavoro con i dati è soggetto al principio GIGO (garbage in — garbage out): se gli analisti e i data scientist si confrontano con dati non preparati e potenzialmente non corretti, i risultati, anche utilizzando gli algoritmi di analisi più sofisticati, saranno errati.
Gli ingegneri dei dati risolvono questo problema costruendo pipeline per l'elaborazione, la pulizia e la trasformazione dei dati, consentendo ai data scientist di lavorare già con dati di qualità.
Sul mercato esistono molti strumenti per lavorare con i dati, che coprono ognuna delle fasi: dall'emergere dei dati all'output su un dashboard per il consiglio di amministrazione. È importante che la decisione di utilizzarli sia presa dall'ingegnere, non perché sia di moda, ma perché realmente aiuterà gli altri partecipanti al processo nel loro lavoro.
Condizionatamente: se l'azienda ha bisogno di integrare BI ed ETL — il caricamento dei dati e gli aggiornamenti dei report, ecco un tipico fondamento legacy con cui dovrà confrontarsi l'ingegnere dei dati (è positivo se nel team ci sarà anche un architetto).
Responsabilità dell'ingegnere dei dati
- Progettazione, costruzione e manutenzione dell'infrastruttura per il lavoro con i dati.
- Gestione degli errori e creazione di pipeline di elaborazione dei dati affidabili.
- Adattare i dati non strutturati provenienti da diverse fonti dinamiche nella forma necessaria per il lavoro degli analisti.
- Fornire raccomandazioni per migliorare la coerenza e la qualità dei dati.
- Garantire e supportare l'architettura dei dati utilizzata dai data scientist e dagli analisti.
- Elaborare e memorizzare i dati in modo sequenziale ed efficiente in un cluster distribuito su decine o centinaia di server.
- Valutare i compromessi tecnici degli strumenti per creare architetture semplici ma affidabili, in grado di resistere ai guasti.
- Controllo e supporto dei flussi di dati e dei sistemi correlati (configurazione del monitoraggio e degli avvisi).
Esiste un'altra specializzazione all'interno della traiettoria dell'ingegnere dei dati — l'ingegnere ML. In breve, questi ingegneri si specializzano nell'implementazione di modelli di machine learning per l'uso industriale. Spesso il modello fornito dal data scientist è parte di una ricerca e potrebbe non funzionare in condizioni operative.
Responsabilità del data scientist
- Estrazione delle caratteristiche dai dati per l'applicazione di algoritmi di machine learning.
- Utilizzo di diversi strumenti di apprendimento automatico per la previsione e la classificazione dei modelli nei dati.
- Aumento delle prestazioni e della precisione degli algoritmi di apprendimento automatico attraverso la sintonizzazione fine e l'ottimizzazione degli algoritmi.
- Formulazione di «forti» ipotesi secondo la strategia aziendale, che devono essere verificate.
Sia il Data Engineer che il Data Scientist condividono un contributo tangibile allo sviluppo della cultura del lavoro con i dati, attraverso la quale l'azienda può ottenere profitti aggiuntivi o ridurre i costi.
Con quali linguaggi e strumenti lavorano ingegneri e data scientist
Oggi, le aspettative nei confronti degli specialisti nella gestione dei dati sono cambiate. In passato, gli ingegneri scrivevano grandi query SQL, scrivevano manualmente MapReduce e gestivano i dati utilizzando strumenti come Informatica ETL, Pentaho ETL, Talend.
Nel 2020, uno specialista non può fare a meno della conoscenza di Python e degli strumenti moderni per l'esecuzione dei calcoli (ad esempio, Airflow), della comprensione dei principi di lavoro con le piattaforme cloud (utilizzandole per risparmiare sull'hardware, rispettando i principi di sicurezza).
SAP, Oracle, MySQL, Redis sono strumenti tradizionali per un ingegnere dei dati nelle grandi aziende. Sono validi, ma il costo delle licenze è così elevato che ha senso imparare a lavorare con essi solo in progetti industriali. Tuttavia, esiste un'alternativa gratuita in Postgres: è gratuito e adatto non solo per l'apprendimento.
Storicamente, c'è stata spesso richiesta di Java e Scala, sebbene, con l'evoluzione delle tecnologie e degli approcci, questi linguaggi stiano venendo messi in secondo piano.
Tuttavia, il BigData hardcore: Hadoop, Spark e il restante zoo non sono più una condizione necessaria per un ingegnere dei dati, ma una varietà di strumenti per affrontare problemi che non possono essere risolti tramite ETL tradizionali.
Tendenze sono i servizi per l'utilizzo di strumenti senza la conoscenza del linguaggio in cui sono scritti (ad esempio, Hadoop senza conoscenza di Java), nonché la fornitura di servizi pronti per l'elaborazione dei dati in streaming (riconoscimento vocale o immagini nei video).
Le soluzioni industriali di SAS e SPSS sono popolari, mentre Tableau, Rapidminer, Stata e Julia sono ampiamente utilizzati dai data scientist per compiti locali.
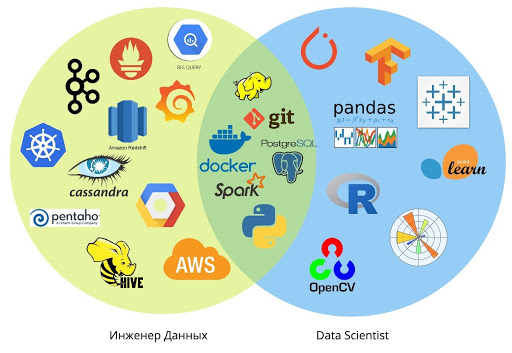
La possibilità di costruire pipeline da soli è emersa per gli analyst e i data scientist solo pochi anni fa: ad esempio, ora è possibile indirizzare i dati in uno storage basato su PostgreSQL con script relativamente semplici.
Di solito, l'utilizzo di pipeline e strutture dati integrate è di competenza dei data engineer. Ma oggi, più che mai, è forte il trend verso professionisti a forma di T — con competenze ampie in ambiti correlati, poiché gli strumenti si stanno semplificando continuamente.
Perché Data Engineer e Data Scientist devono lavorare insieme
Lavorando a stretto contatto con gli ingegneri, i Data Scientist possono concentrarsi sulla parte di ricerca, creando algoritmi di machine learning pronti all'uso.
E gli ingegneri — focalizzarsi sulla scalabilità, sul riutilizzo dei dati e garantire che le pipeline di input e output dei dati in ogni singolo progetto siano conformi all'architettura globale.
Questa suddivisione delle responsabilità assicura coerenza nelle azioni tra i gruppi di specialisti che lavorano su diversi progetti di machine learning.
La collaborazione aiuta a creare nuovi prodotti in modo efficace. La velocità e la qualità sono raggiunte grazie a un equilibrio tra la creazione di servizi per tutti (storage globale o integrazione di dashboard) e la realizzazione di ogni specifica esigenza o progetto (pipeline specializzate, integrazione di fonti esterne).
Un lavoro stretto con i data scientist e gli analyst aiuta gli ingegneri a sviluppare abilità analitiche e di ricerca per scrivere codice di qualità superiore. Migliora lo scambio di conoscenze tra gli utenti di storage e data lake, rendendo i progetti più flessibili e garantendo risultati a lungo termine più solidi.
Nelle aziende che puntano a sviluppare una cultura data-driven e costruire processi aziendali su di essa, i Data Scientist e i Data Engineer si completano a vicenda e creano un sistema di analisi dei dati completo.
Nel prossimo articolo parleremo di quale formazione deve avere un Data Engineer e un Data Scientist, quali competenze devono sviluppare e come è strutturato il mercato.
Dalla redazione di Netology
Se stai considerando la professione di Data Engineer o Data Scientist, ti invitiamo a esplorare i programmi dei nostri corsi:
- Professione «».
- Professione «».
Fonte: habr.com
