

Il tema dei gravi incidenti nei moderni data center solleva domande a cui non sono state date risposte nel primo articolo: abbiamo deciso di espanderlo.
Se crediamo alle statistiche dell'Uptime Institute, la maggior parte degli incidenti nei data center è correlata a guasti del sistema di alimentazione elettrica, che rappresenta il 39% degli eventi. Segue il fattore umano, con un ulteriore 24% di incidenti. La terza causa più significativa (15%) è stata rappresentata dai guasti del sistema di condizionamento, mentre al quarto posto (12%) si sono piazzati i disastri naturali. La quota complessiva di altri problemi è solo del 10%. Senza mettere in dubbio i dati di un'organizzazione rispettabile, evidenziamo ciò che possono avere in comune diversi incidenti e cerchiamo di capire se potessero essere evitati. Spoiler: nella maggior parte dei casi, sì.
La scienza dei contatti.
Parlando in modo semplificato, ci sono sostanzialmente due problemi con l'alimentazione: o il contatto è assente dove dovrebbe essere, o è presente dove non dovrebbe esserci. Ci si può dilungare a discutere sull'affidabilità dei moderni sistemi di alimentazione ininterrotta, ma non sempre si rivelano efficaci. Prendiamo ad esempio il famoso caso del data center utilizzato da British Airways, di proprietà della casa madre International Airlines Group. Nei pressi dell'aeroporto di Heathrow si trovano due di questi centri: Boadicea House e Comet House. Nel primo, il 27 maggio 2017 si è verificata una disconnessione accidentale dell'alimentazione, che ha portato a un sovraccarico e al guasto del sistema UPS. Di conseguenza, parte delle attrezzature IT è stata danneggiata fisicamente, e ci sono voluti tre giorni per risolvere l'ultimo problema.
Le compagnie aeree sono state costrette ad annullare o posticipare oltre mille voli, circa 75 mila passeggeri non sono riusciti a partire in tempo - per il pagamento delle indennità sono stati spesi 128 milioni di dollari, senza contare le spese necessarie per ripristinare l'operatività dei data center. La storia sulle cause del blackout non è chiara. Se si credono ai risultati dell'indagine interna annunciati dal CEO di International Airlines Group Willie Walsh, è avvenuto a causa di un errore degli ingegneri. Tuttavia, il sistema di alimentazione ininterrotta avrebbe dovuto sopportare tale interruzione - è proprio per questo che è stato installato. I centri di gestione dati erano gestiti da specialisti della società di outsourcing CBRE Managed Services, quindi British Airways ha cercato di recuperare l'importo dei danni tramite il tribunale di Londra.
Gli incidenti legati all'alimentazione elettrica si verificano secondo scenari simili: prima c'è l'interruzione per colpa del fornitore di energia elettrica, talvolta a causa di cattive condizioni atmosferiche o problemi interni (inclusi errori del personale), e poi il sistema di alimentazione ininterrotta non riesce a far fronte al carico oppure un'interruzione temporanea della sinusoidale provoca il malfunzionamento di numerosi servizi, il cui ripristino richiede molto tempo e denaro. È possibile evitare incidenti simili? Certamente. Se si progetta il sistema correttamente, tuttavia anche i creatori di grandi data center non sono immuni dagli errori.
Fattore umano
Quando la causa diretta dell'incidente è costituita da azioni errate del personale del data center, i problemi colpiscono più spesso (ma non sempre) la parte software dell'infrastruttura IT. Tali incidenti si verificano anche nelle grandi corporation. Nel febbraio 2017, a causa di un comando errato inserito da un membro del gruppo di supporto tecnico di uno dei data center, è stata disattivata una parte dei server Amazon Web Services. L'errore si è verificato durante il debug del processo di fatturazione per i clienti dello storage cloud Amazon Simple Storage Service (S3). L'impiegato stava cercando di rimuovere un certo numero di server virtuali utilizzati dal sistema di fatturazione, ma ha colpito un cluster di dimensioni maggiori.
A causa di un errore dell'ingegnere, sono stati rimossi i server su cui erano in esecuzione importanti moduli software dell'archivio cloud di Amazon. In particolare, è stata compromessa la sottosistema di indicizzazione, che conteneva informazioni sui metadati e sulla posizione di tutti gli oggetti S3 nella regione americana US-EAST-1. L'incidente ha colpito anche la sottosistema utilizzata per l'archiviazione dei dati e la gestione dello spazio disponibile per la memorizzazione. Dopo la rimozione delle macchine virtuali, queste due sottosistemi hanno richiesto un riavvio completo e per gli ingegneri di Amazon c'è stata una sorpresa: per un periodo prolungato, l'archivio cloud pubblico non è stato in grado di gestire le richieste dei clienti.
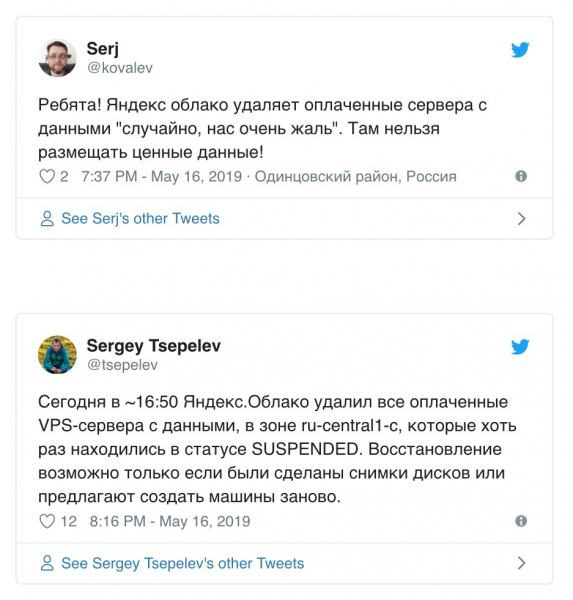
L'effetto si è rivelato ampio, poiché molte grandi risorse utilizzano Amazon S3. Le interruzioni hanno coinvolto Trello, Coursera, IFTTT e, cosa più sgradevole, i servizi dei grandi partner di Amazon dalla lista S&P 500. È difficile quantificare il danno in tali casi, ma si stima che l'ammontare si aggiri intorno a centinaia di milioni di dollari USA. Come si può vedere, per danneggiare il servizio della più grande piattaforma cloud, basta un solo comando errato. Non è un caso isolato: il 16 maggio 2019, durante lavori di manutenzione, il servizio Yandex.Cloud le macchine virtuali degli utenti nella zona ru-central1-c, che erano state almeno una volta nello stato SUSPENDED. Qui già sono stati compromessi i dati dei clienti, parte dei quali è stata persa per sempre. Certamente, gli esseri umani non sono perfetti, ma i sistemi moderni di sicurezza informatica sanno da tempo monitorare le azioni degli utenti privilegiati prima dell'esecuzione dei comandi da loro inseriti. Se si implementassero tali soluzioni in Yandex o Amazon, incidenti simili potrebbero essere evitati.
Raffreddamento congelato
Nel gennaio 2017 si è verificato un grave incidente nel data center di Dmitrov dell'azienda 'Megafon'. In quel periodo la temperatura nella regione di Mosca scese a -35 °C, causando il malfunzionamento del sistema di raffreddamento dell'impianto. Il servizio stampa dell'operatore non ha fornito molte informazioni sulle cause dell'incidente: le aziende russe esitano a parlare di incidenti nei loro impianti; in termini di trasparenza, siamo molto indietro rispetto all'Occidente. Nei social media girava una versione che parlava del congelamento del fluido di raffreddamento nelle tubature interrate e della fuoriuscita di etilene glicole. Se si crede a questa versione, il servizio di gestione non è riuscito, a causa delle lunghe festività, a procurarsi in tempo 30 tonnellate di refrigerante e si è arrangiato usando mezzi alternativi, organizzando un frigo-immagazzinamento improvvisato violando le regole di funzionamento del sistema. Il freddo intenso ha aggravato il problema: a gennaio in Russia è arrivata all'improvviso l'inverno, anche se nessuno lo aspettava. Alla fine, il personale ha dovuto disattivare parte dei rack dei server, il che ha reso alcuni servizi dell'operatore inaccessibili per due giorni.
Probabilmente, qui si può parlare anche di anomalia meteorologica, ma tali gelate non sono insolite per la regione metropolitana. In inverno, la temperatura nella regione di Mosca può scendere a valori ancora più bassi, pertanto i data center sono progettati per funzionare in modo stabile a -42 °C. Nella maggior parte dei casi, i sistemi di raffreddamento si rompono a causa di una concentrazione di glicole non sufficientemente alta e di un eccesso d'acqua nella soluzione del fluido di raffreddamento. Ci sono anche problemi con il montaggio delle tubazioni o con errori nel progetto e nei test del sistema, legati principalmente al desiderio di risparmiare. Di conseguenza, un grave incidente si verifica da condizioni apparentemente normali, che avrebbe potuto essere evitato.
Catastrofi naturali
Nella maggior parte dei casi, temporali e/o uragani interrompono il funzionamento dell'infrastruttura ingegneristica del data center, causando l'interruzione dei servizi e/o danni fisici all'attrezzatura. Gli incidenti provocati da cattive condizioni meteorologiche si verificano abbastanza frequentemente. Nel 2012, un uragano Sandy, accompagnato da forti piogge, ha colpito la costa occidentale degli Stati Uniti. Il data center Peer 1, situato in un grattacielo a Lower Manhattan, , dopo che l'acqua salata del mare ha allagato i semi interrati. I generatori di emergenza dell'oggetto sono stati collocati al 18° piano, e la scorta di carburante per essi era limitata: le regole introdotte a New York dopo gli attacchi dell'11 settembre vietano di immagazzinare grandi quantità di combustibile ai piani superiori.
La pompa di carburante si è guastata, quindi il personale ha dovuto trasportare il diesel per i generatori a mano per diversi giorni. L'eroismo della squadra ha salvato il data center da un grave guasto, ma era davvero così necessario? Viviamo su un pianeta con un'atmosfera di azoto e ossigeno e una grande quantità d'acqua. Tempeste e uragani qui sono all'ordine del giorno (soprattutto nelle zone costiere). Sembra che i progettisti avrebbero dovuto considerare i rischi ad essi associati e costruire un sistema di alimentazione ininterrotta adeguato. O almeno scegliere un luogo più adatto per il data center piuttosto che un grattacielo su un'isola.
Tutto il resto
In questa categoria, l'Uptime Institute distingue vari incidenti, tra cui è difficile scegliere un tipico. Furti di cavi di rame, intrusioni nei data center, pali della linea elettrica e cabine di trasformazione danneggiati da automobili, incendi che rovinano le fibre ottiche provocati da escavatori, roditori (ratti, conigli e persino wombat, che in realtà appartengono ai marsupiali), e anche chi ama esercitarsi nel colpire i fili: il menu è vasto. Anche un di energia elettrica a causa di una piantagione di marijuana illegale può causare interruzioni di alimentazione. Nella maggior parte dei casi, i responsabili dell'incidente sono persone specifiche, cioè ci troviamo di nuovo di fronte al fattore umano, quando un problema ha nome e cognome. Anche se a prima vista l'incidente è correlato a un guasto tecnico o a catastrofi naturali, è possibile evitarlo con una progettazione adeguata dell'oggetto e un corretto utilizzo. Fanno eccezione solo i casi di danni critici all'infrastruttura del data center o di collasso di edifici e strutture a causa di disastri naturali. Queste sono davvero circostanze di forza maggiore; tutti gli altri problemi sono causati da una connessione errata tra il computer e la sedia: è probabilmente la parte più inaffidabile di qualsiasi sistema complesso.
Fonte: habr.com
