

Se si utilizza un database di serie temporali (timeseries db, ) come principale archivio per un sito web di statistiche, si rischia di affrontare molti problemi invece di risolvere la questione. Sto lavorando a un progetto che utilizza un tale database e, a volte, InfluxDB, di cui parleremo, ha portato sorprese del tutto inaspettate.
Avviso: i problemi elencati riguardano la versione InfluxDB 1.7.4.
Perché serie temporali?
Il progetto consiste nel monitoraggio delle transazioni in vari blockchain e nella visualizzazione delle statistiche. Specificamente, stiamo osservando l'emissione e la distruzione di stablecoin (). Sulla base di queste transazioni è necessario costruire grafici e mostrare tabelle riepilogative.
Durante l'analisi delle transazioni è nata l'idea: utilizzare InfluxDB come principale archivio per le serie temporali. Le transazioni sono punti nel tempo e si adattano bene al modello di serie temporali.
Inoltre, le funzioni di aggregazione sembravano molto pratiche: sono ideali per trattare grafici con periodi lunghi. L'utente ha bisogno di un grafico per un anno, ma nel database esiste un insieme di dati con un intervallo di cinque minuti. Inviare le centomila punti sarebbe insensato: oltre a una lunga elaborazione, non ci starebbero nemmeno sullo schermo. È possibile scrivere una propria implementazione per aumentare l'intervallo di tempo oppure utilizzare le funzioni di aggregazione integrate di Influx. Con esse, è possibile raggruppare i dati per giorni e inviare i 365 punti necessari.
Un po' mi disturbava il fatto che normalmente queste basi vengano utilizzate per raccogliere metriche. Monitoraggio dei server, dispositivi IoT, tutti da cui "fluiscono" milioni di punti del tipo: [ — ]. Ma se il database funziona bene con un grande flusso di dati, perché un piccolo volume dovrebbe causare problemi? Con questo pensiero, abbiamo iniziato a lavorare con InfluxDB.
Cosa c'è di comodo in InfluxDB
Oltre alle funzioni di aggregazione già menzionate, c'è un'altra cosa straordinaria — continuous queries (). Questo è un pianificatore integrato nel database che può elaborare i dati in base a un programma. Ad esempio, è possibile raggruppare tutte le registrazioni della giornata ogni 24 ore, calcolare la media e registrare un nuovo punto in un'altra tabella senza scrivere le proprie soluzioni.
C'è anche una retention policies () — configurazione della cancellazione dei dati dopo un certo periodo. Utile, ad esempio, quando è necessario conservare il carico sulla CPU per una settimana con misurazioni ogni secondo, mentre per un intervallo di alcuni mesi tale precisione non è necessaria. In questa situazione si può procedere in questo modo:
- creare una query continua per aggregare i dati in un’altra tabella;
- per la prima tabella definire una politica di cancellazione delle metriche che sono più vecchie di quella settimana.
E Influx si occuperà autonomamente di ridurre la dimensione dei dati e di eliminare il superfluo.
Sui dati conservati
I dati conservati non sono molti: circa 70.000 transazioni e un altro milione di punti con informazioni di mercato. L'aggiunta di nuovi record non supera le 3000 unità al giorno. Ci sono anche metriche sul sito, ma i dati sono pochi e secondo la politica di retention vengono conservati non più di un mese.
Problemi
Nel corso dello sviluppo e dei successivi test del servizio, si sono presentati problemi sempre più critici nell’uso di InfluxDB.
1. Cancellazione dei dati
C’è una serie di dati con transazioni:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Risultato:
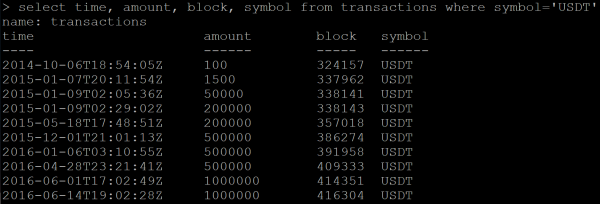
Invio del comando per la cancellazione dei dati:
DELETE FROM transactions WHERE symbol=’USDT’Successivamente faccio una richiesta per ottenere i dati già cancellati. E Influx restituisce invece di una risposta vuota una parte dei dati che dovrebbero essere stati cancellati.
Provo a cancellare l'intera tabella:
DROP MEASUREMENT transactionsControllo la cancellazione della tabella:
SHOW MEASUREMENTSNon vedo la tabella nell'elenco, ma una nuova richiesta di dati continua a restituire lo stesso insieme di transazioni.
Il problema si è presentato solo una volta, poiché il caso di cancellazione è un’eccezione. Ma un comportamento del genere del database non rientra chiaramente nelle norme di ‘corretta’ funzionalità. Successivamente su github ho trovato un problema aperto di quasi un anno fa su questo tema.
Di conseguenza, ha aiutato la cancellazione e il successivo ripristino dell'intero database.
2. Numeri in virgola mobile
I calcoli matematici utilizzando le funzioni integrate di InfluxDB danno errori di precisione. Non che sia qualcosa di inusuale, ma è sgradevole.
Nel mio caso i dati hanno una componente finanziaria e mi piacerebbe elaborarli con alta precisione. Per questo motivo ho in programma di rinunciare alle query continue.
3. Le query continue non possono essere adattate a diversi fusi orari
Nel servizio c'è una tabella con le statistiche giornaliere delle transazioni. Per ogni giorno è necessario raggruppare tutte le transazioni di quel giorno. Tuttavia, il giorno per ogni utente inizia a orari diversi, quindi il set di transazioni è differente. Secondo UTC ci sono di offset per cui è necessario aggregare i dati.
In InfluxDB, durante il raggruppamento per tempo, è possibile specificare un offset, ad esempio per il fuso orario di Mosca (UTC+3):
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Tuttavia, il risultato della query sarà errato. Per qualche motivo, i dati aggregati per giorno inizieranno addirittura nel 1677 (InfluxDB supporta ufficialmente il periodo temporale a partire da quell'anno):
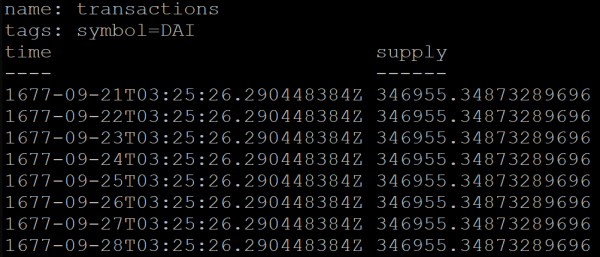
Per aggirare questo problema, il servizio è stato temporaneamente spostato su UTC+0.
4. Prestazioni
In rete ci sono molti benchmark che confrontano InfluxDB e altri database. Alla prima visualizzazione sembravano materiali di marketing, ma ora credo che ci sia una certa verità in essi.
Racconterò il mio caso.
Il servizio fornisce un metodo API che restituisce statistiche per le ultime 24 ore. Durante i calcoli, il metodo interroga il database tre volte con queste query:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCSpiegazione:
- Nella prima query otteniamo gli ultimi punti per ogni moneta con i dati di mercato. Otto punti per otto monete nel mio caso.
- La seconda query ottiene l'ultimo punto più recente.
- La terza richiede un elenco di transazioni delle ultime 24 ore, che possono essere diverse centinaia.
Specifico che in InfluxDB viene automaticamente creato un indice per tag e per tempo, che velocizza le query. Nella prima query symbol è un tag.
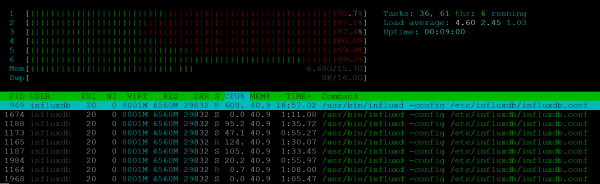
Ho effettuato un test di stress per questo metodo API. Con 25 RPS, il server mostrava un carico completo di sei CPU:
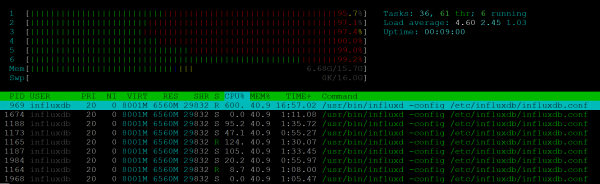
Tuttavia, il processo NodeJs non ha generato alcun carico.
La velocità di esecuzione è degradata già a 7-10 RPS: se un cliente poteva ricevere una risposta in 200 ms, 10 clienti dovevano aspettare un secondo. 25 RPS è il limite oltre il quale la stabilità è stata compromessa, causando errori 500 ai clienti.
Con tali prestazioni, utilizzare Influx nel nostro progetto è impossibile. Inoltre: in un progetto in cui è necessario mostrare il monitoraggio a numerosi clienti, potrebbero sorgere problemi simili e il server di metriche sarebbe sovraccarico.
Conclusione
La lezione principale dell'esperienza ottenuta è che non si può inserire una tecnologia sconosciuta in un progetto senza un'analisi adeguata. Un semplice screening dei ticket aperti su github avrebbe fornito informazioni per evitare di adottare InfluxDB come principale archivio dati.
InfluxDB avrebbe dovuto adattarsi bene alle esigenze del mio progetto, ma come ha dimostrato la pratica, questo database non soddisfa le esigenze e presenta molti problemi.
Nel repository del progetto è già disponibile la versione 2.0.0-beta, speriamo che nella seconda versione ci siano miglioramenti significativi. Nel frattempo, andrò a studiare la documentazione di TimescaleDB.
Fonte: habr.com
