

Attualmente esistono soluzioni pronte (proprietarie) per il monitoraggio dei flussi IP(TS), ad esempio e , che dispongono di un set piuttosto ricco di funzionalità e di solito tali soluzioni sono disponibili per i grandi operatori che trattano servizi TV. Questo articolo descrive una soluzione basata sul progetto open source , progettata per il controllo minimo dei flussi IP(TS) tramite il contatore di continuità (CC) e il bitrate. Un possibile uso è il monitoraggio della perdita di pacchetti o dell'intero flusso attraverso un canale L2 affittato (che non può essere monitorato normalmente, ad esempio, tramite la lettura dei contatori di perdita nelle code).
Brevemente su TSDuck
TSDuck è un software open source (licenza 2-Clause BSD) (un insieme di utilità da console e una libreria per sviluppare le proprie utilità o plugin) per operare sui flussi TS. Come input, può lavorare con IP (multicast/unicast), http, hls, sintonizzatori dvb, demodulatore dektec dvb-asi, dispone di un generatore interno di flusso TS e di lettura da file. Come output può essere la registrazione su file, IP (multicast/unicast), hls, modulatori dektec dvb-asi e HiDes, lettori (mplayer, vlc, xine) e drop. Tra input e output è possibile inserire diversi processori di traffico, ad esempio il rimappamento dei PID, la scramblerizzazione/descramblerizzazione, l'analisi dei contatori CC, il conteggio del bitrate e altre operazioni tipiche per i flussi TS.
In questo articolo, come input saranno utilizzati flussi IP (multicast), i processori bitrate_monitor (dal nome è chiaro di cosa si tratta) e continuity (analisi dei contatori CC). Senza particolari problemi, è possibile sostituire l'IP multicast con un altro tipo di input supportato da TSDuck.
Ci sono per TSDuck per la maggior parte dei sistemi operativi attuali. Non ci sono per Debian, ma sono riuscito a compilare senza problemi per Debian 8 e Debian 10.
Successivamente sarà utilizzata la versione TSDuck 3.19-1520, come sistema operativo si utilizza Linux (per la preparazione della soluzione è stato usato Debian 10, per l'uso reale — CentOS 7)
Preparazione di TSDuck e del sistema operativo
Prima di monitorare i flussi reali, è necessario assicurarsi che TSDuck funzioni correttamente e che non ci siano perdita di pacchetti a livello della scheda di rete o del sistema operativo (socket). Questo è necessario per non dover successivamente indovinare dove si sono verificati i drop: sulla rete o "internamente al server". È possibile controllare i drop a livello della scheda di rete con il comando ethtool -S ethX; il tuning avviene sempre con ethtool (di solito, è necessario aumentare il buffer RX (-G) e a volte disabilitare alcune offload (-K)). Come raccomandazione generale, si consiglia di utilizzare una porta separata per ricevere il traffico analizzato, se possibile, in modo da ridurre le falsi positivi legati al fatto che i drop si verifichino specificamente sulla porta dell'analizzatore a causa della presenza di altro traffico. Se non è disponible tale opzione (si utilizza un mini-computer/NUC con una sola porta), è molto consigliabile impostare la priorità del traffico analizzato rispetto al resto avviato sul dispositivo a cui è collegato l'analizzatore. Riguardo agli ambienti virtuali, qui bisogna fare attenzione e saper individuare i drop dei pacchetti iniziando dalla porta fisica e arrivando fino all'applicazione all'interno della macchina virtuale.
Generazione e ricezione del flusso all'interno dell'host
Come primo passo nella preparazione di TSDuck, genereremo e riceveremo traffico all'interno di un host utilizzando netns.
Prepariamo l'ambiente:
ip netns add P #creiamo netns P, dove avverrà l'analisi del traffico
ip link add type veth #creiamo una coppia veth - veth0 rimane in netns predefinito (il traffico sarà generato su questo interfaccia)
ip link set dev veth1 netns P #veth1 - spostiamo a netns P (su questo interfaccia avverrà la ricezione del traffico)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #attiviamo IP su veth1, non importa quale sia
ip netns exec P ip ro add default via 192.0.2.2 #configuriamo la rotta predefinita all'interno di netns P
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #disabilitiamo IPv6 su veth0 - questo è fatto per evitare che spazzature extra influiscano su TX
ifconfig veth0 up #attiviamo l'interfaccia veth0
ip route add 239.0.0.1 dev veth0 #creiamo una rotta affinché il sistema operativo indirizzi il traffico a 239.0.0.1 verso veth0
L'ambiente è pronto. Avviamo l'analizzatore di traffico:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
dove «-p 1 -t 1» significa che è necessario calcolare il bitrate ogni secondo e visualizzare le informazioni sul bitrate ogni secondo
Avviamo il generatore di traffico a una velocità di 10 Mbit/s:
tsp -I craft
 -P regola -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
dove «-p 7 -e» significa che bisogna adattare 7 pacchetti TS in 1 pacchetto IP e farlo rigidamente (-e), ovvero aspettare sempre 7 pacchetti TS dall'ultimo processore prima di inviare la formazione del pacchetto IP.
L'analizzatore inizia a visualizzare i messaggi previsti:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, bitrate TS: 9.970.016 bit/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, bitrate TS: 10.022.656 bit/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, bitrate TS: 9.980.544 bit/s
Ora aggiungiamo un po' di drop:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPe compaiono messaggi di questo tipo:
* 2020/01/03 14:57:11 - continuity: indice pacchetto: 80.745, PID: 0x0000, mancano 7 pacchetti
* 2020/01/03 14:57:11 - continuity: indice pacchetto: 83.342, PID: 0x0000, mancano 7 pacchetti
il che è atteso. Disattiviamo la perdita di pacchetti (ip netns exec P iptables -F) e proviamo ad aumentare il bitrate del generatore a 100 Mbit/s. L'analizzatore riporta un sacco di errori CC e circa 75 Mbit/s invece di 100. Cerchiamo di capire chi è il colpevole — se il generatore non riesce a tenere il passo o se il problema non è in esso, per questo avviamo la generazione di un numero fisso di pacchetti (700000 pacchetti TS = 100000 pacchetti IP):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Come si può vedere, sono stati generati esattamente 100000 pacchetti IP (151925460-151825460). Quindi indaghiamo su cosa succede con l'analizzatore, quindi confrontiamo con il contatore RX su veth1, che è esattamente uguale al contatore TX su veth0, poi guardiamo cosa succede a livello di socket:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Qui si vede il numero di drop = 24355. Nei pacchetti TS sono 170485, ovvero il 24,36% di 700000, quindi vediamo che quei 25% di bitrate perso sono drop nel socket UDP. I drop nel socket UDP di solito si verificano a causa della mancanza di buffer, vediamo a quanto ammonta la dimensione del buffer del socket per impostazione predefinita e la dimensione massima del buffer del socket:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Quindi, se le applicazioni non richiedono esplicitamente la dimensione del buffer, i socket vengono creati con un buffer di dimensione 208 Kb, ma se richiedono di più, comunque non otterranno quanto richiesto. Poiché in tsp per l'input IP è possibile specificare la dimensione del buffer (—buffer-size), non toccheremo la dimensione del socket per impostazione predefinita, ma imposteremo solo la dimensione massima del buffer del socket e specificheremo chiaramente la dimensione del buffer tramite gli argomenti tsp:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Con questa ottimizzazione del buffer del socket, ora il bitrate riportato è di circa 100 Mbit/s, senza errori CC.
Per il consumo della CPU da parte dell'applicazione tsp. Relativamente a un core i5-4260U CPU @ 1.40GHz, per analizzare un flusso di 10 Mbit/s serviranno il 3-4% di CPU, per 100 Mbit/s - il 25%, per 200 Mbit/s - il 46%. All'aumentare della percentuale di perdita dei pacchetti, il carico sulla CPU praticamente non aumenta (ma può diminuire).
Su hardware più potente è stato possibile generare e analizzare flussi superiori a 1 Gb/s senza problemi.
Test su schede di rete reali
Dopo aver testato sulla coppia veth, è necessario prendere due host o due porte dello stesso host, collegare le porte tra loro, avviare un generatore su uno e un analizzatore sull'altro. Non ci sono state sorprese, ma in realtà tutto dipende dall'hardware: quanto più è debole, tanto più interessante sarà qui.
Utilizzo dei dati ricevuti dal sistema di monitoraggio (Zabbix)
Il tsp non dispone di un API leggibile dalle macchine come SNMP o simili. I messaggi CC devono essere aggregati almeno su 1 secondo (nel caso di una alta percentuale di perdita di pacchetti, potrebbero essercene centinaia/migliaia/decine di migliaia al secondo, a seconda del bitrate).
Pertanto, per memorizzare le informazioni e disegnare grafici sugli errori CC e sul bitrate ed effettuare alcune analisi più avanti possono esserci le seguenti opzioni:
- Analizzare e aggregare (per CC) l'output di tsp, cioè convertirlo nella forma necessaria.
- Modificare il tsp stesso e/o i plugin di elaborazione bitrate_monitor e continuity, in modo che il risultato venga fornito in forma leggibile dalle macchine, adatta al sistema di monitoraggio.
- Scrivere la propria applicazione sopra la libreria tsduck.
Evidentemente, dal punto di vista degli sforzi, l'opzione 1 è la più semplice, soprattutto considerando che il tsduck stesso è scritto in un linguaggio di basso livello (secondo i moderni standard) (C++)
Un semplice prototipo di parser+aggregatore in bash ha mostrato che su un flusso di 10 Mbit/s e il 50% di perdita di pacchetti (il peggiore dei casi), il processo bash consumava da 3 a 4 volte più CPU rispetto al processo tsp stesso. Un simile sviluppo della situazione è inaccettabile. In effetti, un pezzo di questo prototipo è qui sotto.
Noodles su bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Oltre al fatto che funziona in modo inaccettabilmente lento, bash non ha fili normali, i processi bash sono processi autonomi ed è stato necessario registrare ogni secondo il valore missingPackets su un side-effect (quando si riceve un messaggio sulla velocità di trasmissione, che arriva ogni secondo). Alla fine, bash è stato lasciato in pace e si è deciso di scrivere un wrapper (parser+aggregatore) in golang. Il consumo della CPU di codice simile in golang è 4-5 volte inferiore rispetto al processo tsp stesso. L'accelerazione del wrapper sostituendo bash con golang è stata di circa 16 volte e in generale il risultato è accettabile (overhead della CPU del 25% nel caso peggiore). Il file sorgente in golang si trova .
Esecuzione del wrapper
Per eseguire il wrapper è stato creato un semplice template di servizio per systemd (). Si presume che il wrapper stesso sia stato compilato in un file binario (go build tsduck-stat.go), posizionato in /opt/tsduck-stat/. Si presume che venga utilizzato golang con supporto per monotonic clock (>=1.9).
Per creare un'istanza del servizio occorre eseguire il comando systemctl enable tsduck-stat@239.0.0.1:1234, quindi avviarlo tramite systemctl start tsduck-stat@239.0.0.1:1234.
Discovery da Zabbix
Per permettere a Zabbix di effettuare la discovery dei servizi in esecuzione, è stato creato un (discovery.sh), nel formato necessario per la discovery di Zabbix, si presume che sia posizionato lì — in /opt/tsduck-stat. Per eseguire la discovery tramite zabbix-agent, è necessario aggiungere nella directory delle configurazioni dell'agente zabbix per aggiungere i parametri user.
Template Zabbix
(tsduck_stat_template.xml) contiene regole di auto-scoperta, prototipi di elementi dati, grafici e trigger.
Checklist rapida (nel caso qualcuno decida di utilizzarla)
- Assicurarsi che tsp non perda pacchetti in condizioni "ideali" (il generatore e l'analizzatore sono collegati direttamente), se ci sono perdite vedi p.2 o il testo dell'articolo a riguardo.
- Ottimizzare il buffer massimo del socket (net.core.rmem_max=8388608).
- Compilare tsduck-stat.go (go build tsduck-stat.go).
- Posizionare il template di servizio in /lib/systemd/system.
- Avviare i servizi tramite systemctl, controllare che inizino a comparire nei contatori (grep "" /dev/shm/tsduck-stat/*). Il numero di servizi corrisponde al numero di stream multicast. Qui potrebbe essere necessario creare una rotta verso il gruppo multicast, disattivare rp_filter o creare una rotta verso l'IP sorgente.
- Eseguire discovery.sh, assicurarsi che generi JSON.
- Fornire la configurazione dell'agente zabbix, riavviare l'agente zabbix.
- Carica il modello in zabbix, applicalo all'host su cui è in corso il monitoraggio e il cui zabbix-agent è installato, attendi circa 5 minuti, verifica se sono apparsi nuovi elementi di dati, grafici e trigger.
Risultato
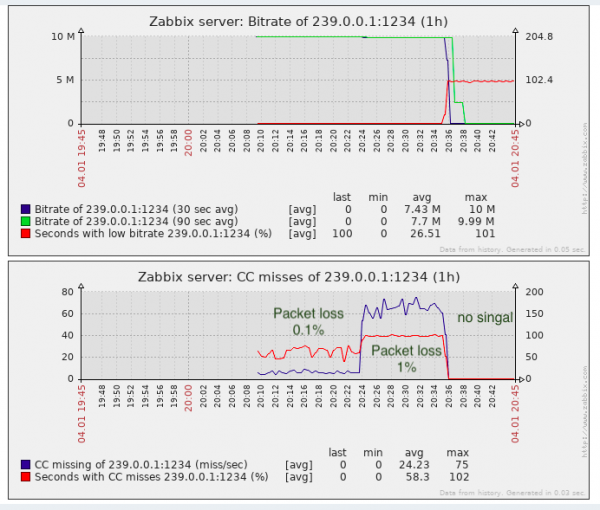
Per il compito di rilevamento della perdita di pacchetti è quasi sufficiente, almeno è meglio di nessun monitoraggio.
In effetti, delle "perdite" di CC possono verificarsi durante il montaggio dei frammenti video (per quanto ne so, questo è il modo in cui vengono effettuate le inserzioni nei centri di produzione locali in RF, ossia senza il ricalcolo del contatore CC), è importante ricordarlo. Nelle soluzioni proprietarie questo problema è parzialmente aggirato mediante il rilevamento dei marcatori SCTE-35 (se vengono aggiunti dal generatore di flusso).
Dal punto di vista del monitoraggio della qualità del trasporto, manca il monitoraggio dello jitter (IAT), poiché l'attrezzatura TV (che si tratti di modulatore o dispositivi finali) ha requisiti per questo parametro e non sempre è possibile espandere il jitbuffer all'infinito. E lo jitter può variare quando sull'asse di trasmissione viene utilizzata un'attrezzatura con buffer grandi e QoS per la trasmissione di tale traffico in tempo reale non è configurato o non è sufficientemente configurato.
Fonte: habr.com
