

Ciao! Mi chiamo Aleksej P'jankov, sono uno sviluppatore presso l'azienda Sportmaster. In questo ho raccontato come è iniziata la lavorazione del sito Sportmaster nel 2012, quali iniziative siamo riusciti a "spingere" e, al contrario, quali ostacoli abbiamo incontrato.
Oggi voglio condividere alcune riflessioni che seguono un'altra trama: la scelta del sistema di caching per il backend Java nell'admin del sito. Questa trama ha un significato particolare per me: anche se la storia si è sviluppata in appena 2 mesi, in questi 60 giorni abbiamo lavorato per 12-16 ore al giorno senza un solo giorno di riposo. Non avevo mai pensato né immaginato che si potesse lavorare così tanto.
Pertanto, dividerò il testo in due parti, per non sovraccaricare. Al contrario, la prima parte sarà molto leggera: una preparazione, un'introduzione, alcune considerazioni su cosa sia il caching. Se sei già un sviluppatore esperto o hai lavorato con i cache, dal punto di vista tecnico non ci sarà nulla di nuovo in questo articolo. Ma per un junior, una piccola panoramica può suggerire verso quale direzione guardare, qualora si trovasse in una situazione simile.
Quando la nuova versione del sito Sportmaster è stata lanciata in produzione, i dati venivano forniti in un modo, per usare un eufemismo, non molto comodo. La base era costituita da tabelle preparate per la precedente versione del sito (Bitrix), che dovevano essere caricate in ETL, adeguate al nuovo formato e arricchite con vari dettagli da una decina di sistemi. Affinché una nuova immagine o descrizione del prodotto apparisse sul sito, era necessario aspettare fino al giorno successivo: aggiornamento solo di notte, una volta al giorno.
Inizialmente c'erano così tante preoccupazioni nelle prime settimane dopo il lancio in produzione, che tali disagi per i content manager erano considerati una questione minore. Ma, non appena tutto si è sistemato, lo sviluppo del progetto è continuato: dopo alcuni mesi, all'inizio del 2015 abbiamo iniziato a sviluppare attivamente l'admin. Nel 2015 e 2016 tutto andava bene, pubblicavamo regolarmente, l'admin copriva una parte sempre maggiore della preparazione dei dati e ci preparavamo al fatto che presto alla nostra squadra sarebbe stato affidato il compito più importante e complesso: il contorno del prodotto (preparazione completa e gestione dei dati su tutti i prodotti). Ma nell'estate del 2017, proprio prima del lancio del contorno del prodotto, il progetto si troverà in una situazione molto difficile: proprio a causa dei problemi con il caching. Di questo episodio voglio parlare nella seconda parte di questa pubblicazione in due episodi.
Ma in questo post inizierò da lontano, riassumendo alcune idee – concezioni sulla cache, scorrere le quali prima di un grande progetto sarebbe un buon passo.
Quando si presenta il compito di caching
Il compito di caching non appare così senza motivo. Noi sviluppatori scriviamo un prodotto software e vogliamo che sia richiesto. Se il prodotto è richiesto e ha successo, gli utenti aumentano. E ancora e ancora. Ecco che gli utenti diventano molti e allora il prodotto diventa ad alta intensità di utilizzo.
Nelle fasi iniziali non pensiamo all'ottimizzazione e alle prestazioni del codice. L'importante è la funzionalità, rilasciare rapidamente un pilota e testare le ipotesi. E se il carico cresce, potenziamo l'hardware. Aumentiamo le risorse di due o tre volte, cinque, magari dieci. Qui i costi potrebbero non permetterselo più. E quante volte aumenterà il numero degli utenti? Non saranno solo 2-5-10, ma in caso di successo potrebbe variare da 100 a 1000 fino a 100.000 volte. Quindi, prima o poi, dovremo occuparci dell'ottimizzazione.
Supponiamo che una certa parte del codice (chiamiamo questa parte funzione) richieda un tempo inaccettabilmente lungo e vogliamo ridurre il tempo di esecuzione. La funzione può essere un accesso al database, può essere l'esecuzione di una logica complessa – l'importante è che richieda tempo. Di quanto possiamo ridurre il tempo di esecuzione? In teoria, possiamo ridurlo a zero, non oltre. E come possiamo ridurre il tempo di esecuzione a zero? Risposta: escludendo completamente l'esecuzione. Invece di ciò, restituiamo subito il risultato. E come possiamo conoscere il risultato? Risposta: o lo calcoliamo, oppure lo controlliamo da qualche parte. Calcolare richiede tempo. Controllare significa, per esempio, memorizzare il risultato che la funzione ha restituito l'ultima volta che è stata chiamata con gli stessi parametri.
Cioè, l'implementazione della funzione non è rilevante per noi. È sufficiente sapere da quali parametri dipende il risultato. Quindi, se rappresentiamo i valori dei parametri come un oggetto da utilizzare come chiave in un certo storage, possiamo memorizzare il risultato del calcolo e, alla successiva richiesta, considerarlo. Se queste operazioni di scrittura e lettura del risultato avvengono più velocemente dell'esecuzione della funzione, otteniamo un vantaggio in termini di velocità. L'entità del vantaggio può arrivare a 100, 1000 o anche 100.000 volte (10^5 è piuttosto un'eccezione, ma nel caso di un database che lagga notevolmente, è del tutto possibile).
Requisiti principali per il sistema di caching
La prima cosa che può diventare un requisito per il sistema di caching è la velocità di lettura rapida e, in misura leggermente minore, la velocità di scrittura. È vero, ma solo finché non implementiamo il sistema in produzione.
Immaginiamo un caso del genere.
Supponiamo di aver garantito l'hardware per il carico attuale e ora iniziamo lentamente a implementare il caching. Il numero di utenti cresce leggermente, aumenta il carico: aggiungiamo un po' di cache, la colleghiamo qua e là. Così va avanti per un po', e adesso le funzioni pesanti praticamente non vengono più chiamate: tutto il carico principale ricade sul cache. Nel frattempo, il numero di utenti è aumentato di N volte.
E se la riserva iniziale di hardware era di 2-5 volte, con l'aiuto del caching abbiamo potuto aumentare le prestazioni di 10 volte, o, nel miglior caso, di 100, e a volte anche di 1000. Cioè, con lo stesso hardware, elaboriamo 100 volte più richieste. Ottimo, meritiamo un premio!
Ma ora, a un certo punto, per caso, il sistema ha fallito e il cache è crollato. Niente di speciale: abbiamo scelto il cache in base al requisito di "alta velocità di lettura e scrittura, il resto non è importante".
Relativamente al carico iniziale, avevamo una riserva di hardware di 2-5 volte, mentre il carico nel frattempo è aumentato di 10-100 volte. Con l'aiuto del caching escludevamo le chiamate per le funzioni pesanti e quindi tutto volava. E ora, senza cache, di quanto il nostro sistema calerà? Cosa succederà? Il sistema si fermerà.
Anche se il nostro cache non è crollato, ma solo svuotato per un certo periodo, sarà necessario riscaldarlo, e questo richiederà del tempo. E per quel periodo, il carico principale ricadrà sulla funzionalità.
Conclusione: i progetti ad alta richiesta in produzione richiedono al sistema di caching non solo alta velocità di lettura e scrittura, ma anche integrità dei dati e resilienza ai guasti.
Le difficoltà della scelta
Nel progetto con il pannello di amministrazione, la scelta è andata così: inizialmente abbiamo installato Hazelcast, poiché eravamo già familiari con questo prodotto grazie all'esperienza del sito principale. Tuttavia, questa scelta si è rivelata infelice: per il nostro profilo di carico, Hazelcast non solo funziona lentamente, ma estremamente lentamente. E con le scadenze per la produzione, a quel punto ci eravamo già impegnati.
Spoiler: come si sono svolte le circostanze, che ci hanno fatto perdere un'opportunità e abbiamo ottenuto una situazione critica e tesa – lo racconterò nella seconda parte — come siamo finiti, e come siamo usciti. Ma al momento, dirò solo che è stato un grande stress, e "pensare – è difficile pensare, scuotiamo la bottiglia". "Scuotiamo la bottiglia" — è anche uno spoiler, di questo parlerò più avanti.
Cosa abbiamo fatto:
- Abbiamo compilato un elenco di tutti i sistemi suggeriti da Google e StackOverflow. Poco più di 30.
- Scriviamo test di carico, caratteristici per la produzione. Per questo abbiamo registrato i dati che passano attraverso il sistema nell'ambiente di produzione — una sorta di sniffing per i dati che non sono in rete, ma all'interno del sistema. Nei test abbiamo utilizzato esattamente questi dati.
- Tutta la squadra, ciascuno sceglie il successivo sistema dall'elenco, lo configura e esegue i test. Se un test non passa, non regge il carico – lo scartiamo e passiamo al successivo in coda.
- Alla 17esima sistema è diventato chiaro che era tutto senza speranza. Basta "scuotere la bottiglia", è ora di riflettere seriamente.
Ma questo è un caso in cui è necessario scegliere un sistema che "regga la velocità" nei test preimpostati. E se quei test non esistono ancora e si vuole scegliere più rapidamente?
Simuliamo questo scenario (è difficile immaginare che uno sviluppatore di livello intermedio+ viva nel vuoto, e al momento della scelta non abbia ancora messo a punto una preferenza su quale prodotto provare per primo — quindi, le ulteriori riflessioni sono, piuttosto, teoria / filosofia / riguardo a un junior).
Stabilite le esigenze, iniziamo a scegliere una soluzione pronta all'uso. Perché reinventare la ruota: andremo e prenderemo un sistema di caching già pronto.
Se stai iniziando e cerchi su Google, l'ordine è più o meno casuale, ma in generale i riferimenti saranno questi. Prima di tutto ti imbatterai in Redis, che è molto pubblicizzato. Poi scoprirai che c'è EhCache, il sistema più longevo e collaudato. Successivamente si parlerà di Tarantool - una creazione nazionale che ha un aspetto unico nella sua soluzione. E anche Ignite, perché al momento sta guadagnando popolarità e riceve supporto da SberTech. Infine parleremo di Hazelcast, poiché nel mondo enterprise è spesso citato tra le grandi aziende.
Ma la lista non si esaurisce qui, esistono decine di sistemi. E noi ne considereremo solo uno. Prenderemo cinque sistemi selezionati per un 'concorso di bellezza' e faremo una selezione. Chi sarà il vincitore?
Redis
Leggiamo cosa scrivono sul sito ufficiale.
— progetto open source. Offre una soluzione di archiviazione dati in memoria, con possibilità di salvataggio su disco, partizionamento automatico, alta disponibilità e recupero da interruzioni di rete.
Tutto sembra ottimo, è possibile adoperarlo — fa esattamente ciò di cui hai bisogno. Ma daremo un'occhiata anche agli altri candidati per pura curiosità.
EhCache
— "il cache più ampiamente usato per Java" (traduzione dello slogan dal sito ufficiale). Anch'esso open source. E qui ci rendiamo conto che Redis non è specifico per Java, ma è generico, e per interagire con esso è necessaria un'astrazione. EhCache si presenta quindi più comodo. Cosa promette il sistema? Affidabilità, collaudato, funzionalità completa. E inoltre è il più diffuso. Cache centinaia di terabyte di dati.
Redis è dimenticato, sono pronto a scegliere EhCache.
Ma il mio senso di patriottismo mi spinge a considerare cosa ha di buono Tarantool.
Tarantool
— si presenta come "Piattaforma di integrazione dei dati in tempo reale". Suona molto complesso, quindi leggiamo attentamente la pagina e troviamo una dichiarazione audace: "Cache il 100% dei dati in memoria". Questo dovrebbe sollevare domande — poiché i dati possono essere significativamente più del disponibile nella memoria. Il significato è che per scrivere dati su disco dalla memoria, Tarantool non esegue la serializzazione. Invece, utilizza caratteristiche a basso livello del sistema, in cui la memoria è semplicemente mappata al file system con ottime prestazioni I/O. In generale, hanno fatto un buon lavoro.
Diamo un'occhiata alle implementazioni: Mail.ru, Avito, Beeline, MegaFon, Alfa-Bank, Gazprom…
Se ci fossero ancora dei dubbi riguardo a Tarantool, il caso di implementazione in Mastercard mi convince del tutto. Prendo Tarantool.
Ma comunque…
Ignite
… c'è ancora , dichiarato come "piattaforma di calcolo in-memory… velocità in-memory su petabyte di dati". Qui ci sono anche molti vantaggi: cache distribuita in-memory, il più veloce sistema di archiviazione e cache key-value, scalabilità orizzontale, alta disponibilità, integrità rigorosa. In generale, si scopre che il più veloce è Ignite.
Implementazioni: Sberbank, American Airlines, Yahoo! Japan. E poi scopro anche che Ignite non è solo implementato in Sberbank, ma il team di SberTech manda i propri membri nel team di Ignite per migliorare il prodotto. Questo mi convince completamente e sono pronto a prendere Ignite.
È completamente incomprensibile perché, guardo il quinto punto.
Hazelcast
Vado sul sito , leggo. E si scopre che la soluzione più veloce per la cache distribuita è Hazelcast. È di parecchie volte più veloce di tutte le altre soluzioni e in effetti è il leader nel campo dei data grid in-memory. A fronte di ciò, prendere qualcos'altro sarebbe mancarsi di rispetto. Inoltre, utilizza la memorizzazione dei dati ridondante per garantire il funzionamento continuo del cluster senza perdita di dati.
Va bene, sono pronto a prendere Hazelcast.
Confronto
Ma se guardiamo, tutti e cinque i candidati sono presentati in modo tale che ognuno di essi è il migliore. Come scegliere? Possiamo controllare quale di essi è il più popolare, cercare confronti e il mal di testa passerà.
Troviamo un , scegliamo i nostri 5 sistemi.
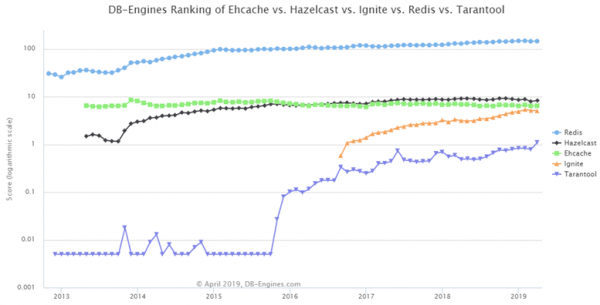
Qui sono ordinati: in cima Redis, al secondo posto Hazelcast, Tarantool e Ignite stanno guadagnando popolarità, EhCache è rimasto tale e quale.
Ma diamo un'occhiata al : links ai siti web, interesse generale per il sistema, offerte di lavoro — fantastico! Cioè, quando il mio sistema va in crash, dirò: "No, è affidabile! Ecco molte offerte di lavoro...". Un confronto così semplice non è adatto.
Tutti questi sistemi non sono semplicemente sistemi per la cache. Hanno anche molte altre funzionalità, tra cui — quando non sono i dati a essere trasferiti al cliente per l'elaborazione, ma viceversa: il codice da eseguire sui dati si sposta sul server, viene eseguito lì e il risultato viene restituito. E come sistema separato per la cache, non vengono spesso considerati.
Va bene, non ci arrendiamo, troviamo un confronto diretto dei sistemi. Prendiamo le due opzioni superiori — Redis e Hazelcast. Ci interessa la velocità, su questo parametro li confronteremo.
Hz vs Redis
Troviamo tale :
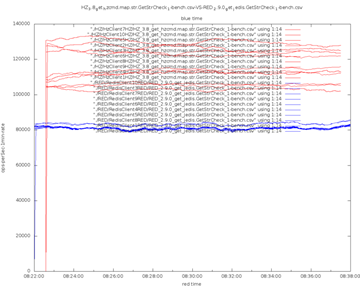
Il blu è Redis, il rosso Hazelcast. Hazelcast vince ovunque, e questo è giustificato: è multithreaded, altamente ottimizzato, ogni thread lavora con la propria partizione, quindi non ci sono blocchi. Redis è invece monothreaded, e non sfrutta i moderni processori multicore. Hazelcast utilizza I/O asincrono, mentre Redis-Jedis usa socket bloccanti. Alla fine, Hazelcast utilizza un protocollo binario, mentre Redis è orientato al testo, il che significa che è inefficiente.
Per ogni evenienza, rivolgiamoci a un'altra fonte di confronto. Cosa ci mostrerà?
Redis vs Hz
Un'altra :
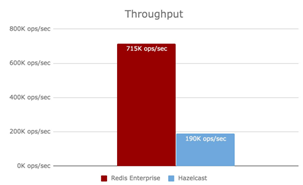
Qui al contrario, il rosso è Redis. Cioè, Redis ha prestazioni migliori rispetto a Hazelcast. Nel primo confronto vinceva Hazelcast, nel secondo invece vince Redis. è stato spiegato molto bene perché nel confronto precedente ha vinto Hazelcast.
Si scopre che il risultato del primo confronto era praticamente truccato: Redis è stato preso nella sua configurazione base, mentre Hazelcast è stato ottimizzato per il caso di test. Quindi, innanzitutto, non ci si può fidare di nessuno; in secondo luogo, quando alla fine scegliamo un sistema, dobbiamo anche configurarlo correttamente. Queste impostazioni comprendono decine, quasi centinaia di parametri.
Agitiamo la bottiglia
E tutto il processo che abbiamo appena svolto posso spiegare con questa metafora: "Agitiamo la bottiglia". Cioè, ora non è necessario programmare, ciò che conta è sapere come leggere Stackoverflow. Ho in team una persona, un professionista, che lavora proprio in questo modo nei momenti critici.
Cosa sta facendo? Vede un aggeggio che non funziona, osserva il stack trace, prende alcune parole da esso (quali esattamente - è la sua competenza nel programma), cerca su Google, trova Stack Overflow tra le risposte. Senza leggere, senza riflettere, tra le risposte alla domanda - sceglie qualcosa di simile alla frase «fare questo e quello» (scegliere quella risposta - è il suo talento, perché non è sempre quella la risposta che ha raccolto più like), applica, guarda: se qualcosa è cambiato, allora bene. Se non è cambiato - annulliamo. E ripetiamo avvio-controllo-ricerca. E in questo modo intuitivo riesce ad ottenere che dopo un po' di tempo il codice funzioni. Non sa perché, non sa cosa ha fatto, non riesce a spiegare. Ma! Quello funziona. E «il fuoco è spento». Adesso analizziamo cosa abbiamo fatto. Quando il programma funziona - è di gran lunga più facile. E risparmia significativamente tempo.
Questo metodo è molto bene spiegato con un esempio.
Una volta era molto popolare costruire una nave a vela in una bottiglia. La nave è grande e fragile, mentre il collo della bottiglia è molto stretto, non può essere infilata dentro. Come si può assemblare?
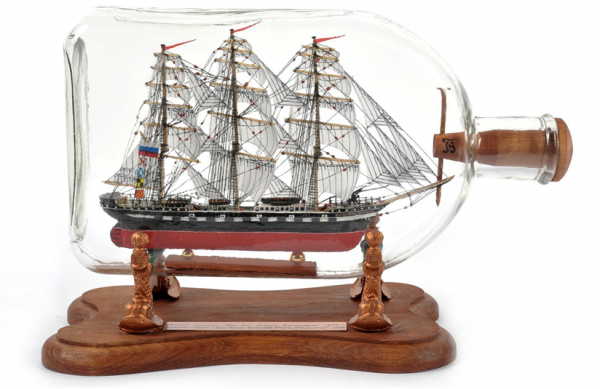
Esiste un metodo, molto rapido e molto efficace.
La nave è composta da un sacco di piccole cose: bastoncini, cordicelle, vele, colla. Mettiamo tutto nella bottiglia.
Prendiamo la bottiglia con entrambe le mani e iniziamo a scuoterla. La scuotiamo e la scuotiamo. E di solito - risulta un disastro, certo. Ma a volte. A volte esce una nave! Più precisamente, qualcosa che assomiglia a una nave.
Mostriamo questo qualcosa a qualcuno: «Serjoga, vedi!?». E in effetti, da lontano - sembra una nave. Ma non si può lasciarla così.
Esiste anche un altro modo. Lo usano ragazzi più esperti, come i hacker.
Ho dato a un ragazzo così un compito, ha fatto tutto e se ne è andato. E guardi - sembra fatto. Ma dopo un po', quando bisogna rifinire il codice - iniziano a succedere cose a causa sua... Per fortuna, è già riuscito a scappare lontano. Sono ragazzi che prendono l'esempio della bottiglia e fanno così: vedete, dove c'è il fondo - il vetro si piega. E non è del tutto chiaro, se sia trasparente o meno. Allora i «hacker» segano quel fondo, inseriscono dentro la nave, poi riattaccano il fondo, e sembra che debba essere così.
Sotto il profilo della formulazione del problema sembra che sia tutto corretto. Ma prendo l'esempio delle navi: a cosa serve fare questa nave, a chi serve davvero? Non ha alcuna funzionalità. Di solito, queste navi sono regali per persone di grande rilievo, che la mettono su uno scaffale, come un simbolo, un segno. E se a una persona del genere, un dirigente d'azienda o un funzionario di alto rango, si presentasse una nave realizzata malamente, con il collo spezzato? È meglio che non lo scopra mai. Quindi, come si fanno alla fine queste navi che si possono regalare a una persona importante?
L'unico posto, chiave, su cui realmente non si può intervenire, è lo scafo. E lo scafo della nave passa proprio attraverso il collo. Mentre la nave viene assemblata al di fuori della bottiglia. Ma non è semplice assemblare una nave, è un vero e proprio lavoro di precisione. A pezzi vengono aggiunti speciali leve che permettono poi di sollevarli. Ad esempio, le vele vengono piegate, portate delicatamente all'interno e poi, con l'aiuto di una pinzetta, vengono sollevate con grande cura e precisione. Ne risulta un'opera d'arte che si può regalare con la coscienza pulita e con orgoglio.
E se vogliamo che il progetto abbia successo, nel team deve esserci almeno una persona artigiana. Quella che si preoccupa della qualità del prodotto e considera tutti gli aspetti, senza sacrificare nulla, anche nei momenti di stress, quando le circostanze richiedono di fare una cosa urgente a scapito di un aspetto importante. Tutti i progetti di successo, che sono solidi e che hanno resistito alla prova del tempo, si basano su questo principio. Contengono qualcosa di molto preciso e unico, qualcosa che sfrutta tutte le possibilità disponibili. Nell'esempio della nave nella bottiglia, si gioca sul fatto che lo scafo della nave passa attraverso il collo.
Tornando al compito di scegliere il nostro server di caching, come si potrebbe applicare questo approccio? Propongo un modo di scegliere tra tutti i sistemi esistenti: non agitare la bottiglia, non scegliere a caso, ma guardare cosa c'è in essi da considerare durante la scelta del sistema.
Dove cercare il collo di bottiglia
Cercheremo di non scuotere la bottiglia, di non esaminare tutto ciò che c'è in ordine, ma vedremo quali problemi sorgeranno se, nel caso, decidessimo di progettare un sistema simile da soli. Non costruiremo una bicicletta, ma utilizzeremo questo schema per orientarci su quali aspetti prestare attenzione nelle descrizioni dei prodotti. Disegneremo tale schema.
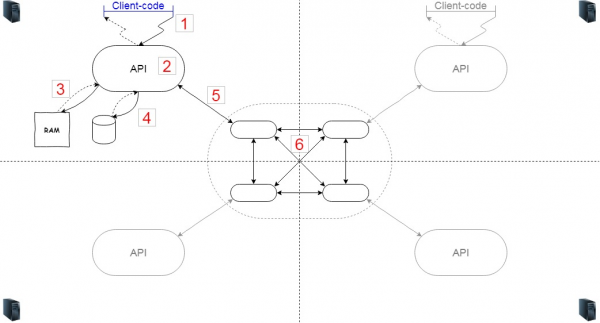
Se il sistema è distribuito, avremo diversi server (6). Supponiamo quattro (comodo da posizionare nell'immagine, ma in realtà possono essercene quanti ne vogliamo). Se i server sono su nodi diversi, significa che su di essi gira un certo codice che si occupa di far formare un cluster a questi nodi e, in caso di interruzione, di riconnetterli e fargli riconoscere l'un l'altro.
Serve anche un codice-logica (2) che si occupa effettivamente della memorizzazione nella cache. Con questo codice interagiscono i client tramite un certo API. Il codice client (1) può trovarsi all'interno della stessa JVM oppure può essere interpellato tramite rete. La logica implementata internamente riguarda quali oggetti mantenere nella cache e quali scartare. Utilizziamo la memoria (3) per memorizzare la cache, ma se necessario possiamo anche salvare parte dei dati su disco (4).
Diamo un'occhiata a quali parti genereranno il carico. In effetti, ogni freccia e ogni nodo subiranno un carico. In primo luogo, tra il codice client e l'API, se si tratta di un'interazione di rete, le perdite possono essere abbastanza evidenti. In secondo luogo, all'interno dell'API stessa, se esageriamo con logiche complesse, possiamo trovarci a dover gestire il CPU. E sarebbe meglio che la logica non utilizzi la memoria inutilmente. Infine, rimane l'interazione con il file system: nel caso normale si tratta di serializzare / ripristinare e scrivere / leggere.
Proseguiamo con l'interazione con il cluster. Probabilmente sarà nella stessa sistema, ma potrebbe anche essere separato. Qui dobbiamo anche considerare il passaggio dei dati, la velocità di serializzazione dei dati e l'interazione tra il cluster.
Ora, da un lato, possiamo immaginare "quali ingranaggi si muoveranno" nel sistema di cache durante l'elaborazione delle richieste dal nostro codice, e dall'altro lato, possiamo stimare quali e quante richieste genererà il nostro codice per questo sistema. Questo è sufficiente per fare una scelta abbastanza razionale – scegliere un sistema adatto al nostro caso d'uso.
Hazelcast
Vediamo come applicare questa scomposizione alla nostra lista. Ad esempio, Hazelcast.
Per inserire o prelevare dati da Hazelcast, il codice client accede (1) all'api. Hz consente di avviare il server come embedded, e in questo caso l'accesso all'api è una chiamata di metodo all'interno della JVM, che può essere considerata gratuita.
Per far funzionare la logica in (2), Hz si basa sul hash di un byte array del chiave serializzata – cioè, la serializzazione della chiave avverrà in ogni caso. Questo è un overhead inevitabile per Hz.
Le strategie di Eviction sono ben implementate, ma per casi particolari è possibile collegare le proprie. Non c'è bisogno di preoccuparsi per questa parte.
Il repository (4) può essere configurato. Eccellente. L'interazione (5) per embedded può essere considerata istantanea. Lo scambio di dati tra i nodi nel cluster (6) - sì, esiste. Questo contribuisce alla ridondanza a costo di velocità. Hz ha una funzione chiamata Near-cache che permette di ridurre i costi: i dati ottenuti da altri nodi del cluster saranno memorizzati nella cache.
Cosa si può fare in queste condizioni per aumentare la velocità?
Ad esempio, per evitare la serializzazione della chiave in (2) – sopra Hazelcast si può aggiungere un'altra cache, per i dati più caldi. In Sportmaster per questo scopo è stata scelta Caffeine.
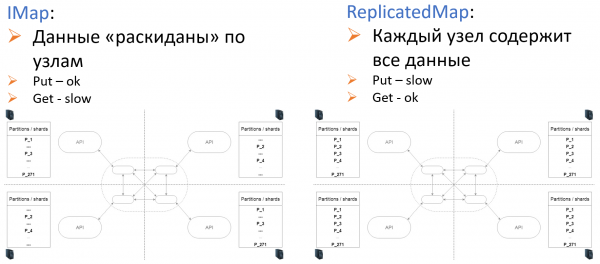
Per la configurazione a livello di (6), in Hz sono offerti due tipi di memorizzazione: IMap e ReplicatedMap.
È importante dire come Hazelcast sia entrato nello stack tecnologico di Sportmaster.
Nel 2012, quando stavamo lavorando sul primo pilota del futuro sito, Hazelcast è stato il primo link fornito dal motore di ricerca. L'incontro è avvenuto 'al primo colpo' — ci ha colpito il fatto che dopo sole due ore, quando abbiamo integrato Hz nel sistema — funzionava. E funzionava bene. Fino alla fine della giornata abbiamo scritto alcuni test, ci siamo congratulati. E questa energia è stata sufficiente per affrontare le sorprese che Hz ha riservato nel tempo. Ora il team di Sportmaster non ha motivi per rinunciare a Hazelcast.
Ma argomenti come 'primo link nel motore di ricerca' e 'abbiamo rapidamente assemblato HelloWorld' sono, ovviamente, un'eccezione e una peculiarità del momento in cui è avvenuta la scelta. Le vere prove per il sistema scelto iniziano con il passaggio alla produzione, ed è proprio su questo stadio che bisogna prestare attenzione quando si sceglie qualsiasi sistema, incluso il caching. In sostanza, nel nostro caso si può dire che abbiamo scelto Hazelcast per caso, ma poi si è rivelato di aver scelto correttamente.
Per la produzione, ciò che conta di più è: monitoraggio, gestione delle anomalie sui singoli nodi, replica dei dati, costi di scalabilità. Cioè, è importante prestare attenzione alle attività che emergeranno durante la gestione del sistema – quando il carico supererà di dieci volte quello pianificato, quando caricheremo accidentalmente qualcosa di sbagliato nel posto sbagliato, quando sarà necessario distribuire una nuova versione del codice, sostituire i dati e farlo senza che i clienti se ne accorgano.
Per tutti questi requisiti, Hazelcast è sicuramente adatto.
Continua...
Ma Hazelcast non è una panacea. Nel 2017 abbiamo scelto Hazelcast per la cache nell'interfaccia di amministrazione, semplicemente basandoci su una buona impressione del passato. Questo ha giocato un ruolo chiave in uno scherzo devastante, che ci ha portato in una situazione difficile e ci ha visto "eroicamente" combattere per uscirne per 60 giorni. Ma di questo parleremo nella prossima parte.
E nel frattempo… Buon codice nuovo!
Fonte: habr.com
