

Le immagini in formato JPEG si trovano ovunque nella nostra vita digitale, ma dietro questo velo di consapevolezza si nascondono algoritmi che eliminano dettagli impercettibili all'occhio umano. Ne risulta una qualità visiva straordinaria con la dimensione del file più ridotta possibile – ma come funziona esattamente tutto questo? Diamo un'occhiata a cosa non vedono i nostri occhi!
È facile dare per scontata la possibilità di inviare una foto a un amico, senza preoccuparsi di quale dispositivo, browser o sistema operativo stia utilizzando – ma non è stato sempre così. All'inizio degli anni '80, i computer erano in grado di memorizzare e visualizzare immagini digitali, ma c'erano molte idee concorrenti su quale fosse il modo migliore per farlo. Non era possibile semplicemente inviare un'immagine da un computer all'altro e sperare che tutto funzionasse.
Per affrontare questo problema, nel 1986 è stato formato un comitato di esperti provenienti da tutto il mondo chiamato "" (Joint Photographic Experts Group, JPEG), istituito attraverso la collaborazione dell'Organizzazione internazionale per la standardizzazione (ISO) e della Commissione Elettrotecnica Internazionale (IEC) – due organizzazioni internazionali per la standardizzazione con sede a Ginevra (Svizzera).
Il gruppo di persone conosciuto come JPEG ha creato lo standard di compressione delle immagini digitali JPEG nel 1992. Chiunque abbia utilizzato Internet avrà probabilmente incontrato immagini codificate in JPEG. È il modo più comune di codificare, inviare e memorizzare immagini. Dalle pagine web alle email e ai social media, JPEG viene utilizzato miliardi di volte al giorno – praticamente ogni volta che guardiamo un'immagine online o la inviamo. Senza JPEG, il web sarebbe meno vivace, più lento e probabilmente avrebbe meno foto di gattini!
Questo articolo tratta di come decodificare un'immagine JPEG. In altre parole, riguarda ciò che è necessario per trasformare i dati compressi memorizzati sul computer in un'immagine che appare sullo schermo. È importante sapere questo non solo perché è fondamentale per comprendere la tecnologia che usiamo quotidianamente, ma anche perché svelando i livelli di compressione impariamo meglio come percepiamo e vediamo, oltre a quali dettagli i nostri occhi percepiscono di più.
Inoltre, giocare con le immagini in questo modo è molto interessante.
Guardando dentro un JPEG
Sul computer tutto è memorizzato come una sequenza di numeri binari. Di solito, questi bit, zeri e uno, sono raggruppati in ottetti, formando byte. Quando apri un'immagine JPEG sul computer, qualcosa (un browser, il sistema operativo, qualcos'altro) deve decodificare i byte, ripristinando l'immagine originale sotto forma di un elenco di colori che possono essere visualizzati.
Se scarichi questa adorabile e la apri in un editor di testo, vedrai un sacco di simboli senza senso.
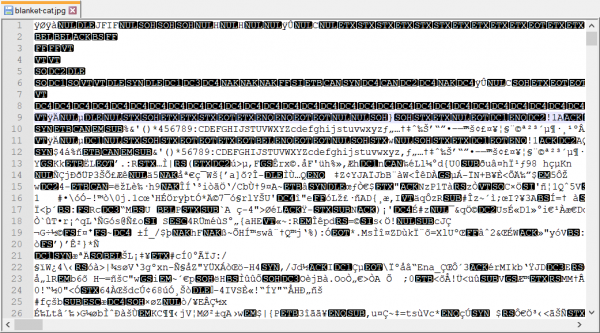
Qui utilizzo Notepad++ per esaminare il contenuto del file, poiché i normali editor di testo, come Notepad di Windows, rovinerebbero il file binario dopo il salvataggio, rendendolo non conforme al formato JPEG.
Aprendo un'immagine in un editor di testo, confondi il computer, proprio come confondi il tuo cervello quando ti strofini gli occhi e inizi a vedere macchie colorate!
Queste macchie che vedi sono conosciute come , e non sono il risultato dell'influenza di uno stimolo luminoso o allucinazioni generate dalla mente. Si verificano perché il tuo cervello presume che qualsiasi segnale elettrico nei nervi ottici trasmetta informazioni sulla luce. Il cervello deve fare tali ipotesi, poiché non è possibile sapere se un segnale è un suono, una visione o qualcos'altro. Tutti i nervi del corpo trasmettono impulsi elettrici assolutamente identici. Premendo sugli occhi, invii segnali che non sono visivi ma attivano i recettori oculari, che il tuo cervello interpreta – in questo caso, in modo errato – come qualcosa di visivo. Sei letteralmente in grado di vedere la pressione!
È divertente pensare a quanto i computer siano simili al cervello, tuttavia è anche un'analogia utile che illustra quanto il significato dei dati - trasmessi attraverso il corpo dai nervi o memorizzati su un computer - dipenda dalla loro interpretazione. Tutti i dati binari sono composti da zeri e uni, elementi di base capaci di trasmettere informazioni di qualsiasi tipo. Il tuo computer spesso indovina come interpretarli attraverso indizi, come le estensioni dei file. Ora lo costringiamo a interpretarli come testo, poiché è proprio ciò che si aspetta un editor di testo.
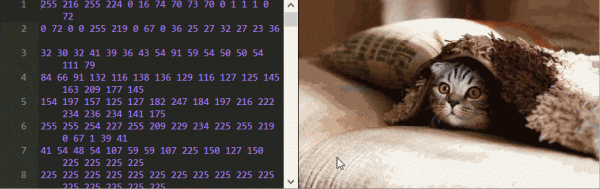
Per capire come decodificare un JPEG, dobbiamo vedere i segnali originali - i dati binari. Questo può essere fatto utilizzando un editor esadecimale, o direttamente su ! C'è un'immagine, accanto alla quale nel campo di testo sono indicati tutti i suoi byte (esclusa l'intestazione), rappresentati in forma decimale. Puoi modificarli e lo script ricodificherà e genererà una nuova immagine al volo.
Puoi scoprire molto semplicemente giocando con questo editor. Ad esempio, riesci a dire in quale ordine sono memorizzati i pixel?
In questo esempio, la cosa strana è che cambiare alcuni numeri non influisce affatto sull'immagine, mentre, per esempio, se sostituisci il numero 17 con 0 nella prima riga, la foto si rovina completamente!
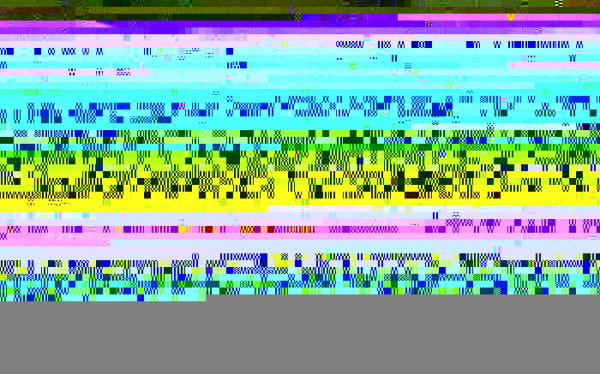
Altre modifiche, come sostituire 7 nella riga 1988 con il numero 254, cambiano il colore, ma solo dei pixel successivi.
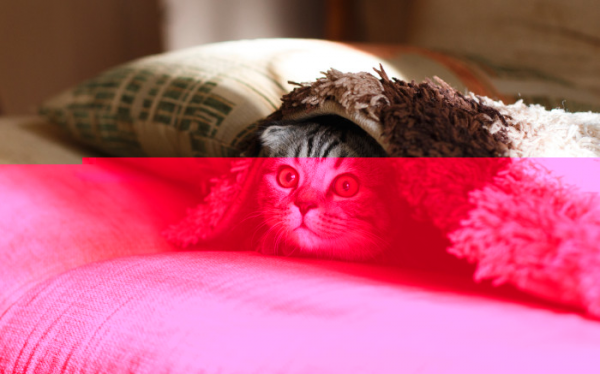
Forse la cosa più strana è che alcuni numeri cambiano non solo il colore, ma anche la forma dell'immagine. Cambia 70 nella riga 12 con 2 e guarda la riga superiore dell'immagine per vedere cosa intendo.
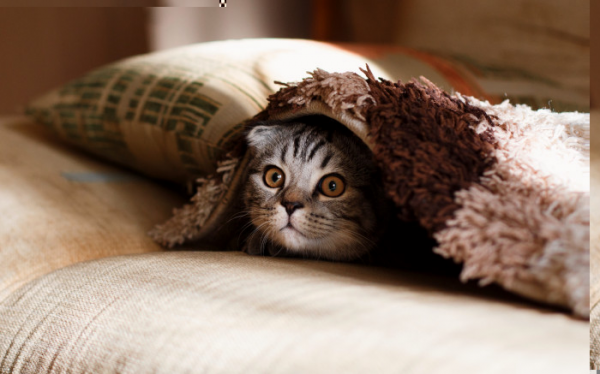
E indipendentemente dall'immagine JPEG che utilizzi, troverai sempre queste misteriose sequenze a scacchi quando modifichi i byte.
Giocando con l'editor, è difficile capire come venga ricreata la foto da questi byte, poiché la compressione JPEG si basa su tre diverse tecnologie che vengono applicate sequenzialmente. Esploreremo ciascuna di esse separatamente per svelare il comportamento misterioso che osserviamo.
Tre livelli di compressione JPEG:
- .
- .
- , e
Per darvi un'idea delle dimensioni della compressione, notate che l'immagine sopra rappresenta 79.819 numeri, ovvero circa 79 Kb. Se lo avessimo salvato senza compressione, sarebbero necessari tre numeri per ciascun pixel – per il rosso, il verde e il blu. Questo avrebbe significato 917.700 numeri, ovvero circa 917 Kb. Grazie alla compressione JPEG, il file finale è stato ridotto di oltre 10 volte!
In realtà, questa immagine può essere compressa ulteriormente. Qui sotto ci sono due immagini affiancate – la foto a destra è stata compressa a 16 Kb, ovvero 57 volte meno della versione non compressa!
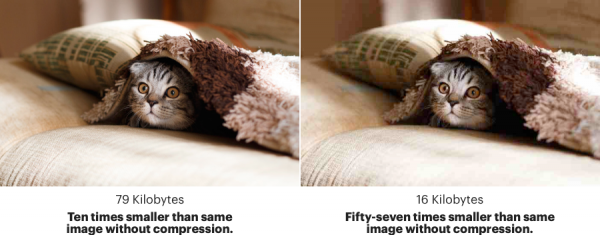
Se ci si osserva attentamente, si noterà che queste immagini non sono identiche. Entrambe sono immagini con compressione JPEG, ma quella a destra è molto più piccola. Inoltre, appare leggermente peggiore (guardate i quadrati dei colori di sfondo). Per questo motivo, il JPEG è conosciuto come compressione lossy; durante il processo di compressione l'immagine cambia e perde alcuni dettagli.
1. Sottocampionamento del colore
Ecco un'immagine con solo il primo livello di compressione applicato.
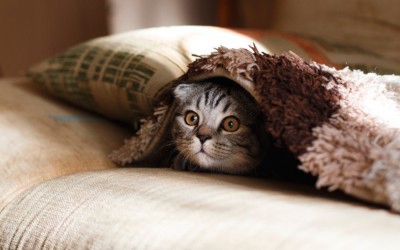
(Versione interattiva – nel dell'articolo). La rimozione di un numero compromette tutti i colori. Tuttavia, se si rimuovono esattamente sei numeri, questo non influisce praticamente sull'immagine.
Ora i numeri sono un po' più facili da decifrare. Quasi come una semplice lista di colori, in cui ogni byte modifica esattamente un pixel, ma a questo punto è già la metà delle dimensioni dell'immagine non compressa (che occuperebbe circa 300 Kb in questa dimensione ridotta). Riuscite a indovinare il perché?
Si può vedere che questi numeri non rappresentano le componenti standard rosso, verde e blu, poiché se si sostituiscono tutti i numeri con zeri, otteniamo un'immagine verde (anziché bianca).

Questo perché questi byte rappresentano Y (luminosità),
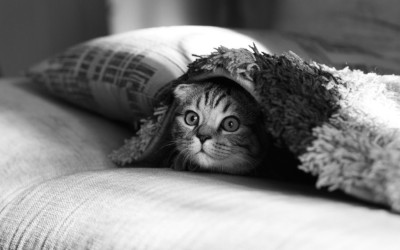
Cb (blues relative),
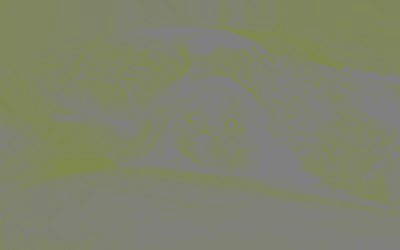
e Cr (rosso relativo) dell'immagine.
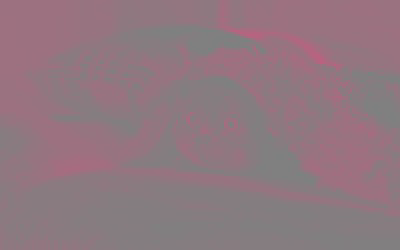
Perché non usare RGB? Dopotutto, è così che funzionano la maggior parte dei moderni schermi. Il tuo monitor può visualizzare qualsiasi colore, inclusi rosso, verde e blu con diverse intensità per ogni pixel. Il bianco si ottiene accendendo tutti e tre al massimo della luminosità, mentre il nero è il loro spegnimento.
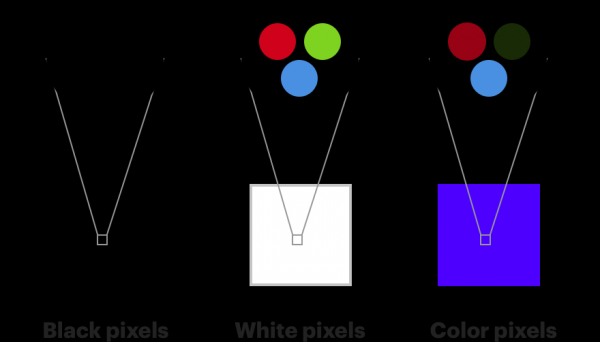
Questo è anche molto simile al funzionamento dell'occhio umano. I recettori di colore dei nostri occhi si chiamano "«, e si dividono in tre tipi, ognuno dei quali è più sensibile o al rosso, o al verde, o al blu [i coni di tipo S sono sensibili alla parte violetto-blu (S dall'inglese Short — spettro a onde corte), i coni di tipo M sono sensibili alla parte verde-gialla (M dall'inglese Medium — spettro a onde medie), e i coni di tipo L sono sensibili alla parte giallo-rossa (L dall'inglese Long — spettro a onde lunghe) dello spettro. La presenza di questi tre tipi di coni (e bastoncelli, sensibili alla parte verde smeraldo dello spettro) conferisce all'essere umano la visione a colori. / nota del traduttore]. , un altro tipo di fotorecettori nei nostri occhi, è in grado di rilevare le variazioni di luminosità, ma è molto più sensibile al colore. Nei nostri occhi ci sono circa 120 milioni di bastoncelli e solo 6 milioni di coni.
Pertanto, i nostri occhi notano molto meglio le variazioni di luminosità che le variazioni di colore. Se si separa il colore dalla luminosità, è possibile ridurre un po' il colore e nessuno se ne accorgerà. La sottodiscretizzazione del colore è il processo di rappresentazione dei componenti di colore di un'immagine a una risoluzione inferiore rispetto ai componenti di luminosità. Nell'esempio sopra, ogni pixel ha esattamente un componente Y, e ogni gruppo di quattro pixel ha esattamente un componente Cb e uno Cr. Di conseguenza, l'immagine contiene quattro volte meno informazioni di colore rispetto all'originale.
Lo spazio colore YCbCr non è usato solo in JPEG. È stato originariamente concepito nel 1938 per le trasmissioni televisive. Non tutti possiedono una televisione a colori, quindi la separazione del colore dalla luminosità ha permesso a tutti di ricevere lo stesso segnale, e le televisioni in bianco e nero utilizzavano solo il componente di luminosità.
Pertanto, la rimozione di un numero dall'editor distrugge completamente tutti i colori. I componenti sono memorizzati come Y Y Y Y Cb Cr (in realtà, non è obbligatorio seguire quest'ordine – l'ordine di memorizzazione è definito nell'intestazione del file). La rimozione del primo numero farà sì che il primo valore Cb venga interpretato come Y, Cr come Cb, e si ottiene così un effetto domino che cambia tutti i colori dell'immagine.
La specifica JPEG non ti obbliga a usare YCbCr. Tuttavia, nella maggior parte dei file viene utilizzata, poiché offre immagini di qualità superiore dopo la sottocampionatura rispetto a RGB. Ma non sei obbligato a credermi sulla parola. Guarda tu stesso nella tabella qui sotto come apparirà la sottocampionatura di ciascun componente sia in RGB che in YCbCr.
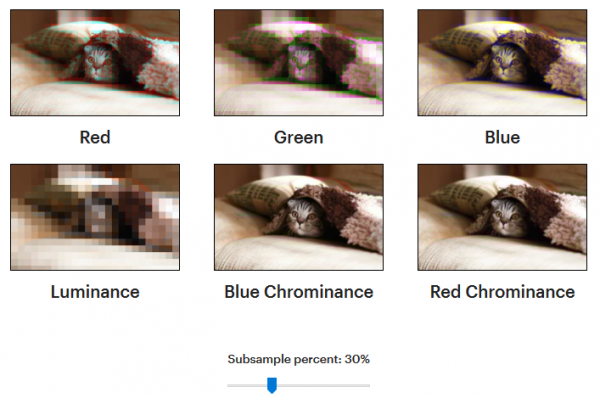
(Versione interattiva – nel articoli).
La rimozione del blu non è così evidente come quella del rosso o del verde. Questo perché, delle sei milioni di coni nei tuoi occhi, circa il 64% è sensibile al rosso, il 32% al verde e il 2% al blu.
La sottocampionatura del componente Y (in basso a sinistra) è la più evidente. Anche una piccola variazione è facilmente percepibile.
La conversione dell'immagine da RGB a YCbCr non riduce la dimensione del file, ma facilita la ricerca di dettagli meno evidenti che possono essere rimossi. La compressione con perdita avviene nella fase successiva. Alla base di questa c'è l'idea di rappresentare i dati in una forma più compressa.
2. Trasformata discreta del coseno e sottocampionatura
Questo livello di compressione definisce in gran parte l'essenza del JPEG. Dopo la conversione dei colori in YCbCr, i componenti vengono compressi separatamente, quindi possiamo concentrarci solo sul componente Y. Ed ecco come appare il byte del componente Y dopo l'applicazione di questo livello.
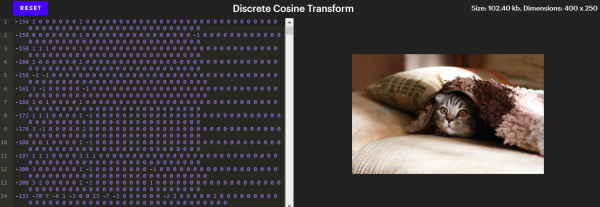
(Versione interattiva – nel articoli). Nella versione interattiva, cliccando su un pixel, il editor si sposta sulla riga che lo identifica. Prova a rimuovere dei numeri dalla fine o ad aggiungere degli zeri a un numero specifico.
A prima vista, sembra una compressione molto scadente. Nell'immagine ci sono 100.000 pixel e per indicare la loro luminosità (componenti Y) servono 102.400 numeri: è peggio che non comprimere affatto!
Tuttavia, nota che la maggior parte di questi numeri è pari a zero. Inoltre, tutti quegli zeri alla fine delle righe possono essere rimossi senza alterare l'immagine. Rimangono circa 26.000 numeri, che è già quasi quattro volte meno!
A questo livello si trova il segreto dei pattern scacchistici. A differenza di altri effetti che abbiamo visto, l'emergere di questi pattern non è un errore. Sono i mattoni dell'intera immagine. In ogni riga del editor ci sono esattamente 64 numeri, i coefficienti della trasformata discreta del coseno (DCT), che corrispondono alle intensità di 64 schemi unici.
Questi schemi si formano sulla base del grafico del coseno. Ecco come appaiono alcuni di essi:
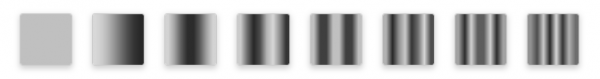
8 su 64 coefficienti
Di seguito è riportata un'immagine che mostra tutti i 64 schemi.
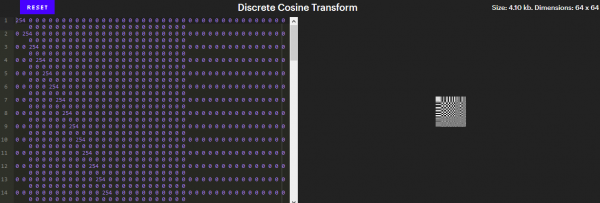
(Versione interattiva – nel articoli).
Questi schemi hanno un'importanza particolare, poiché formano la base delle immagini di dimensioni 8x8. Se non sei familiare con l'algebra lineare, ciò significa che qualsiasi immagine di dimensioni 8x8 può essere ottenuta da questi 64 schemi. La DCT è il processo di suddivisione delle immagini in blocchi 8x8 e di trasformazione di ciascun blocco in una combinazione di questi 64 coefficienti.
Il fatto che qualsiasi immagine possa essere composta da 64 schemi specifici sembra magico. Tuttavia, è lo stesso che dire che qualsiasi luogo sulla Terra può essere descritto da due numeri: latitudine e longitudine [con indicazione degli emisferi / ndr]. Spesso consideriamo la superficie della Terra come bidimensionale, quindi ci servono solo due numeri. Un'immagine 8x8 ha 64 dimensioni, quindi ci servono 64 numeri.
Non è ancora chiaro come questo ci aiuti in termini di compressione. Se abbiamo bisogno di 64 numeri per rappresentare un'immagine 8x8, perché questo approccio sarebbe migliore che semplicemente memorizzare 64 componenti di luminosità? Lo facciamo per lo stesso motivo per cui abbiamo trasformato tre numeri RGB in tre numeri YCbCr: ci permette di rimuovere dettagli impercettibili.
È difficile vedere quali dettagli vengano rimossi in questo stadio, poiché il JPEG applica la DCT ai blocchi 8x8. Tuttavia, nulla ci vieta di applicarlo all'intera immagine. Ecco come appare la DCT sulla componente Y applicata all'intera immagine:
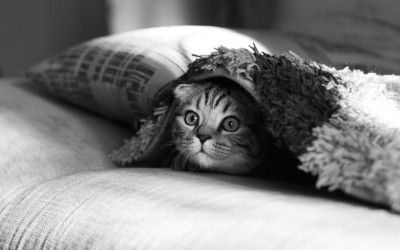
Dalla fine è possibile rimuovere oltre 60.000 numeri praticamente senza cambiamenti evidenti nella foto.
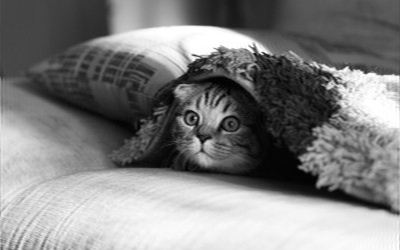
Tuttavia, nota che se azzeriamo i primi cinque numeri, la differenza sarà evidente.
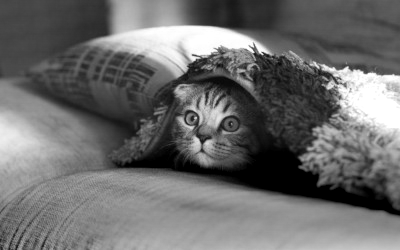
I numeri all'inizio rappresentano le variazioni a bassa frequenza nell'immagine, e i nostri occhi le rilevano meglio. I numeri più vicini alla fine rappresentano variazioni ad alta frequenza, che sono più difficili da notare. Per 'vedere ciò che non è visibile ad occhio', possiamo isolare questi dettagli ad alta frequenza azzerando i primi 5000 numeri.
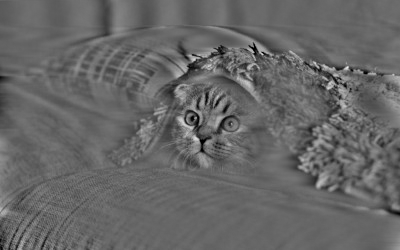
Vediamo tutte le aree dell'immagine in cui si verifica il maggior cambiamento da un pixel all'altro. Si evidenziano gli occhi del gatto, i suoi baffi, la coperta di spugna e le ombre nell'angolo in basso a sinistra. Possiamo andare oltre, azzerando i primi 10.000 numeri:
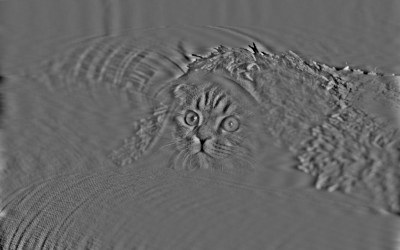
20 000:
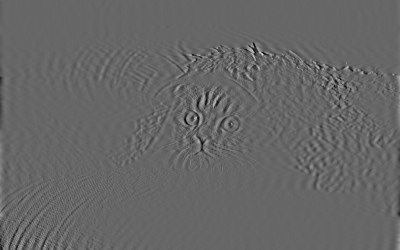
40 000:
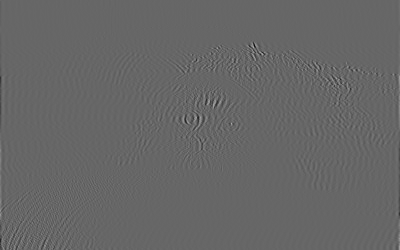
60 000:
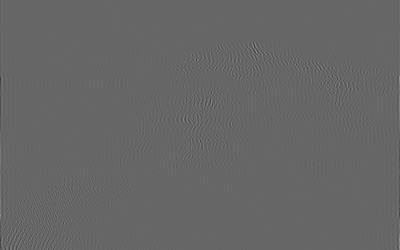
Questi dettagli ad alta frequenza JPEG vengono rimossi nella fase di compressione. La trasformazione dei colori in coefficienti DCT non comporta perdite. Le perdite si verificano nel passaggio di campionamento, dove vengono eliminate le grandezze ad alta frequenza o prossime allo zero. Quando riduci la qualità del salvataggio JPEG, il programma aumenta la soglia della quantità di valori rimossi, il che porta a una diminuzione delle dimensioni del file, ma rende l'immagine più pixelata. Ecco perché l'immagine nella prima sezione, che era 57 volte più piccola, appariva in questo modo. Ogni blocco 8x8 era rappresentato da un numero di coefficienti DCT molto inferiore rispetto alla versione di qualità superiore.
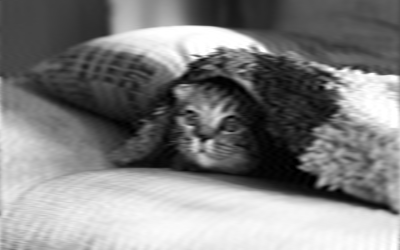
Puoi creare un effetto davvero interessante, come il caricamento graduale delle immagini. Puoi mostrare un'immagine sfocata che diventa sempre più dettagliata man mano che vengono scaricati ulteriori coefficienti.
Ecco, giusto per curiosità, cosa risulta utilizzando solo 24.000 numeri:
Oppure solo 5000:
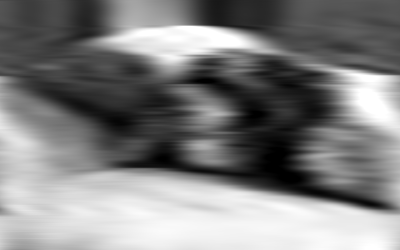
Molto sfocato, ma sembra quasi riconoscibile!
3. Codifica delle lunghezze delle sequenze, delta e Huffman
Fino ad ora, tutti i passaggi di compressione sono stati con perdite. L'ultimo passaggio, al contrario, è senza perdite. Non rimuove informazioni, ma riduce notevolmente le dimensioni del file.
Come si può comprimere qualcosa senza eliminare informazioni? Immagina come descriveremmo un semplice rettangolo nero di 700 x 437.
JPEG utilizza 5000 numeri per questo, ma si può ottenere un risultato molto migliore. Riesci a immaginare uno schema di codifica che descriva un'immagine simile con il minor numero possibile di byte?
Lo schema minimo che sono riuscito a ideare utilizza quattro: tre per indicare il colore e il quarto – quanti pixel hanno quel colore. L'idea di rappresentare valori ripetitivi in questo modo così compatto si chiama codifica delle lunghezze delle sequenze. Non comporta perdite, poiché possiamo ripristinare i dati codificati nella loro forma originale.
La dimensione del file JPEG con il rettangolo nero è molto più grande di 4 byte: ricordate che a livello DCT la compressione viene applicata ai blocchi di 8x8 pixel. Pertanto, abbiamo bisogno di almeno un coefficiente DCT per ogni 64 pixel. Uno ci serve perché, invece di memorizzare un coefficiente DCT seguito da 63 zeri, la codifica delle lunghezze delle serie ci consente di memorizzare un numero e indicare che "tutti gli altri sono zeri".
La codifica delta è una tecnica in cui ogni byte contiene la differenza rispetto a un certo valore, e non un valore assoluto. Pertanto, modificare determinati byte cambia il colore di tutti gli altri pixel. Ad esempio, invece di memorizzare
12 13 14 14 14 13 13 14
Potremmo iniziare da 12 e poi semplicemente indicare quanto aggiungere o sottrarre per ottenere il numero successivo. E questa sequenza nella codifica delta assume la forma:
12 1 1 0 0 -1 0 1
I dati trasformati non diventano più piccoli rispetto all'originale, ma è più facile comprimerli. L'applicazione della codifica delta prima della codifica delle lunghezze delle serie può essere molto utile, rimanendo una compressione lossless.
La codifica delta è una delle poche tecniche applicate al di fuori dei blocchi di 8x8. Su 64 coefficienti DCT, uno è semplicemente una funzione d'onda costante (un colore uniforme). Rappresenta la luminosità media di ciascun blocco per i componenti di luminosità, o la media di blu per i componenti Cb, e così via. Il primo valore di ciascun blocco DCT viene chiamato valore DC e ogni valore DC viene sottoposto a codifica delta rispetto al precedente. Pertanto, la modifica della luminosità del primo blocco influirà su tutti i blocchi.
Rimane l'ultimo mistero: come può la modifica di un singolo numero rovinare completamente l'immagine? Finora non c'erano tale proprietà nei livelli di compressione. La risposta risiede nell'intestazione JPEG. I primi 500 byte contengono metadati sull'immagine: larghezza, altezza e altro, e finché non lavoriamo con essi.
Senza intestazione è praticamente impossibile (o molto difficile) decodificare un JPEG. Apparirà come se stessi cercando di descriverti un dipinto e cominciassi a inventare parole per trasmettere la mia impressione. La descrizione sarà probabilmente piuttosto concisa, poiché posso inventare parole esattamente con il significato che voglio trasmettere, ma per tutti gli altri non avranno senso.
Può sembrare stupido, ma è proprio così che funziona. Ogni immagine JPEG viene compressa con codici specifici per essa. Il dizionario dei codici è conservato nell'intestazione. Questa tecnica è chiamata "codice di Huffman", e il dizionario è la tabella di Huffman. Nell'intestazione, la tabella è contrassegnata da due byte: 255 e poi 196. Ogni componente colore può avere la propria tabella.
Le modifiche alle tabelle influenzeranno radicalmente qualsiasi immagine. Un buon esempio è sostituire 1 con 12 nella riga 15.
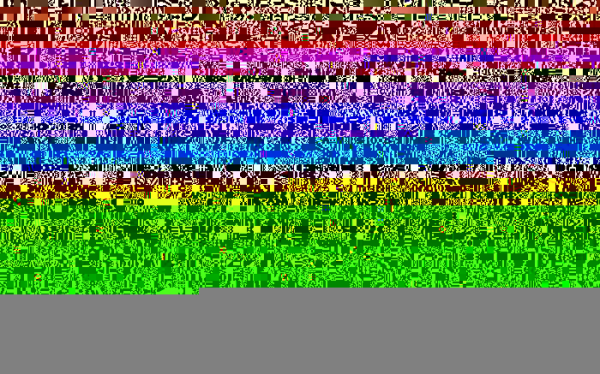
Ciò avviene perché nelle tabelle è indicato come devono essere letti i singoli bit. Finora abbiamo lavorato solo con numeri binari in forma decimale. Ma questo ci nasconde il fatto che se si desidera memorizzare il numero 1 in un byte, esso apparirà come 00000001, poiché in ogni byte devono esserci esattamente otto bit, anche se ne serve solo uno.
Potenzialmente, questo rappresenta un grande spreco di spazio se si hanno molti numeri piccoli. Il codice di Huffman è una tecnica che ci consente di allentare questo requisito secondo cui ogni numero deve occupare otto bit. Questo significa che se vedete due byte:
234 115
Allora, a seconda della tabella di Huffman, questi possono rappresentare tre numeri. Per estrarli, è necessario prima suddividerli in singoli bit:
11101010 01110011
Dopo ci si riferisce alla tabella per capire come raggrupparli. Ad esempio, possono essere i primi sei bit (111010), ossia 58 in decimale, seguiti da cinque bit (10011), ovvero 19, e infine gli ultimi quattro bit (0011), ossia 3.
Pertanto, a questo punto della compressione è molto difficile districarsi tra i byte. I byte non rappresentano ciò che sembra. Non entrerò nei dettagli dello svolgimento della tabella in questo articolo, ma per questa questione in rete .
Uno dei trucchi interessanti che si possono fare, sapendo questo, è separare l'intestazione dal JPEG e conservarla separatamente. Di fatto, ciò significa che solo voi potrete leggere il file. Facebook lo fa per ridurre ulteriormente le dimensioni dei file.
Un altro modo per procedere è modificare leggermente la tabella di Huffman. Per gli altri, questo apparirà come un'immagine rovinata. E solo voi conoscerete il modo magico per ripararla.
Facciamo un riepilogo: cosa serve per decodificare un JPEG? Serve:
- Estrare la tabella (o le tabelle) di Huffman dall'intestazione e decodificare i bit.
- Estrai i coefficienti della trasformata discreta del coseno per ogni componente colore e luminosità per ciascun blocco 8x8, eseguendo le trasformazioni inverse della codifica delle lunghe sequenze e delle differenze.
- Combina i coseni basati sui coefficienti per ottenere i valori dei pixel per ciascun blocco 8x8.
- Scala i componenti dei colori, se è stata eseguita la sottocampionatura (queste informazioni sono contenute nell'intestazione).
- Trasforma i valori YCbCr ottenuti per ogni pixel in RGB.
- Mostra l'immagine sullo schermo!
Un lavoro serio per semplicemente visualizzare una foto di un gatto! Tuttavia, ciò che mi piace di questo è che si può vedere quanto la tecnologia JPEG sia centrata sull'essere umano. Essa si basa sulle caratteristiche della nostra percezione, consentendo di ottenere una compressione notevolmente migliore rispetto alle tecnologie normali. E ora, comprendendo come funziona JPEG, è possibile immaginare come queste tecnologie possano essere trasferite in altri ambiti. Ad esempio, la codifica delle differenze nei video può portare a una significativa riduzione delle dimensioni del file, poiché spesso ci sono aree intere che non cambiano da un fotogramma all'altro (ad esempio, lo sfondo).
, è aperto e contiene istruzioni su come sostituire le immagini con le proprie.
Fonte: habr.com
