

Trascrizione della presentazione del 2015 di Ilya Kosmodemyansky "Ottimizzazione di Linux per migliorare le prestazioni di PostgreSQL"
Dichiarazione: Vorrei sottolineare che questa presentazione risale a novembre 2015: sono passati più di 4 anni e un bel po' di tempo. La versione di cui si parla nella presentazione, 9.4, non è più supportata. Negli ultimi 4 anni sono state rilasciate 5 nuove versioni di PostgreSQL e 15 versioni del kernel Linux. Se si riscrivono questi punti, alla fine si otterrebbe una presentazione diversa. Tuttavia, qui viene trattata l'ottimizzazione fondamentale di Linux per PostgreSQL, che è ancora attuale.
Mi chiamo Ilya Kosmodemyansky. Lavoro per PostgreSQL-Consulting. E ora parlerò un po' di cosa fare con Linux relativamente ai database in generale e a PostgreSQL in particolare, poiché i principi sono piuttosto simili.
Di cosa parleremo? Se si interagisce con PostgreSQL, in una certa misura è necessario essere un amministratore UNIX. Cosa significa? Se confrontiamo Oracle e PostgreSQL, con Oracle devi essere per l'80% un amministratore DBA del database e per il 20% un amministratore Linux.
Con PostgreSQL è un po' più complesso. Con PostgreSQL è necessario avere una comprensione molto più approfondita di come funziona Linux. E nel frattempo, bisogna un po' correre dietro al treno, perché recentemente ci sono stati molti aggiornamenti. Sono uscite nuove versioni del kernel e nuove funzionalità, le prestazioni sono migliorate, e così via.
Perché parliamo di Linux? Non solo perché siamo alla conferenza Linux a San Pietroburgo, ma perché, nelle condizioni attuali, uno dei sistemi operativi più giustificati per l'uso con i database in generale e con PostgreSQL in particolare è Linux. Perché FreeBSD, sfortunatamente, si sta sviluppando in una direzione piuttosto strana. Ci saranno problemi sia con le prestazioni che con molte altre cose. Le prestazioni di PostgreSQL su Windows sono un tema completamente diverso e difficile, legato al fatto che Windows non ha una memoria condivisa come UNIX, e PostgreSQL si basa molto su questo, poiché è un sistema multiprocesso.
E l'esotismo come Solaris, penso che interessi a meno persone, quindi andiamo.
Un moderno distribuzione di Linux ha più di 1.000 parametri syctl, a seconda di come viene compilato il kernel. Inoltre, se guardiamo a diverse impostazioni, ci sono molti altri modi per effettuare configurazioni. Ci sono parametri di file system, come montare. Se ci sono domande su come avviare: cosa attivare nel BIOS, come configurare l'hardware, ecc.
È un volume molto grande di cui si può parlare per diversi giorni, non in una breve presentazione, ma ora mi concentrerò su punti importanti, come evitare gli ostacoli che sicuramente non vi permetteranno di utilizzare bene il database su Linux, se non li correggete. E un punto importante è che molti parametri sono attivati di default non in impostazioni corrette per il database. Cioè, di default funzionerà male o non funzionerà affatto.
Quali sono i tradizionali obiettivi di tuning in Linux? Penso che, dato che tutti voi avete a che fare con l'amministrazione di Linux, non sia necessario spiegare cosa siano gli obiettivi.
Si può ottimizzare:
- CPU.
- Memoria.
- Storage.
- Altro. Di questo ne parleremo alla fine come dessert. Anche, ad esempio, parametri come le politiche di risparmio energetico possono influenzare le prestazioni in modo molto imprevedibile e poco gradevole.
Qual è la specificità di PostgreSQL e di un database in generale? Il problema è che non si può ottimizzare un singolo parametro e vedere che le prestazioni sono notevolmente migliorate.
Sì, ci sono parametri di questo tipo, ma un database è una cosa complessa. Interagisce con tutte le risorse disponibili sul server e preferisce interagire a pieno regime. Se guardate le raccomandazioni moderne di Oracle su come utilizzare il sistema operativo host, sarà come la barzelletta del cosmonauta mongolo - dare da mangiare al cane e non toccare nulla. Diamo al database tutte le risorse, il database si occuperà di tutto.
In linea di principio, ci sono situazioni simili anche con PostgreSQL. La differenza è che il database non può appropriarsi di tutte le risorse autonomamente, cioè in alcuni casi è necessario gestire tutto questo a livello di Linux.
L'idea principale è di non scegliere un unico target e iniziare a modificarlo, ad esempio, la memoria, la CPU o qualcosa del genere, ma analizzare il carico di lavoro e cercare di migliorare al massimo la capacità di elaborazione, affinché il carico creato dai bravi programmatori, compresi i nostri utenti, passi attraverso il nostro database nel modo più efficiente possibile.
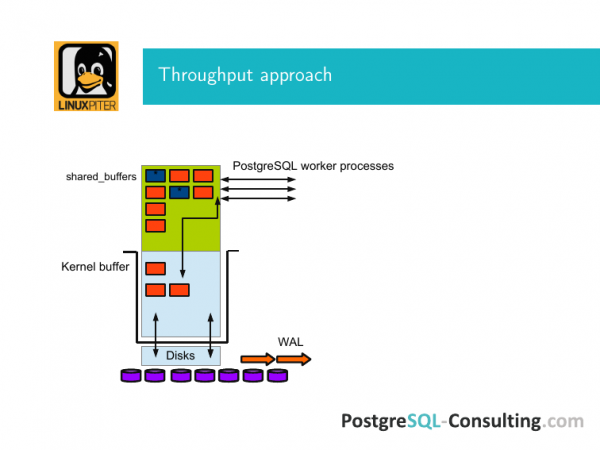
Ecco un'immagine per spiegare di cosa si tratta. C'è il buffer del sistema operativo Linux, la memoria condivisa e i buffer condivisi di PostgreSQL. A differenza di Oracle, PostgreSQL lavora direttamente tramite il buffer del kernel, quindi affinché una pagina proveniente dal disco entri nella sua memoria condivisa, deve passare attraverso il kernel buffer, e la stessa situazione vale per il ritorno.
Sotto questo sistema ci sono i dischi. Li ho rappresentati come dischi, ma in realtà ci può essere un controller RAID, ecc.
E questo input-output avviene comunque attraverso questa cosa.
PostgreSQL è un classico sistema di database. All'interno ci sono delle pagine. Tutto l'input-output avviene tramite queste pagine. Carichiamo blocchi in memoria mediante le pagine. E se non è successo nulla, le abbiamo solo lette, allora piano piano esse escono da questa cache, dai buffer condivisi e tornano indietro sul disco.
Se abbiamo sostituito qualcosa, l'intera pagina viene contrassegnata come sporca. Le ho evidenziate in blu. Questo significa che questa pagina deve essere sincronizzata con lo storage a blocchi. Cioè, quando è diventata sporca, abbiamo effettuato una scrittura nel WAL. E a un certo punto, è avvenuto un evento chiamato checkpoint. E in questo log è stata registrata l'informazione che è avvenuto. Questo significa che tutte le pagine sporche che in quel momento si trovavano nei buffer condivisi sono state sincronizzate con il disco dello storage tramite fsync attraverso il kernel buffer.
A cosa serve tutto ciò? Se perdiamo l'alimentazione, non ci troveremo nella situazione in cui tutti i dati sono scomparsi. La memoria persistente, di cui ci hanno parlato, rappresenta ancora, in teoria dei database, un futuro luminoso verso cui stiamo certamente tendendo e che ci piace, ma per ora vive ancora con un ritardo di 20 anni. E, naturalmente, è necessario tenere tutto questo sotto controllo.
E l'obiettivo di massimizzare la larghezza di banda è ottimizzare tutti questi passaggi affinché tutto funzioni rapidamente. La memoria condivisa è fondamentalmente una cache di pagine. In PostgreSQL abbiamo inviato una query select di qualcosa, ha recuperato questi dati dal disco. Sono andati nei buffer condivisi. Pertanto, per migliorare il funzionamento, è necessaria una grande quantità di memoria.
Affinché tutto funzioni bene e velocemente, è necessario configurare correttamente il sistema operativo a tutti i livelli. E scegliere l'hardware in modo bilanciato, perché se in qualche punto c'è uno squilibrio, puoi avere molta memoria, ma sarà servita a una velocità insufficiente.
E passeremo in rassegna ciascuno di questi punti.
Per garantire che queste pagine viaggino avanti e indietro più velocemente, è necessario raggiungere i seguenti obiettivi:
- Innanzitutto, è necessario lavorare più efficientemente con la memoria.
- In secondo luogo, deve esserci un miglioramento nel passaggio da quando le pagine passano dalla memoria al disco.
- E, in terzo luogo, devono esserci dischi di buona qualità.
Se hai 512 GB di memoria RAM in server e tutto questo alla fine arriva su un disco rigido SATA senza alcuna cache, allora tutto il server del database non si trasforma solo in una zucca, ma in una zucca con un'interfaccia SATA. Ti scontrerai direttamente con questo. E nulla ti salverà.
Per quanto riguarda il primo punto sulla memoria, ci sono tre aspetti che possono complicare notevolmente la vita.
Il primo di questi è il NUMA. NUMA è una tecnologia progettata per migliorare le prestazioni. A seconda del carico di lavoro, puoi ottimizzare diverse cose. E nella sua attuale forma, non è ideale per applicazioni come i database che utilizzano intensivamente la cache delle pagine nei buffer condivisi.
In poche parole. Come capire che c'è qualcosa che non va con il NUMA? Hai qualche rumore fastidioso, improvvisamente una CPU risulta sovraccarica. Allo stesso tempo, stai analizzando le query in PostgreSQL e vedi che non c'è nulla di simile lì. Queste query non dovrebbero consumare così intensamente la CPU. Puoi impiegare molto tempo a individuarlo. È più semplice seguire sin dall'inizio il giusto consiglio su come configurare il NUMA per PostgreSQL.
Cosa succede realmente? NUMA sta per Non-Uniform Memory Access. Di cosa si tratta? Hai una CPU, accanto a essa c'è la sua memoria locale. E questa memoria interconnessa può recuperare memoria da altre CPU.
Se esegui numactl --hardware, ti verrà fuori un grande foglio. Tra l'altro ci sarà il campo distances. Ci saranno dei numeri – 10-20, qualcosa del genere. Questi numeri non sono altro che il numero di hop necessari per collegare questa memoria remota e utilizzarla localmente. In sostanza, è una buona idea. Questo migliora notevolmente le prestazioni in determinate situazioni.
Ora immagina che tu abbia una CPU che prima cerca di utilizzare la sua memoria locale, poi cerca di tirare altra memoria tramite interconnect per qualche motivo. E su questa CPU viene caricato tutto il tuo page cache di PostgreSQL – tutto, qualche giga. Ottieni sempre il caso peggiore, perché su CPU direttamente in quel modulo di memoria di solito ce n'è poca. E tutta la memoria che viene gestita passa attraverso questi interconnect. Risultato: è lento e deludente. E hai un processore che gestisce questo nodo, costantemente sovraccarico. E il tempo di accesso a questa memoria è scadente, lento. Questa è una situazione da evitare se utilizzi questo tipo di tecnologia per i database.
Pertanto, una soluzione migliore per i database sarebbe che il sistema operativo Linux non sapesse affatto cosa sta succedendo. Dovrebbe accedere alla memoria come fa normalmente.
Perché così? Sembrerebbe dovesse essere il contrario. Questo accade per una semplice ragione: abbiamo bisogno di molta memoria per il page cache – decine, centinaia di gigabyte.
E se abbiamo allocato tutto e memorizzato i nostri dati lì, il guadagno nell'utilizzare la cache sarà sostanzialmente maggiore rispetto al vantaggio di un accesso alla memoria così ingegnoso. In questo modo, realizziamo un vantaggio incomparabile rispetto a come potremmo accedere in modo più efficiente alla memoria utilizzando NUMA.
Quindi al momento ci sono due approcci, finché non arriverà un futuro luminoso in cui il database sarà in grado di capire su quali CPU sta operando e da dove ha bisogno di tirare alcune informazioni.
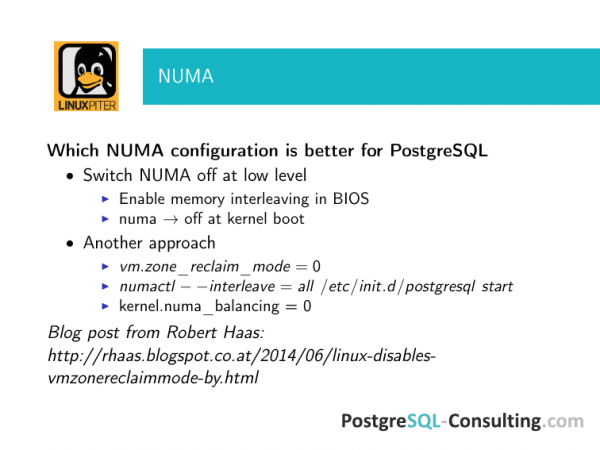
Pertanto, l'approccio giusto è disabilitare completamente NUMA, ad esempio, al riavvio. Nella maggior parte dei casi, i vantaggi sono tali da non lasciare alcun dubbio su quale sia la scelta migliore.
C'è un'altra opzione. La utilizziamo più spesso della prima, perché quando un cliente si rivolge a noi per assistenza, riavviare il server è un grosso problema per lui. Ha un'attività da gestire. E si trovano ad affrontare problemi a causa di NUMA. Pertanto, cerchiamo di disattivare il tutto in modi meno invasivi rispetto al reboot, ma qui dovete controllare attentamente che si sia realmente disattivato. Perché, come dimostra l'esperienza, anche se disattiviamo il NUMA per il processo principale di PostgreSQL, ciò è buono, ma non è affatto garantito che funzioni. È necessario verificare e controllare che si sia effettivamente disattivato.
C'è un buon post di Robert Haas. È uno dei committers di PostgreSQL. Uno dei principali sviluppatori di tutti i meccanismi a basso livello. E se seguite i link di quel post, troverete alcune storie colorite su come NUMA abbia complicato la vita a molte persone. Date un'occhiata, studiate la checklist per sistemisti, su cosa configurare nel server affinché il nostro database funzioni bene. Queste impostazioni devono essere annotate e verificate, perché altrimenti non andrà affatto bene.
Faccio presente che questo riguarda tutte le impostazioni di cui parlerò. Ma di solito i database vengono configurati in modalità master-slave per garantire la resilienza. Non dimenticate di apportare queste configurazioni anche sullo slave, perché a un certo punto potreste subire un guasto, e passerete allo slave, che diventerà master.
In situazioni di emergenza, quando tutto va male, vi suonerà continuamente il telefono e il vostro capo arriverà con un grande bastone, non avrete tempo per pensare di controllare. E i risultati potrebbero essere molto disastrosi.
Il punto successivo riguarda le huge pages. Le huge pages sono difficili da testare separatamente e non ha nemmeno senso farlo, anche se ci sono benchmark che sanno farlo. Si trovano facilmente su Google.
Qual è il significato? Avete un server non molto costoso, con molta RAM, ad esempio, oltre 30 GB. Non state utilizzando le huge pages. Questo significa che c'è sicuramente un sovraccarico nell'uso della memoria. E questo sovraccarico è tutt'altro che piacevole.
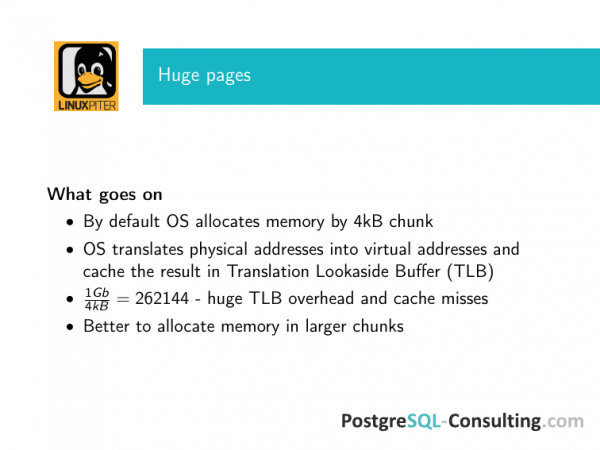
Perché così? E cosa sta succedendo? Il sistema operativo assegna la memoria a piccoli pezzi. Così è comodo, così è storicamente avvenuto. E se approfondiamo, il sistema operativo deve tradurre gli indirizzi virtuali in indirizzi fisici. Questo processo non è dei più semplici, quindi il sistema operativo memorizza nella cache il risultato di questa operazione nel Translation Lookaside Buffer (TLB).
E poiché il TLB è una cache, in questa situazione sorgono tutti i problemi tipici delle cache. In primo luogo, se hai molta memoria RAM e viene allocata a piccoli chunk, questo buffer diventa molto grande. E se la cache è grande, cercare in essa diventa più lento. L'overhead è significativo e occupa spazio, cioè consuma una parte della RAM in modo inefficace. Questo è il primo punto.
Secondo – più cresce la cache in questa situazione, maggiore è la probabilità di avere cache misses. L'efficienza di questa cache diminuisce rapidamente all'aumentare delle sue dimensioni. Per questo motivo, i sistemi operativi hanno ideato un approccio semplice. In Linux è utilizzato da tempo. In FreeBSD è comparso abbastanza di recente. Ma stiamo parlando di Linux. Questi sono i huge pages.
E qui va notato che i huge pages, come idea, sono stati inizialmente promossi da comunità che includevano Oracle e IBM, cioè i produttori di database pensavano seriamente che potesse tornare utile anche per i database.
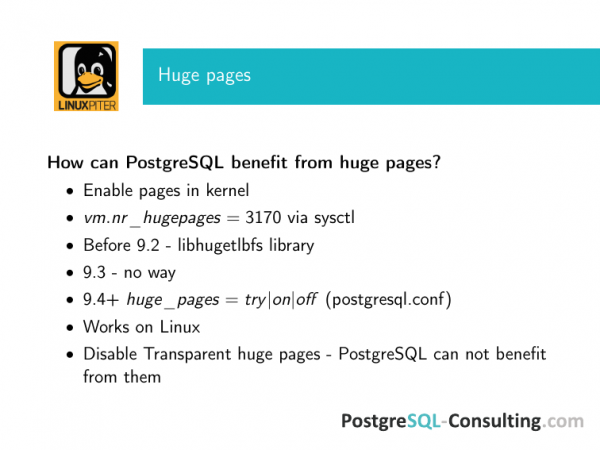
E come si può integrare con PostgreSQL? Innanzitutto, nel kernel di Linux devono essere abilitati i huge pages.
In secondo luogo, devono essere esplicitamente indicati con il parametro sysctl – quanti ce ne sono. I numeri qui provengono da un vecchio server. Puoi calcolare quanti shared buffers hai circa, in modo che ci stiano i huge pages.
E se hai dedicato l'intero server a PostgreSQL, un buon punto di partenza è assegnare il 25% della RAM agli shared buffers, oppure il 75%, se sei sicuro che nel 75% ci starà sicuramente il tuo database. Questo è il primo punto di partenza. E calcola che, se hai 256 GB di RAM, avrai quindi circa 64 GB di shared buffers. Calcola circa con un certo margine – a quale cifra dovrebbe corrispondere.
Fino alla versione 9.2 (se non sbaglio, dalla versione 8.2) era possibile integrare PostgreSQL con huge pages tramite una libreria di terze parti. E questo è sempre necessario. Innanzitutto, è fondamentale che il kernel sia in grado di allocare correttamente le huge pages. In secondo luogo, l'applicazione che lavora con queste deve poterle utilizzare. Non ci si può semplicemente aspettare di utilizzarle. Poiché PostgreSQL allocava memoria con lo stile system 5, questo era possibile grazie a libhugetlbfs — questo è il nome completo della libreria.
Nella versione 9.3 è migliorata la gestione della memoria in PostgreSQL e si è abbandonato il metodo di allocazione della memoria system 5. Tutti erano molto contenti, perché altrimenti, se provavi a lanciare due istanze di PostgreSQL sulla stessa macchina, ti diceva che la memoria condivisa era insufficiente. E ti indicava di modificare sysctl. E c'era un sysctl tale che bisognava anche riavviare, ecc. In generale, la contentezza era diffusa. Ma l'allocazione della memoria mmap ha compromesso l'uso delle huge pages. La maggior parte dei nostri clienti utilizza grandi shared buffers. E abbiamo fortemente raccomandato di non passare alla versione 9.3, perché lì l'overhead iniziava a essere calcolato in percentuali significative.
Tuttavia, la community ha prestato attenzione a questo problema e nella versione 9.4 è stata notevolmente rielaborata questa funzionalità. Nella 9.4 è stata introdotta un'opzione in postgresql.conf per abilitare try, on o off.
Try è l'opzione più sicura. All'avvio di PostgreSQL, quando alloca memoria condivisa, cerca di ottenere questa memoria dalle huge pages. E se non ci riesce, torna all'allocazione normale. Se utilizzi FreeBSD o Solaris, puoi impostare try, è sempre sicuro.
Se on, semplicemente non si avvia se non riesce ad allocare dalle huge pages. Qui dipende da preferenze di ciascuno. Ma se hai impostato try, controlla che ciò che deve essere allocato lo sia davvero, perché ci sono ampi margini di errore. Attualmente, questa funzionalità funziona solo su Linux.
Un'altra piccola nota prima di procedere. Le Transparent huge pages non riguardano ancora PostgreSQL. Non possono essere utilizzate in modo adeguato. E con le Transparent huge pages, per un carico di lavoro del genere, dove è necessario un grande blocco di memoria condivisa, i vantaggi si manifestano solo con volumi molto elevati. Se avete terabyte di memoria, allora questo può avere un certo rilievo. Se parliamo di applicazioni più comuni, dove avete 32, 64, 128, 256 GB di memoria sulla macchina, allora le huge pages normali vanno bene, mentre le Transparent devono essere disattivate.
E l'ultima cosa riguardante la memoria, che non è direttamente collegata al throughput, può complicare molto le cose. L'intera capacità di throughput può risentirne notevolmente se il server continua a fare swap.
E questo sarà davvero sgradevole in diverse circostanze. La difficoltà principale è che nei kernel moderni il comportamento è leggermente diverso rispetto ai kernel Linux più vecchi. E questa è una problematica che può essere piuttosto sgradevole, perché quando parliamo di un qualche lavoro con lo swap, si conclude con un'arrivo intempestivo dell'oom-killer. E l'oom-killer che arriva in ritardo e termina PostgreSQL è davvero spiacevole. Questo lo sapranno tutti, cioè fino all'ultimo utente.
Cosa succede? Avete una grande quantità di memoria RAM, tutto funziona bene. Ma per qualche motivo, il server è bloccato nello swap e ciò causa rallentamenti. Sembrerebbe che ci sia sufficiente memoria, eppure succede.
In passato consigliavamo di impostare vm.swappiness a zero, cioè disattivare lo swap. Prima si pensava che 32 GB di memoria RAM e i relativi buffer condivisi fossero una quantità enorme. La principale funzione dello swap è fornire uno spazio dove trasferire i processi se c'è un errore. E questa funzione non veniva più così frequentemente utilizzata. E cosa farai poi con quel processo? È una questione non chiara sull'effettivo utilizzo dello swap, soprattutto di tali dimensioni.
Ma nelle versioni più moderne, ovvero nella terza versione del kernel, il comportamento è cambiato. E se si imposta swap a zero, cioè si disattiva, prima o poi, anche con una certa quantità di memoria RAM residua, l'OOM-killer arriverà per uccidere i consumatori più intensivi. Perché egli considererà che con un tale carico di lavoro ci rimane ancora un po' e noi rischiamo di esaurirci, quindi non ucciderà i processi di sistema, ma qualcosa di meno importante. Questo meno importante si rivelerà essere un consumatore intensivo di memoria condivisa, ovvero il postmaster. E dopo ciò sarà un bene se non sarà necessario ripristinare il database.
Quindi attualmente, se ricordo bene, la maggior parte delle distribuzioni ha un valore predefinito di circa 6, cioè in quale momento iniziare a usare lo swap a seconda di quanta memoria è rimasta. Adesso consigliamo di impostare vm.swappiness = 1, perché praticamente lo disattiva, ma non ha effetti simili a un OOM-killer che arriva inaspettatamente e termina tutto quanto.
Cosa c'è dopo? Quando parliamo delle prestazioni dei database e ci avviciniamo progressivamente ai dischi, tutti iniziano a prendere a protezione la testa. Perché la verità che il disco è lento e la memoria è veloce è conosciuta da tutti fin dall'infanzia. E tutti sanno che ci saranno problemi di prestazioni disco nel database.
Il principale problema di prestazioni di PostgreSQL, legato ai picchi di checkpoint, non deriva dal fatto che il disco è lento. È, piuttosto, che la capacità di memoria e disco non è bilanciata. Inoltre, possono non essere bilanciate in modi diversi. PostgreSQL non è configurato, il sistema operativo non è configurato, l'hardware non è configurato e l'hardware è sbagliato. E questo problema non si verifica solo se tutto avviene come dovrebbe, cioè o non ci sono carichi o le impostazioni e l'hardware sono ben scelti.
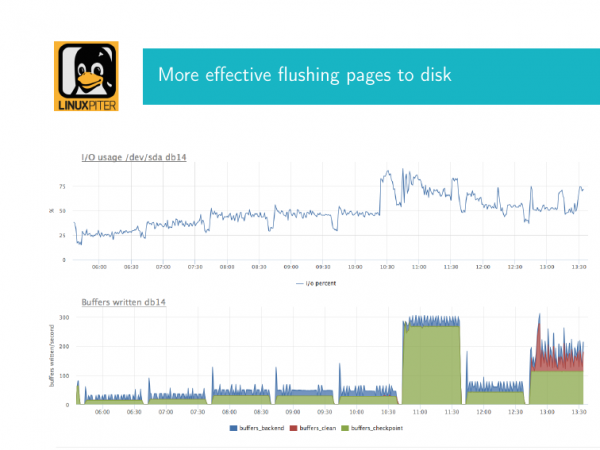
Che cos'è e come appare? Di solito, le persone che lavorano con PostgreSQL si sono già imbattute in questo problema diverse volte. Spiegherò. Come ho detto, PostgreSQL esegue periodicamente dei checkpoints per scrivere le pagine sporche dalla memoria condivisa su disco. Se abbiamo un grande volume di memoria condivisa, il checkpoint inizia a influenzare intensamente il disco, poiché scrive queste pagine utilizzando fsync. Esse arrivano nel buffer del kernel e vengono scritte sui dischi tramite fsync. E se il volume è grande, possiamo osservare un effetto sgradevole, ovvero un'alta utilizzo dei dischi.
Qui ho due immagini. Ora spiegherò di cosa si tratta. Si tratta di due grafici correlati nel tempo. Il primo grafico rappresenta l'utilizzo del disco. A questo punto, raggiunge quasi il 90%. Se il vostro sistema di database ha dischi fisici, con un controller RAID che raggiunge un utilizzo vicino al 90%, sono brutte notizie. Significa che se continua, arriveremo al 100% e l'input-output si fermerà.
Se avete un array di dischi, la storia è un po' diversa. Dipende da come è configurato, che tipo di array si tratta, ecc.
Parallelamente, qui è configurato un grafico da una vista interna di postgres, che mostra come avviene il checkpoint. In verde è indicato il numero di buffer, queste pagine sporche, che sono arrivate in questo checkpoint per la sincronizzazione. Questo è l'aspetto principale da sapere. Vediamo che sono arrivate molte pagine e a un certo punto ci siamo scontrati con il limite, cioè abbiamo scritto tanto, e chiaramente il sistema disco è molto occupato. Inoltre, il nostro checkpoint influisce notevolmente sul disco. Idealmente, la situazione dovrebbe apparire in modo diverso, cioè con meno scritture. Possiamo ottimizzare le impostazioni per mantenere questa situazione. Cioè, un'utilizzazione bassa, ma scriviamo comunque da qualche parte.
Cosa bisogna fare per risolvere questo problema? Se l'IO per il database si è fermato, significa che tutti gli utenti che hanno tentato di eseguire le proprie query dovranno aspettare.
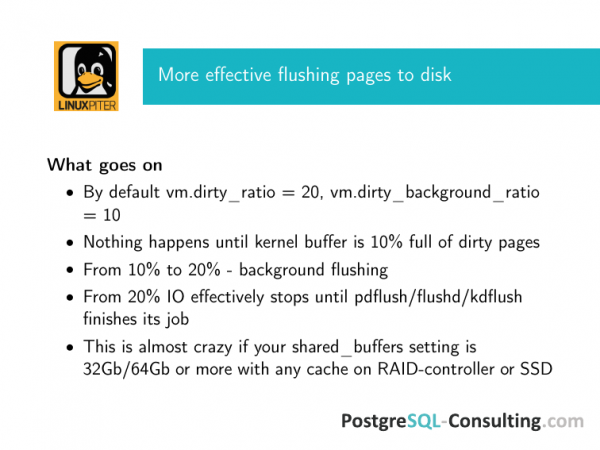
Se si guarda dal punto di vista di Linux, se si dispone di un buon hardware, configurato correttamente, e se PostgreSQL è impostato per eseguire i checkpoint meno frequentemente e distribuirli nel tempo, si utilizzano i parametri predefiniti di Debian. Per la maggior parte delle distribuzioni Linux, si presenta questa situazione: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Cosa significa questo? Con il kernel 2.6 è apparso un demone per il flushing. Pdglush, a seconda di quale si utilizza, che si occupa del dumping in background delle pagine sporche dal kernel buffer e del dumping quando necessario, qualunque cosa accada, quando il dumping in background non è più utile.
Quando inizia il background? Quando il 10% dell'intera memoria RAM disponibile sul server è occupato da pagine sporche nel kernel buffer, viene chiamata una funzione speciale per il dumping in background. Perché è in background? Essa accetta come parametro quante pagine dumpare. E, ad esempio, dumpa N pagine. E per un certo periodo di tempo questa funzione va in attesa. Poi ritorna e dumpa un altro certo numero di pagine.
È una storia estremamente semplice. Qui la questione è simile a quella di una piscina, dove da un tubo esce acqua e in un altro entra. Abbiamo ricevuto un checkpoint e se ha inviato poche pagine sporche per il dumping, allora lentamente dal kernel buffer pgflush dissiperebbe tutto questo con attenzione.
Se queste pagine sporche continuano ad accumularsi, si accumuleranno fino al 20%, dopo di che il sistema operativo ha la priorità di scriverle su disco, perché se si interrompe l'alimentazione, sarà un problema. Perderemo questi dati, ad esempio.
Qual è il trucco? Il trucco è che questi parametri nel mondo moderno, 20 e 10% dell'intera memoria RAM disponibile sulla macchina, sono assolutamente mostruosi in termini di throughput di qualsiasi sistema di archiviazione che si possieda.
Immagina di avere 128 GB di RAM. 12,8 GB arrivano al tuo sistema di archiviazione. E qualunque sia la cache o l'array che hai lì, non reggeranno così tanto.
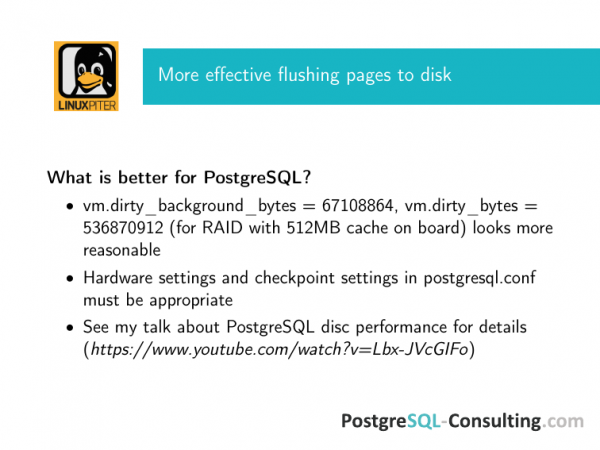
Pertanto, ti consigliamo di impostare immediatamente questi valori in base alle capacità del tuo controller RAID. Qui ho immediatamente fornito una raccomandazione per un controller che ha 512 MB di cache.
Si considera tutto molto semplice. Puoi impostare vm.dirty_background in byte. E queste impostazioni annullano le precedenti due. O il rapporto di default, oppure si attiveranno quelle che si basano sui byte, quindi funzioneranno quelle che utilizzano i byte. Ma poiché sono un consulente DBA e lavoro con diversi clienti, cerco di prendere precauzioni e quindi, se in byte, allora in byte. Nessuno ha garantito che un buon admin non aggiunga memoria al server, non lo riavvii, e la cifra rimanga la stessa. Calcola semplicemente queste cifre, così da essere sicuro che tutto ci stia.
Cosa succede se non riesci a rientrare? È scritto che qualsiasi flushing si ferma efficacemente, ma in realtà è una figura retorica. Il sistema operativo ha un grosso problema: ha molte pagine sporche, quindi si interrompe efficacemente l'IO che generano i tuoi clienti, cioè, quando l'applicazione invia una query SQL al database, è in attesa. Qualsiasi input-output in esso è in priorità bassissima, perché il database è occupato con il checkpoint. E quando lo terminerà è completamente incomprensibile. E quando hai raggiunto un flushing non in background, significa che tutto il tuo IO è occupato da questo. E fino a quando non sarà completato, non puoi fare nulla.
Ci sono anche altri due aspetti importanti che esulano da questo rapporto. Queste impostazioni devono corrispondere alle impostazioni in postgresql.conf, cioè le impostazioni dei checkpoint. E il tuo sistema di dischi deve essere adeguatamente configurato. Se hai una cache su RAID, deve avere una batteria. La gente acquista RAID con una buona cache senza batteria. Se hai SSD in RAID, devono essere di tipo server, e devono avere condensatori. Ecco una checklist dettagliata. A questo link c'è la mia relazione su come configurare le prestazioni del disco in PostgreSQL. Ci sono tutte queste checklist.
Cosa può rendere la vita molto più complicata? Sono due parametri. Sono relativamente nuovi. Possono essere abilitati di default in diverse applicazioni. E possono complicare la vita non meno, se sono attivati in modo errato.
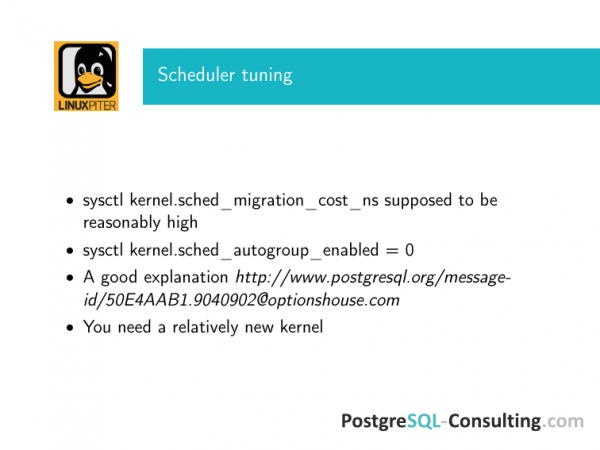
Ci sono due elementi relativamente nuovi. Sono già comparsi nei terzi kernel. Si tratta di sched_migration_cost in nanosecondi e sched_autogroup_enabled, che di default è uno.
E come rovinano la vita? Cos'è sched_migration_cost? Il scheduler di Linux può migrare un processo da una CPU all'altra. E per PostgreSQL, che esegue le query, la migrazione su un'altra CPU non è affatto chiara. Dal punto di vista del sistema operativo, quando cambi le finestre tra OpenOffice e il terminale, questo può essere positivo, ma per un database è molto negativo. Quindi, è sensato impostare migration_cost su un valore elevato, almeno alcune migliaia di nanosecondi.
Cosa significa questo per il scheduler? Considererà che per tutto questo tempo quel processo è ancora "caldo". Cioè, se hai una transazione lunga che richiede tempo, il scheduler lo capirà. Considererà che fino a quando non scade il timeout, non è necessario migrare quel processo. Se il processo sta compiendo qualche operazione, non verrà migrato altrove, ma continuerà a lavorare tranquillamente sulla CPU a lui assegnata. E il risultato sarà eccellente.
Un secondo punto è l'autogroup. C'è una buona idea per carichi di lavoro specifici che non hanno a che fare con i moderni database: raggruppare i processi in base al terminale virtuale da cui sono stati avviati. Questo è comodo per certe attività. Nella pratica, PostgreSQL è un sistema multiprocesso con prefork, che viene avviato da un unico terminale. Hai uno scrittore di lock, checkpoint e tutte le tue richieste client si raggrupperanno su un solo scheduler, su una sola CPU. E attenderanno lì amichevolmente che si liberi, per non disturbarsi a vicenda e occupare a lungo quella CPU. Questa è una storia che non è affatto necessaria per tale carico e quindi è meglio disattivarla.
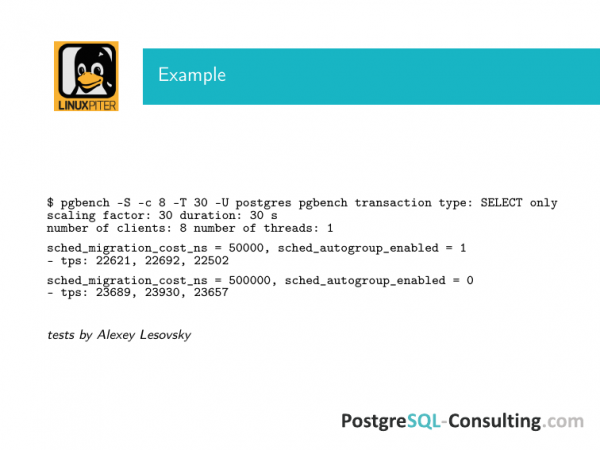
Il mio collega, Aleksey Lesovskiy, ha effettuato test con un semplice pgbench, dove aumentava drasticamente migration_cost e disattivava autogroup. La differenza su un hardware scadente è stata quasi del 10%.C'è una discussione nella mailing list di PostgreSQL dove le persone riportano risultati su come tali modifiche abbiano influito sulla velocità delle query per il 50%.Ci sono molte storie simili.
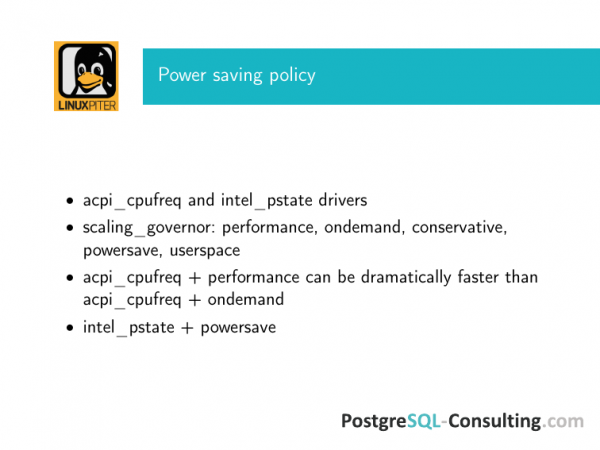
E infine, riguardo alla politica di risparmio energetico. È positivo che ora Linux possa essere utilizzato su un laptop. E si dice che consuma bene la batteria. Ma improvvisamente si scopre che questo può succedere anche su un server.
Inoltre, se affitti server da qualche host, quegli "amichevoli" Inoltre, se prendi server in affitto da qualche provider di hosting, ci sono 'buoni' non si prendono cura di far sì che tu abbia prestazioni migliori. Il loro obiettivo è rendere il loro hardware il più efficiente possibile. Pertanto, possono abilitare per impostazione predefinita la modalità di risparmio energetico per portatili nel sistema operativo.
Se utilizzi questo bene su un server con un database sottoposto a un carico intenso, la tua scelta è acpi_cpufreq + performance. Anche con ondemand avrai problemi.
Intel_pstate è già un driver un po' diverso. Ora si dà preferenza a questo, in quanto è più recente e funziona meglio.
E, di conseguenza, il governor solo performance. Ondemand, powersave e tutto il resto non fa per te.
I risultati di explain analyze di PostgreSQL possono variare di alcuni ordini di grandezza se abiliti powersave, poiché praticamente la CPU verrà gestita in modo del tutto imprevedibile.
Queste cose possono essere abilitate per impostazione predefinita. Controlla attentamente se sono state abilitate di default. Questo può rappresentare un problema davvero enorme.
E alla fine volevo ringraziare i ragazzi del nostro team DBA PosgreSQL-Consulting, in particolare Max Bogu e Alexey Lesovski, che ogni giorno si imbattono in problemi in questo campo. Per i nostri clienti cerchiamo di fare il meglio possibile affinché tutto funzioni. È come le istruzioni per la sicurezza aerea. Qui tutto è scritto col sangue. Ognuno di questi bulloni è stato scoperto in un determinato problema. Sono felice di condividerli con voi.
Domande:
Grazie! Se, ad esempio, un'azienda vuole risparmiare e ospitare su un unico server il database e la logica dell'applicazione, oppure se l'azienda segue la tendenza della microservizi, in cui PostgreSQL viene eseguito in un contenitore. Qual è il problema? Sysctl influisce a livello globale su tutto il kernel. Non ho mai sentito parlare di sysctl che venga virtualizzato in modo che funzioni separatamente nel contenitore. Esistono solo cgroup e lì c'è solo un controllo parziale. Come si può convivere con questo? Oppure se vuoi prestazioni, esegui PostgreSQL su un server hardware dedicato e ottimizzalo?
Abbiamo risposto alla tua domanda in circa tre modi. Se non si tratta di un server fisico che può essere ottimizzato, rilassati, funzionerà bene anche senza queste impostazioni. Se ti trovi a dover gestire un carico tale da dover fare tali configurazioni, arriverai prima al server fisico che a queste impostazioni.
Qual è il problema? Se si tratta di una virtual machine, molto probabilmente avrai molti problemi, ad esempio con la latenza del disco, che è piuttosto incoerente nella maggior parte delle virtual machine. Anche se la larghezza di banda dei dischi è buona, un'operazione di input/output che fallisce, che non influisce molto sulla capacità media, potrebbe accadere durante il checkpoint o durante la scrittura nel WAL, e il database ne risentirà. E lo noterai prima di confrontarti con questi problemi.
Se hai NGINX sullo stesso server, avrai lo stesso problema. Si contenderà la memoria condivisa. E non arriverai ai problemi descritti qui.
Tuttavia, alcuni di questi parametri saranno comunque rilevanti per te. Ad esempio, impostare dirty_ratio con sysctl affinché non sia così eccessivo - in ogni caso questo aiuterà. In ogni caso interagirai con il disco. E lo farai con uno schema non corretto. Questi parametri sono quelli predefiniti che ho mostrato. E in ogni caso è meglio cambiarli.
Ci possono essere problemi con NUMA. VmWare, ad esempio, funziona bene con NUMA con impostazioni esattamente opposte. Qui devi scegliere: server fisico o non fisico.
Ho una domanda riguardante Amazon AWS. Hanno delle immagini preconfigurate. Una di esse si chiama Amazon RDS. Ci sono delle impostazioni personalizzate per il loro sistema operativo?
Ci sono delle impostazioni, ma sono altre impostazioni. Qui configuriamo il sistema operativo dal punto di vista di come il database utilizzerà queste impostazioni. E ci sono parametri che definiscono in quale direzione procedere, come un shaping. Cioè, abbiamo bisogno di tante risorse e le utilizzeremo. Dopo ciò, Amazon RDS collega queste risorse e la prestazione diminuisce. Ci sono storie specifiche su come le persone cominciano a sperimentare con questo. A volte con successo. Ma questo non ha a che fare con le impostazioni del sistema operativo. È una sorta di hacking del cloud. È un'altra storia.
Perché le Transparent huge pages non hanno effetto rispetto alle Huge TLB?
Non hanno effetto. Questo può essere spiegato in molti modi. Ma di fatto non forniscono alcun vantaggio. Qual è la storia di PostgreSQL? All'avvio, riserva un grande blocco di memoria condivisa. Che siano trasparenti o meno, non importa affatto. Il fatto che vengano allocate all'avvio spiega tutto. E se c'è molta memoria e si deve ricostruire il segmento shared_memory, allora le Transparent huge pages saranno rilevanti. In PostgreSQL, sono semplicemente allocate come un grande blocco all'avvio e basta, non succede nient'altro di particolare successivamente. Certo, si può usare, ma c'è il rischio di ottenere una shared_memory corrotta quando verrà riassegnato qualcosa. PostgreSQL non ne è a conoscenza.
Fonte: habr.com
