

Ciao a tutti.
Sono un amministratore di sistema Linux, mi sono trasferito dalla Russia in Australia con un visto professionale indipendente nel 2015, ma l'articolo non tratterà di come un maialino possa guidare un trattore. Ci sono già abbastanza articoli del genere (tuttavia, se c'è interesse, scriverò anche su questo), quindi vorrei raccontare come nel mio lavoro in Australia come ingegnere linux-ops sono stato l'ideatore della migrazione da un sistema di monitoraggio a un altro. In particolare, da Nagios a Icinga2.
L'articolo è parzialmente tecnico e parzialmente riguarda la comunicazione con le persone e i problemi legati alle differenze culturali e ai metodi di lavoro.
Sfortunatamente, il tag "code" non evidenzia il codice Puppet e YAML, quindi ho dovuto utilizzare "plaintext".
Niente presagiva guai la mattina del 21 dicembre 2016. Come al solito, stavo leggendo Habr come anonimo non registrato nelle prime mezz'ore della giornata lavorativa, sorseggiando caffè e mi sono imbattuto in .
Poiché nella mia azienda si usava Nagios, senza pensarci troppo, ho creato un ticket su Redmine e ho condiviso il link nella chat generale, poiché lo consideravo importante. L'iniziativa è punitiva anche in Australia, quindi il principale ingegnere ha assegnato questo problema a me, dal momento che l'ho scoperto.
Screenshot da Redmine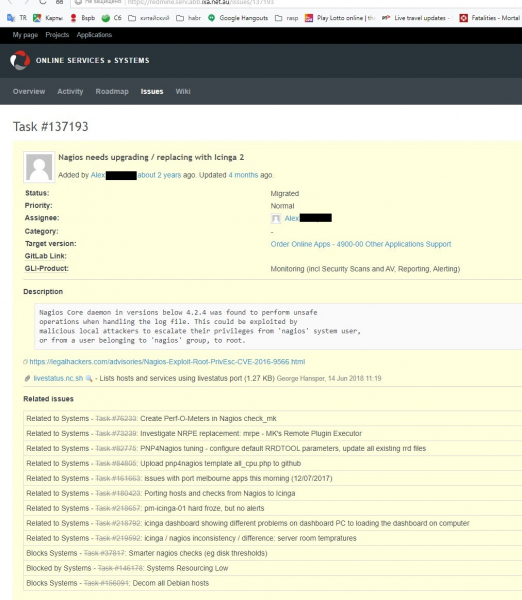
Nel nostro dipartimento, prima di esprimere la propria opinione, è consuetudine proporre almeno un'alternativa, anche se la scelta è ovvia, quindi ho iniziato a cercare su Google quali sistemi di monitoraggio siano attuali al momento, poiché in Russia, nel mio ultimo lavoro, avevo il mio personale sistema homemade, molto primitivo, ma comunque funzionante e che svolgeva tutti i compiti assegnati. Python, Politecnico di Pietroburgo e la metro sono il top. No, la metro è pessima. Questo è personale (11 anni di lavoro) e merita un articolo a parte, ma non ora.
Un po' sulle regole per apportare modifiche alla configurazione dell'infrastruttura nel mio attuale posto di lavoro. Utilizziamo Puppet, Gitlab e il principio dell'Infrastructure as a Code, quindi:
- Nessuna modifica manuale tramite SSH cambiando a mano file su macchine virtuali. Negli ultimi tre anni mi è capitato di essere richiamato diverse volte, l'ultima — una settimana fa e non penso sia stata l'ultima. Davvero — correggere una riga nel file di configurazione, riavviare il servizio e vedere se il problema si è risolto — 10 secondi. Creare un nuovo ramo in Gitlab, inviare le modifiche, aspettare che r10k funzioni su Puppetmaster, eseguire Puppet —environment=mybranch e aspettare ancora un paio di minuti affinché tutto questo funzioni — almeno 5 minuti.
- Qualsiasi modifica viene effettuata creando una Merge Request in Gitlab e necessita dell'approvazione di almeno un membro del team. Cambiamenti significativi decisi dal team leader richiedono due o tre approvazioni.
- Tutte le modifiche sono comunque di tipo testuale (poiché i manifesti Puppet, gli script e i dati Hiera sono testo), i file binari sono fortemente sconsigliati e l'approvazione di tali file richiede motivi validi.
Quindi, le opzioni che ho considerato:
- Munin — se nell'infrastruttura ci sono più di 10 server, l'amministrazione diventa un inferno (da . Non avevo particolare voglia di verificarlo, quindi ho preso per buona questa affermazione).
- Zabbix — ci avevo già messo gli occhi, anche in Russia, ma allora era eccessivo per le mie esigenze. Qui — ho dovuto scartarlo a causa dell'uso di Puppet come gestore di configurazione e Gitlab come sistema di controllo versione. A quel tempo, da quanto ho capito — Zabbix memorizza tutta la configurazione in un database, il che rendeva poco chiaro come gestire la configurazione nelle attuali condizioni e come monitorare le modifiche.
- Prometheus — ciò a cui arriveremo alla fine, stando all'umore del dipartimento, ma a quel tempo non sono riuscito a padroneggiarlo e non ho potuto dimostrare un campione funzionante (Proof of Concept), quindi ho dovuto rinunciare.
- Ci sono state anche altre opzioni, che richiedevano una completa riprogettazione del sistema, oppure erano in una fase embrionale / abbandonate e per questo motivo sono state scartate.
Alla fine, mi sono fermato su Icinga2 per tre motivi:
1 — compatibilità con Nrpe (il servizio client che esegue controlli attraverso i comandi di Nagios). Questo era molto importante, poiché all'epoca avevamo 135 (adesso nel 2019 sono 165) macchine virtuali con un sacco di servizi/verifiche scritte da noi e rifare tutto questo sarebbe stato un vero incubo.
2 — tutti i file di configurazione sono in formato testo, il che consente di modificarli facilmente, creare merge requests con la possibilità di vedere cosa è stato aggiunto o rimosso.
3 — è un progetto OpenSource vivo e in evoluzione. Amiciamo molto l'OpenSource e contribuiamo come possiamo attraverso la creazione di Pull Requests e Issues per risolvere problemi.
Quindi, andiamo, Icinga2.
La prima cosa con cui ho dovuto confrontarmi è stata l'inerzia dei colleghi. Tutti erano abituati a Nagios/Nadgios (anche se qui non siamo riusciti a trovare un compromesso su come pronunciarlo) e all'interfaccia di CheckMK. Con Icinga l'interfaccia appare completamente diversa (questo è stato un limite), ma c'è la possibilità di configurare in modo flessibile ciò che si desidera visualizzare attraverso filtri basati su qualsiasi parametro (questo è stato un vantaggio, ma ho dovuto combattere molto per questo).
Filtri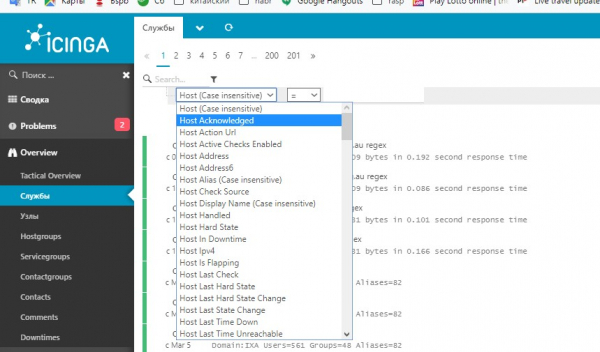
Valuta il rapporto tra la dimensione della barra di scorrimento e la dimensione dell'area di scorrimento.
Secondo — tutti erano abituati a vedere l'intera infrastruttura su un singolo monitor, poiché CheckMk consente di lavorare con più host di Nagios, ma l'interfaccia di Icinga non lo permetteva (in realtà lo permetteva, ma di questo parlerò più avanti). Un'alternativa era una cosa chiamata Thruk, ma il suo design suscitava reazioni negative in tutti i membri del team, tranne uno — quello che l'ha proposta (non io).
Fate a meno di Thruk — è stata una decisione unanime del team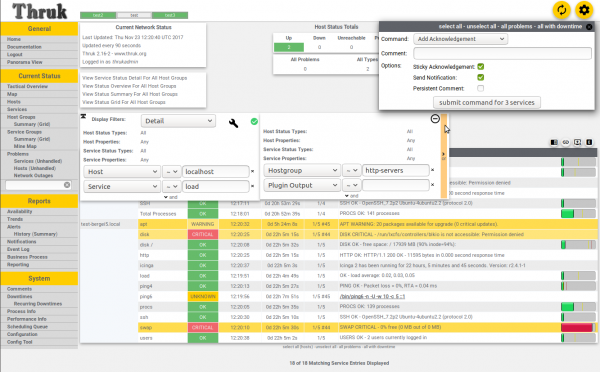
Dopo un paio di giorni di brainstorming ho proposto l'idea del monitoraggio cluster, in cui c'è un master host nella zona di produzione e due host subordinati: uno in dev/test e uno esterno, situato presso un altro fornitore, con l'obiettivo di monitorare i nostri servizi dal punto di vista del cliente o di un osservatore esterno. Questa configurazione permetteva di vedere tutti i problemi in un'unica interfaccia web e funzionava abbastanza bene, ma Puppet... Il problema con Puppet era che il master host doveva ora conoscere tutti gli host e i servizi/controlli nel sistema e doveva distribuirli tra le zone (dev-test, staging-prod, esterno), ma l'invio delle modifiche tramite l'API di Icinga richiede un paio di secondi, mentre la compilazione della directory di Puppet di tutti i servizi per tutti gli host richiede un paio di minuti. Questo è ancora un motivo di rimprovero per me, anche se ho spiegato più volte come tutto funziona e perché ci voglia così tanto tempo.
Terzo: un sacco di SnowFlakes (fiocchi di neve) - cose che si discostano dal sistema generale perché hanno qualcosa di speciale, quindi le regole generali non si applicano. Questo veniva affrontato con un attacco frontale: se ci sono allerta, ma in realtà tutto è a posto, vuol dire che bisogna scavare più a fondo e capire perché mi sta avvisando, anche se non dovrebbe. O viceversa: perché Nagios entra nel panico, mentre Icinga no.
Quarto: Nagios è stato qui per tre anni prima di me e inizialmente c'era più fiducia in lui che nella mia nuova e alla moda sistema hipster, quindi ogni volta che Icinga sollevava il panico, nessuno faceva nulla finché Nagios non si allarmava per la stessa questione. Ma molto raramente Icinga emetteva avvisi reali prima di Nagios e considero questo un grave difetto, di cui parlerò nella sezione «Conclusioni».
Di conseguenza, il lancio è stato ritardato di oltre 5 mesi (era previsto per il 28 giugno 2018, ma è avvenuto il 3 dicembre 2018), principalmente a causa del «parity check» - quella rottura, in cui ci sono diversi servizi in Nagios di cui nessuno ha sentito nulla negli ultimi due anni, ma PROPRIO ADESSO hanno, cavolo, emesso un critico senza alcun motivo e ho dovuto giustificare perché non sono presenti nel mio pannello e ho dovuto aggiungerli in Icinga, in modo che il «parity check sia completo» (Tutti i servizi/controlli in Nagios corrispondono ai servizi/controlli in Icinga)
Implementazione:
Primo: guerra tra Code e Data, in stile Puppet. Tutti i dati, proprio tutti, devono essere in Hiera e in nessun altro modo. Tutto il codice deve trovarsi in file .pp. Variabili, astrazioni, funzioni: tutto va in pp.
Alla fine: abbiamo un sacco di macchine virtuali (165 al momento della scrittura di questo articolo) e 68 applicazioni web, che devono essere monitorate per verificarne il funzionamento e la validità dei certificati SSL. Ma a causa di problemi storici, le informazioni per il monitoraggio delle applicazioni provengono da un repository gitlab separato e il formato dei dati non è cambiato dai tempi di Puppet 3, il che crea ulteriori complessità nella configurazione.
Codice Puppet per le applicazioni, proteggi i tuoi occhi
definire profili::servizi::monitoraggio::docker_apps(
  Hash $app_list,
  Hash $apps_accessible_from,
  Hash $apps_access_list,
  Hash $webhost_defaults,
  Hash $webcheck_defaults,
  Hash $service_overrides,
  Hash $targets,
  Hash $app_checks,
  )
{
#### APPS ####
  $zone = $name
  $app_list.each | String $app_name, Hash $app_data |
  {

    $notify_group = { 'notify_group' => ($webcheck_defaults[$zone]['notify_group'] + pick($app_data['notify_group'], {} )) } # aggiunge le notifiche per il gruppo predefinito (sistemi) + qualsiasi gruppo definito in int/pm_docker_apps.eyaml

    $data = merge($webhost_defaults, $apps_accessible_from, $app_data)

    $site_domain = $app_data['site_domain']

    $regexp = pick($app_data['check_regex'], 'html')        # Seleziona un regex da controllare

    $check_url = $app_data['check_url'] ? {
      undef   => { 'http_uri' => '\/ '},
      default => { 'http_uri' => $app_data['check_url'] }
    }

    $check_regex = $regexp ?{
      'absent' => {},
      default  => {'http_expect_body_regex' => $regexp}
    }

    $site_domain.each | String $vhost, Hash $vdata | {        # Split un'app in base ai domini se ce ne sono due o più
      $vhost_name = {'http_vhost' => $vhost}

      $vars = $data['vars'] + $vhost_name + $check_regex + $check_url

      $web_ipaddress = is_array($vdata['web_ipaddress']) ? {  # Rendi l'indirizzo IP un array se non lo è, perché askizzy ha 2 ips ed è un array
        true  => $vdata['web_ipaddress'],
        false => [$vdata['web_ipaddress']],
      }

      $access_from_zones = [$zone] + $apps_access_list[$data['accessible_from']] # Unisci la zona predefinita (dove l'app è definita) e le zone extra se esistono
      $web_ipaddress.each | String $ip_address | {            # Per ogni IP (se ne abbiamo più di uno)
        $suffix = length($web_ipaddress) ? {                  # Se abbiamo più di uno - aggiungi l'IP come suffisso a questo nome host per evitare di duplicare le risorse
          1       => '',
          default => "_${ip_address}"
        }
        $octets = split($ip_address, '.')
        $ip_tag = "${octets[2]}.${octets[3]}" # Usare solo l'ultimo ottetto causa una collisione tra nginx-vip 203.15.70.94 e ip est. 49.255.194.94

        $access_from_zones.each | $zone_prefix |{
          $zone_target = $targets[$zone_prefix]

          $nginx_vip_name = "${zone_prefix}_nginx-vip-${ip_tag}" # Se è un host per est - il prefisso diventa 'ext_' (ext_nginx-vip...)
          $nginx_host_vip = {
            $nginx_vip_name => {
              ensure        => present,
              target        => $zone_target,
              address       => $ip_address,
              check_command => 'hostalive',
              groups        => ['nginx_vip',],
            }
          }

          $ssl_vars = $app_checks['ssl']
          $regex_vars = $app_checks['http'] + $vars + $webcheck_defaults[$zone] + $notify_group

          if !defined( Profiles::Services::Monitoring::Host[$nginx_vip_name] ) {
          ensure_resources('profiles::services::monitoring::host', $nginx_host_vip)
          }

          if !defined( Icinga2::Object::Service["${nginx_vip_name}_ssl"] ) {
            icinga2::object::service {"${nginx_vip_name}_ssl":
              ensure         => $data['ensure'],
              assign         => ["host.name == $nginx_vip_name",],
              groups         => ['webchecks',],
              check_command  => 'ssl',
              check_interval => $service_overrides['ssl']['check_interval'],
              target         => $targets['services'],
              apply          => true,
              vars           => $ssl_vars
            }
          }
          if $regexp != 'absent'{
            if !defined(Icinga2::Object::Service["${vhost}${$suffix} regex"]){
              icinga2::object::service {"${vhost}${$suffix} regex":
                ensure          => $data['ensure'],
                assign          => ["match(*_nginx-vip-${ip_tag}, host.name)",],
                groups          => ['webchecks',],
                check_command   => 'http',
                check_interval  => $service_overrides['regex']['check_interval'],
                target          => $targets['services'],
                enable_flapping => true,
                apply           => true,
                vars            => $regex_vars
              }
            }
          }
        }
      }
    }
  }
}
Il codice di configurazione degli host e dei servizi appare veramente spaventoso:
monitoring/config.pp
class profiles::services::monitoring::config(
  Array $default_config,
  Array $hostgroups,
  Hash $hosts = {},
  Hash $host_defaults,
  Hash $services,
  Hash $service_defaults,
  Hash $service_overrides,
  Hash $webcheck_defaults,
  Hash $servicegroups,
  String $servicegroup_target,
  Hash $user_defaults,
  Hash $users,
  Hash $oncall,
  Hash $usergroup_defaults,
  Hash $usergroups,
  Hash $notifications,
  Hash $notification_defaults,
  Hash $notification_commands,
  Hash $timeperiods,
  Hash $webhost_defaults,
  Hash $apps_access_list,
  Hash $check_commands,
  Hash $hosts_api = {},
  Hash $targets = {},
  Hash $host_api_defaults = {},
)
{

  # Profiles::Services::Monitoring::Hostgroup <> # sarà abilitato quando ci trasferiremo completamente su icinga
#### APPS ####
  case $location {
    'int', 'ext': {
      $apps_by_zone = {}
    }
    'pm': {
      $int_apps         = hiera('int_docker_apps')
      $int_app_defaults = hiera('int_docker_app_common')

      $st_apps          = hiera('staging_docker_apps')
      $srs_apps         = hiera('pm_docker_apps_srs')
      $pm_apps          = hiera('pm_docker_apps') + $st_apps + $srs_apps
      $pm_app_defaults  = hiera('pm_docker_app_common')

      $apps_by_zone = {
        'int' => $int_apps,
        'pm'  => $pm_apps,
      }

      $app_access_by_zone = {
        'int' => {'accessible_from' => $int_app_defaults['accessible_from']},
        'pm'  => {'accessible_from' => $pm_app_defaults['accessible_from']},
      }
    }

    default: {
      fail('Si prega di assicurarsi che il nodo abbia il fatto $location impostato (int, pm, ext)')
    }
  }

  file { '/etc/icinga2/conf.d/':
    ensure  => directory,
    recurse => true,
    purge   => true,
    owner   => 'icinga',
    group   => 'icinga',
    mode    => '0750',
    notify  => Service['icinga2'],
  }

  $default_config.each | String $file_name |{
    file {"/etc/icinga2/conf.d/${file_name}":
      ensure => present,
      source => "puppet:////modules/profiles/services/monitoring/default_config/${file_name}",
      owner  => 'icinga',
      group  => 'icinga',
      mode    => '0640',
    }
  }

  $app_checks = {
    'ssl' => $services['webchecks']['checks']['ssl']['vars'],
    'http' => $services['webchecks']['checks']['http_regexp']['vars']
  }

  $apps_by_zone.each | String $zone, Hash $app_list | {
    profiles::services::monitoring::docker_apps{$zone:
      app_list             => $app_list,
      apps_accessible_from => $app_access_by_zone[$zone],
      apps_access_list     => $apps_access_list,
      webhost_defaults     => $webhost_defaults,
      webcheck_defaults    => $webcheck_defaults,
      service_overrides    => $service_overrides,
      targets              => $targets,
      app_checks           => $app_checks,
    }
  }

####    HOSTS    ####

  # Profiles::Services::Monitoring::Host <> # Questo è per l'invasione della navetta quando sarà pronta.
  $hosts_has_large_disks = query_nodes('mountpoints.*.size_bytes >= 1099511627776')

  $hosts.each | String $hostgroup, Hash $list_of_hosts_with_settings | {           # Divisione delle liste del sito per gruppi di host - docker_host/gluster_host/altro
    $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
    $hostgroup_settings     = $list_of_hosts_with_settings['settings']
    $merged_hostgroup_settings = deep_merge($host_defaults, $list_of_hosts_with_settings['settings'])
    $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{  # Divisione delle liste per host
      # Questo host è nell'array $hosts_has_large_disks? In caso affermativo impostare host.vars.has_large_disks
      if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
        $vars_has_large_disks = { 'has_large_disks' => true }
      } else {
        $vars_has_large_disks = {}
      }
      $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
      $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})
      $host_settings_vars = pick($host_settings['vars'], {})
      $host_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
      $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_notify_group}, $vars_has_large_disks)) # Unendo vars separatamente

      $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

      profiles::services::monitoring::host{$host_name:
        ensure             => $host_data['ensure'],
        display_name       => $host_data['display_name'],
        address            => $host_data['address'],
        groups             => $hostgroups,
        target             => $host_data['target'],
        check_command      => $host_data['check_command'],
        check_interval     => $host_data['check_interval'],
        max_check_attempts => $host_data['max_check_attempts'],
        vars               => $host_data_vars,
        template           => $host_data['template'],
      }
    }
  }
  if !empty($hosts_api){                                                                # Tutti gli host gestiti dall'API
    $hosts_api.each | String $zone, Hash $hosts_api_zone | {                            # Divisione degli host api per zone
      $hosts_api_zone.each | String $hostgroup, Hash $list_of_hosts_with_settings | {   # Divisione delle liste del sito per gruppi di host - docker_host/gluster_host/altro
        $list_of_hosts_in_group = $list_of_hosts_with_settings['hosts']
        $hostgroup_settings     = $list_of_hosts_with_settings['settings']
        $merged_hostgroup_settings = deep_merge($host_api_defaults, $list_of_hosts_with_settings['settings'])
        $list_of_hosts_in_group.each | String $host_name, Hash $host_settings |{        # Divisione delle liste per host
          # Questo host è nell'array $hosts_has_large_disks? In caso affermativo impostare host.vars.has_large_disks
          if ( $hosts_has_large_disks.reduce(false) | $found, $value| { ( $value =~ "^${host_name}" ) or $found } ) {
            $vars_has_large_disks = { 'has_large_disks' => true }
          } else {
            $vars_has_large_disks = {}
          }
          $host_data = deep_merge($merged_hostgroup_settings, $host_settings)
          $hostgroup_settings_vars = pick($hostgroup_settings['vars'], {})

          $host_settings_vars = pick($host_settings['vars'], {})
          $host_api_notify_group = delete_undef_values($host_defaults['vars']['notify_group'] + $hostgroup_settings_vars['notify_group'] + $host_settings_vars['notify_group'])
          $host_data_vars = delete_undef_values(deep_merge($host_data['vars'] , {'notify_group' => $host_api_notify_group}, $vars_has_large_disks))
          $hostgroups = delete_undef_values([$hostgroup] + $host_data['groups'])

          if defined(Profiles::Services::Monitoring::Host[$host_name]){
            $hostname = "${host_name}_from_${zone}"
          }
          else
          {
            $hostname = $host_name
          }
          profiles::services::monitoring::host{$hostname:
            ensure             => $host_data['ensure'],
            display_name       => $host_data['display_name'],
            address            => $host_data['address'],
            groups             => $hostgroups,
            target             => "${host_data['target_base']}/${zone}/hosts.conf",
            check_command      => $host_data['check_command'],
            check_interval     => $host_data['check_interval'],
            max_check_attempts => $host_data['max_check_attempts'],
            vars               => $host_data_vars,
            template           => $host_data['template'],
          }
        }
      }
    }
  }

#### FINE DEGLI HOST ####

####   SERVIZI   ####

  $services.each | String $service_group, Hash $s_list |{             # Gruppo di servizi e lista di servizi in quel gruppo
    $service_list = $s_list['checks']                                 # Lista di controlli effettivi, separatamente dalle impostazioni del SG
    $service_list.each | String $service_name, Hash $data |{

      $merged_defaults = merge($service_defaults, $s_list['settings']) # impostazioni globali per i servizi + impostazioni di gruppo per i servizi
      $merged_data = merge($merged_defaults, $data)

      $settings_vars = pick($s_list['settings']['vars'], {})
      $this_service_vars = pick($data['vars'], {})
      $all_service_vars = delete_undef_values($service_defaults['vars'] + $settings_vars + $this_service_vars)

      # Se sovrascriviamo check_timeout predefinito, ma non nrpe_timeout, rendiamo nrpe_timeout uguale a check_timeout
      if ( $merged_data['check_timeout'] and ! $this_service_vars['nrpe_timeout'] ) {
        # Nota: Icinga convertirà 1m in 60 automaticamente!
        $nrpe = { 'nrpe_timeout' => $merged_data['check_timeout'] }
      } else {
        $nrpe = {}
      }

      # Di default utilizziamo nrpe e tutti i comandi vengono eseguiti tramite nrpe. Quindi vars.nrpe_command = $service_name è un valore predefinito
      # Se è un comando di Icinga lato server - non abbiamo bisogno di 'nrpe_command'
      # ma non c'è danno ad avere quella var e il codice è più breve

      if $merged_data['check_command'] == 'nrpe'{
        $check_command = $merged_data['vars']['nrpe_command'] ? {
          undef   => { 'nrpe_command' => $service_name },
          default => { 'nrpe_command' => $merged_data['vars']['nrpe_command'] }
        }
      }else{
        $check_command = {}
      }

      # Assemblando $vars dalle impostazioni globali predefinite del servizio, impostazioni del gruppo, impostazioni di questo controllo particolare e non dimentichiamo le impostazioni nrpe.
      if $all_service_vars['graphite_template'] {
        $graphite_template = {'check_command' => $all_service_vars['graphite_template']}
      }else{
        $graphite_template = {'check_command' => $service_name}
      }
      $service_notify = [] + pick($settings_vars['notify_group'], []) + pick($this_service_vars['notify_group'], []) # pick è necessario ovunque, altrimenti diventa "Il valore '' non può essere convertito in numerico"

      $service_notify_group = $service_notify ? {
        []      => $service_defaults['vars']['notify_group'],
        default => $service_notify
      } # Assegna il gruppo predefinito (sistemi) se non sono definiti altri gruppi

      $vars = $all_service_vars + $nrpe + $check_command + $graphite_template + {'notify_group' => $service_notify_group}

      # Questo deve essere unito separatamente, perché unirlo come parte di MERGED_DATA sovrascrive gli array invece di unirli, quindi perdiamo alcuni valori "assign" e "ignore"

      $assign = delete_undef_values($service_defaults['assign'] + $s_list['settings']['assign'] + $data['assign'])
      $ignore = delete_undef_values($service_defaults['ignore'] + $s_list['settings']['ignore'] + $data['ignore'])

      icinga2::object::service {$service_name:
        ensure             => $merged_data['ensure'],
        apply              => $merged_data['apply'],
        enable_flapping    => $merged_data['enable_flapping'],
        assign             => $assign,
        ignore             => $ignore,
        groups             => [$service_group],
        check_command      => $merged_data['check_command'],
        check_interval     => $merged_data['check_interval'],
        check_timeout      => $merged_data['check_timeout'],
        check_period       => $merged_data['check_period'],
        display_name       => $merged_data['display_name'],
        event_command      => $merged_data['event_command'],
        retry_interval     => $merged_data['retry_interval'],
        max_check_attempts => $merged_data['max_check_attempts'],
        target             => $merged_data['target'],
        vars               => $vars,
        template           => $merged_data['template'],
      }
    }
  }
#### FINE DEI SERVIZI ####

#### ALTRE COSA NOIOSE ####

  $servicegroups.each | $servicegroup, $description |{
    icinga2::object::servicegroup{ $servicegroup:
      target       => $servicegroup_target,
      display_name => $description
    }
  }

  $hostgroups.each| String $hostgroup |{
    profiles::services::monitoring::hostgroup { $hostgroup:}
  }

  $notifications.each | String $name, Hash $settings |{

    $assign = pick($notification_defaults['assign'], []) + $settings['assign']
    $ignore = pick($notification_defaults['ignore'], []) + $settings['ignore']

    $merged_settings = $settings + $notification_defaults

    icinga2::object::notification{$name:
      target       => $merged_settings['target'],
      apply        => $merged_settings['apply'],
      apply_target => $merged_settings['apply_target'],
      command      => $merged_settings['command'],
      interval     => $merged_settings['interval'],
      states       => $merged_settings['states'],
      types        => $merged_settings['types'],
      assign       => delete_undef_values($assign),
      ignore       => delete_undef_values($ignore),
      user_groups  => $merged_settings['user_groups'],
      period       => $merged_settings['period'],
      vars         => $merged_settings['vars'],
    }
  }

  # Unendo le impostazioni di notifica per gli utenti con altre impostazioni
  $users_oncall = deep_merge($users, $oncall)
  # Magia. Non toccare.
  create_resources('icinga2::object::user', $users_oncall, $user_defaults)
  create_resources('icinga2::object::usergroup', $usergroups, $usergroup_defaults)
  create_resources('icinga2::object::timeperiod',$timeperiods)
  create_resources('icinga2::object::checkcommand', $check_commands)
  create_resources('icinga2::object::notificationcommand', $notification_commands)

  profiles::services::sudoers { 'icinga_runs_ping_l2':
    ensure            => present,
    sudoersd_template => 'profiles/os/redhat/centos7/sudoers/icinga.erb',
  }

}
Sto ancora lavorando su questo codice e lo miglioro dove possibile. Tuttavia, è proprio questo tipo di codice che ha permesso l'uso di una sintassi semplice e comprensibile in Hiera:
Dati
profiles::services::monitoring::config::services:
  perf_checks:
    settings:
      check_interval: '2m'
      assign:
        - 'host.vars.type == linux'
    checks:
      procs: {}
      load: {}
      memory: {}
      disk:
        check_interval: '5m'
        vars:
          notification_period: '24x7'
      disk_iops:
        vars:
          notifications:
            - 'silent'
      cpu:
        vars:
          notifications:
            - 'silent'
      dns_fqdn:
        check_interval: '15m'
        ignore:
          - 'xenserver in host.groups'
        vars:
          notifications:
            - 'silent'
      iftraffic_nrpe:
        vars:
          notifications:
            - 'silent'
  logging:
    settings:
      assign:
        - 'logserver in host.groups'
    checks:
       rsyslog: {}
      nginx_limit_req_other: {}
      nginx_limit_req_s2s: {}
      nginx_limit_req_s2x: {}
      nginx_limit_req_srs: {}
     logstash: {}
      logstash_api:
        vars:
          notifications:
            - 'silent'
Tutti i controlli sono suddivisi in gruppi, e ciascun gruppo ha impostazioni predefinite su dove e con quale frequenza eseguire questi controlli, quali notifiche inviare e a chi.
In ciascun controllo è possibile sovrascrivere qualsiasi opzione e tutto ciò si combina anche con le impostazioni predefinite di tutti i controlli in generale. Pertanto, in config.pp è presente questo codice — lì avviene la fusione di tutte le impostazioni predefinite con le impostazioni dei gruppi e poi con ogni singolo controllo.
Un'altra modifica molto importante è stata la possibilità di utilizzare funzioni nelle impostazioni, ad esempio, la funzione per sostituire la porta, l'indirizzo e l'URL per il controllo http_regex.
http_regexp:
  assign:
    - 'host.vars.http_regex'
    - 'static_sites in host.groups'
  check_command: 'http'
  check_interval: '1m'
  retry_interval: '20s'
  max_check_attempts: 6
  http_port: '{{ if(host.vars.http_port) { return host.vars.http_port } else { return 443 } }}'
  vars:
    notification_period: 'host.vars.notification_period'
    http_vhost: '{{ if(host.vars.http_vhost) { return host.vars.http_vhost } else { return host.name } }}'
    http_ssl: '{{ if(host.vars.http_ssl) { return false } else { return true } }}'
    http_expect_body_regex: 'host.vars.http_regex'
    http_uri: '{{ if(host.vars.http_uri) { return host.vars.http_uri } else { return "\/" } }}'
    http_onredirect: 'follow'
    http_warn_time: 8
    http_critical_time: 15
    http_timeout: 30
    http_sni: true
Questo significa — se nella definizione dell'host c'è una variabile http_port — usarla, altrimenti 443. Ad esempio, l'interfaccia web di jabber è sulla porta 9090, mentre Unifi è sulla porta 7443.
http_vhost significa ignorare il DNS e prendere questo indirizzo.
Se nell'host è specificato un uri — si deve utilizzare quello, altrimenti si prende «\/».
La storia con http_ssl è stata divertente — questa variabile non voleva proprio disattivarsi su richiesta. Ho passato molto tempo a cercare di capire questa riga, finché non mi sono reso conto che la variabile era nella definizione dell'host:
http_ssl: falseSostituito nell'espressione
if(host.vars.http_ssl) { return false } else { return true }come false e alla fine si ottiene
if(false) { return false } else { return true }cioè, il controllo ssl risulta sempre attivo. È stato risolto sostituendo la sintassi:
http_ssl: noConclusioni:
Pro:
- Adesso abbiamo un unico sistema di monitoraggio, e non due come negli ultimi 7-8 mesi, o uno solo, obsoleto e vulnerabile.
- La struttura dei dati degli host / servizi (controlli) adesso è (a mio avviso) molto più leggibile e comprensibile. Per altri non è risultato così ovvio, quindi è stato necessario creare un paio di pagine nella wiki locale per spiegare come funziona tutto e dove correggere.
- C'è la possibilità di una configurazione flessibile dei controlli tramite variabili e funzioni, ad esempio per il controllo http_regexp, il pattern ricercato, il codice di ritorno, l'url e la porta possono essere definiti nelle impostazioni dell'host.
- Ci sono diversi pannelli (dashboards), per ciascuno dei quali è possibile definire la propria lista di allerta visualizzate e gestire tutto questo tramite Puppet e merge requests.
Contro:
- Inerzia dei membri del team – Nagios lavorava, lavorava e lavorava, mentre la tua Icinga continua a bloccarsi e a rallentare. E come faccio a guardare la cronologia? Ah, caspita, non si aggiorna… (Problema reale: la cronologia delle allerte non si aggiorna automaticamente, solo premendo F5)
- Inerzia del sistema – quando clicco su 'aggiorna' (check now) nell'interfaccia web, il risultato dell'esecuzione dipende dalle condizioni meteorologiche su Marte, soprattutto con servizi complessi che richiedono decine di secondi per l'esecuzione. Un risultato simile è una cosa normale.

- In generale, dalla statistica semestrale dell'operato dei due sistemi affiancati, Nagios ha sempre funzionato più velocemente di Icinga e questo mi ha molto infastidito. A mio avviso, hanno introdotto qualche problema con i timer e il controllo ogni cinque minuti di fatto avviene ogni 5:30 o qualcosa di simile.
- Se riavvio il servizio in qualsiasi momento (systemctl restart icinga2) – tutti i controlli che in quel momento sono in esecuzione mostreranno un'allerta critica <terminato per segnale 15> a schermo e da un punto di vista esterno sembra che sia tutto caduto ().
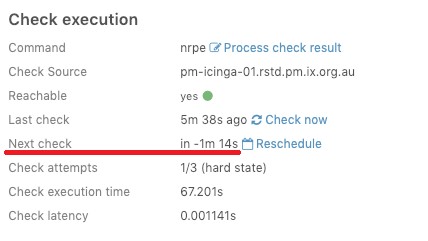
Ma in generale – funziona.
Fonte: habr.com
