

Fino a poco tempo fa, in Odnoklassniki, circa 50 TB di dati trattati in tempo reale erano memorizzati in SQL Server. Per un tale volume, garantire accesso veloce, affidabile e anche ridondante a un centro dati utilizzando un database SQL è praticamente impossibile. Di solito, in questi casi, si utilizza uno dei sistemi di archiviazione NoSQL, ma non tutto può essere trasferito in NoSQL: alcune entità richiedono garanzie di transazioni ACID.
Questo ci ha portato all'uso di un sistema di archiviazione NewSQL, cioè un database che offre tolleranza ai guasti, scalabilità e velocità dei sistemi NoSQL, ma mantenendo le garanzie ACID caratteristiche dei sistemi tradizionali. Ci sono poche soluzioni industriali funzionanti di questa nuova classe, quindi abbiamo realizzato un tale sistema da soli e lo abbiamo messo in funzione nel settore.
Come funziona e cosa è stato realizzato — leggi sotto.
Oggi l'audience mensile di "Odnoklassniki" supera i 70 milioni di visitatori unici. Noi principali reti sociali del mondo, e tra i primi venti siti dove gli utenti trascorrono più tempo. L'infrastruttura di "OK" gestisce carichi molto elevati: oltre un milione di richieste HTTP/secondo sui front-end. Parti del parco server, che conta oltre 8000 unità, si trovano vicine tra loro — in quattro data center a Mosca, il che consente di garantire una latenza di rete inferiore a 1 ms tra di essi.
Utilizziamo Cassandra dal 2010, a partire dalla versione 0.6. Oggi sono in uso diverse dozzine di cluster. Il cluster più veloce gestisce oltre 4 milioni di operazioni al secondo, mentre il più grande memorizza 260 TB.
Tuttavia, tutto ciò sono normali cluster NoSQL utilizzati per la memorizzazione Volevamo invece sostituire il principale sistema di archiviazione coerente, Microsoft SQL Server, utilizzato fin dalla fondazione di "Odnoklassniki". Il sistema di archiviazione era composto da oltre 300 macchine SQL Server Standard Edition, su cui erano memorizzati 50 TB di dati — entità aziendali. Questi dati vengono modificati nell'ambito di transazioni ACID e richiedono .
Per distribuire i dati tra i nodi SQL Server abbiamo utilizzato sia il partizionamento verticale che quello orizzontale. (sharding). Storicamente abbiamo utilizzato uno schema semplice di sharding dei dati: a ciascuna entità veniva assegnato un token - una funzione dall'ID dell'entità. Le entità con lo stesso token erano allocate su un unico server SQL. La relazione di tipo master-detail era realizzata in modo tale che i token del record principale e del record derivato coincidessero sempre e fossero nello stesso server. Nella rete sociale quasi tutti i record sono generati a nome dell'utente, il che significa che tutti i dati dell'utente all'interno di una singola sottosistema funzionale sono memorizzati su un unico server. Cioè, quasi sempre le transazioni commerciali coinvolgevano tabelle di un unico server SQL, il che consentiva di garantire la coerenza dei dati tramite transazioni ACID locali, senza la necessità di utilizzare transazioni ACID distribuite.
Grazie allo sharding e per accelerare il funzionamento di SQL:
- Non utilizziamo vincoli di chiave esterna, poiché durante lo sharding l'ID dell'entità potrebbe trovarsi su un altro server.
- Non utilizziamo stored procedure e trigger a causa del carico aggiuntivo sulla CPU del DBMS.
- Non utilizziamo JOIN poiché tutto quanto sopra e un gran numero di letture casuali dal disco.
- Fuori dalla transazione, per ridurre i deadlock utilizziamo il livello di isolamento Read Uncommitted.
- Eseguiamo solo transazioni brevi (in media più brevi di 100 ms).
- Non utilizziamo UPDATE e DELETE multiriga a causa dell'elevato numero di deadlock - aggiorniamo solo un record alla volta.
- Le richieste vengono sempre eseguite solo sugli indici - una richiesta con un piano di scansione completa della tabella per noi significa sovraccarico del DB e il suo crash.
Questi passaggi hanno permesso di estrarre quasi il massimo delle prestazioni dai server SQL. Tuttavia, i problemi aumentavano sempre di più. Esaminiamoli.
Problemi con SQL
- Poiché abbiamo utilizzato uno sharding personalizzato, l'aggiunta di nuovi shard veniva eseguita manualmente dagli amministratori. Per tutto questo tempo, le repliche scalabili dei dati non gestivano le richieste.
- Con l'aumento del numero di record nella tabella, la velocità di inserimento e modifica diminuisce; aggiungendo indici a una tabella esistente, la velocità diminuisce notevolmente, la creazione e la ricreazione degli indici avviene con downtime.
- La presenza in produzione di un numero ridotto di Windows per SQL Server complica la gestione dell'infrastruttura.
Ma il problema principale è —
Resilienza
Un server SQL classico ha bassa capacità di tolleranza ai guasti. Supponiamo che tu abbia solo un server di database e che questo si guasti una volta ogni tre anni. Durante questo tempo, il sito non funziona per 20 minuti, il che è accettabile. Se hai 64 server, il sito non funziona una volta ogni tre settimane. E se hai 200 server, il sito non funziona ogni settimana. Questo è un problema.
Cosa si può fare per aumentare la tolleranza ai guasti di un server SQL? Wikipedia ci suggerisce di costruire : dove nel caso di guasto di uno qualsiasi dei componenti, c'è una copia di riserva.
Ciò richiede un parco di attrezzature costose: duplicazioni multiple, fibra ottica, storage condiviso, e anche l'attivazione delle riserve funziona in modo inaffidabile: circa il 10% delle attivazioni si conclude con il fallimento della node di riserva in parallelo alla node principale.
Ma il principale svantaggio di un cluster ad alta disponibilità è l'assenza di disponibilità in caso di guasto del data center in cui si trova. 'Odnoklassniki' ha quattro data center, e dobbiamo garantire il funzionamento in caso di un guasto totale in uno di essi.
Per questo si potrebbe applicare integrata in SQL Server. Questa soluzione è molto più costosa a causa del costo del software e soffre di problemi noti con la replicazione: ritardi imprevedibili nelle transazioni durante la replicazione sincrona e ritardi nell'applicazione delle repliche (e, di conseguenza, modifiche perse) in quella asincrona. Si presume che renda questa opzione completamente inapplicabile per noi.
Tutti questi problemi richiedevano una soluzione drastica e abbiamo iniziato ad analizzarli in dettaglio. Qui dobbiamo familiarizzare con ciò che fa principalmente SQL Server: le transazioni.
Transazione semplice
Consideriamo la più semplice, dal punto di vista di un programmatore SQL applicativo, transazione: aggiunta di una foto a un album. Gli album e le foto vengono memorizzati in tavole diverse. Un album ha un contatore di foto pubbliche. Pertanto, tale transazione si suddivide nei seguenti passaggi:
- Blocchiamo l'album per chiave.
- Creiamo un record nella tabella delle foto.
- Se la foto ha uno status pubblico, incrementiamo nel'album il contatore delle foto pubbliche, aggiorniamo il record e confermiamo la transazione.
O in forma di pseudocodice:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vediamo che lo scenario di transazione aziendale più comune è leggere i dati dal database nella memoria del server delle applicazioni, modificare qualcosa e salvare i nuovi valori nel database. Di solito, in una tale transazione aggiorniamo diverse entità, diverse tabelle.
Durante l'esecuzione di una transazione, può verificarsi una modifica concorrente degli stessi dati da un altro sistema. Ad esempio, il sistema antispam potrebbe decidere che un utente è sospetto e quindi tutte le foto dell'utente non devono più essere pubbliche, devono essere inviate in moderazione, il che significa cambiare photo.status in un altro valore e aggiornare i contatori corrispondenti. È ovvio che se questa operazione avviene senza garanzie di atomicità e isolamento delle modifiche concorrenti, come in , il risultato non sarà quello necessario: o il contatore delle foto mostrerà un valore errato, o non tutte le foto verranno inviate in moderazione.
Codici simili, che manipolano varie entità aziendali all'interno di una singola transazione, sono stati scritti per tutto il tempo di esistenza di Odnoklassniki. Dall'esperienza di migrazioni verso NoSQL con , sappiamo che le maggiori complessità (e costi in termini di tempo) derivano dalla necessità di sviluppare codice volto a mantenere la coerenza dei dati. Pertanto, il principale requisito per il nuovo archivio era garantire la logica applicativa di vere transazioni ACID.
Altrettanto importanti erano i seguenti requisiti:
- In caso di guasto del data center, devono essere accessibili sia la lettura che la scrittura nel nuovo archivio.
- Mantenere l'attuale velocità di sviluppo. Cioè, quando si lavora con il nuovo archivio, la quantità di codice deve essere approssimativamente la stessa, non deve esserci bisogno di aggiungere qualcosa all'archivio, sviluppare algoritmi di risoluzione dei conflitti, mantenere indici secondari, ecc.
- La velocità di funzionamento del nuovo archivio deve essere sufficientemente alta sia per la lettura dei dati che per l'elaborazione delle transazioni, il che significa che soluzioni accademiche rigorose, universali, ma lente, come ad esempio .
- Ridimensionamento automatico in tempo reale.
- Utilizzo di server comuni e a basso costo, senza necessità di acquistare hardware esotico.
- Possibilità di sviluppare lo storage con gli sviluppatori dell'azienda. In altre parole, si privilegiavano soluzioni interne o basate su codice aperto, preferibilmente in Java.
Soluzioni, soluzioni
Analizzando le possibili soluzioni, siamo giunti a due scelte architettoniche possibili:
La prima è prendere un qualsiasi server SQL e implementare la resilienza desiderata, il meccanismo di scalabilità, un cluster tollerante ai guasti, la risoluzione dei conflitti e transazioni ACID distribuite, affidabili e veloci. Abbiamo valutato questa opzione come piuttosto non banale e laboriosa.
La seconda opzione è prendere uno storage NoSQL già pronto con scalabilità implementata, un cluster tollerante ai guasti, la risoluzione dei conflitti e implementare noi stessi le transazioni e SQL. A prima vista, anche solo l'implementazione di SQL, per non parlare delle transazioni ACID, sembra un compito che richiede anni. Ma poi abbiamo capito che il set di funzionalità SQL che utilizziamo nella pratica è lontano dall'ANSI SQL tanto quanto è lontano dall'ANSI SQL. Osservando più attentamente il CQL, abbiamo capito che è abbastanza vicino a quello di cui abbiamo bisogno.
Cassandra e CQL
Quindi, cosa rende interessante Cassandra e quali funzionalità offre?
In primo luogo, è possibile creare tabelle con supporto per diversi tipi di dati, è possibile effettuare SELECT o UPDATE sulla chiave primaria.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Per garantire la coerenza dei dati delle repliche, Cassandra utilizza . Nel caso più semplice, ciò significa che quando si posizionano tre repliche dello stesso dato su nodi diversi del cluster, la scrittura è considerata riuscita se la maggior parte dei nodi (ossia due su tre) ha confermato il successo di questa operazione di scrittura. I dati della riga sono considerati coerenti se, durante la lettura, la maggior parte dei nodi sono stati interrogati e hanno confermato i dati. Pertanto, con tre repliche, viene garantita la piena e immediata coerenza dei dati in caso di guasto di un nodo. Questo approccio ci ha permesso di implementare uno schema ancora più affidabile: inviare sempre richieste a tutte e tre le repliche, attendendo la risposta dalle due più veloci. La risposta tardiva della terza replica viene quindi scartata. Il nodo che ha tardato a rispondere può avere gravi problemi: rallentamenti, garbage collection in JVM, direct memory reclaim nel kernel linux, guasti hardware, disconnessione dalla rete. Tuttavia, ciò non influisce sulle operazioni del cliente e sui dati.
L'approccio in cui ci rivolgiamo a tre nodi, ma riceviamo risposta da due, è chiamato : la richiesta per repliche in più viene inviata prima che avvenga il "fallimento".
Un altro vantaggio di Cassandra è il Batchlog: un meccanismo che garantisce l'applicazione totale o l'assenza totale di un pacchetto di modifiche che apporti. Questo ci consente di realizzare la A in ACID — atomicità out of the box.
La cosa più vicina alle transazioni in Cassandra sono le cosiddette ““. Ma rispetto alle “vere” transazioni ACID sono molto distanti: in effetti, questa è la possibilità di effettuare su dati di una sola riga, utilizzando il consenso nel pesante protocollo Paxos. Pertanto, la velocità di tali transazioni non è elevata.
Cosa ci mancava in Cassandra
Quindi dovevamo implementare in Cassandra vere transazioni ACID. Con cui potremmo facilmente realizzare altre due comode funzionalità delle DBMS classiche: indici rapidi e coerenti, il che ci consentirebbe di eseguire selezioni di dati non solo in base alla chiave primaria e un generatore normale di ID monotoni autoincrementabili.
C*One
Così nacque un nuovo DBMS C*One, composto da tre tipi di nodi server:
- Storage — server Cassandra (quasi) standard, responsabili della memorizzazione dei dati sui dischi locali. Man mano che cresce il carico e il volume dei dati, il loro numero può essere facilmente scalato fino a decine e centinaia.
- I coordinatori delle transazioni garantiscono l'esecuzione delle transazioni.
- I client sono i server delle applicazioni che implementano operazioni aziendali e avviano transazioni. Tali client possono essere migliaia.
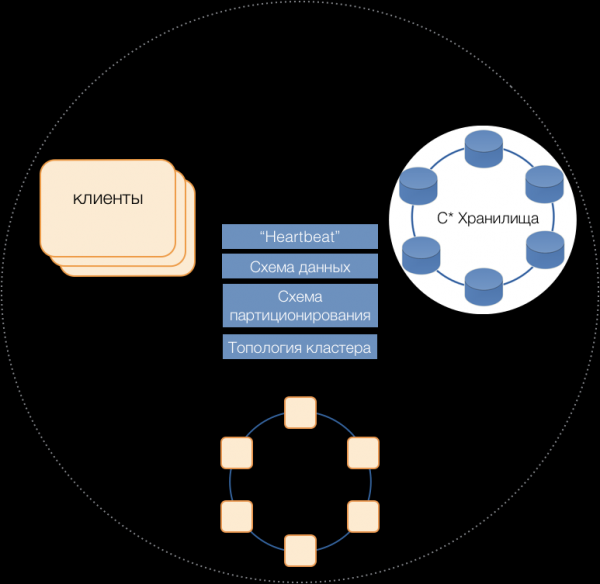
I server di tutti i tipi fanno parte di un cluster comune, utilizzano il protocollo di messaggistica interno di Cassandra per comunicare tra loro e per scambiare informazioni di cluster. Grazie a Heartbeat, i server possono rilevare i guasti reciproci, mantenere un'unica schema dei dati - tabelle, la loro struttura e replica; schema di partizionamento, topologia del cluster, e così via.
Clienti
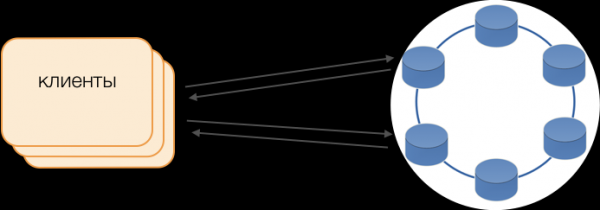
Invece dei driver standard viene utilizzata la modalità Fat Client. Un nodo di questo tipo non memorizza dati, ma può fungere da coordinatore dell'esecuzione delle richieste, ovvero il Client stesso esegue la funzione di coordinatore delle sue richieste: interroga le repliche del repository e risolve i conflitti. Questo è non solo più affidabile e veloce rispetto al driver standard, che richiede comunicazioni con un coordinatore remoto, ma consente anche di gestire l'invio delle richieste. Al di fuori di una transazione aperta sul client, le richieste vengono dirette ai repository. Se il client ha aperto una transazione, tutte le richieste nell'ambito della transazione vengono inviate al coordinatore delle transazioni.
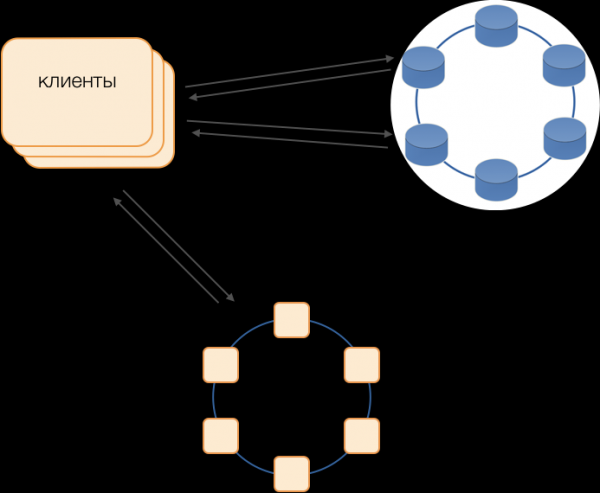
Coordinatore delle transazioni C*One
Il coordinatore è ciò che abbiamo realizzato per C*One da zero. È responsabile della gestione delle transazioni, dei blocchi e dell'ordine di applicazione delle transazioni.
Per ogni transazione gestita, il coordinatore genera un timestamp: ogni successivo è maggiore di quello della transazione precedente. Poiché in Cassandra il sistema di risoluzione dei conflitti si basa sui timestamp (tra due record in conflitto, quello più recente è considerato valido), il conflitto sarà sempre risolto a favore della transazione successiva. In questo modo abbiamo implementato — un modo economico per risolvere i conflitti in un sistema distribuito.
Blocchi
Per garantire l'isolamento, abbiamo deciso di utilizzare il modo più semplice: blocchi pessimisti basati sulla chiave primaria del record. In altre parole, nella transazione, il record deve prima essere bloccato, quindi letto, modificato e salvato. Solo dopo un commit riuscito il record può essere sbloccato affinché le transazioni concorrenti possano utilizzarlo.
L'implementazione di tale blocco è semplice in un ambiente non distribuito. In un sistema distribuito ci sono due percorsi principali: o implementare un blocco distribuito nel cluster, oppure distribuire le transazioni in modo che le transazioni che coinvolgono una registrazione siano sempre gestite dallo stesso coordinatore.
Poiché nel nostro caso i dati sono già distribuiti in gruppi di transazioni locali in SQL, è stato deciso di assegnare ai coordinatori gruppi di transazioni locali: un coordinatore esegue tutte le transazioni con un token da 0 a 9, il secondo con un token da 10 a 19, e così via. Di conseguenza, ciascuno degli esemplari del coordinatore diventa il master del gruppo di transazioni.
Allora i blocchi possono essere implementati sotto forma di una semplice HashMap in memoria del coordinatore.
Guasti dei coordinatori
Poiché un coordinatore gestisce esclusivamente un gruppo di transazioni, è molto importante determinare rapidamente il fatto della sua indisponibilità, affinché il tentativo di riesecuzione della transazione rientri nel timeout. Per garantire che ciò avvenga in modo rapido e affidabile, abbiamo applicato un protocollo di heartbeat a quorum completo:
In ogni data center sono presenti almeno due nodi coordinatori. Periodicamente, ciascun coordinatore invia un messaggio di heartbeat agli altri coordinatori, informandoli sul proprio stato operativo, nonché sui messaggi di heartbeat ricevuti dagli altri coordinatori nel cluster.
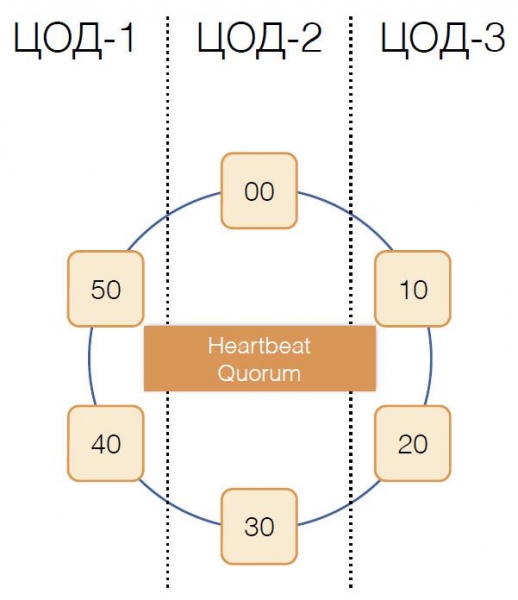
Ricevendo informazioni simili dagli altri nei loro messaggi di heartbeat, ciascun coordinatore decide quali nodi del cluster stanno funzionando e quali no, seguendo il principio del quorum: se il nodo X riceve dalla maggior parte dei nodi del cluster informazioni sulla ricezione normale dei messaggi dal nodo Y, significa che Y è attivo. E viceversa, non appena la maggioranza segnala la mancanza di messaggi dal nodo Y, significa che Y ha fallito. È curioso notare che se il quorum informa il nodo X di non ricevere più messaggi da esso, il nodo stesso X sarà considerato fuori servizio.
I messaggi Heartbeat vengono inviati con grande frequenza, circa 20 volte al secondo, con un intervallo di 50 ms. In Java è difficile garantire una risposta dell'applicazione entro 50 ms a causa della durata comparabile delle pause, causate dal garbage collector. Siamo riusciti a ottenere un tale tempo di risposta utilizzando il garbage collector G1, che consente di specificare un obiettivo per la durata delle pause del GC. Tuttavia, a volte, abbastanza raramente, le pause del garbage collector superano i 50 ms, il che può portare a falsi rilevamenti di guasti. Per evitare ciò, il coordinatore non segnala il guasto di un nodo remoto alla perdita del primo messaggio heartbeat da esso, ma solo se ne mancano più di uno consecutivo. In questo modo siamo riusciti a ottenere il rilevamento del guasto del nodo coordinatore entro 200 ms.
Ma è poco per capire rapidamente quale nodo ha smesso di funzionare. Bisogna fare qualcosa in proposito.
Ridondanza
Lo schema classico prevede, in caso di guasto del master, di avviare le elezioni di un nuovo master mediante uno dei algoritmi. Tuttavia, tali algoritmi hanno ben note problematiche di convergenza temporale e durata del processo elettorale stesso. Siamo riusciti a evitare tali ritardi aggiuntivi mediante uno schema di sostituzione dei coordinatori in una rete completamente connessa:
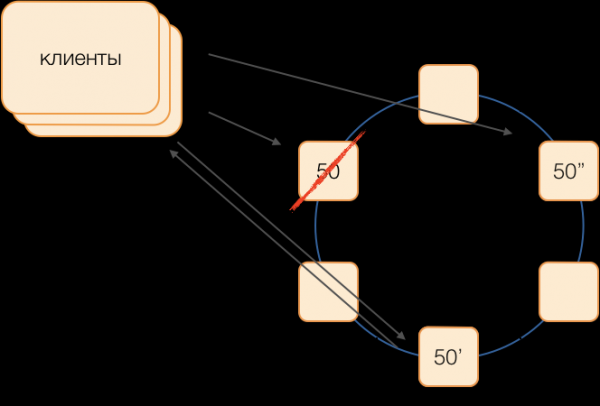
Supponiamo di voler eseguire una transazione nel gruppo 50. Definiamo in anticipo lo schema di sostituzione, cioè quali nodi eseguiranno le transazioni del gruppo 50 in caso di guasto del coordinatore principale. Il nostro obiettivo è mantenere il funzionamento del sistema in caso di guasto del data center. Definiamo che il primo riserva sarà un nodo di un altro data center e la seconda riserva sarà un nodo del terzo. Questo schema viene scelto una volta e non cambia fino a quando non cambia la topologia del cluster, ovvero fino a quando non entrano nuovi nodi (cosa che accade molto raramente). L'ordine di scelta di un nuovo master attivo in caso di guasto del vecchio sarà sempre questo: il primo riserva diventerà il master attivo e, se anche lui smette di funzionare, il secondo riserva.
Questo schema è più affidabile di un algoritmo universale, poiché per attivare un nuovo master è sufficiente determinare il fatto del guasto del vecchio.
Ma come faranno i clienti a capire quale dei maestri sta lavorando in questo momento? In 50 ms è impossibile inviare informazioni a migliaia di clienti. Può succedere che un cliente invii una richiesta per aprire una transazione senza sapere che quel maestro non è più attivo, e la richiesta rimarrà in attesa. Per evitare ciò, i clienti inviano speculativamente la richiesta di apertura della transazione al maestro del gruppo e ai suoi due riservi, ma risponderà a questa richiesta solo colui che è il maestro attivo in quel momento. Tutta la comunicazione successiva nell'ambito della transazione sarà effettuata solo con il maestro attivo.
I maestri riservisti collocano le richieste ricevute per transazioni non proprie in una coda di transazioni non nate, dove rimangono per un certo periodo. Se il maestro attivo termina, un nuovo maestro gestisce le richieste di apertura delle transazioni dalla sua coda e risponde al cliente. Se il cliente ha già aperto una transazione con il vecchio maestro, la seconda risposta viene ignorata (e, ovviamente, tale transazione non si concluderà e verrà ripetuta dal cliente).
Come funziona una transazione
Supponiamo che il cliente abbia inviato al coordinatore una richiesta di apertura di una transazione per una certa entità con una certa chiave primaria. Il coordinatore blocca questa entità e la colloca nella tabella di blocco in memoria. Se necessario, il coordinatore legge quest'entità dal repository e salva i dati ottenuti nello stato della transazione in memoria.
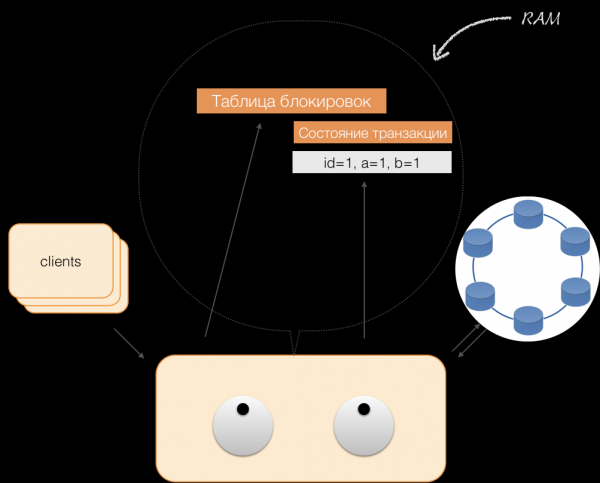
Quando un cliente vuole modificare i dati nella transazione, invia al coordinatore una richiesta di modifica dell'entità, e questi colloca i nuovi dati nella tabella di stato delle transazioni in memoria. A questo punto, la registrazione è terminata: non viene eseguita alcuna registrazione nel repository.
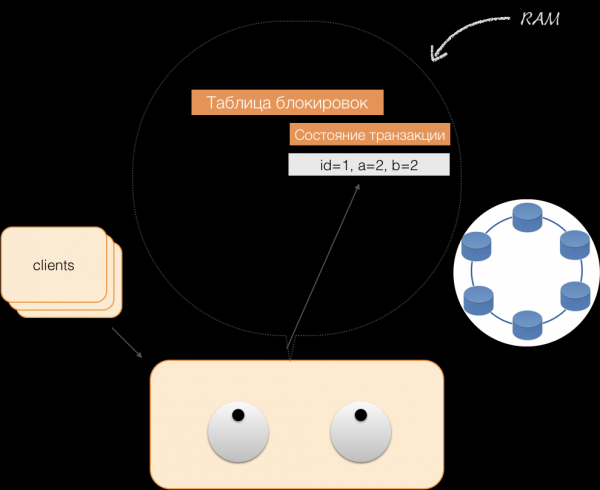
Quando un cliente richiede i propri dati modificati all'interno di una transazione attiva, il coordinatore agisce in questo modo:
- se l'ID è già presente nella transazione, i dati vengono presi dalla memoria;
- se l'ID non è presente in memoria, i dati mancanti vengono letti dai nodi di archiviazione, uniti con quelli già presenti in memoria, e il risultato viene fornito al cliente.
In questo modo, il cliente può leggere le proprie modifiche, mentre gli altri clienti non vedono tali modifiche, poiché sono memorizzate solo nella memoria del coordinatore e non sono ancora disponibili nei nodi di Cassandra.
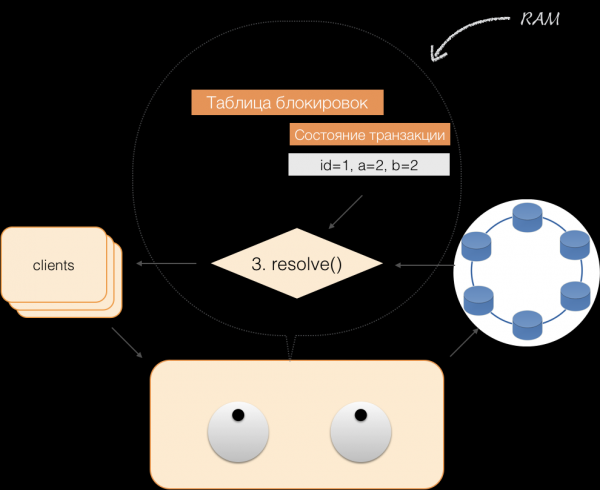
Quando il cliente invia un commit, lo stato presente in memoria del servizio viene salvato dal coordinatore in un batch registrato, e quindi inviato ai repository Cassandra sotto forma di batch registrato. I repository compiono tutto il necessario affinché questo pacchetto venga applicato in modo atomico (completamente), e restituiscono una risposta al coordinatore, che a sua volta libera i blocchi e conferma il successo della transazione al cliente.
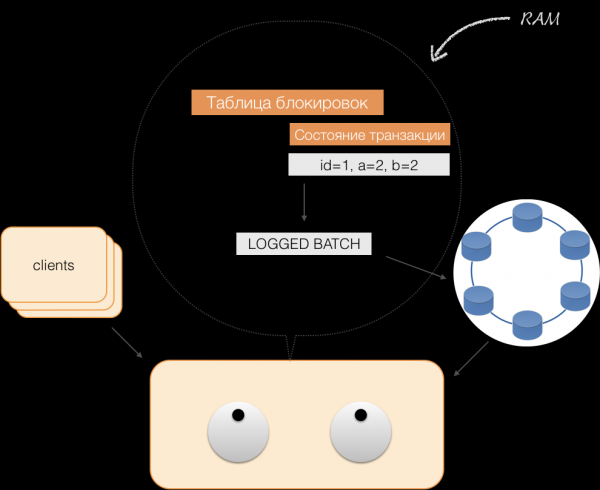
E per annullare, al coordinatore basta liberare la memoria occupata dallo stato della transazione.
A seguito delle modifiche descritte sopra, abbiamo implementato i principi ACID:
- Atomicità. Questa è la garanzia che nessuna transazione sarà registrata nel sistema in modo parziale; tutte le sue sotto-operazioni saranno eseguite oppure nessuna di esse verrà eseguita. Questo principio è rispettato da noi attraverso il batch registrato in Cassandra.
- Coerenza. Ogni transazione andata a buon fine definisce solo i risultati ammissibili. Se dopo aver aperto una transazione e aver eseguito parte delle operazioni si scopre che il risultato non è ammissibile, avviene un rollback.
- Isolamento. Durante l'esecuzione della transazione, le transazioni parallele non devono influenzarne il risultato. Le transazioni concorrenti sono isolate mediante blocchi pessimisti sul coordinatore. Per le letture al di fuori della transazione viene rispettato il principio di isolamento a livello di Read Committed.
- Resilienza. Indipendentemente dai problemi ai livelli inferiori — come un'interruzione di corrente, guasti hardware — le modifiche apportate da una transazione completata con successo devono rimanere salvate dopo il ripristino del funzionamento.
Lettura per indici
Prendiamo una semplice tabella:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Questa tabella ha un ID (chiave primaria), un proprietario e una data di modifica. Dobbiamo effettuare una query molto semplice — selezionare i dati in base all'owner con la data di modifica "nell'ultimo giorno".
SELECT *
WHERE owner=?
AND modified>?
Affinché una simile query venga eseguita rapidamente, in un classico DBMS SQL è necessario costruire un indice sulle colonne (owner, modified). Possiamo fare ciò molto facilmente, poiché ora abbiamo garanzie ACID!
Indici in C*One
Esiste una tabella di base con foto, in cui l'ID della registrazione è la chiave primaria.
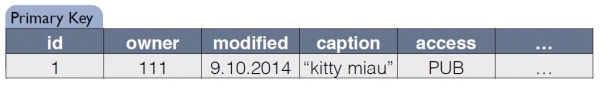
Per l'indice C*One crea una nuova tabella, che è una copia della tabella originale. La chiave coincide con l'espressione indice, mentre include anche la chiave primaria della registrazione dalla tabella originale:
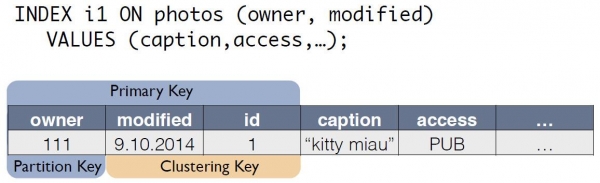
Ora la richiesta per «il proprietario nelle ultime 24 ore» può essere riscritta come select da un'altra tabella:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
La coerenza dei dati della tabella originale photos e dell'indice i1 è mantenuta automaticamente dal coordinatore. Basandosi solo sullo schema dei dati, al verificarsi di una modifica, il coordinatore genera e memorizza il cambiamento non solo della tabella principale, ma anche delle sue copie. Non vengono eseguite azioni aggiuntive sulla tabella dell'indice, i log non vengono letti, e non vengono utilizzati blocchi. Questo significa che l'aggiunta di indici consuma quasi nessuna risorsa e non influisce praticamente sulla velocità di applicazione delle modifiche.
Con ACID siamo riusciti a implementare indici «come in SQL». Essi possiedono coerenza, possono scalare, funzionano rapidamente, possono essere composti e integrati nel linguaggio di query CQL. Per supportare gli indici non è necessario apportare modifiche al codice applicativo. È tutto semplice, come in SQL. E cosa più importante, gli indici non influenzano la velocità di esecuzione delle modifiche nella tabella originale delle transazioni.
Risultato ottenuto
Abbiamo sviluppato C*One tre anni fa e l'abbiamo messo in produzione.
Cosa abbiamo ottenuto quindi? Valutiamolo prendendo ad esempio il sottosistema di elaborazione e archiviazione delle fotografie, uno dei tipi di dati più importanti in una rete sociale. Non si tratta dei corpi delle fotografie, ma di tutte le varie meta-informazioni. Oggi, in «Odnoklassniki», ci sono circa 20 miliardi di tali registrazioni, il sistema gestisce 80.000 richieste di lettura al secondo, fino a 8.000 transazioni ACID al secondo relative alla modifica dei dati.
Quando utilizzavamo SQL con replication factor = 1 (ma in RAID 10), la meta-informazione delle fotografie era memorizzata su un cluster ad alta disponibilità di 32 macchine con Microsoft SQL Server (più 11 di riserva). Sono stati riservati anche 10 server per archiviare i backup. In totale 50 macchine costose. Nel frattempo, il sistema operava a carico nominale, senza margine.
Dopo la migrazione al nuovo sistema abbiamo ottenuto replication factor = 3 — una copia in ogni data center. Il sistema è composto da 63 nodi di archiviazione Cassandra e 6 macchine coordinatrici, per un totale di 69 server. Ma queste macchine sono notevolmente più economiche, il loro costo totale è circa il 30% del costo del sistema su SQL. Nel frattempo, il carico si mantiene attorno al 30%.
Con l'implementazione di C*One sono diminuite anche le latenza: in SQL l'operazione di scrittura richiedeva circa 4,5 ms. In C*One — circa 1,6 ms. La durata della transazione è mediamente inferiore a 40 ms, il commit avviene in 2 ms, la durata di lettura e scrittura — in media 2 ms. Il 99° percentile — solo 3-3,1 ms, il numero di timeout è diminuito di 100 volte — tutto grazie all'ampio utilizzo delle speculazioni.
Al momento, la maggior parte dei nodi SQL Server è stata dismessa, i nuovi prodotti vengono sviluppati esclusivamente utilizzando C*One. Abbiamo adattato C*One per funzionare nel nostro cloud , il che ha permesso di accelerare il dispiegamento di nuovi cluster, semplificare la configurazione e automatizzare l'operatività. Senza il codice sorgente sarebbe stato molto più complicato e
Attualmente stiamo lavorando alla migrazione di altri nostri archivi nel cloud — ma questa è un'altra storia.
Fonte: habr.com
