

Ho visto una pubblicazione in cui si affermava che PVS aveva finalmente imparato ad analizzare sotto Linux e ho deciso di provarlo sui miei progetti. Ed ecco cosa ne è venuto fuori.
Contenuto
Supporto reattivo
Ho richiesto una chiave di prova e me l'hanno inviata lo stesso giorno.
Documentazione abbastanza chiara
L'analizzatore è stato avviato senza particolari problemi. È disponibile anche un aiuto per i comandi della console (anche se ci sono delle lamentele, vedi la sezione ).
Possibilità di analisi multithread
L'analizzatore ha un'opzione "standard" -j, che consente di eseguire l'analisi in parallelo su più attività. Questo fa risparmiare molto tempo.
Buona visualizzazione
Diversi formati di output, da testo a una piccola interfaccia web. .
Integrazione semplice nel processo di compilazione
Tutta la documentazione è disponibile sul loro sito, posso solo dire che se il tuo progetto è compilato con CMake, è tutto molto semplice.
Buone descrizioni delle diagnosi
Se si genera l'output in modalità fullhtml, ogni messaggio ha un collegamento alla descrizione della diagnosi, con spiegazioni, esempi di codice e collegamenti aggiuntivi.
Mancanza di conoscenza del linguaggio C++ da parte dell'analizzatore
Sfortunatamente, PVS a volte commette errori di sintassi e genera messaggi falsi positivi anche per codice perfettamente corretto.
Ad esempio, c'è una funzione che restituisce void:
template <typename T>
auto copy (const void * source, void * destination)
    ->
        std::enable_if_t
        <
            std::is_copy_constructible<T>::value
        >
{
    new (destination) T(*static_cast<const T *>(source));
}
Sì, la parola chiave auto può significare void, ed è per questo che auto. Ma PVS ha fornito i seguenti messaggi:
dynamic_tuple_management.hpp:29:1: error: V591 Non-void function should return a value.
dynamic_tuple_management.hpp:29:1: error: V2542 Function with a non-void return type should return a value from all exit paths.
Sito molto lento
Sì, nell'interfaccia web accanto a ogni messaggio c'è un collegamento alla corrispondente descrizione della diagnosi con esempi. Ma fare clic sul collegamento richiede abbastanza tempo, a volte anche .
Lingua
Tutte le descrizioni sono in russo, il che è ottimo. Ma i collegamenti nei rapporti portano sempre alla versione in inglese. Sarebbe utile avere la possibilità di cambiare lingua, in modo da poter visualizzare le diagnosi direttamente in russo. Non ho trovato questa opzione nell'interfaccia.
Scomodo lavorare con i livelli di diagnosi attraverso la console
Iniziamo col dire che le due squadre utilizzate (questo pvs-studio-analyzer e plog-converter) hanno formati diversi per la definizione delle diagnosi.
La documentazione per pvs-studio-analyzer afferma:
-a [MODE], --analysis-mode [MODE]
    MODE definisce il tipo di avvisi:
    1 - errori a 64 bit;
    2 - riservato;
    4 - Analisi generale;
    8 - Micro-ottimizzazioni;
    16 - Richieste specifiche dei clienti;
    32 - MISRA.
    I modi possono essere combinati sommando i valori
    Predefinito: 4
Ho faticato a capire dove dovessi aggiungere («adding the values») le chiavi. Ho provato a elencarle con la virgola:
pvs-studio-analyzer analyze ... -a 1,4,16Ho provato a scrivere la chiave più volte:
pvs-studio-analyzer analyze ... -a 1 -a 4 -a 16E solo dopo ho capito che si trattava di maschere bit a bit! E dovevo sommare, e non aggiungere i valori. Ad esempio, per ottenere le diagnosi generali, quelle sulle micro-ottimizzazioni e MISRA, dovevo sommarlre (4 + 8 + 32 = 44):
pvs-studio-analyzer analyze ... -a 44L'uso delle maschere bit a bit nelle interfacce utente è, in genere, di cattivo gusto. Si poteva sommare tutto all'interno, e fornire all'utente un insieme di flag.
Inoltre, c'è un'altra utility plog-converter, che genera informazioni leggibili dall'utente sull'analisi statica. Ha altre problematiche.
La documentazione del programma plog-converter afferma:
-a, --analyzer            Specifica l'analizzatore e il livello da utilizzare per il filtraggio, cioè
                          'GA:1,2;64:1;OP:1,2,3;CS:1;MISRA:1,2'
                          Predefinito: GA:1,2
Qui sono apparsi dei "livelli", che prima non c'erano, e non ho trovato nulla al riguardo nella documentazione.
In sostanza, è poco chiaro. Pertanto, ho impostato tutto al massimo.
Un sacco di avvisi inutili su Catch
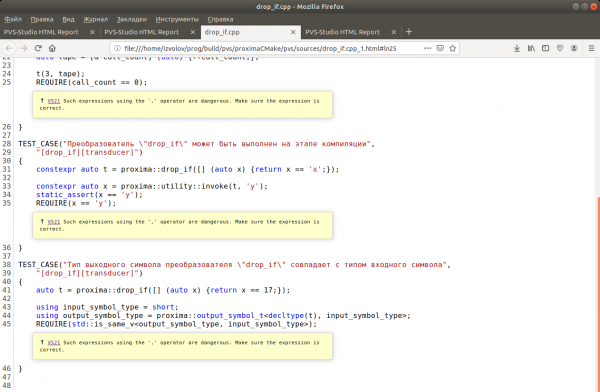
In due dei tre progetti che ho analizzato, viene utilizzata la libreria di testing modulare . E la maggior parte dei messaggi (!!! 90 su 138 in uno e 297 su 344 nell'altro !!!) appare nel seguente modo:
Non considera la multithreading
Molti falsi positivi riguardo a variabili che dovrebbero essere immutabili o cicli infiniti, mentre l'interazione con queste variabili avviene in thread diversi, e se non fosse così, i test modulari non si attiverebbero.
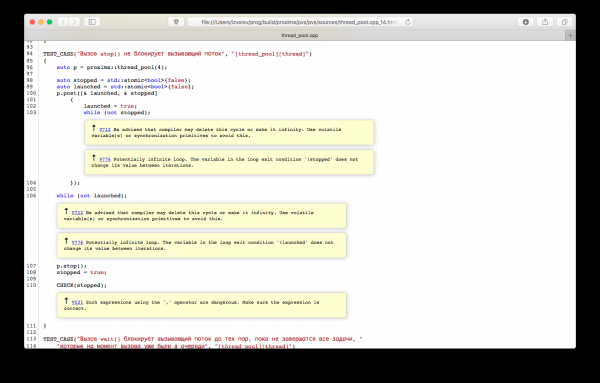
Tuttavia, può un analizzatore statico considerare tutto ciò? Non lo so.
PVS non ha trovato alcun errore reale nei miei progetti aperti e , così come in un progetto di lavoro che, per ovvi motivi, non posso mostrare. Tuttavia, è importante tenere presente che alcuni problemi erano già stati rilevati e corretti in precedenza utilizzando e .
In generale, l'impressione di tutti questi analizzatori è piuttosto simile: sì, catturano qualcosa, a volte anche qualcosa di importante, ma nel complesso un compilatore è sufficiente.
Forse (e personalmente mi piace pensarlo), il nostro team utilizza pratiche di sviluppo software che consentono di generare la minima quantità di codice scadente. È meglio non creare problemi piuttosto che superarli eroicamente.
Pertanto, mi prendo la libertà di dare alcuni consigli su come scrivere in C++ in modo da non spararsi nei piedi e non colpirsi in testa con i rastrelli.
Utilizzate al massimo le diagnosi del compilatore
Il nostro team utilizza (e vi consiglia) le seguenti opzioni di compilazione:
-Werror

-Wall
-Wextra
-Wpedantic

-Wcast-align
-Wcast-qual
-Wconversion
-Wctor-dtor-privacy
-Wenum-compare
-Wfloat-equal
-Wnon-virtual-dtor
-Wold-style-cast
-Woverloaded-virtual
-Wredundant-decls
-Wsign-conversion
-Wsign-promo
Includetele nel vostro progetto, scoprirete molte cose nuove sul vostro codice.
Seguite gli standard
Cercate di non utilizzare elementi dipendenti dalla piattaforma, se ci sono analoghi standard, e se non potete farne a meno, racchiudeteli in blocchi speciali sotto macro (o in altro modo) e non permettete semplicemente che il vostro codice venga compilato in condizioni non supportate.
Attenetevi alla semantica standard delle operazioni
L'addizione deve essere addizione, la moltiplicazione deve essere moltiplicazione, la chiamata di funzione deve essere una chiamata di funzione, la copia deve copiare, il trasferimento deve trasferire, un contenitore deve essere iterabile, l'iteratore deve avere progresso ++ e dereferenziazione *. E così via, e così via.
Penso che il concetto sia chiaro. Ci sono convenzioni consolidate che non sono obbligatorie, ma che tutti gli utenti e lettori del vostro codice si aspettano di vedere. Non cercate di sovrastare gli altri, altrimenti finirete per ingannare voi stessi.
Scrivete codice compatibile
Prima di tutto, mi riferisco alla libreria standard. È molto desiderabile che le interfacce delle vostre classi e funzioni possano essere utilizzate con librerie standard e altre librerie (ad esempio, Boost).
Non esitate a dare un'occhiata alle interfacce di STL e Boost. Con rare eccezioni, lì troverete un esempio degno di imitazione.
Utilizzate al massimo gli strumenti open source
Per la stessa analisi statica, esistono almeno due strumenti open source gratuiti che si collegano una sola volta a qualsiasi progetto con sistema di build CMake.
.
Vorrei sottolineare che non intendo dissuadere dall'uso di PVS o di altri analizzatori statici. Tuttavia, vi esorto a riflettere su come sia possibile che un analizzatore statico trovi costantemente errori significativi nel vostro codice.
Questo è solo un effetto. È necessario cercare e risolvere la causa.
Fonte: habr.com
