

Introduzione ai sistemi operativi
Ciao, Habr! Vorrei presentarvi una serie di articoli di traduzione su una letteratura che trovo interessante — OSTEP. In questo materiale vengono esaminati in profondità i funzionamenti dei sistemi operativi Unix-like, in particolare — il lavoro con i processi, diversi scheduler, memoria e altri componenti simili che costituiscono un moderno sistema operativo. Potete vedere l'originale di tutti i materiali qui . Si prega di considerare che la traduzione è stata eseguita non professionalmente (abbastanza liberamente), ma spero di aver mantenuto il significato generale.
I lavori di laboratorio su questo argomento possono essere trovati qui:
Altre parti:
E potete anche dare un'occhiata al mio canale su =)
Introduzione al pianificatore
Il cuore del problema: Come sviluppare la politica del pianificatore
Come dovrebbero essere sviluppati i framework di base delle politiche del pianificatore? Quali dovrebbero essere le assunzioni chiave? Quali metriche sono importanti? Quali tecniche di base sono state utilizzate nei primi sistemi di calcolo?
Assunzioni sul carico di lavoro
Prima di discutere le possibili politiche, iniziamo con alcune semplificazioni sui processi avviati nel sistema, che sono complessivamente chiamati carico di lavoro. Definire il carico di lavoro come una parte critica della creazione delle politiche e più conosci il carico, migliore sarà la politica che riuscirai a scrivere.
Faremo le seguenti assunzioni sui processi avviati nel sistema, a volte chiamati jobs (task). Quasi tutte queste assunzioni non sono realistiche, ma sono necessarie per sviluppare il pensiero.
- Ogni task è in esecuzione per lo stesso intervallo di tempo,
- Tutti i task sono avviati contemporaneamente,
- Il task avviato continua fino al completamento,
- Tutti i task utilizzano solo la CPU,
- Il tempo di esecuzione di ogni task è noto.
Metriche del pianificatore
Oltre ad alcune assunzioni sul carico, è necessario anche uno strumento di confronto per le varie politiche di pianificazione: le metriche del pianificatore. Una metrica è semplicemente una misura di qualcosa. Ci sono diverse metriche che possono essere utilizzate per confrontare i pianificatori.
Come esempio utilizzeremo la metrica chiamata tempo di turnaround (turnaround time). Il tempo di turnaround di un task viene definito come la differenza tra il tempo di completamento del task e il tempo di arrivo del task nel sistema.
Tturnaround=Tcompletion−Tarrival
Poiché abbiamo assunto che tutti i task siano arrivati nello stesso momento, allora Ta=0 e quindi Tt=Tc. Questo valore cambierà naturalmente quando modificheremo le assunzioni sopra menzionate.
Un'altra metrica è fairness (equità). Prestazioni e equità sono spesso caratteristiche contrapposte nella pianificazione. Ad esempio, un pianificatore può ottimizzare le prestazioni, ma a scapito del tempo di attesa di altri task, riducendo così l'equità.
FIRST IN FIRST OUT (FIFO)
L'algoritmo più semplice che possiamo implementare si chiama FIFO o first come (in), first served (out). Questo algoritmo ha diversi vantaggi: è molto semplice da implementare e si adatta a tutte le nostre ipotesi, svolgendo il compito piuttosto bene.
Consideriamo un semplice esempio. Supponiamo che 3 task siano stati assegnati contemporaneamente. Ma supponiamo che il task A sia arrivato un po' prima degli altri, quindi nella lista di esecuzione apparirà prima degli altri, proprio come B rispetto a V. Supponiamo che ognuno di essi venga eseguito per 10 secondi. Quale sarà quindi il tempo medio di esecuzione di questi task?
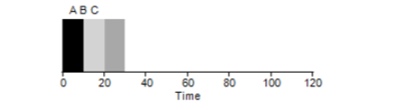
Calcolando i valori — 10+20+30 e dividendo per 3, otteniamo un tempo medio di esecuzione del programma pari a 20 secondi.
Ora proviamo a modificare le nostre ipotesi. In particolare, l'ipotesi 1 e in questo modo non supponiamo più che ogni task richieda lo stesso tempo di esecuzione. Come si comporterà FIFO questa volta?
Come si può vedere, tempi di esecuzione differenti dei task influenzano negativamente la produttività dell'algoritmo FIFO. Supponiamo che il task A venga eseguito per 100 secondi, mentre B e V continuano a richiedere 10 secondi ciascuno.
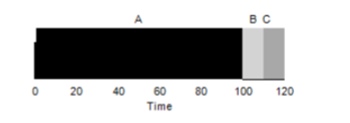
Come si può vedere dall'immagine, il tempo medio per il sistema sarà (100+110+120)/3=110. Questo effetto è chiamato effetto convoglio, quando alcuni consumatori a breve termine di una risorsa si trovano in coda dietro a un consumatore pesante. È simile a una fila al supermercato, quando davanti a te c'è un cliente con un carrello pieno. La soluzione migliore al problema è cercare di cambiare cassa o rilassarsi e respirare profondamente.
Shortest Job First
C'è un modo per risolvere situazioni simili con processi pesanti? Certo. Un altro tipo di pianificazione si chiamaShortest Job First (SJF). Il suo algoritmo è anch'esso piuttosto primitivo — come suggerisce il nome, le prime a essere eseguite saranno le task più brevi, una dopo l'altra.
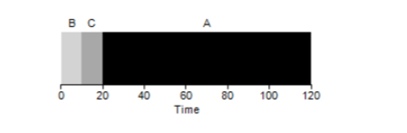
In questo esempio, il risultato dell'esecuzione degli stessi processi sarà un miglioramento del tempo medio di turnaround dei programmi e sarà pari a 50 invece di 110, il che è praticamente il doppio migliore.
Pertanto, dato il presupposto che tutti i compiti arrivino contemporaneamente, l'algoritmo SJF sembra essere l'algoritmo più ottimale. Tuttavia, le nostre assunzioni non sembrano ancora realistiche. Questa volta cambiamo l'assunzione 2 e consideriamo che i compiti possano arrivare in qualsiasi momento, e non tutti insieme. A quali problemi potrebbe portare questo?
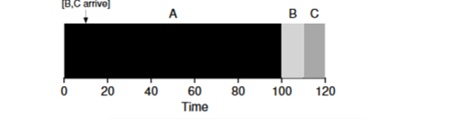
Immaginiamo che il compito A (100s) arrivi per primo e inizi ad essere eseguito. Al momento t=10 arrivano i compiti B e C, ognuno dei quali richiederà 10 secondi. Pertanto, il tempo medio di esecuzione è (100+(110-10)+(120-10))3 = 103. Che cosa potrebbe fare il pianificatore per migliorare la situazione?
Shortest Time-to-Completion First (STCF)
Per migliorare la situazione, ignoreremo l'assunzione 3 che afferma che il programma viene avviato e funziona fino al completamento. Inoltre, avremo bisogno del supporto dell'hardware e, come potreste immaginare, utilizzeremo un timer per interrompere il compito in esecuzione e eseguire il cambio di contesto. In questo modo, il pianificatore può intervenire al momento dell'arrivo dei compiti B e C — interrompere l'esecuzione del compito A e avviare l'elaborazione dei compiti B e C e, al termine di questi, riprendere l'esecuzione del processo A. Questo tipo di pianificatore è chiamato STCFo Preemptive Job First.
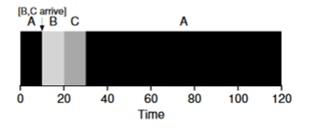
Il risultato di questo pianificatore sarà il seguente: ((120-0)+(20-10)+(30-10)) / 3 = 50. Di conseguenza, questo pianificatore diventa ancora più ottimale per i nostri compiti.
Metrica Tempo di Risposta (Response Time)
Pertanto, se conosciamo i tempi di esecuzione dei compiti e che questi compiti utilizzano solo la CPU, lo STCF sarà la soluzione migliore. In passato, questi algoritmi funzionavano e piuttosto bene. Tuttavia, ora l'utente trascorre la maggior parte del tempo al terminale e si aspetta un'interazione interattiva produttiva. Così è nata una nuova metrica — tempo di risposta (response).
Il tempo di risposta viene calcolato come segue:
Tresponse = Tfirstrun − Tarrival
Pertanto, per l'esempio precedente, il tempo di risposta sarà il seguente: A=0, B=0, C=10 (abg=3,33).
E si scopre che l'algoritmo STCF non è poi così buono in situazioni in cui 3 compiti arrivano contemporaneamente: deve aspettare che i compiti più piccoli siano completamente completati. Così, l'algoritmo è buono per la metrica del tempo di turnaround, ma scarso per la metrica dell'interattività. Immaginate di essere seduti a un terminale e di dover aspettare più di 10 secondi per digitare simboli in un editor, perché un'altra attività occupa il processore. Non è affatto piacevole.
Pertanto, ci troviamo di fronte a un altro problema: come possiamo costruire uno scheduler che sia sensibile ai tempi di risposta?
Round Robin
Per risolvere questo problema è stato sviluppato l'algoritmo Round Robin (RR). L'idea principale è piuttosto semplice: invece di eseguire i compiti fino al completamento, eseguiremo un compito per un intervallo di tempo (chiamato quantum di tempo) e poi passeremo a un altro compito in coda. L'algoritmo ripete il suo lavoro fino a quando tutti i compiti non sono completati. Di conseguenza, il tempo di esecuzione del programma deve essere multiplo del tempo dopo il quale il timer interromperà il processo. Ad esempio, se il timer interrompe il processo ogni x=10ms, la dimensione della finestra di esecuzione del processo deve essere un multiplo di 10 e può essere 10, 20 o x*10.
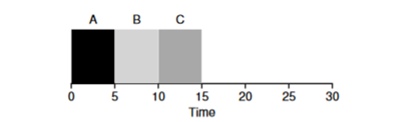
Consideriamo un esempio: i compiti A, B e C arrivano contemporaneamente nel sistema e ciascuno di essi desidera lavorare per 5 secondi. L'algoritmo SJF eseguirà ciascun compito fino alla fine, prima di avviare un altro. Al contrario, l'algoritmo RR con una finestra di esecuzione di 1s eseguirà i compiti nel seguente modo (fig. 4.3):
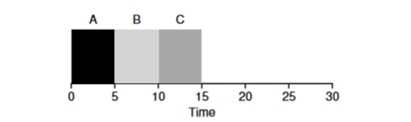
(SJF Again (Bad for Response Time)
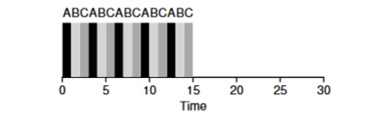
(Round Robin (Good For Response Time)
Il tempo medio di risposta per l'algoritmo RR (0+1+2)/3=1, mentre per SJF (0+5+10)/3=5.
È logico supporre che la finestra di tempo sia un parametro molto importante per il RR; minore è, maggiore sarà il tempo di risposta. Tuttavia, non si può renderla eccessivamente piccola, poiché il tempo di commutazione del contesto giocherà anch'esso un ruolo nelle prestazioni complessive. Pertanto, la selezione del tempo di finestra di esecuzione è determinata dall'architetto del sistema operativo e dipende dai compiti che si prevede di eseguire. La commutazione del contesto non è l'unica operazione di servizio che richiede tempo; un programma in esecuzione deve gestire anche altre cose, come vari cache, e a ogni commutazione è necessario salvare e ripristinare questo ambiente, il che può richiedere anche molto tempo.
Il RR è un ottimo pianificatore se parliamo solo della metrica del tempo di risposta. Ma come si comporterà la metrica del tempo di turnaround delle attività con questo algoritmo? Consideriamo l'esempio sopra, in cui i tempi di esecuzione A, B, C = 5s e arrivano allo stesso tempo. Il compito A terminerà alle 13, B alle 14, C alle 15s e il tempo medio di turnaround sarà di 14s. Pertanto, il RR è l’algoritmo peggiore per la metrica del turnaround.
Parlando più in generale, qualsiasi algoritmo di tipo RR è equo; divide il tempo di CPU equamente tra tutti i processi. E così, queste metriche sono costantemente in conflitto tra loro.
Così, abbiamo diversi algoritmi opposti e rimangono anche alcune ipotesi: che il tempo del compito sia noto e che il compito utilizzi solo la CPU.
Mescolamento con I/O
Iniziamo rimuovendo l'ipotesi 4, che il processo utilizzi solo la CPU; naturalmente non è così e i processi possono accedere anche ad altre attrezzature.
Nel momento in cui un processo richiede un'operazione di input/output, il processo passa allo stato di blocked, in attesa di completare l'I/O. Se l'I/O è diretto a un disco rigido, tale operazione può occupare fino a diversi ms o più a lungo, e la CPU in quel momento sarà inattiva. Durante questo tempo, il pianificatore può assegnare la CPU a un altro processo. La successiva decisione che dovrà prendere il pianificatore è quando il processo terminerà il suo I/O. Quando accade, si verifica un'interruzione e il sistema operativo passerà il processo che ha richiesto l'I/O allo stato di ready.
Consideriamo un esempio con diverse attività. Ognuna di esse ha bisogno di 50 ms di tempo di CPU. Tuttavia, la prima richiederà ogni 10 ms l'accesso all'I/O (che verrà eseguito anche ogni 10 ms). Mentre il processo B utilizza semplicemente 50 ms di CPU senza I/O.
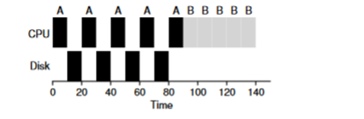
In questo esempio utilizzeremo il piano STCF. Come si comporterà questo piano se avviamo un processo come A? Procederà in questo modo: prima terminerà completamente il processo A e poi passerà al processo B.
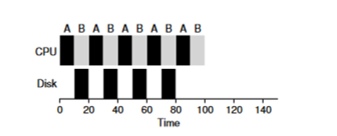
L'approccio tradizionale per risolvere questo problema è interpretare ogni sottocompito di 10 ms del processo A come un'attività separata. Così, all'inizio con l'algoritmo STJF, è evidente la scelta tra un'attività di 50 ms e una di 10 ms. Poi, quando il sottocompito A è completato, verrà avviato il processo B e l'I/O. Dopo il completamento dell'I/O, sarà deciso di avviare nuovamente il processo A da 10 ms anziché il processo B. In questo modo, è possibile realizzare una sovrapposizione, in cui la CPU è utilizzata da un altro processo mentre il primo attende l'I/O. Di conseguenza, il sistema viene meglio utilizzato: nel momento in cui i processi interattivi stanno aspettando l'I/O, possono essere eseguiti altri processi sulla CPU.
L'oracolo non c'è più.
Ora cerchiamo di liberarci dell'idea che il tempo di esecuzione di un'attività sia noto. Questa è, in generale, l'ipotesi peggiore e più poco realistica dell'intero elenco. Infatti, nelle normali OS medie, il sistema operativo sa generalmente molto poco sul tempo di esecuzione dei task; come possiamo quindi costruire un piano senza sapere quanto tempo impiegherà un'attività? Forse potremmo utilizzare alcuni principi del RR per risolvere questo problema?
Risultato
Abbiamo esaminato le idee di base della pianificazione dei task e considerato due famiglie di pianificatori. La prima avvia l'attività più breve all'inizio, migliorando in tal modo il tempo di turnaround, mentre la seconda interrompe equamente tutte le attività, migliorando il tempo di risposta. Entrambi gli algoritmi hanno dei difetti dove gli altri algoritmi eccellono. Abbiamo anche visto come l'uso parallelo di CPU e I/O possa migliorare le prestazioni, ma non abbiamo ancora risolto il problema della visione del sistema operativo. Alla prossima lezione, esamineremo un pianificatore che guarda al passato recente e cerca di prevedere il futuro. Si chiama multi-level feedback queue.
Fonte: habr.com
