

Il database analitico ClickHouse gestisce una grande varietà di stringhe, consumando risorse. Per velocizzare il funzionamento del sistema, vengono costantemente aggiunte nuove ottimizzazioni. Lo sviluppatore di ClickHouse, Nikolai Kochetov, parla del tipo di dato stringa, compreso il nuovo tipo LowCardinality, e spiega come ottimizzare il lavoro con le stringhe.
— Prima di tutto, vediamo come possiamo memorizzare le stringhe.
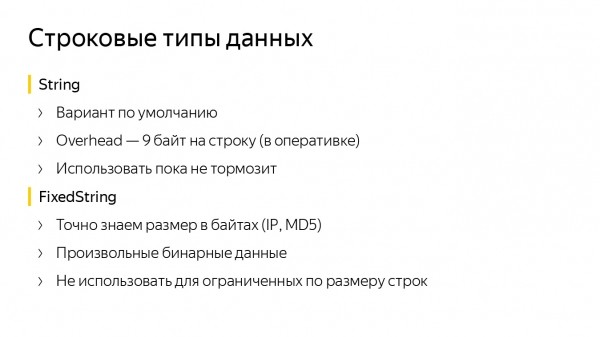
Abbiamo i tipi di dati stringa. Il tipo String è adatto per impostazione predefinita e vale la pena utilizzarlo quasi sempre. Ha un sovraccarico minimo: 9 byte per ogni stringa. Se desideriamo che la dimensione delle stringhe sia fissa e nota in anticipo, è meglio usare FixedString. In questo modo possiamo definire il numero di byte desiderato, rendendolo utile per dati come indirizzi IP o funzioni hash.
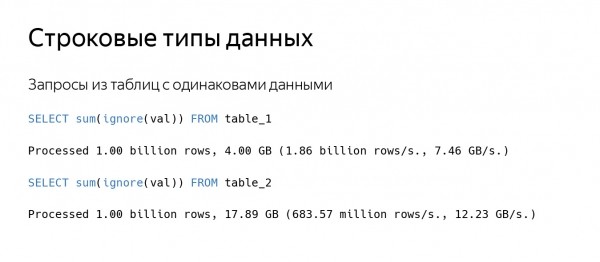
Certamente, a volte qualcosa può rallentare. Supponiamo di fare una query su una tabella. ClickHouse legge una quantità piuttosto elevata di dati, ad esempio a una velocità di 100 GB/s, mentre il numero di stringhe elaborate è basso. Abbiamo due tabelle che memorizzano dati quasi identici. Dalla seconda tabella, ClickHouse legge i dati a una velocità maggiore, ma il numero di stringhe lette al secondo è tre volte inferiore.
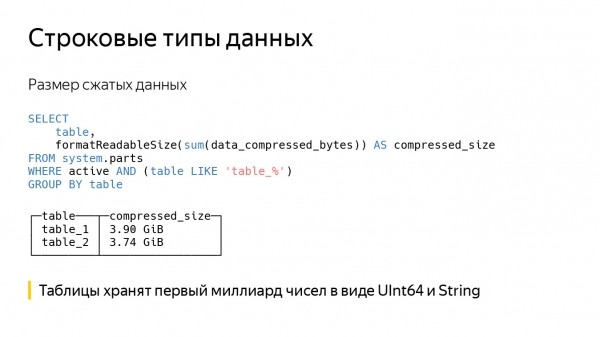
Se guardiamo alla dimensione dei dati compressi, risulta quasi uguale. In realtà, nelle tabelle sono memorizzati gli stessi dati: il primo miliardo di numeri — solo che nella prima colonna sono scritti come UInt64 e nella seconda come String. Per questo motivo, la seconda query impiega più tempo a leggere i dati dal disco e a decomprimerli.
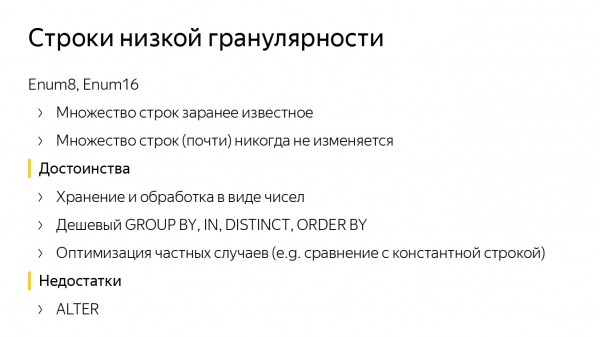
Ecco un altro esempio. Supponiamo che ci sia un insieme di stringhe noto in anticipo, limitato a una costante di 1000 o 10.000 e che non cambi praticamente mai. Per questo caso, ci sembrano adatte le Enum, in ClickHouse ne abbiamo due: Enum8 e Enum16. Grazie alla memorizzazione nelle Enum, possiamo elaborare rapidamente le query.
In ClickHouse ci sono ottimizzazioni per GROUP BY, IN, DISTINCT e ottimizzazioni per certe funzioni, ad esempio per il confronto con una stringa costante. Ovviamente, i numeri nelle stringhe non vengono convertiti; al contrario, la stringa costante viene trasformata nel valore Enum. Dopo di ciò, tutto viene confrontato rapidamente.
Ma ci sono anche degli svantaggi. Anche se conosciamo l'insieme esatto di stringhe, a volte deve essere ampliato. Se arriva una nuova stringa, dobbiamo effettuare un ALTER.
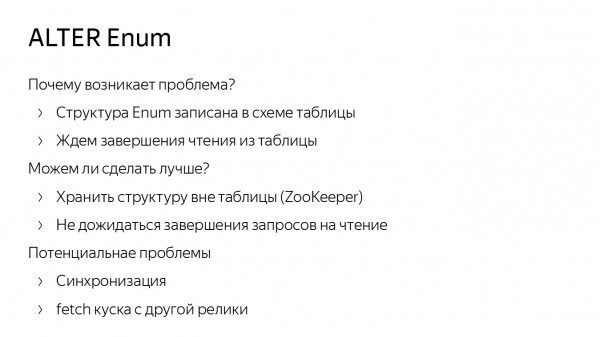
L'ALTER per Enum in ClickHouse è implementato in modo ottimale. Non riscriviamo i dati su disco, ma l'ALTER può rallentare perché le strutture Enum sono memorizzate nello schema della tabella stessa. Pertanto, dobbiamo attendere le richieste di lettura dalla tabella, ad esempio.
Sorge il problema: si può fare meglio? Probabilmente sì. Si potrebbe salvare la struttura Enum non nello schema della tabella, ma in ZooKeeper. Tuttavia, potrebbero sorgere problemi legati alla sincronizzazione. Ad esempio, un replica ha ricevuto i dati, mentre un'altra no, e se quest'ultima ha un Enum obsoleto, qualcosa si romperà. (In ClickHouse abbiamo quasi completato le richieste ALTER non bloccanti. Quando saranno completamente pronte, non sarà necessario attendere le richieste di lettura.)
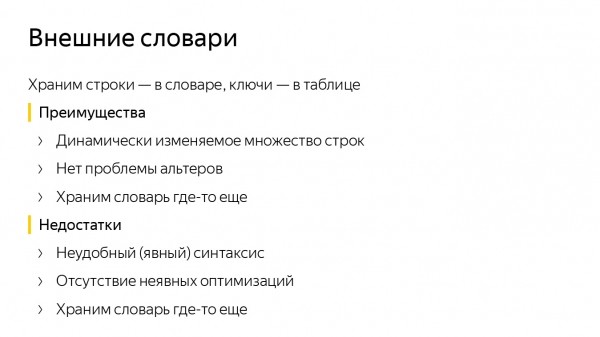
Per non doversi occupare dell'ALTER Enum, è possibile utilizzare i dizionari esterni di ClickHouse. Ricordo che si tratta di una struttura dati key-value all'interno di ClickHouse, tramite la quale è possibile ottenere dati da fonti esterne, ad esempio da tabelle MySQL.
Nel dizionario ClickHouse memorizziamo molte stringhe diverse, mentre nella tabella abbiamo i loro identificatori sotto forma di numeri. Se dobbiamo ottenere una stringa, invochiamo la funzione dictGet e lavoriamo con essa. Dopodiché non dobbiamo fare ALTER. Per aggiungere qualcosa a Enum, lo inseriamo nella stessa tabella MySQL.
Ma qui sorgono altri problemi. Innanzitutto, la sintassi scomoda. Se vogliamo ottenere una stringa, dobbiamo invocare dictGet. In secondo luogo, la mancanza di alcune ottimizzazioni. Il confronto con una stringa costante per i dizionari non è così veloce.
Possono sorgere anche problemi con l'aggiornamento. Supponiamo di aver richiesto una stringa nel dizionario cache e questa non vi è finita. Allora dobbiamo attendere il caricamento dei dati dalla fonte esterna.
Un difetto comune di entrambi i metodi è che memorizziamo tutte le chiavi in un unico posto e le sincronizziamo. Allora perché non memorizzare i dizionari localmente? Niente sincronizzazione, niente problemi. Possiamo memorizzare il dizionario localmente in un frammento su disco. Dunque, abbiamo fatto un Insert, registrato il dizionario. Se lavoriamo con i dati in memoria, possiamo registrare il dizionario o in un blocco di dati, o in un pezzo di colonna, o in qualche cache, per accelerare i calcoli.
Codifica a dizionario delle stringhe
Così siamo arrivati alla creazione di un nuovo tipo di dato in ClickHouse: LowCardinality. Questo è un formato di memorizzazione dei dati: come vengono scritti su disco e come vengono letti, come sono rappresentati in memoria e lo schema del loro trattamento.
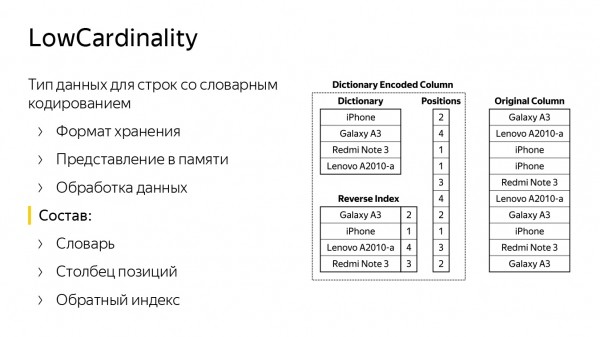
Nella slide ci sono due colonne. A destra le righe sono salvate in modo standard, nel tipo String. È visibile che si tratta di alcuni modelli di telefoni cellulari. A sinistra c'è una colonna identica, solo nel tipo LowCardinality. Essa consiste in un dizionario con molte righe diverse (righe dalla colonna di destra) e un elenco di posizioni (numeri di riga).
Con queste due strutture è possibile ricostruire la colonna originale. C'è anche un indice inverso — una tabella hash che aiuta a trovare la posizione nel dizionario partendo dalla riga. Questa è necessaria per accelerare alcune query. Per esempio, se vogliamo confrontare, cercare una riga nella nostra colonna o unirle tra loro.
LowCardinality è un tipo di dato parametrico. Può essere un numero, o qualcosa che è memorizzato come numero, oppure una stringa, o Nullable di essi.
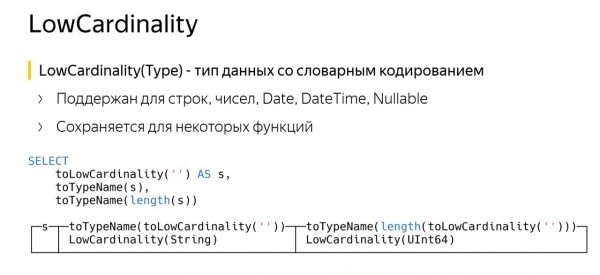
La caratteristica di LowCardinality è che può essere salvata per alcune funzioni. Nella slide è visibile un esempio di query. Nella prima riga ho creato una colonna di tipo LowCardinality da String, chiamandola S. Poi ho chiesto il suo nome — ClickHouse ha detto che è LowCardinality da String. Tutto corretto.
La terza riga è quasi la stessa, solo che abbiamo chiamato la funzione length. In ClickHouse la funzione length restituisce il tipo di dato UInt64. Ma è diventata LowCardinality da UInt64. Qual è il senso?
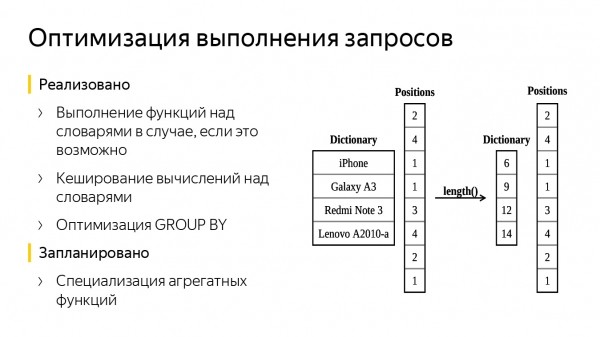
Nel dizionario erano memorizzati i nomi dei telefoni cellulari, abbiamo applicato la funzione length. Ora abbiamo un dizionario analogo, composto solo da numeri — sono le lunghezze delle righe. La colonna con le posizioni non è cambiata. Alla fine, abbiamo elaborato meno dati, risparmiando tempo nella query.
Possono esserci anche altre ottimizzazioni, ad esempio l'aggiunta di una semplice cache. Durante il calcolo del valore della funzione si può memorizzare e crearne uno simile, senza calcolarlo di nuovo.
Può anche essere ottimizzata la GROUP BY, poiché la nostra colonna con il dizionario è già parzialmente aggregata — è possibile calcolare più rapidamente il valore delle funzioni hash e trovare approssimativamente il bucket in cui posizionare la nuova riga. Inoltre, si possono specializzare alcune funzioni aggregate, come uniq, poiché in essa si può inviare solo il dizionario, lasciando intatte le posizioni — in questo modo tutto funzionerà più rapidamente. Le prime due ottimizzazioni le abbiamo già aggiunte in ClickHouse.
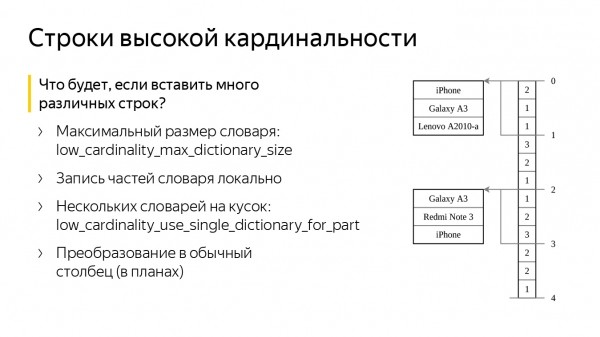
E se creassimo una colonna con il nostro tipo di dati e ci inserissimo molte righe diverse e sbagliate? La nostra memoria non si riempirebbe? No, per questo in ClickHouse ci sono due impostazioni speciali. La prima è low_cardinality_max_dictionary_size. Questo è il massimo dimensione del dizionario che può essere scritto su disco. L'inserimento avviene nel seguente modo: quando inseriamo dati, riceviamo un flusso di righe, da cui formiamo un grande dizionario condiviso. Se il dizionario diventa più grande del valore dell'impostazione, scriviamo l'attuale dizionario su disco, mentre le altre righe vengono allocate da qualche parte "di lato", vicino agli indici. Alla fine, non ri-calcoleremo mai il grande dizionario e non avremo problemi di memoria.
La seconda impostazione si chiama low_cardinality_use_single_dictionary_for_part. Immaginate che nella precedente configurazione, quando inserivamo dati, il nostro dizionario si sia riempito e lo abbiamo scritto su disco. C'è da chiedersi, perché non formare ora un altro dizionario esattamente uguale?
Quando si riempie, lo scriviamo di nuovo su disco e iniziamo a formare il terzo. Questa impostazione disabilita proprio questa possibilità per impostazione predefinita.
In realtà, avere molti dizionari può essere utile se vogliamo inserire un certo insieme di righe, ma accidentalmente abbiamo inserito "spazzatura". Diciamo, all'inizio abbiamo inserito righe sbagliate e poi abbiamo inserito quelle corrette. Allora il dizionario si dividerà in molti piccoli dizionari. Alcuni di essi conterranno "spazzatura", ma gli ultimi conterranno righe buone. E se leggiamo, ad esempio, solo l'ultima porzione, tutto funzionerà rapidamente.
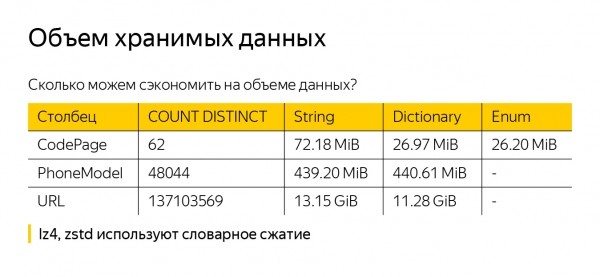
Prima di parlare dei vantaggi di LowCardinality, voglio dire subito che è improbabile che otteniamo una riduzione dei dati su disco (anche se può succedere), poiché ClickHouse comprime i dati. C'è un'opzione predefinita: LZ4. È anche possibile eseguire la compressione tramite ZSTD. Ma entrambi gli algoritmi implementano già la compressione dizionario, quindi il nostro dizionario esterno ClickHouse non sarà di grande aiuto.
Per non essere solo teorico, ho preso alcuni dati dalla metrica — String, LowCardinality(String) ed Enum — e li ho salvati in diversi tipi di dati. Sono risultati tre colonne, ognuna contenente un miliardo di righe. Nella prima colonna, CodePage, ci sono solo 62 valori. E si vede che nel LowCardinality(String) sono stati compressi meglio. String è un po' peggio, ma ciò è probabilmente dovuto al fatto che le stringhe sono corte, ne conserviamo le lunghezze, e occupano molto spazio, compressione scadente.
Se prendiamo PhoneModel, ce ne sono 48 mila — già di più, e le differenze tra String e LowCardinality(String) sono quasi inesistenti. Anche per l'URL abbiamo risparmiato solo 2 GB — penso che non valga la pena fare affidamento su questo.
Valutazione della velocità di esecuzione
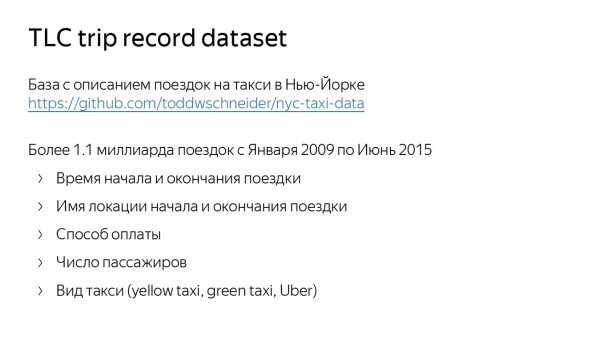
Ora valutiamo la velocità di esecuzione. Per farlo, ho utilizzato un dataset con la descrizione delle corse dei taxi a New York. Esso si trova su GitHub. Contiene poco più di un miliardo di corse. Sono riportati la posizione, l'ora di inizio e fine corsa, il metodo di pagamento, il numero di passeggeri e persino il tipo di taxi — verde, giallo e Uber.
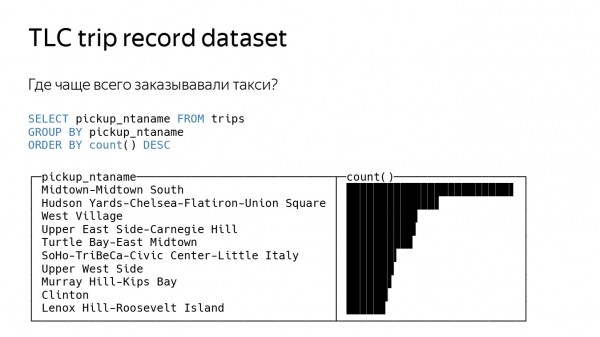
Ho fatto la prima richiesta piuttosto semplice — ho chiesto dove si ordinano più spesso i taxi. Per fare ciò, è necessario prendere la posizione da cui sono stati ordinati, fare un GROUP BY su di essa e contare la funzione count. Ecco cosa restituisce ClickHouse.
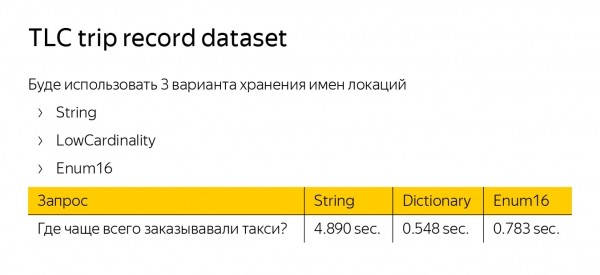
Per misurare la velocità di elaborazione della richiesta, ho creato tre tabelle con gli stessi dati, ma ho utilizzato tre diversi tipi di dati per la nostra posizione di partenza — String, LowCardinality ed Enum. LowCardinality ed Enum si sono rivelati cinque volte più veloci di String. Enum è più veloce perché lavora con numeri. LowCardinality — perché è stata implementata un'ottimizzazione per il GROUP BY.
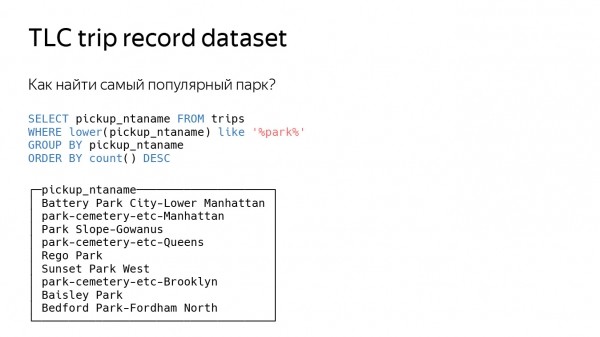
Complichiamo ulteriormente la richiesta — chiediamo dove si trova il parco più popolare a New York. Ancora una volta, misureremo ciò in base a dove si ordinano più spesso i taxi, ma filtreremo solo quelle posizioni che contengono la parola "parco". Aggiungeremo anche la funzione like.
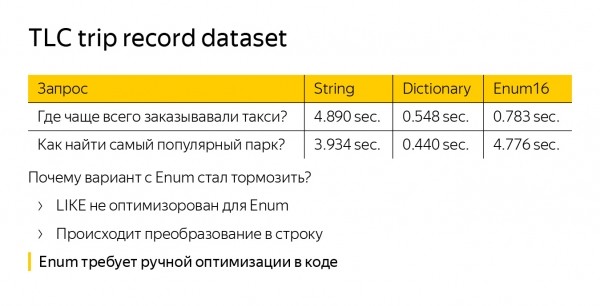
Controlliamo il tempo — vediamo che Enum ha improvvisamente iniziato a rallentare. Inoltre, funziona addirittura più lentamente del tipo di dato standard String. Questo accade perché la funzione like non è affatto ottimizzata per Enum. Dobbiamo convertire le nostre stringhe da Enum in stringhe normali — facciamo più lavoro. LowCardinality(String) non è ottimizzato per impostazione predefinita, ma qui like funziona su un dizionario, quindi la richiesta si accelera rispetto a String.
Quando si lavora con Enum, c'è un problema più globale. Se vogliamo ottimizzarlo, dobbiamo farlo in ogni punto del codice. Supponiamo di aver scritto una nuova funzione: dobbiamo necessariamente pensare a un'ottimizzazione per Enum. In LowCardinality tutto è ottimizzato di default.
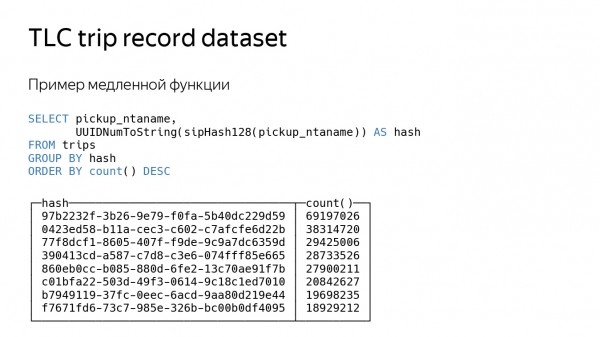
Diamo un'occhiata all'ultima query, più artificiale. Calcoleremo semplicemente la funzione hash della nostra posizione. La funzione hash è una richiesta piuttosto lenta, richiede tempo, quindi tutto rallenterà di circa tre volte.
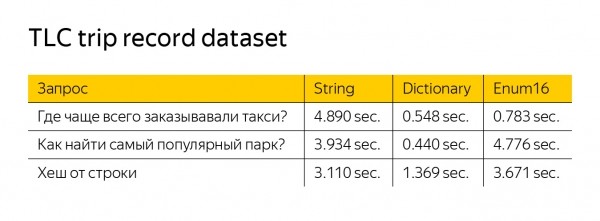
LowCardinality funziona ancora più velocemente, anche se qui non c'è filtraggio. Questo accade perché le nostre funzioni operano solo sul dizionario. La funzione di calcolo dell'hash ha un argomento: può elaborare meno dati e può anche restituire LowCardinality.
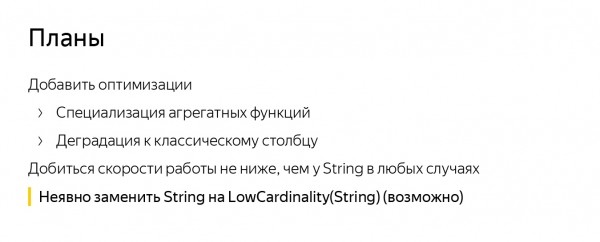
Il nostro piano globale è raggiungere velocità di funzionamento non inferiori a quelle di String in tutti i casi e mantenere l'accelerazione. E, forse un giorno, sostituiremo String con LowCardinality, aggiornerai ClickHouse e tutto funzionerà un po' più velocemente.
Fonte: habr.com
