

Continuando a esaminare le tecnologie per accelerare le operazioni di input/output applicate agli storage, iniziate in , non si può fare a meno di soffermarsi su un'opzione piuttosto popolare, come il tiering (Auto Tiering). Sebbene l'ideologia del funzionamento di questa funzione sia piuttosto simile tra i diversi produttori di sistemi di storage, esamineremo le peculiarità dell'implementazione del tiering utilizzando come esempio .
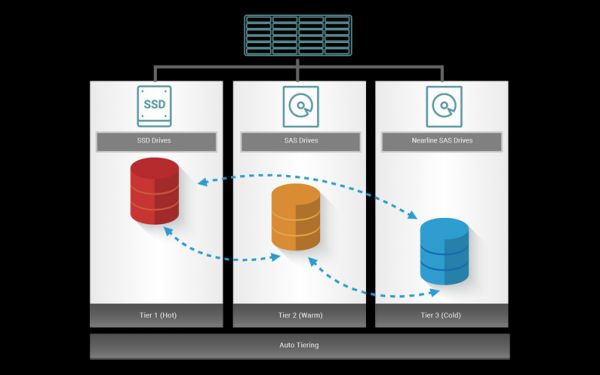
Nonostante la varietà di dati memorizzati nello storage, tali dati possono essere suddivisi in diverse categorie, in base alla loro frequenza di utilizzo. Per i dati più richiesti ("caldi"), è fondamentale organizzare un accesso il più veloce possibile, mentre l'elaborazione dei dati meno richiesti ("freddi") può essere eseguita con una priorità inferiore.
Per organizzare un tale schema si utilizza proprio la funzionalità del tiering. In questo caso, l'array di dati non è composto da dischi omogenei, ma da diversi gruppi di dischi che formano livelli di stoccaggio differenti (tier). Attraverso un algoritmo speciale, i dati vengono spostati automaticamente tra i livelli al fine di garantire la massima performance complessiva.
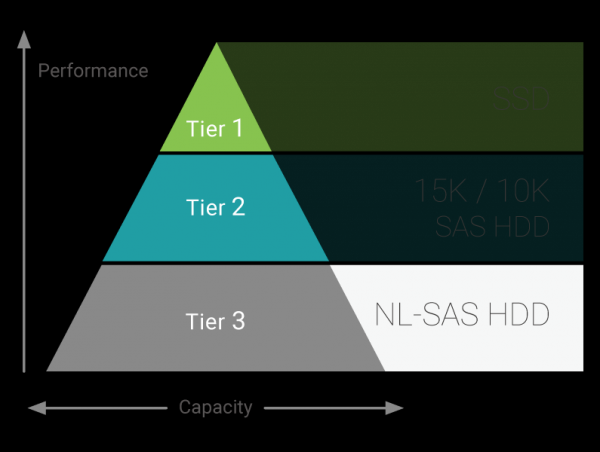
Sistemi di archiviazione Supportano fino a tre livelli di stoccaggio:
- Tier 1: SSD, massima prestazione
- Tier 2: HDD SAS 10K/15K, alta prestazione
- Tier 3: HDD NL-SAS 7.2K, massima capacità
Il pool di Auto Tiering può contenere sia tutti e tre i livelli che solo due in qualsiasi combinazione. All'interno di ogni Tier, i dischi vengono raggruppati in consuete configurazioni RAID. Per massima flessibilità, il livello RAID in ogni Tier può essere diverso. Ad esempio, nulla impedisce di organizzare una struttura del tipo 4x SSD RAID10 + 6x HDD 10K RAID5 + 12 HDD 7.2K RAID6.
Dopo la creazione dei volumi (dischi virtuali) su il pool inizia a raccogliere statistiche di tutte le operazioni di input/output in background. A tal fine, lo spazio viene "suddiviso" in blocchi di dimensioni 1GB (i cosiddetti sub LUN). Ad ogni accesso a un blocco di questo tipo, gli viene assegnato un coefficiente di 1. Successivamente, nel tempo, tale coefficiente diminuisce. Dopo 24 ore, in assenza di richieste di input/output a quel blocco, sarà già pari a 0.5 e continuerà a scendere ogni successiva ora.
In un momento specifico (di default ogni giorno a mezzanotte) avviene il ranking dei risultati raccolti in base all'attività del sub LUN in base ai loro coefficienti. Da questo si decide quali blocchi spostare e in quale direzione. Successivamente avviene il rilocamento dei dati tra i livelli.
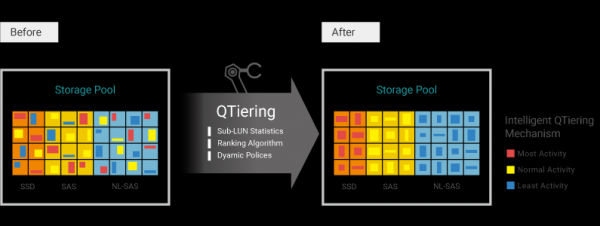
Nel sistema di archiviazione Qsan, la gestione del processo di tiering è ben implementata grazie a numerosi parametri, consentendo di configurare in modo molto flessibile la performance finale del pool.
Per determinare la posizione iniziale dei dati e la direzione prioritaria del loro spostamento si utilizzano politiche, che sono impostate separatamente per ogni volume:
- Auto Tiering – politica predefinita, la posizione iniziale e la direzione degli spostamenti sono determinate automaticamente, ovvero i dati "caldi" tendono a salire al livello più alto, mentre i dati "freddi" scendono verso il basso. La posizione iniziale viene scelta in base allo spazio disponibile su ciascun livello. Ma è importante capire che il sistema cerca principalmente di utilizzare al massimo le unità di archiviazione più veloci. Pertanto, in presenza di spazio libero, i dati verranno collocati ai livelli superiori. Questa politica è adatta per la maggior parte degli scenari, quando non è possibile prevedere in anticipo la domanda di dati.
- Iniziare da un livello alto e poi Auto Tiering – l'unica differenza rispetto a prima è la posizione iniziale dei dati (al livello più veloce)
- Livello massimo – i dati tendono sempre a occupare il livello più veloce. Se durante l'attività vengono spostati verso il basso, alla prima opportunità vengono riportati indietro. Questa politica è adatta per i dati a cui si richiede accesso il più veloce possibile.
- Livello minimo – i dati tendono sempre a occupare il livello più basso. Questa politica è ideale per i dati usati raramente (ad esempio, archivi).
- Senza spostamento – il sistema determina automaticamente la posizione iniziale dei dati e non li sposta. Tuttavia, le statistiche continuano a essere raccolte nel caso in cui in seguito sia necessario il loro rilocamento.
Va notato che, nonostante le politiche siano definite al momento della creazione di ciascun volume, possono essere modificate in qualsiasi momento durante il ciclo di vita del sistema.
Oltre alle politiche per il meccanismo di tiering, viene anche impostata la frequenza e il ritmo del trasferimento dei dati tra i livelli. È possibile specificare un tempo specifico per il trasferimento: quotidianamente o in determinati giorni della settimana, oltre a ridurre l'intervallo di raccolta delle statistiche a poche ore (frequenza minima – 2 ore). Se è necessario limitare il tempo di esecuzione delle operazioni di trasferimento dati, si possono impostare delle fasce temporali (finestra per il trasferimento). Inoltre, viene indicata la velocità di rilocazione: 3 modalità: veloce, medio, lento.
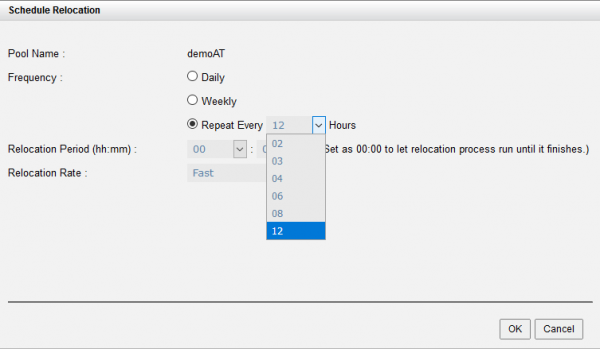
In caso di necessità di rilocazione immediata dei dati, è possibile eseguirla manualmente in qualsiasi momento su comando dell'amministratore.
È chiaro che più frequentemente e velocemente avverrà il trasferimento dei dati tra i livelli, più flessibile sarà lo storage per adattarsi alle condizioni operative attuali. Tuttavia, è anche importante ricordare che il trasferimento rappresenta un carico aggiuntivo (soprattutto per i dischi), quindi non è opportuno "spingere" i dati senza una reale necessità. È meglio pianificare il trasferimento nei momenti di minimo carico. Se tuttavia lo storage richiede costantemente prestazioni elevate in modalità 24/7, è consigliabile ridurre il ritmo di rilocazione al minimo.
L'abbondanza di impostazioni di tiering certamente farà felici gli utenti avanzati. Tuttavia, anche per coloro che si confrontano per la prima volta con questa tecnologia, non c'è nulla di cui preoccuparsi. Si può tranquillamente fare affidamento sulle impostazioni predefinite (politica di Auto Tiering, trasferimento alla massima velocità una volta al giorno di notte) e, man mano che si accumulano statistiche, regolare i vari parametri per raggiungere il risultato desiderato.
Confrontando il tiering con un'altra tecnologia popolare per aumentare le prestazioni, come , è importante ricordare i diversi principi di funzionamento dei loro algoritmi.
il caching SSD
Auto Tiering
La velocità di insorgenza dell'effetto
Quasi immediatamente. Ma l'effetto significativo si manifesta solo dopo il "riscaldamento" della cache (minuti-ore)
Dopo la raccolta delle statistiche (da 2 ore, idealmente – un giorno) più il tempo per il trasferimento dei dati
La durata dell'effetto
Finché i dati non vengono sostituiti da una nuova porzione (minuti-ore)
Finché la domanda sui dati è attuale (un giorno e oltre)
Indicazioni per l'uso
Aumento immediato delle prestazioni a breve termine (database, ambienti di virtualizzazione)
Aumento delle prestazioni per un lungo periodo (server file, web, di posta)
Inoltre, una delle caratteristiche del tiering è la possibilità di utilizzarlo non solo per scenari del tipo "SSD + HDD", ma anche "HDD veloci + HDD lenti" o addirittura tutti e tre i livelli, il che risulta impossibile in caso di utilizzo della memorizzazione nella cache SSD.
Test
Per verificare il funzionamento degli algoritmi di tiering, abbiamo eseguito un semplice test. È stato creato un pool di due livelli SSD (RAID 1) + HDD 7.2K (RAID1), su cui è stato posizionato un volume con la politica "livello minimo". Cioè, i dati devono sempre trovarsi sui dischi lenti.
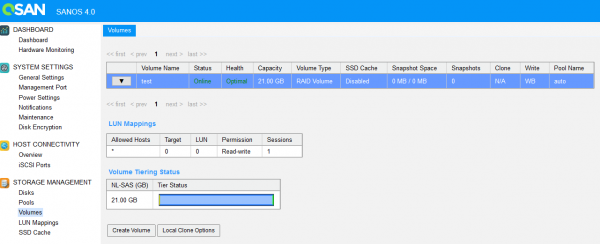
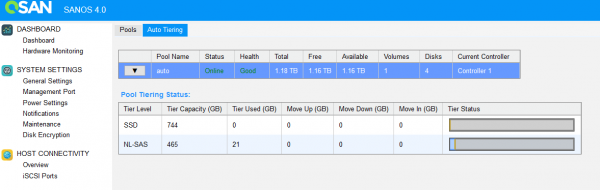
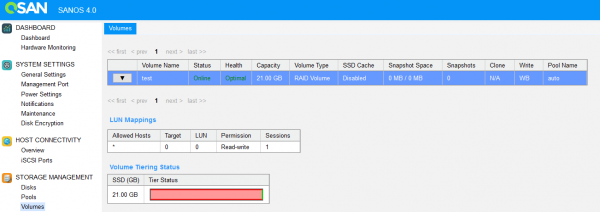
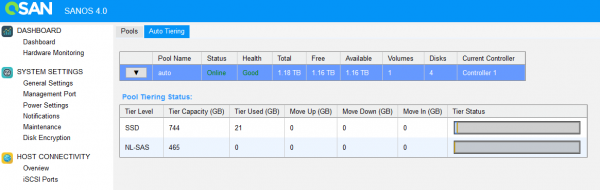
L'interfaccia di gestione mostra chiaramente la disposizione dei dati tra i livelli
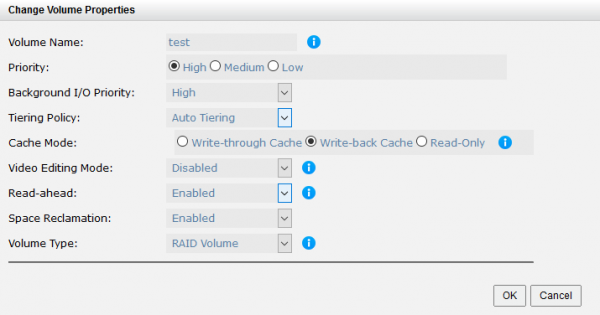
Dopo aver riempito il volume con i dati, abbiamo cambiato la politica di posizionamento in Auto Tiering e abbiamo avviato un test IOmeter.
Dopo alcune ore di test, quando il sistema è riuscito a raccogliere statistiche, è iniziato il processo di rilocalizzazione.
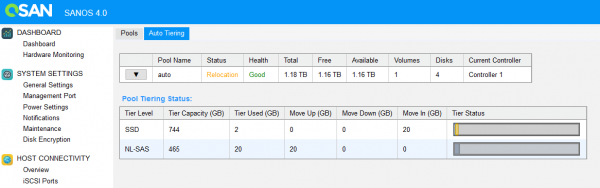
Al termine del trasferimento dei dati, il nostro volume di test è completamente "migrato" al livello superiore (SSD).
Verdetto
L'Auto Tiering è una tecnologia straordinaria che consente di aumentare le prestazioni del sistema di archiviazione con un minimo di costi materiali e di tempo, grazie a un utilizzo più intensivo degli storage veloci. Riguardo a l'unico investimento è la licenza, che viene acquisita una volta per tutte senza limitazioni sul numero di dischi/armadi. Questa funzionalità è dotata di impostazioni così ricche da poter soddisfare praticamente qualsiasi esigenza aziendale. E la visualizzazione dei processi nell'interfaccia consentirà una gestione efficace del dispositivo.
Fonte: habr.com
