

Il tema del monorepo è stato già discusso molte volte e, di solito, solleva vivaci dibattiti. Creando uno strumento Open Source, destinato a migliorare i processi di compilazione del codice delle applicazioni da Git in immagini Docker (e la loro successiva consegna in Kubernetes), riflettiamo poco sulla questione di quale scelta sia la migliore. Per noi, è fondamentale garantire tutto il necessario per i sostenitori di opinioni diverse (se ciò non contraddice il buon senso, ovviamente).
Il recente supporto per mono-repo in werf è un buon esempio in tal senso. Ma prima, cerchiamo di capire come questo supporto sia effettivamente collegato all'uso di werf e quale sia il ruolo di Docker Registry...
Problematica
Immaginiamo una situazione del genere. In un'azienda ci sono numerosi team di sviluppatori che lavorano su progetti indipendenti. La maggior parte delle applicazioni funziona in Kubernetes e, di conseguenza, vengono containerizzate. Per memorizzare i contenitori e le immagini, è necessario un registro (registry). L'azienda utilizza Docker Hub con un unico account COMPANY. Analogamente alla maggior parte dei sistemi di archiviazione del codice sorgente, Docker Hub non consente di creare una gerarchia di repository annidata, come COMPANY/PROJECT/IMAGE. In tal caso... come possiamo memorizzare applicazioni non monolitiche nel registro senza creare un account separato per ogni progetto?
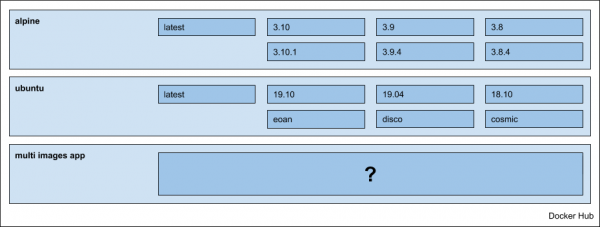
È possibile che la situazione descritta sia nota a qualcuno, ma analizziamo la questione dell'organizzazione della memorizzazione delle applicazioni in generale, ossia senza fare riferimento all'esempio sopra descritto e a Docker Hub.
Vie di soluzione
Se l'applicazione è monolitica, viene fornita in un'unica immagine, quindi non ci sono problemi e semplicemente memorizziamo le immagini nel registro dei contenitori del progetto.
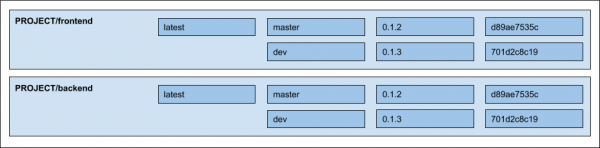
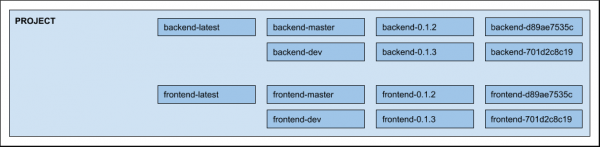
Quando l'applicazione è rappresentata da più componenti, microservizi, è necessario scegliere un approccio specifico. Per esempio, prendiamo un'applicazione web tipica, composta da due immagini: frontend e backend — le possibili opzioni sono:
- Memorizzare le immagini in repository annidati separati:

- Memorizzare tutto in un unico repository, considerando il nome dell'immagine nel tag, ad esempio, nel modo seguente:

NB: In realtà, c'è anche l'opzione di salvare in vari repository, PROJECT-frontend e PROJECT-backend, ma non la esamineremo a causa della difficoltà nel supportarla, nel gestire e distribuire i diritti tra gli utenti.
Supporto in werf
Inizialmente werf si era limitato ai repository annidati, poiché la maggior parte dei registri supporta questa possibilità. A partire dalla versione , è stata aggiunta la gestione dei registri che non supportano l'annidamento, incluso Docker Hub. Da questo momento, l'utente ha la possibilità di scegliere come memorizzare le immagini dell'applicazione.
L'implementazione è disponibile attraverso l'opzione --images-repo-mode=multirepo|monorepo (predefinito multirepo, ovvero memorizzazione in repository annidati). Essa definisce i modelli secondo cui le immagini sono memorizzate nel registro. È sufficiente selezionare la modalità desiderata durante l'uso dei comandi principali, e tutto il resto rimarrà invariato.
Poiché la maggior parte delle opzioni di werf possono essere impostate tramite variabili d'ambiente, nelle piattaforme CI/CD, la modalità di memorizzazione può generalmente essere impostata globalmente per l'intero progetto. Ad esempio, nel caso di GitLab , è sufficiente aggiungere una variabile d'ambiente nelle impostazioni del progetto: Impostazioni -> CI / CD -> Variabili: WERF_IMAGES_REPO_MODE: multirepo|monorepo.
Parlando della pubblicazione delle immagini e del deployment delle applicazioni (su questi processi è possibile leggere in dettaglio negli articoli pertinenti della documentazione: e ), la modalità definisce esclusivamente il modello secondo cui si può lavorare con l'immagine.
Il diavolo è nei dettagli
La differenza e la principale difficoltà nell'aggiungere un nuovo metodo di memorizzazione sono nel processo di pulizia del registry (le possibilità di pulizia, supportate in werf, sono descritte in ).
) Quando si pulisce, werf considera le immagini utilizzate nei cluster Kubernetes, così come le politiche impostate dall'utente. Alla base delle politiche c'è la suddivisione dei tag in strategie. Le strategie attualmente supportate sono:
- 3 strategie legate ai primitivi Git, come tag, branch e commit;
- 1 strategia per tag utente arbitrari.
Le informazioni sulla strategia del tag sono conservate quando si pubblica l'immagine nelle etichette dell'immagine finale. Il valore stesso — il cosiddetto metatags — è necessario per applicare parte delle politiche. Ad esempio, quando si elimina un branch o un tag da un repository Git, è logico rimuovere anche le immagini non utilizzate dal registro, cosa coperta parte delle nostre politiche.
Quando si salva in un unico repository (monorepo), nel tag dell'immagine, oltre al metatag, è possibile memorizzare anche il nome dell'immagine: PROGETTO:frontend-META-TAG. Per separare, non abbiamo introdotto un delimitatore specifico, ma abbiamo semplicemente aggiunto il valore necessario all'etichetta dell'immagine finale al momento della pubblicazione.
NB: Se sei interessato a vedere tutto ciò che è descritto nel codice sorgente di werf, il punto di partenza potrebbe essere .
In questo articolo non approfondiremo ulteriormente la problematica e la giustificazione del nostro approccio: sulle strategie di tagging, sulla conservazione dei dati nelle etichette e sul processo di pubblicazione in generale — tutto questo è stato ampiamente trattato nel recente rapporto di Dmitrij Stoljarev: «».
In sintesi
L'assenza di supporto per registri senza nidificazione non è stata un fattore bloccante per noi o per i comuni utenti di werf — infatti è sempre possibile avviare un registro separato di immagini (o passare a un Container Registry in Google Cloud)… Tuttavia, rimuovere tale restrizione appariva logico affinché lo strumento fosse più utile a una community DevOps più ampia. Implementandolo, ci siamo scontrati con la principale difficoltà nel ripensare il meccanismo di pulizia del registro dei container. Ora che tutto è pronto, è piacevole sapere che per qualcuno è diventato più facile, e per noi (come sviluppatori principali del progetto) non prevediamo difficoltà significative nel mantenere questa funzionalità in futuro.
Resta con noi e presto ti parleremo di altre novità in !
P.S.
Leggi anche nel nostro blog:
- «»;
- «».
Fonte: habr.com
