

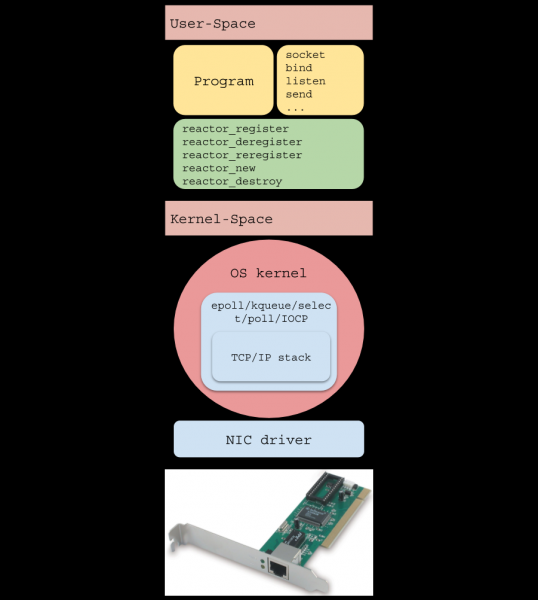
Introduzione
(monotask ) è un pattern per la scrittura di software ad alto carico, utilizzato in molte soluzioni popolari:
- …
In questo articolo esploreremo il funzionamento interno del reattore I/O e il principio del suo operare, scrivendo un'implementazione in meno di 200 righe di codice e facendo sì che un semplice server HTTP gestisca oltre 40 milioni di richieste/min.
Introduzione
- L'articolo è scritto con l'intento di aiutare a comprendere il funzionamento del reattore I/O, e quindi a comprendere i rischi del suo utilizzo.
- Per comprendere l'articolo è necessario avere conoscenze di base e una piccola esperienza nello sviluppo di applicazioni di rete.
- Tutto il codice è scritto in linguaggio C secondo ilattento: PDF lungo) per Linux ed è disponibile su .
A cosa serve?
Con la crescente popolarità di Internet, i server web hanno dovuto gestire un gran numero di connessioni simultaneamente, motivo per cui sono stati testati due approcci: I/O bloccante con un gran numero di thread OS e I/O non bloccante combinato con un sistema di notifica degli eventi, chiamato anche 'selettore di sistema' (///etc).
Il primo approccio prevedeva la creazione di un nuovo thread OS per ogni connessione in entrata. Il suo svantaggio è una scarsa scalabilità: il sistema operativo dovrà effettuare numerosi e . Queste sono operazioni costose e possono portare a una carenza di memoria RAM disponibile in caso di un numero elevato di connessioni.
Una versione modificata prevede (thread pool), evitando che il sistema termini in modo anomalo l'esecuzione, ma introduce un nuovo problema: se in quel momento il pool di thread blocca operazioni di lettura prolungate, altri socket, che sono già in grado di ricevere dati, non potranno farlo.
Il secondo approccio utilizza (selettore di sistema), fornito dal sistema operativo. In questo articolo si esamina il tipo di selettore di sistema più comune, basato su notifiche (eventi, avvisi) di prontezza per le operazioni di I/O, piuttosto che su . Un esempio semplificato del suo utilizzo può essere rappresentato dal seguente diagramma di flusso:
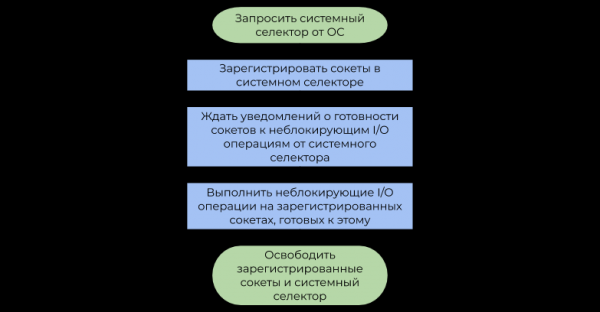
La differenza tra questi approcci è la seguente:
- Le operazioni I/O bloccanti sospendono il thread utente fino a quando, finché il sistema operativo non i pacchetti in un flusso di byte (, ricezione dati) o non viene liberato spazio sufficiente nei buffer interni di scrittura per un successivo invio attraverso (invio dati).
- Il selettore di sistema dopo un po' informa il programma che il sistema operativo ha già ha deframmentato i pacchetti IP (TCP, ricezione dati) o che è disponibile spazio sufficiente nei buffer interni di scrittura ha già (invio dati).
In sintesi, la riserva del flusso del sistema operativo per ogni I/O è uno spreco di potenza di calcolo, poiché in realtà i flussi non sono impegnati in lavoro utile (da qui deriva il termine ). Il selettore di sistema risolve questo problema, consentendo al programma utente di utilizzare le risorse della CPU in modo significativamente più efficiente.
Il modello di I/O reattore
Il reattore I/O funge da intermediario tra il selettore di sistema e il codice utente. Il principio del suo funzionamento è descritto dal seguente diagramma di flusso:
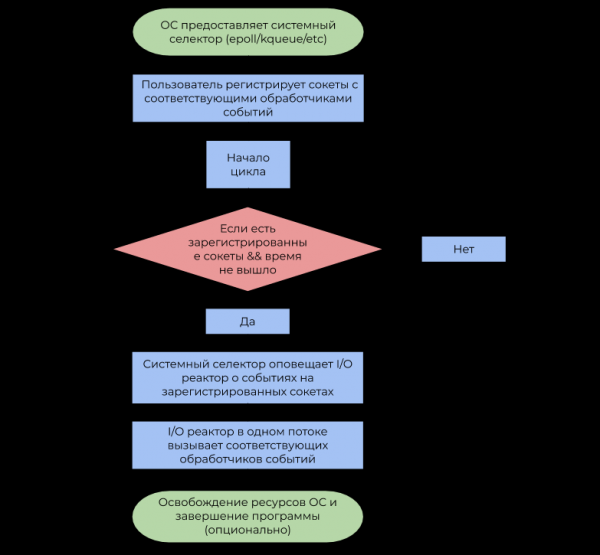
- Ricordo che un evento è una notifica che un determinato socket è in grado di eseguire un'operazione I/O non bloccante.
- Il gestore degli eventi è una funzione chiamata dal reattore I/O al ricevimento di un evento, che poi esegue un'operazione I/O non bloccante.
È importante notare che il reattore I/O è per definizione mono-thread, ma nulla impedisce di utilizzare il concetto in un ambiente multi-thread in relazione a 1 thread: 1 reattore, sfruttando così tutti i nuclei della CPU.
Implementazione
Metteremo l'interfaccia pubblica nel file , mentre l'implementazione sarà in . reactor.h sarà composta dai seguenti annunci:
Mostra gli annunci in reactor.h
typedef struct reactor Reactor;


/*
 * Puntatore a una funzione che verrà chiamata dal reattore I/O all'arrivo
 * di un evento dal selettore di sistema.
 */
typedef void (*Callback)(void *arg, int fd, uint32_t events);

/*
 * Restituisce `NULL` in caso di errore, un puntatore non `NULL` a `Reactor`
 * altrimenti.
 */
Reactor *reactor_new(void);

/*
 * Libera il selettore di sistema, tutti i socket registrati in questo momento
 * e il reattore I/O stesso.
 *
 * Le seguenti funzioni restituiscono -1 in caso di errore, 0 in caso di successo.
 */
int reactor_destroy(Reactor *reactor);

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg);
int reactor_deregister(const Reactor *reactor, int fd);
int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg);

/*
 * Avvia il ciclo di eventi con il timeout `timeout`.
 *
 * Questa funzione restituirà il controllo al codice chiamante se il tempo allocato è scaduto
 * o/o in assenza di socket registrati.
 */
int reactor_run(const Reactor *reactor, time_t timeout);
La struttura del reattore I/O consiste in selettore e , che associa ogni socket a CallbackData (una struttura del gestore di eventi e dell'argomento utente per esso).
Mostra Reactor e CallbackData
struct reactor {
    int epoll_fd;
    GHashTable *table; // (int, CallbackData)
};

typedef struct {
    Callback callback;
    void *arg;
} CallbackData;
Nota che abbiamo utilizzato la possibilità di gestire un per riferimento. In reactor.h dichiareremo la struttura reactor, e in reactor.c definendola, impedendo così all'utente di modificare esplicitamente i suoi campi. Questo è uno dei modelli , che si integra perfettamente nella semantica del C.
Funzioni reactor_register, reactor_deregister e reactor_reregister aggiornano l'elenco dei socket di interesse e i rispettivi gestori di eventi nel selettore di sistema e nella tabella hash.
Mostra le funzioni di registrazione
#define REACTOR_CTL(reactor, op, fd, interest)
    if (epoll_ctl(reactor->epoll_fd, op, fd,
                  &(struct epoll_event){.events = interest,
                                        .data = {.fd = fd}}) == -1) {
        perror("epoll_ctl");
        return -1;
    }

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_ADD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}

int reactor_deregister(const Reactor *reactor, int fd) {
    REACTOR_CTL(reactor, EPOLL_CTL_DEL, fd, 0)
    g_hash_table_remove(reactor->table, &fd);
    return 0;
}

int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_MOD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}
Dopo che il reattore I/O ha intercettato un evento con il descrittore fd, chiama il rispettivo gestore di eventi, al quale passa fd, degli eventi generati e un puntatore utente su void.
Mostra la funzione reactor_run()
int reactor_run(const Reactor *reactor, time_t timeout) {
    int result;
    struct epoll_event *events;
    if ((events = calloc(MAX_EVENTS, sizeof(*events))) == NULL)
        abort();

    time_t start = time(NULL);

    while (true) {
        time_t passed = time(NULL) - start;
        int nfds =
            epoll_wait(reactor->epoll_fd, events, MAX_EVENTS, timeout - passed);

        switch (nfds) {
        // Errore
        case -1:
            perror("epoll_wait");
            result = -1;
            goto cleanup;
        // Tempo scaduto
        case 0:
            result = 0;
            goto cleanup;
        // Operazione riuscita
        default:
            // Chiamare i gestori degli eventi
            for (int i = 0; i table, &fd);
                callback->callback(callback->arg, fd, events[i].events);
            }
        }
    }

cleanup:
    free(events);
    return result;
}
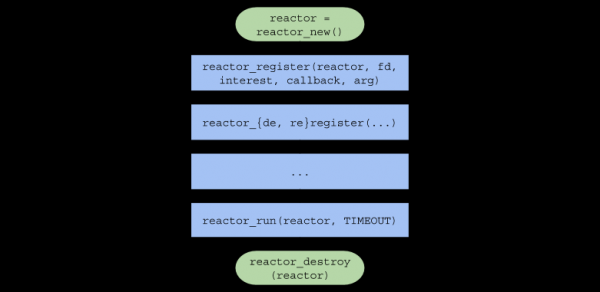
In sintesi, la catena di chiamate di funzioni nel codice dell'utente avrà il seguente aspetto:
Server a thread singolo
Per testare l'I/O reactor sotto carico elevato, scriveremo un semplice server web HTTP, che risponde con un'immagine a qualsiasi richiesta.
Breve introduzione al protocollo HTTP
è un protocollo , principalmente utilizzato per l'interazione tra server e browser.
HTTP può essere facilmente utilizzato sopra del protocollo , inviando e ricevendo messaggi nel formato definito da .
Formato della richiesta
CRLF
CRLF
CRLF
CRLF CRLFCRLFè una sequenza di due caratteri:ren, che separa la prima riga della richiesta, le intestazioni e i dati.<КОМАНДА>è uno deiCONNECT,DELETE,e username/password: admin/admin.,HEAD,OPTIONS,PATCH,POST,richiesta PUT:,TRACE. Il browser invierà al nostro server un comandoe username/password: admin/admin., che significa “Inviami il contenuto del file”.<URI>— . Ad esempio, se URI =/index.html, il client richiede la home page del sito.<ВЕРСИЯ HTTP>è la versione del protocollo HTTP nel formatoHTTP/X.Y. La versione più comunemente usata al giorno d'oggi èHTTP/1.1.:, inviata al server per un'ulteriore analisi.sono i dati necessari al server per eseguire l'operazione. Spesso consiste semplicemente in o in qualsiasi altro formato.
Formato della risposta
CRLF
CRLF
CRLF
CRLF CRLF
<КОД СТАТУСА>— questo numero rappresenta il risultato dell'operazione. Il nostro server restituirà sempre lo stato 200 (operazione riuscita).<ОПИСАНИЕ СТАТУСА>— rappresentazione in forma di stringa del codice di stato. Per il codice di stato 200 — questo èOK.Content-Length(dimensione del file) eContent-Type: text/html(tipo di dati restituiti).— dati richiesti dall'utente. Nel nostro caso, questo è il percorso all'immagine in .
all'interno di ogni container per impostazione predefinita apparirà così: (server monothread) include il file , che contiene i seguenti prototipi di funzioni:
Mostra i prototipi di funzioni in common.h
/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять новое соединение.
 */
static void on_accept(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов отправить HTTP ответ.
 */
static void on_send(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять часть HTTP запроса.
 */
static void on_recv(void *arg, int fd, uint32_t events);

/*
 * Переводит входящее соединение в неблокирующий режим.
 */
static void set_nonblocking(int fd);

/*
 * Печатает переданные аргументы в stderr и выходит из процесса с
 * кодом `EXIT_FAILURE`.
 */
static noreturn void fail(const char *format, ...);

/*
 * Возвращает файловый дескриптор сокета, способного принимать новые
 * TCP соединения.
 */
static int new_server(bool reuse_port);
È inoltre descritto il macro funzionale SAFE_CALL() ed è definita la funzione fail(). Il macro confronta il valore dell'espressione con un errore e, se la condizione è soddisfatta, chiama la funzione fail():
#define SAFE_CALL(call, error)
    do {
        if ((call) == error) {
            fail("%s", #call);
        }
    } while (false)
La funzione fail() stampa gli argomenti passati nel terminale (come ) e termina il programma con il codice EXIT_FAILURE:
static noreturn void fail(const char *format, ...) {
    va_list args;
    va_start(args, format);
    vfprintf(stderr, format, args);
    va_end(args);
    fprintf(stderr, ": %sn", strerror(errno));
    exit(EXIT_FAILURE);
}
La funzione new_server() restituisce un descrittore di file per il socket «server», creato da chiamate di sistema , e e in grado di accettare connessioni in ingresso in modalità non bloccante.
Mostra la funzione new_server()
static int new_server(bool reuse_port) {
    int fd;
    SAFE_CALL((fd = socket(AF_INET, SOCK_STREAM | SOCK_NONBLOCK, IPPROTO_TCP)),
              -1);

    if (reuse_port) {
        SAFE_CALL(
            setsockopt(fd, SOL_SOCKET, SO_REUSEPORT, &(int){1}, sizeof(int)),
            -1);
    }

    struct sockaddr_in addr = {.sin_family = AF_INET,
                               .sin_port = htons(SERVER_PORT),
                               .sin_addr = {.s_addr = inet_addr(SERVER_IPV4)},
                               .sin_zero = {0}};

    SAFE_CALL(bind(fd, (struct sockaddr *)&addr, sizeof(addr)), -1);
    SAFE_CALL(listen(fd, SERVER_BACKLOG), -1);
    return fd;
}- Si noti che il socket è inizialmente creato in modalità non bloccante tramite il flag
SOCK_NONBLOCK, affinché nella funzioneon_accept()(leggere oltre) la chiamata di sistemaaccept()non fermi l'esecuzione del thread. - Se
reuse_port, quindi questa funzione configurerà il socket con l'opzionetrue, quindi questa funzione configurerà il socket con l'opzione tramite , per utilizzare la stessa porta in un ambiente multithread (vedere la sezione «Server Multithread»).
Il gestore eventi on_accept() viene chiamato dopo che il sistema operativo genera l'evento EPOLLIN, che in questo caso significa che una nuova connessione può essere accettata. on_accept() accetta una nuova connessione, la commuta in modalità non bloccante e la registra con il gestore eventi on_recv() nel reattore I/O.
Mostra la funzione on_accept()
static void on_accept(void *arg, int fd, uint32_t events) {
    int incoming_conn;
    SAFE_CALL((incoming_conn = accept(fd, NULL, NULL)), -1);
    set_nonblocking(incoming_conn);
    SAFE_CALL(reactor_register(reactor, incoming_conn, EPOLLIN, on_recv,
                               request_buffer_new()),
              -1);
}
Il gestore eventi on_recv() viene chiamato dopo che il sistema operativo genera l'evento EPOLLIN, il che significa che la connessione registrata on_accept(), è pronta a ricevere dati.
on_recv() legge i dati dalla connessione fino a quando la richiesta HTTP non è completamente ricevuta, quindi registra il gestore on_send() per inviare la risposta HTTP. Se il cliente interrompe la connessione, il socket viene deregistrato e chiuso tramite .
Mostra la funzione on_recv()
static void on_recv(void *arg, int fd, uint32_t events) {
    RequestBuffer *buffer = arg;

    // Riceviamo i dati in ingresso finché recv non restituisce 0 o un errore
    ssize_t nread;
    while ((nread = recv(fd, buffer->data + buffer->size,
                         REQUEST_BUFFER_CAPACITY - buffer->size, 0)) > 0)
        buffer->size += nread;

    // Il cliente ha interrotto la connessione
    if (nread == 0) {
        SAFE_CALL(reactor_deregister(reactor, fd), -1);
        SAFE_CALL(close(fd), -1);
        request_buffer_destroy(buffer);
        return;
    }

    // read ha restituito un errore diverso da un errore che bloccherebbe
    // il thread
    if (errno != EAGAIN && errno != EWOULDBLOCK) {
        request_buffer_destroy(buffer);
        fail("read");
    }

    // È stata ricevuta una richiesta HTTP completa dal cliente. Ora registriamo il gestore
    // eventi per inviare i dati
    if (request_buffer_is_complete(buffer)) {
        request_buffer_clear(buffer);
        SAFE_CALL(reactor_reregister(reactor, fd, EPOLLOUT, on_send, buffer),
                  -1);
    }
}
Il gestore eventi on_send() viene chiamato dopo che il sistema operativo genera l'evento EPOLLOUT, il che significa che la connessione registrata on_recv(), è pronta a inviare dati. Questa funzione invia la risposta HTTP, contenente HTML con un'immagine, al cliente, e poi cambia di nuovo il gestore eventi in on_recv().
Mostra la funzione on_send()
static void on_send(void *arg, int fd, uint32_t events) {
    const char *content = "<img "
 "src="https://habrastorage.org/webt/oh/wl/23/"
                          "ohwl23va3b-dioerobq_mbx4xaw.jpeg">";
    char response[1024];
    sprintf(response,
            "HTTP/1.1 200 OK" CRLF "Content-Length: %zd" CRLF "Content-Type: "
            "text/html" DOUBLE_CRLF "%s",
            strlen(content), content);

    SAFE_CALL(send(fd, response, strlen(response), 0), -1);
    SAFE_CALL(reactor_reregister(reactor, fd, EPOLLIN, on_recv, arg), -1);
}
E infine, nel file http_server.c, nella funzione main() creiamo il reattore I/O tramite reactor_new(), creiamo il socket server e lo registriamo, eseguiamo il reattore tramite reactor_run() per esattamente un minuto, quindi liberiamo le risorse e usciamo dal programma.
Mostra http_server.c
#include "reactor.h"

static Reactor *reactor;

#include "common.h"

int main(void) {
    SAFE_CALL((reactor = reactor_new()), NULL);
    SAFE_CALL(
        reactor_register(reactor, new_server(false), EPOLLIN, on_accept, NULL),
        -1);
    SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
    SAFE_CALL(reactor_destroy(reactor), -1);
}
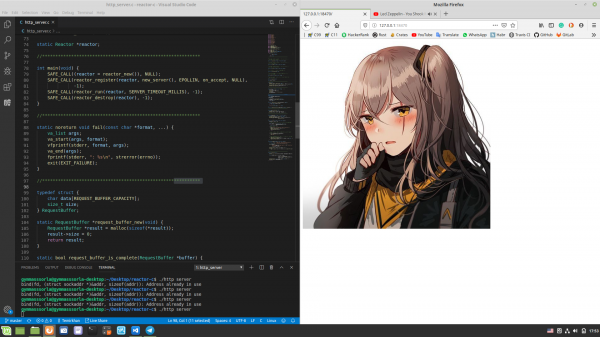
Verifichiamo che tutto funzioni come previsto. Compiliamo (chmod a+x compile.sh && ./compile.sh nella radice del progetto) e avviamo il server personalizzato, apriamo nel browser e osserviamo ciò che ci aspettavamo:
Misura delle prestazioni
Mostra le specifiche della mia macchina
$ screenfetch
 MMMMMMMMMMMMMMMMMMMMMMMMMmds+.        OS: Mint 19.1 tessa
 MMm----::-://////////oymNMd+`     Kernel: x86_64 Linux 4.15.0-20-generic
 MMd      /++                -sNMd:    Uptime: 2h 34m
 MMNso/`  dMM    `.::-. .-::.` .hMN:   Packages: 2217
 ddddMMh  dMM   :hNMNMNhNMNMNh: `NMm   Shell: bash 4.4.20
     NMm  dMM  .NMN/-+MMM+-/NMN` dMM   Resolution: 1920x1080
     NMm  dMM  -MMm  `MMM   dMM. dMM   DE: Cinnamon 4.0.10
     NMm  dMM  -MMm  `MMM   dMM. dMM   WM: Muffin
     NMm  dMM  .mmd  `mmm   yMM. dMM   WM Theme: Mint-Y-Dark (Mint-Y)
     NMm  dMM`  ..`   ...   ydm. dMM   GTK Theme: Mint-Y [GTK2/3]
     hMM- +MMd/-------...-:sdds  dMM   Icon Theme: Mint-Y
     -NMm- :hNMNNNmdddddddddy/`  dMM   Font: Noto Sans 9
      -dMNs-``-::::-------.``    dMM   CPU: Intel Core i7-6700 @ 8x 4GHz [52.0°C]
       `/<dMNmy+/:-------------:/yMMM   GPU: NV136
          ./ydNMMMMMMMMMMMMMMMMMMMMM   RAM: 2544MiB / 7926MiB
             .MMMMMMMMMMMMMMMMMMM
Misuriamo le prestazioni di un server monoutente. Apriamo due terminali: in uno avviamo ./http_server, nell'altro — . Dopo un minuto nel secondo terminale apparirà la seguente statistica:
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Esecuzione test di 1m @ http://127.0.0.1:18470
  8 thread e 100 connessioni
  Statistiche thread   Avg      Stdev     Max   +/- Stdev
    Latency   493.52us   76.70us  17.31ms   89.57%
    Req/Sec    24.37k     1.81k   29.34k    68.13%
  11657769 richieste in 1.00m, 1.60GB letti
Richieste/sec: 193974.70
Trasferimento/sec:     27.19MB
Il nostro server monoutente è riuscito a gestire oltre 11 milioni di richieste al minuto, provenienti da 100 connessioni. Un buon risultato, ma si può migliorare?
Server multi-thread
Come detto sopra, il reattore I/O può essere creato in thread separati, sfruttando così tutti i core della CPU. Applichiamo questo approccio in pratica:
Mostra http_server_multithreaded.c
#include "reactor.h"

static Reactor *reactor;
#pragma omp threadprivate(reactor)

#include "common.h"

int main(void) {
#pragma omp parallel
    {
        SAFE_CALL((reactor = reactor_new()), NULL);
        SAFE_CALL(reactor_register(reactor, new_server(true), EPOLLIN,
                                   on_accept, NULL),
                  -1);
        SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
        SAFE_CALL(reactor_destroy(reactor), -1);
    }
}
Ora ogni thread reattore:
static Reactor *reactor;
#pragma omp threadprivate(reactor)
Si noti che l'argomento della funzione new_server() è true. Questo significa che stiamo assegnando al socket del server l'opzione , per utilizzarlo in un ambiente multi-thread. Puoi leggere di più .
Secondo tentativo
Ora misuriamo le prestazioni del server multi-thread:
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Esecuzione test di 1m @ http://127.0.0.1:18470
  8 thread e 100 connessioni
  Statistiche thread   Avg      Stdev     Max   +/- Stdev
    Latency     1.14ms    2.53ms  40.73ms   89.98%
    Req/Sec    79.98k    18.07k  154.64k    78.65%
  38208400 richieste in 1.00m, 5.23GB letti
Richieste/sec: 635876.41
Trasferimento/sec:     89.14MB
Il numero di richieste elaborate in 1 minuto è aumentato di circa 3.28 volte! Ma mancava poco meno di due milioni per arrivare a un numero tondo, proviamo a sistemarlo.
Iniziamo esaminando le statistiche generate :
$ sudo perf stat -B -e task-clock,context-switches,cpu-migrations,page-faults,cycles,instructions,branches,branch-misses,cache-misses .\/http_server_multithreaded

 Statistiche dei contatori di prestazioni per '.\/http_server_multithreaded':

     242446,314933      task-clock (msec)         #    4,000 CPU utilizzate
         1 813 074      context-switches          #    0,007 M\/sec
             4 689      cpu-migrations            #    0,019 K\/sec
               254      page-faults               #    0,001 K\/sec
   895 324 830 170      cycles                    #    3,693 GHz
   621 378 066 808      instructions              #    0,69  insn per ciclo
   119 926 709 370      branches                  #  494,653 M\/sec
     3 227 095 669      branch-misses             #    2,69% di tutti i branch
           808 664      cache-misses

60,604330670 secondi di tempo trascorso, compilazione con -march=native, , aumento del numero di hit nel , aumento MAX_EVENTS e utilizzo EPOLLET non ha portato a un significativo aumento delle prestazioni. Ma cosa succede se aumentiamo il numero di connessioni simultanee?
Statistiche con 352 connessioni simultanee:
$ wrk -c352 -d1m -t8 http:\/\/127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Esecuzione del test di 1m a http:\/\/127.0.0.1:18470
  8 thread e 352 connessioni
  Statistiche Thread   Avg      Stdev     Max   +\/ - Stdev
    Latenza     2.12ms    3.79ms  68.23ms   87.49%
    Richieste\/Sec    83.78k    12.69k  169.81k    83.59%
  40006142 richieste in 1.00m, 5.48GB letti
Richieste\/sec: 665789.26
Trasferimento\/sec:     93.34MB
Risultato desiderato ottenuto, insieme a un interessante grafico che mostra la dipendenza del numero di richieste elaborate in 1 minuto dal numero di connessioni:
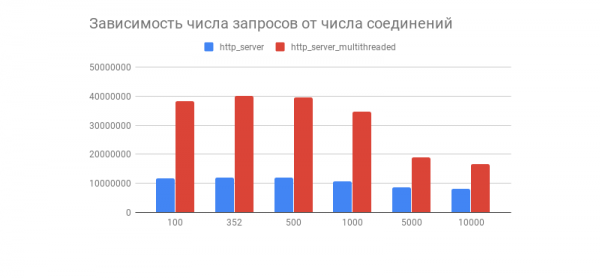
Vediamo che dopo un paio di centinaia di connessioni, il numero di richieste elaborate da entrambi i server diminuisce drasticamente (questo è più evidente nella versione multithreaded). È legato all'implementazione dello stack TCP\/IP di Linux? Sentitevi liberi di condividere nei commenti le vostre ipotesi riguardo a questo comportamento del grafico e alle ottimizzazioni delle versioni multithreaded e single-threaded.
Come Nei commenti, questo test delle prestazioni non mostra il comportamento del reattore I\/O sotto carichi reali, poiché quasi sempre il server interagisce con il DB, genera log, utilizza crittografia con e così via, rendendo il carico eterogeneo (dinamico). I test insieme a componenti di terze parti saranno effettuati in un articolo sul reattore I\/O.
Svantaggi del reattore I\/O
È importante comprendere che il reattore I\/O non è privo di difetti, in particolare:
- Usare il reattore I\/O in un ambiente multithreaded è un po' più complesso, poiché sarà necessario gestire manualmente i thread.
- La pratica dimostra che nella maggior parte dei casi il carico non è omogeneo, il che può portare a situazioni in cui un thread è in attesa mentre un altro è occupato con il lavoro.
- Se un gestore di eventi blocca un thread, anche il selettore di sistema sarà bloccato, il che può portare a bug difficili da rilevare.
Questi problemi si risolvono con , che di solito ha uno scheduler che distribuisce uniformemente il carico nel pool di thread e offre anche un'API più comoda. Ne parlerò più avanti, in un altro articolo.
Conclusione
Con questo il nostro viaggio dalla teoria al profiling è giunto al termine.
Non dobbiamo fermarci qui, ci sono molti altri approcci altrettanto interessanti alla scrittura di software di rete con diversi livelli di comodità e velocità. I collegamenti interessanti, secondo me, sono riportati di seguito.
A presto!
Progetti interessanti
- C
Cosa leggere ancora?
Fonte: habr.com
