

Proseguimento della traduzione di un piccolo libro:
«Understanding Message Brokers»,
autore: Jakub Korab, editore: O’Reilly Media, Inc., data di pubblicazione: Giugno 2017, ISBN: 9781492049296.
Parte precedente tradotta:
CAPITOLO 3
Kafka
Kafka è stato sviluppato in LinkedIn per superare alcune limitazioni dei tradizionali broker di messaggi e per evitare la necessità di configurare più broker di messaggi per diverse interazioni “point-to-point”, come descritto in questo libro nella sezione “Scalabilità verticale e orizzontale” a pagina 28. Gli scenari d'uso in LinkedIn si basavano principalmente sull'assorbimento unidirezionale di enormi volumi di dati, come i clic sulle pagine e i log di accesso, consentendo al contempo a questi dati di essere utilizzati da più sistemi senza influire sulle prestazioni dei produttori o di altri consumatori. In effetti, il motivo per cui Kafka esiste è per ottenere un'architettura di scambio di messaggi come quella descritta nel Universal Data Pipeline.
Tenendo presente questo obiettivo finale, sono naturalmente emerse altre esigenze. Kafka deve:
- Essere estremamente veloce
- Fornire un'ampia larghezza di banda nella gestione dei messaggi
- Supportare i modelli “Publisher-Subscriber” e “Point-to-Point”
- Non rallentare con l'aggiunta di consumatori. Ad esempio, le prestazioni sia della queue sia del topic in ActiveMQ peggiorano con l'aumento del numero di consumatori sul destinatario
- Essere scalabile orizzontalmente; se un broker che memorizza (persists) i messaggi può farlo solo alla massima velocità del disco, ha senso superare un singolo esempio di broker per aumentare le prestazioni
- Separare l'accesso alla memorizzazione e al recupero dei messaggi
Per raggiungere tutto ciò, Kafka ha adottato un'architettura che ha ridefinito i ruoli e le responsabilità dei client e dei broker di messaggistica. Il modello JMS è fortemente orientato verso il broker, dove quest'ultimo è responsabile della distribuzione dei messaggi, mentre i client devono preoccuparsi solo dell'invio e della ricezione dei messaggi. Kafka, d'altra parte, è orientato al client, con quest'ultimo che assume molte funzioni tradizionali del broker, come la distribuzione equa dei messaggi pertinenti tra i consumatori, ricevendo in cambio un broker estremamente veloce e scalabile. Per coloro che hanno lavorato con sistemi di messaggistica tradizionali, lavorare con Kafka richiede cambiamenti fondamentali nella visione.
Questo approccio ingegneristico ha portato alla creazione di un'infrastruttura di messaggistica capace di aumentare enormemente la capacità rispetto a un broker tradizionale. Come vedremo, questo approccio comporta dei compromessi, che significano che Kafka non è adatta per determinati tipi di carichi e software consolidato.
Modello unificato del destinatario
Per soddisfare i requisiti descritti sopra, Kafka ha unito i messaggi di tipo 'pubblicazione-sottoscrizione' e 'point-to-point' all'interno di un'unica forma di destinatario — topic. Questo può confondere le persone che hanno lavorato con sistemi di messaggistica, dove la parola 'topic' si riferisce a un meccanismo di broadcasting, dal quale (dal topic) la lettura non è affidabile (è non durevole). I topic di Kafka devono essere considerati come un tipo ibrido di destinatario, in conformità con la definizione fornita nell'introduzione di questo libro.
Nella parte rimanente di questo capitolo, se non indicato esplicitamente altrimenti, il termine 'topic' si riferirà ai topic di Kafka.
Per comprendere appieno come si comportano i topic e quali garanzie offrono, dobbiamo prima esaminare come sono implementati in Kafka.
Ogni topic in Kafka ha il proprio registro.
I produttori che inviano messaggi a Kafka registrano nel registro, mentre i consumatori leggono dal registro utilizzando puntatori che si spostano continuamente in avanti. Periodicamente, Kafka elimina le parti più vecchie del registro, indipendentemente dal fatto che i messaggi in queste parti siano stati letti o meno. Un elemento centrale del design di Kafka è che il broker non si preoccupa se i messaggi siano stati letti o meno: questa è la responsabilità del cliente.
I termini "registro" e "puntatore" non si incontrano nella . Questi termini ben noti sono utilizzati qui per facilitare la comprensione.
Questo modello è completamente diverso da ActiveMQ, dove i messaggi di tutte le code sono memorizzati in un unico registro e il broker contrassegna i messaggi come eliminati dopo che sono stati letti.
Ora approfondiamo un po' e consideriamo più dettagliatamente il registro del topic.
Il registro di Kafka è composto da diverse partizioni (). Kafka garantisce un rispetto rigoroso dell'ordine in ogni partizione. Ciò significa che i messaggi registrati in una partizione in un certo ordine verranno letti nello stesso ordine. Ogni partizione è implementata come un file di registro ciclico (rolling) che contiene un sottoinsieme (subset) di tutti i messaggi inviati al topic dai suoi produttori. Un topic creato contiene per default una partizione. L'idea delle partizioni è il concetto centrale di Kafka per la scalabilità orizzontale.
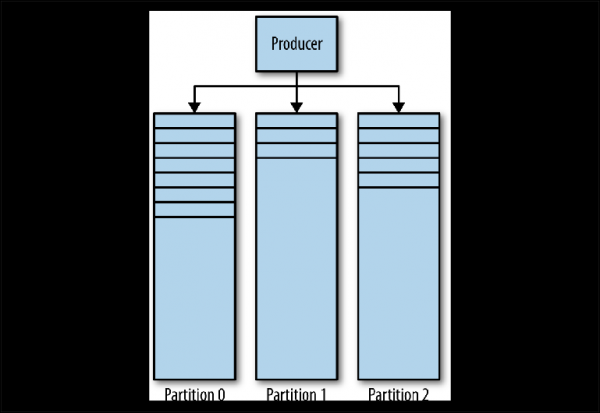
Figura 3-1. Partizioni di Kafka
Quando un produttore invia un messaggio a un topic di Kafka, decide in quale partizione inviare il messaggio. Esamineremo questo più in dettaglio in seguito.
Lettura dei messaggi
Il cliente che desidera leggere i messaggi gestisce un puntatore denominato gruppo di consumatori (consumer group), che punta a uno spostamento (offset) del messaggio nella partizione. Lo spostamento è una posizione con un numero in aumento, che inizia da 0 all'inizio della partizione. Questo gruppo di consumatori, a cui si fa riferimento nell'API tramite un identificatore definito dall'utente group_id, corrisponde a un consumatore logico o sistema.
La maggior parte dei sistemi che utilizzano il messaging legge i dati dall'indirizzo tramite più istanze e flussi per l'elaborazione parallela dei messaggi. Pertanto, ci saranno solitamente molte istanze di consumatori che condividono lo stesso gruppo di consumatori.
Il problema della lettura può essere visto in questo modo:
- Il topic ha diverse partizioni
- Molteplici gruppi di consumer possono utilizzare il topic contemporaneamente
- Un gruppo di consumer può avere più esemplari distinti
Questo è un problema non banale di «molti a molti». Per comprendere come Kafka gestisca le relazioni tra i gruppi di consumer, gli esemplari di consumer e le partizioni, consideriamo una serie di scenari di lettura che diventano progressivamente più complessi.
Consumer e gruppi di consumer
Partiamo da un topic con una sola partizione ().
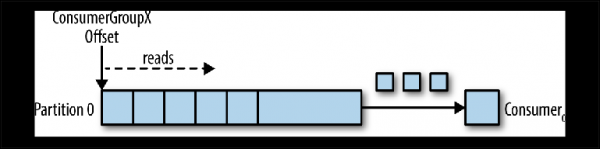
Figura 3-2. Il consumer legge dalla partizione
Quando un esemplare di consumer si connette a questo topic con il proprio group_id, viene assegnata una partizione per la lettura e un offset in quella partizione. La posizione di questo offset è configurata nel client, come puntatore alla posizione più recente (il messaggio più recente) o alla posizione più antica (il messaggio più vecchio). Il consumer richiede (polls) messaggi dal topic, il che porta alla loro lettura sequenziale dal log.
La posizione dell'offset viene regolarmente committata di nuovo in Kafka e memorizzata, come messaggi nel topic interno _consumer_offsets. I messaggi letti non vengono comunque rimossi, a differenza di un broker normale, e il client può riavvolgere (rewind) l'offset per rielaborare i messaggi già visualizzati.
Quando si connette un secondo consumer logico, utilizzando un altro group_id, gestisce un secondo puntatore, che è indipendente dal primo (). In questo modo, il topic Kafka funziona come una coda, in cui esiste un consumer e, come un comune topic publisher-subscriber (pub-sub), a cui sono iscritti più consumer, con il vantaggio aggiuntivo che tutti i messaggi vengono conservati e possono essere elaborati più volte.
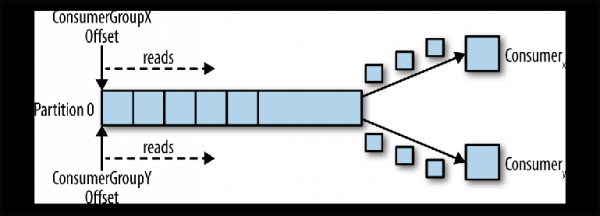
Figura 3-3. Due consumer in gruppi di consumer diversi leggono da una partizione
Consumer nel gruppo di consumer
Quando un esemplare di consumer legge dati da una partizione, controlla completamente il puntatore e elabora i messaggi, come descritto nel precedente paragrafo.
Se diversi consumer sono connessi con lo stesso group_id a un topic con una sola partizione, l'istanza che si è connessa per ultima otterrà il controllo del puntatore e da quel momento riceverà tutti i messaggi ().
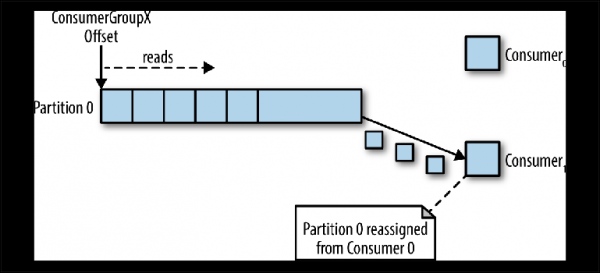
Figura 3-4. Due consumer nella stessa gruppo di consumer leggono da una partizione
Questa modalità di elaborazione, in cui il numero di istanze di consumer supera il numero di partizioni, può essere considerata una forma di consumatore monopolistico. Questo può essere utile se si desidera una clustering "attivo-passivo" (o "caldo-tiepido") delle vostre istanze di consumer, sebbene l'esecuzione parallela di più consumer ("attivo-attivo" o "caldo-caldo") sia molto più comune rispetto ai consumer in attesa.
Questo comportamento di distribuzione dei messaggi, descritto sopra, può sorprendere rispetto al funzionamento di una normale coda JMS. In questo modello, i messaggi inviati alla coda saranno distribuiti uniformemente tra i due consumer.
Più frequentemente, quando creiamo più istanze di consumer, lo facciamo per l'elaborazione parallela dei messaggi, per aumentare la velocità di lettura o per migliorare la resilienza del processo di lettura. Poiché da una partizione può leggere un solo consumer alla volta, come viene raggiunto questo in Kafka?
Un modo per farlo è utilizzare un'istanza di consumer per leggere tutti i messaggi e passarli a un pool di thread. Sebbene questo approccio aumenti la capacità di elaborazione, aumenta la complessità della logica dei consumer e non migliora la resilienza del sistema di lettura. Se un'istanza di consumer si disconnette a causa di un'interruzione di corrente o di un evento simile, la lettura si interrompe.
Il modo canonico per risolvere questo problema in Kafka è utilizzare unOnumero maggiore di partizioni.
Partizionamento
Le partizioni sono il meccanismo principale per parallelizzare la lettura e scalare il topic oltre la capacità di un singolo broker. Per comprendere meglio, consideriamo la situazione in cui esiste un topic con due partizioni e a questo topic si iscrive un consumer ().
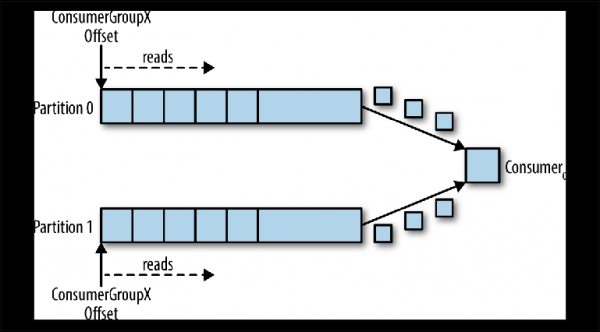
Figura 3-5. Un consumatore legge da più partizioni
In questo scenario, al consumatore viene dato il controllo sui puntatori corrispondenti al suo group_id in entrambe le partizioni e inizia a leggere i messaggi da entrambe le partizioni.
Quando viene aggiunto un ulteriore consumatore a questo argomento per lo stesso group_id, Kafka ri-assegna (reallocate) una delle partizioni dal primo al secondo consumatore. Dopo di che, ogni istanza del consumatore leggerà da una partizione dell'argomento ().
Per garantire l'elaborazione dei messaggi in parallelo su 20 thread, saranno necessarie almeno 20 partizioni. Se ci sono meno partizioni, ci saranno consumatori che non hanno nulla di cui occuparsi, come descritto in precedenza nella discussione sui consumatori monopolisti.
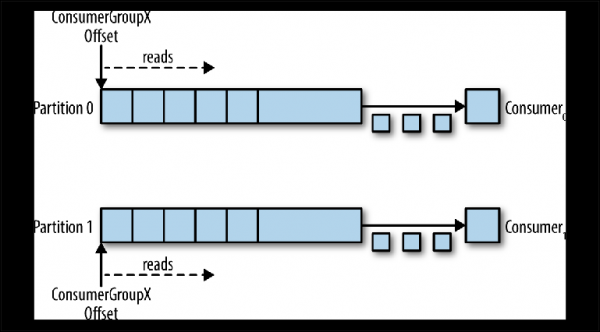
Figura 3-6. Due consumatori nella stessa gruppo di consumatori leggono da partizioni diverse
Questo schema riduce significativamente la complessità del lavoro del broker Kafka rispetto alla distribuzione dei messaggi necessaria per supportare la coda JMS. Qui non è necessario preoccuparsi dei seguenti aspetti:
- Quale consumatore dovrebbe ricevere il prossimo messaggio, basato sulla distribuzione a turno (round-robin), la capacità corrente dei buffer di pre-lettura o i messaggi precedenti (come per i gruppi di messaggi JMS).
- Quali messaggi sono stati inviati a quali consumatori e se devono essere consegnati di nuovo in caso di errore.
Tutto ciò che deve fare il broker Kafka è trasmettere i messaggi al consumatore in modo sequenziale, quando quest'ultimo li richiede.
Tuttavia, le esigenze di parallelizzazione della lettura e di reinvio dei messaggi falliti non scompaiono, ma la responsabilità per esse passa semplicemente dal broker al client. Questo significa che devono essere considerate nel vostro codice.
Invio dei messaggi
La responsabilità di decidere a quale partizione inviare un messaggio ricade sul produttore di quel messaggio. Per comprendere il meccanismo con cui questo avviene, è necessario prima esaminare cosa stiamo effettivamente inviando.
Mentre in JMS utilizziamo una struttura di messaggio con metadati (intestazioni e proprietà) e un corpo contenente il payload, in Kafka il messaggio è una coppia "chiave-valore". Il payload del messaggio viene inviato come valore (value). La chiave, d'altra parte, viene utilizzata principalmente per il partizionamento e deve contenere una chiave specifica per la logica aziendale, per collocare i messaggi correlati nella stessa partizione.
Nella Capitolo 2 abbiamo discusso di uno scenario di scommesse online, quando eventi correlati devono essere elaborati in ordine da un unico consumatore:
- L'account utente è stato configurato.
- I soldi vengono accreditati sul conto.
- Viene effettuata una scommessa che preleva soldi dal conto.
Se ogni evento rappresenta un messaggio inviato a un topic, in questo caso la chiave naturale sarà l'ID dell'account.
Quando un messaggio viene inviato utilizzando l'API Kafka Producer, viene passato alla funzione di partizionamento, che, considerato il messaggio e lo stato attuale del cluster Kafka, restituisce l'ID della partizione in cui il messaggio deve essere inviato. Questa funzione è implementata in Java tramite l'interfaccia Partitioner.
Questa interfaccia è la seguente:
interface Partitioner {
    int partition(String topic,
        Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster);
}
L'implementazione del Partitioner per la determinazione della partizione utilizza per impostazione predefinita un algoritmo di hash del chiave (general-purpose hashing algorithm over the key) o round-robin, se la chiave non è specificata. Questo valore predefinito funziona bene nella maggior parte dei casi. Tuttavia, in futuro, potresti voler scrivere la tua.
Scrittura della propria strategia di partizionamento
Consideriamo un esempio in cui desideri inviare metadati insieme al payload del messaggio. Il payload nel nostro esempio è un'istruzione per effettuare un deposito su un conto di gioco. L'istruzione è ciò che vorremmo garantire di non modificare durante la trasmissione e vogliamo assicurarci che solo un sistema di fiducia superiore possa avviare questa istruzione. In questo caso, i sistemi mittente e destinatario concordano sull'uso della firma per verificare l'autenticità del messaggio.
Nell'ordinario JMS definiamo semplicemente la proprietà "firma del messaggio" e la aggiungiamo al messaggio. Tuttavia, Kafka non ci offre un meccanismo per trasmettere metadati — solo chiave e valore.
Poiché il valore è il payload del bonifico bancario, la cui integrità vogliamo mantenere, non ci resta altro che definire la struttura dei dati da utilizzare nella chiave. Supponendo di aver bisogno di un identificatore dell'account per il partizionamento, dato che tutti i messaggi relativi all'account devono essere elaborati in sequenza, ipotizzeremo la seguente struttura JSON:
{
  "signature": "541661622185851c248b41bf0cea7ad0",
  "accountId": "10007865234"
}
Poiché il valore della firma varierà a seconda del payload, la strategia di hashing predefinita dell'interfaccia Partitioner non raggrupperà in modo affidabile i messaggi correlati. Pertanto, dovremo scrivere la nostra strategia, che analizzerà questa chiave e dividerà (partition) il valore accountId.
Kafka include checksum per rilevare la corruzione dei messaggi nello storage e ha un completo insieme di funzionalità di sicurezza. Anche in questo caso, a volte emergono requisiti specifici del settore, come quello di cui sopra.
La strategia di partizionamento personalizzata deve garantire che tutti i messaggi correlati finiscano in una sola partizione. Anche se questo sembra semplice, il requisito può complicarsi a causa dell'importanza di mantenere l'ordine dei messaggi correlati e del numero fisso di partizioni nel topic.
Il numero di partizioni nel topic può cambiare nel tempo, poiché possono essere aggiunte se il traffico supera le aspettative iniziali. Pertanto, le chiavi dei messaggi possono essere associate alla partizione in cui sono state inizialmente inviate, implicando parte dello stato che deve essere distribuito tra le istanze del produttore.
Un altro fattore da considerare è l'uniformità della distribuzione dei messaggi tra le partizioni. Di norma, le chiavi non sono distribuite uniformemente tra i messaggi, e le funzioni hash non garantiscono una distribuzione equa dei messaggi per un piccolo insieme di chiavi.
È importante notare che, qualunque sia la decisione su come dividere i messaggi, il delimitatore stesso potrebbe dover essere riutilizzato.
Esaminiamo il requisito della replica dei dati tra cluster Kafka in diverse località geografiche. A questo scopo, Kafka viene fornito con uno strumento da riga di comando chiamato MirrorMaker, utilizzato per leggere i messaggi da un cluster e trasferirli in un altro.
MirrorMaker deve comprendere le chiavi del topic replicato per mantenere l'ordine relativo tra i messaggi durante la replica tra i cluster, poiché il numero di partizioni per quel topic potrebbe non corrispondere nei due cluster.
Le strategie di partizionamento personalizzate si incontrano relativamente raramente, poiché il default hashing o il round-robin funzionano con successo nella maggior parte degli scenari. Tuttavia, se hai bisogno di garanzie rigorose di ordinamento o se è necessario estrarre metadati dai payload, il partizionamento è ciò su cui dovresti soffermarti con maggiore attenzione.
I vantaggi di scalabilità e prestazioni di Kafka derivano dal trasferimento di alcune responsabilità di un tradizionale broker al client. In questo caso, si decide di distribuire messaggi potenzialmente correlati su più consumatori che funzionano in parallelo.
Anche i broker JMS devono affrontare tali requisiti. È interessante notare che il meccanismo di invio di messaggi correlati allo stesso consumatore, implementato attraverso i JMS Message Groups (una variante della strategia di bilanciamento del carico sticky load balancing (SLB)), richiede anche che l'invio contrassegni i messaggi come correlati. Nel caso di JMS, il broker è responsabile dell'invio di questo gruppo di messaggi correlati a un consumatore tra molti e del trasferimento della proprietà del gruppo se il consumatore si disconnette.
Accordi per il produttore
Il partizionamento non è l'unico aspetto da considerare quando si inviano messaggi. Esaminiamo i metodi send () della classe Producer nell'API Java:
Future  send(ProducerRecord  record);
Future  send(ProducerRecord  record, Callback callback);
È importante notare che entrambi i metodi restituiscono un Future, il che indica che l'operazione di invio non viene eseguita immediatamente. Di conseguenza, il messaggio (ProducerRecord) viene scritto nel buffer di invio per ogni partizione attiva e viene inviato al broker tramite un thread in background nella libreria cliente Kafka. Sebbene questo renda il lavoro incredibilmente veloce, significa che un'applicazione scritta in modo inadeguato potrebbe perdere messaggi se il suo processo viene interrotto.
Come sempre, c'è un modo per rendere l'operazione di invio più affidabile a scapito delle prestazioni. Le dimensioni di questo buffer possono essere impostate a 0, e il thread dell'applicazione di invio sarà costretto ad attendere fino al completamento della trasmissione del messaggio al broker, nel modo seguente:
RecordMetadata metadata = producer.send(record).get();Ancora una volta sulla lettura dei messaggi
La lettura dei messaggi presenta ulteriori complessità di cui è necessario discutere. A differenza dell'API JMS, che può avviare un ascoltatore di messaggi in risposta all'arrivo di un messaggio, l'interfaccia Consumer Kafka esegue solo polling. Esaminiamo più da vicino il metodo poll (), utilizzato per questo scopo:
ConsumerRecords poll(long timeout);Il valore restituito dal metodo è una struttura contenitore che contiene più oggetti ConsumerRecord da potenziali più partizioni. ConsumerRecord è, di per sé, un oggetto contenitore per la coppia chiave-valore con metadati pertinenti, come la partizione da cui è stato ricevuto.
Come discusso nel Capitolo 2, dobbiamo ricordare costantemente cosa succede ai messaggi dopo il loro trattamento, sia che sia andato a buon fine che non, ad esempio nel caso in cui il cliente non riesca a elaborare un messaggio o si interrompa. In JMS questo veniva gestito attraverso la modalità di conferma (acknowledgement mode). Il broker eliminerà il messaggio elaborato con successo oppure riporterà il messaggio non elaborato o fallito (a condizione che siano state utilizzate transazioni).
Kafka funziona in modo completamente diverso. I messaggi non vengono eliminati dal broker dopo la lettura e la responsabilità di ciò che accade in caso di errore è nel codice di lettura stesso.
Come abbiamo già detto, un gruppo di consumatori è legato allo spostamento nel log. La posizione nel log associata a questo spostamento corrisponde al successivo messaggio che sarà emesso in risposta a poll ()Il momento in cui questo offset aumenta è fondamentale nella lettura.
Tornando al modello di lettura discusso in precedenza, l'elaborazione del messaggio avviene in tre fasi:
- Estrarre il messaggio da leggere.
- Elaborare il messaggio.
- Confermare il messaggio.
Il consumatore Kafka viene fornito con un'opzione di configurazione enable.auto.commit. Questa è un'impostazione frequentemente utilizzata di default, come di solito accade con le impostazioni che contengono la parola "auto".
Fino a Kafka 0.10, il client che utilizzava questo parametro inviava l'offset dell'ultimo messaggio letto al successivo richiamo poll () dopo l'elaborazione. Questo significava che eventuali messaggi già estratti (fetched) avrebbero potuto essere elaborati nuovamente, se il client li avesse già elaborati, ma fosse stato improvvisamente interrotto prima del richiamo poll (). Poiché il broker non conserva alcuno stato riguardo a quante volte un messaggio è stato letto, il successivo consumatore che estrae questo messaggio non saprà che è successo qualcosa di sbagliato. Questo comportamento era pseudo-transazionale. L'offset veniva impegato solo in caso di elaborazione riuscita del messaggio, ma se il client andava in errore, il broker inviava lo stesso messaggio a un altro client. Tale comportamento corrispondeva alla garanzia di consegna dei messaggi "almeno una volta«.
In Kafka 0.10, il codice del client è stato modificato in modo tale che il commit iniziava a essere eseguito periodicamente dalla libreria cliente, in conformità con l'impostazione auto.commit.interval.ms. Questo comportamento si colloca a metà strada tra le modalità JMS AUTO_ACKNOWLEDGE e DUPS_OK_ACKNOWLEDGE. Quando si utilizza l'auto-commit, i messaggi potrebbero essere confermati indipendentemente dal fatto che fossero stati effettivamente elaborati - questo potrebbe verificarsi nel caso di un consumatore lento. Se il consumatore andava in errore, i messaggi venivano estratti dal successivo consumatore a partire dalla posizione confermata, il che poteva portare a saltare un messaggio. In tal caso, Kafka non perdeva messaggi; il codice di lettura semplicemente non li elaborava.
Questa modalità ha le stesse prospettive di quella nella versione 0.9: i messaggi possono essere elaborati, ma in caso di errore, l'offset potrebbe non essere stato confermato, il che potrebbe potenzialmente portare a una duplicazione della consegna. Più messaggi estrai durante l'esecuzione poll (), maggiore è questo problema.
Come discusso nella sezione «Lettura dei messaggi dalla coda» a pagina 21, nel sistema di messaging non esiste il concetto di consegna unica del messaggio, se si considerano le modalità di errore.
In Kafka ci sono due modi per registrare (commit) l'offset: automaticamente e manualmente. In entrambi i casi, i messaggi possono essere elaborati più volte, nel caso in cui un messaggio sia stato elaborato, ma si sia verificato un errore prima del commit. Puoi anche non elaborare affatto un messaggio se il commit è avvenuto in background e il tuo codice è stato completato prima di iniziare l'elaborazione (probabilmente in Kafka 0.9 e versioni precedenti).
Per gestire manualmente il processo di commit dell'offset, puoi utilizzare l'API del consumer di Kafka, impostando il parametro enable.auto.commit su false e chiamando esplicitamente uno dei seguenti metodi:
void commitSync();
void commitAsync();
Se desideri elaborare un messaggio «almeno una volta», devi committare l'offset manualmente con commitSync (), eseguendo questo comando immediatamente dopo l'elaborazione dei messaggi.
Questi metodi non consentono di confermare i messaggi fino a quando non vengono elaborati, ma non fanno nulla per prevenire la potenziale duplicazione dell'elaborazione, creando nel contempo l'illusione di transazionalità. In Kafka non ci sono transazioni. Il client non ha la possibilità di fare quanto segue:
- Annullare automaticamente (rollback) un messaggio non riuscito. I consumer devono gestire le eccezioni che si verificano a causa di payload problematici e disconnessioni del backend, poiché non possono contare sulla riconsegna dei messaggi da parte del broker.
- Inviare messaggi a più topic all'interno di un'unica operazione atomica. Come vedremo presto, il controllo su diversi topic e partizioni può trovarsi su diverse macchine nel cluster Kafka, che non coordinano le transazioni durante l'invio. Al momento della scrittura di questo articolo, è stato fatto un certo lavoro per rendere questo possibile tramite KIP-98.
- Collegare la lettura di un messaggio da un topic all'invio di un altro messaggio a un altro topic. Ancora una volta, l'architettura di Kafka dipende da molte macchine indipendenti che funzionano come un'unica rete e non vengono fatti tentativi per nascondere questo. Ad esempio, non esistono componenti API che permettano di collegare Consumer e Producer nella transazione. In JMS questo è garantito dall'oggetto Session, da cui vengono creati MessageProducers e MessageConsumers.
Se non possiamo fare affidamento sulle transazioni, come possiamo garantire una semantica più vicina a quella fornita dai tradizionali sistemi di messaggistica?
Se c'è la possibilità che l'offset del consumer possa aumentare prima che il messaggio venga elaborato, ad esempio durante un guasto del consumer, allora il consumer non ha alcun modo di sapere se il suo gruppo di consumer ha saltato messaggi quando gli viene assegnata una partizione. Pertanto, una delle strategie è quella di riavvolgere l'offset sulla posizione precedente. L'API del consumer di Kafka fornisce i seguenti metodi per questo:
void seek(TopicPartition partition, long offset);
void seekToBeginning(Collection  partitions);
Sanitizer.replaceElementWithChildren() seek () può essere utilizzato con il metodo
offsetsForTimes (Map timestampsToSearch) per riavvolgere a uno stato in un particolare momento nel passato.
Implicitamente, l'uso di questo approccio significa che è molto probabile che alcuni messaggi precedentemente elaborati vengano letti ed elaborati di nuovo. Per evitare ciò, possiamo utilizzare la lettura idempotente, come descritto nel Capitolo 4, per tracciare i messaggi già visualizzati ed escludere i duplicati.
In alternativa, il codice del tuo consumer potrebbe essere semplice, se è accettabile la perdita o la duplicazione dei messaggi. Quando consideriamo scenari d'uso per i quali Kafka è tipicamente utilizzato, come l'elaborazione di eventi di log, metriche, tracciamento dei clic, ecc., ci rendiamo conto che la perdita di messaggi singoli avrà probabilmente un impatto trascurabile sulle applicazioni circostanti. In tali casi, i valori predefiniti sono assolutamente accettabili. D'altra parte, se la tua applicazione deve trasmettere pagamenti, devi prestare particolare attenzione a ciascun singolo messaggio. Tutto si riduce al contesto.
Osservazioni personali mostrano che, con l'aumentare dell'intensità dei messaggi, il valore di ciascun singolo messaggio diminuisce. Messaggi di grande volume diventano generalmente preziosi se considerati in forma aggregata.
Alta disponibilità (High Availability)
L'approccio di Kafka alla disponibilità elevata è sostanzialmente diverso rispetto a quello di ActiveMQ. Kafka è progettata su cluster scalabili orizzontalmente, in cui tutte le istanze del broker ricevono e inviano messaggi contemporaneamente.
Un cluster Kafka è composto da più istanze di broker che operano su server diversi. Kafka è stata progettata per funzionare su hardware autonomo comune, dove ogni nodo ha il proprio storage dedicato. L'uso di storage di rete (SAN) non è raccomandato, poiché più nodi computazionali possono competere per gli intervalli di tempo dello storage e creare conflitti.Laintervalli di archiviazione e creare conflitti.
Kafka è un sistema sempre acceso. Molti grandi utilizzatori di Kafka non spengono mai i loro cluster e il software assicura sempre l'aggiornamento tramite un riavvio sequenziale. Ciò è raggiunto garantendo la compatibilità con le versioni precedenti per i messaggi e le interazioni tra broker.
I broker sono collegati al cluster di server , che funge da registro delle configurazioni e viene utilizzato per coordinare i ruoli di ciascun broker. ZooKeeper è a sua volta un sistema distribuito che garantisce alta disponibilità tramite la replicazione delle informazioni stabilendo un quorum..
Nel caso base, un topic viene creato nel cluster Kafka con le seguenti proprietà:
- Numero di partizioni. Come discusso in precedenza, il valore preciso utilizzato qui dipende dal livello desiderato di lettura parallela.
- Il fattore di replica determina quanti istanze del broker nel cluster devono contenere i log per questa partizione.
Utilizzando ZooKeepers per la coordinazione, Kafka cerca di distribuire in modo equo le nuove partizioni tra i broker nel cluster. Questo viene fatto da un'istanza che svolge il ruolo di Controller.
Durante il runtime per ciascuna partizione del topic Controller assegna ai broker i ruoli di leader (leader, master, capo) seguaci (follower, schiavi, subordinati). Il broker che funge da leader per questa partizione è responsabile della ricezione di tutti i messaggi inviati dai produttori e della distribuzione dei messaggi ai consumatori. Quando vengono inviati messaggi a una partizione del topic, vengono replicati su tutti i nodi broker che fungono da follower per questa partizione. Ogni nodo che contiene i log per la partizione è chiamato replica. Il broker può fungere da leader per alcune partizioni e da follower per altre.
Il follower che contiene tutti i messaggi memorizzati dal leader è chiamato replica sincronizzata (replica che è in stato sincronizzato, in-sync replica). Se il broker che funge da leader per la partizione si disconnette, qualsiasi broker che è in uno stato aggiornato o sincronizzato per questa partizione può assumere il ruolo di leader. Questo è un design incredibilmente resiliente.
Una parte della configurazione del produttore è il parametro acks, che definisce quante repliche devono riconoscere (acknowledge) la ricezione di un messaggio prima che il flusso dell'applicazione continui a inviare: 0, 1 o tutte. Se è impostato un valore all, allora al ricevimento del messaggio il leader invierà una conferma (confirmation) al produttore non appena riceve conferme (acknowledgements) da più repliche (compresa se stessa), come definito nella configurazione del topic min.insync.replicas (di default 1). Se il messaggio non può essere replicato con successo, il produttore genererà un'eccezione per l'applicazione (NotEnoughReplicas o NotEnoughReplicasAfterAppend).
In una configurazione tipica, viene creato un topic con un fattore di replica di 3 (1 leader, 2 follower per ogni partizione) e il parametro min.insync.replicas è impostato a 2. In questo caso, il cluster permetterà a uno dei broker che gestiscono la partizione del topic di disconnettersi senza influenzare le applicazioni client.
Questo ci riporta al compromesso già noto tra prestazioni e affidabilità. La replicazione avviene a causa del tempo aggiuntivo necessario per l'attesa delle conferme (acknowledgments) dai follower. Anche se, poiché avviene in parallelo, la replicazione, su almeno tre nodi, ha le stesse prestazioni che su due (ignorando l'aumento dell'uso della larghezza di banda della rete).
Utilizzando questo schema di replica, Kafka evita abilmente la necessità di garantire la registrazione fisica di ogni messaggio su disco con l'operazione sync (). Ogni messaggio inviato dal produttore verrà registrato nel log della partizione, ma, come discusso nel Capitolo 2, la registrazione nel file viene inizialmente eseguita nel buffer del sistema operativo. Se questo messaggio viene replicato su un'altra istanza di Kafka e si trova nella sua memoria, la perdita del leader non significa che il messaggio sia stato perso: può essere gestito da una replica sincronizzata.
Evitare la necessità di eseguire l'operazione sync () significa che Kafka può ricevere messaggi alla velocità con cui può registrarli in memoria. E viceversa, più a lungo si può evitare il flush della memoria su disco, meglio è. Per questo motivo, non è raro che ai broker Kafka venga assegnata una memoria di 64 GB o più. Questo utilizzo della memoria significa che un'istanza di Kafka può facilmente operare a velocità migliaia di volte superiori rispetto a un tradizionale broker di messaggi.
Kafka può anche essere configurato per applicare l'operazione sync () a pacchetti di messaggi. Poiché tutto in Kafka è orientato al lavoro con pacchetti, questo funziona davvero bene per molti scenari di utilizzo ed è uno strumento utile per gli utenti che richiedono garanzie molto forti. Gran parte della pura performance di Kafka è legata ai messaggi inviati al broker in forma di pacchetti, e al fatto che questi messaggi vengono letti dal broker in blocchi sequenziali tramite operazioni (operazioni in cui non viene eseguito il compito di copiare i dati da un'area di memoria a un'altra). Quest'ultima rappresenta un grande vantaggio in termini di performance e risorse ed è possibile solo grazie all'utilizzo della struttura dati sottostante del log che definisce lo schema della partizione.
In un cluster Kafka è possibile ottenere prestazioni molto più elevate rispetto a un singolo broker Kafka, poiché le partizioni del topic possono scalare orizzontalmente su molte macchine separate.
Conclusioni
In questo capitolo abbiamo esaminato come l'architettura di Kafka ridefinisca i rapporti tra clienti e broker, per fornire un incredibile flusso di messaggi con una capacità di gran lunga superiore rispetto a un normale broker di messaggi. Abbiamo discusso le funzionalità che sfrutta per raggiungere questo obiettivo e fornito una breve panoramica dell'architettura delle applicazioni che supportano tale funzionalità. Nel prossimo capitolo esamineremo le problematiche comuni che le applicazioni basate sullo scambio di messaggi devono affrontare e discuteremo le strategie per affrontarle. Concluderemo il capitolo delineando come riflettere sulle tecnologie di messaggistica in generale, in modo da poter valutarne l'idoneità per i tuoi scenari d'uso.
Parte precedente tradotta:
Traduzione eseguita:
Continua…
Solo gli utenti registrati possono partecipare al sondaggio. , per favore.
Kafka è utilizzato nella tua organizzazione?
Sì
No
In passato era utilizzato, ora no
Prevediamo di utilizzarlo
Hanno votato 38 utenti. 8 utenti si sono astenuti.
Fonte: habr.com
