

In Abbiamo esaminato la clusterizzazione di RabbitMQ per garantire la resilienza e l'alta disponibilità. Ora approfondiamo Apache Kafka.
In questo contesto, l'unità di replica è la partizione. Ogni argomento ha una o più partizioni. In ogni partizione c'è un leader con o senza follower. Quando si crea un argomento, si specifica il numero di partizioni e il fattore di replica. Il valore tipico è 3, il che significa tre repliche: un leader e due follower.
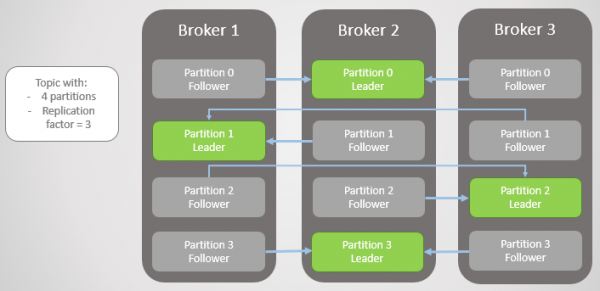
Fig. 1. Quattro partizioni distribuite tra tre broker
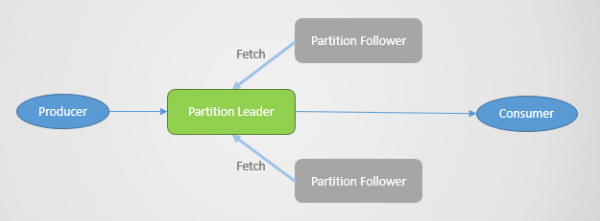
Tutte le richieste di lettura e scrittura vengono inviate al leader. I follower inviano periodicamente richieste al leader per ottenere gli ultimi messaggi. I consumatori non si collegano mai ai follower; questi ultimi esistono solo per ridondanza e resilienza.
Guasto della partizione
Quando un broker cade, spesso i leader di diverse partizioni smettono di funzionare. In ognuna di esse, un follower di un altro nodo diventa il nuovo leader. In realtà, ciò non avviene sempre, poiché influisce anche il fattore di sincronizzazione: ci sono follower sincronizzati e, se non ci sono, è consentito passare a una replica non sincronizzata. Ma non complicchiamo per ora.
Il broker 3 esce dalla rete, e per la partizione 2 viene scelto un nuovo leader sul broker 2.
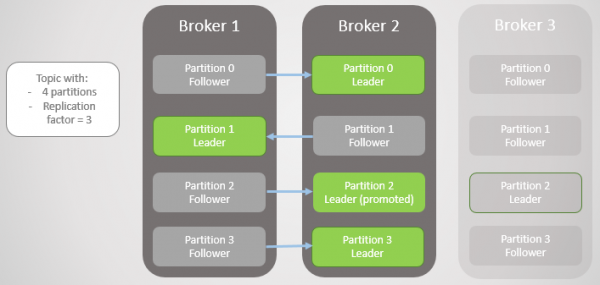
Fig. 2. Il broker 3 muore, e il suo follower sul broker 2 viene scelto come nuovo leader della partizione 2
Poi il broker 1 esce e anche la partizione 1 perde il suo leader, il cui ruolo passa al broker 2.
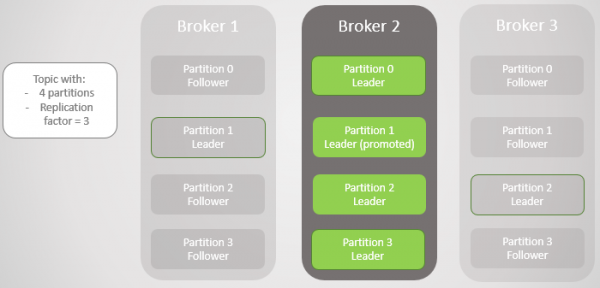
Fig. 3. Rimane solo un broker. Tutti i leader si trovano su un solo broker con zero ridondanza
Quando il broker 1 ritorna in rete, aggiunge quattro follower, fornendo una certa ridondanza a ogni partizione. Ma tutti i leader rimangono ancora sul broker 2.
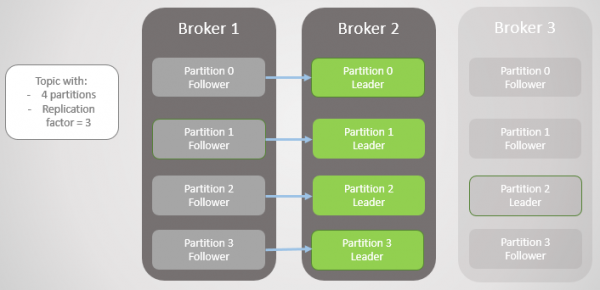
Fig. 4. I leader rimangono sul broker 2
Quando il broker 3 si riavvia, torniamo a tre repliche per partizione. Ma tutti i leader rimangono ancora sul broker 2.
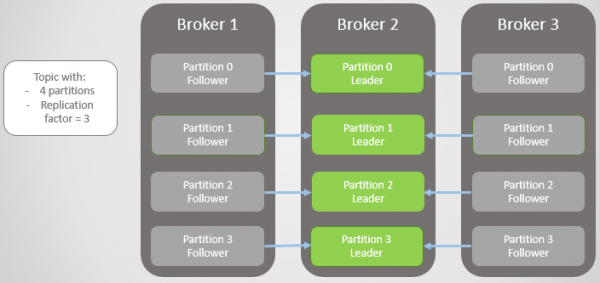
Fig. 5. Distribuzione sbilanciata dei leader dopo il ripristino dei broker 1 e 3
Kafka ha uno strumento per un riequilibrio dei leader di qualità superiore rispetto a RabbitMQ. Qui si doveva utilizzare un plugin o uno script esterno che modificava le politiche per migrare il nodo principale, riducendo la ridondanza durante la migrazione. Inoltre, per code di grandi dimensioni, si doveva accettare l'inaccessibilità durante la sincronizzazione.
Kafka ha un concetto di "repliche preferite" per il ruolo di leader. Quando vengono creati i topic, Kafka cerca di distribuire uniformemente i leader tra i nodi e contrassegna questi primi leader come preferiti. Col passare del tempo, a causa del riavvio dei server, guasti e interruzioni di connettività, i leader possono trovarsi su altri nodi, come nel caso estremo descritto sopra.
Per risolvere questo problema, Kafka offre due opzioni:
- Opzione auto.leader.rebalance.enable=true consente al nodo controller di riassegnare automaticamente i leader alle repliche preferite, ripristinando così la distribuzione uniforme.
- L'amministratore può eseguire lo script kafka-preferred-replica-election.sh per effettuare una riassegnazione manuale.
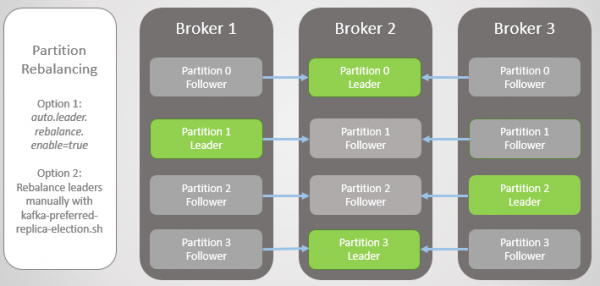
Fig. 6. Repliche dopo il ri bilanciamento
Questa era una versione semplificata del guasto, ma la realtà è più complessa, anche se non c'è nulla di troppo complicato qui. Tutto si riduce a repliche sincronizzate (In-Sync Replicas, ISR).
Repliche sincronizzate (ISR)
ISR è un insieme di repliche di un partizione che è considerata "sincronizzata". Qui c'è un leader, e i follower possono anche non esserci. Un follower è considerato sincronizzato se ha fatto copie esatte di tutti i messaggi del leader prima della scadenza dell'intervallo replica.lag.time.max.ms.
Un follower viene rimosso dall'insieme di ISR se:
- non ha effettuato una richiesta di fetch entro l'intervallo replica.lag.time.max.ms (considerato morto)
- non è riuscito ad aggiornarsi entro l'intervallo replica.lag.time.max.ms (considerato lento)
I follower effettuano richieste di fetch entro l'intervallo replica.fetch.wait.max.ms, che per impostazione predefinita è di 500 ms.
Per spiegare chiaramente l'obiettivo di ISR, è necessario esaminare gli acknowledgments dal produttore e alcuni scenari di guasto. I produttori possono scegliere quando il broker invia un acknowledgment:
- acks=0, non viene inviato alcun acknowledgment
- acks=1, l'acknowledgment viene inviato dopo che il leader ha registrato il messaggio nel proprio log locale
- acks=all, l'acknowledgment viene inviato dopo che tutte le repliche in ISR hanno registrato il messaggio nei log locali
Nella terminologia di Kafka, se ISR ha mantenuto il messaggio, avviene il suo "commit". Acks=all è l'opzione più sicura, ma comporta anche un ritardo addizionale. Consideriamo due esempi di guasto e come le diverse opzioni di 'acks' interagiscono con il concetto di ISR.
Acks=1 e ISR
In questo esempio vedremo che se il leader non aspetta di ricevere ogni messaggio da tutti i follower, allora in caso di guasto del leader potrebbero esserci perdite di dati. Il passaggio a un follower non sincronizzato può essere consentito o vietato tramite configurazione. unclean.leader.election.enable.
In questo esempio, il produttore ha impostato il valore di acks=1. La partizione è distribuita su tutti e tre i broker. Il broker 3 è in ritardo, si è sincronizzato con il leader otto secondi fa e ora è in ritardo di 7456 messaggi. Il broker 1 è in ritardo solo di un secondo. Il nostro produttore invia un messaggio e riceve rapidamente un ack, senza overhead per follower lenti o morti, che il leader non sta aspettando.
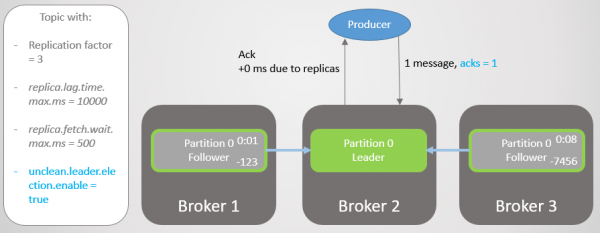
Fig. 7. ISR con tre repliche
Il broker 2 si guasta e il produttore riceve un errore di connessione. Dopo il passaggio di leadership al broker 1, perdiamo 123 messaggi. Il follower sul broker 1 era nell'ISR, ma non si era completamente sincronizzato con il leader quando questo è crollato.
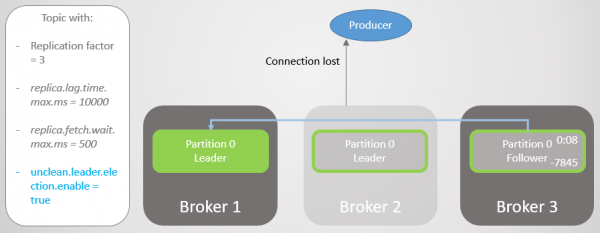
Fig. 8. Messaggi persi in caso di guasto
Nella configurazione bootstrap.servers il produttore elenca diversi broker e può chiedere a un altro broker chi è diventato il nuovo leader della partizione. Poi stabilisce una connessione con il broker 1 e continua a inviare messaggi.
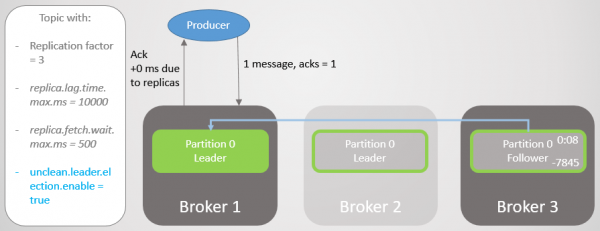
Fig. 9. L'invio dei messaggi riprende dopo una breve interruzione
Il broker 3 è in ulteriore ritardo. Fa richieste di fetch, ma non riesce a sincronizzarsi. Questo potrebbe essere dovuto a una connessione di rete lenta tra i broker, problemi di archiviazione, ecc. Viene rimosso dall'ISR. Ora l'ISR è composto da una sola replica: il leader! Il produttore continua a inviare messaggi e ricevere conferme.
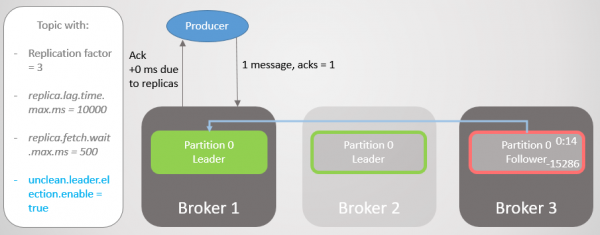
Fig. 10. Il follower sul broker 3 viene rimosso dall'ISR
Il broker 1 crolla e il ruolo di leader passa al broker 3 con una perdita di 15286 messaggi! Il produttore riceve un messaggio di errore di connessione. Il passaggio al leader fuori dall'ISR è stato possibile solo a causa della configurazione unclean.leader.election.enable=true. Se è impostato su false, il passaggio non sarebbe avvenuto e tutte le richieste di lettura e scrittura sarebbero state rifiutate. In questo caso, aspettiamo il ritorno del broker 1 con i suoi dati intatti nella replica, che riprenderà la leadership.
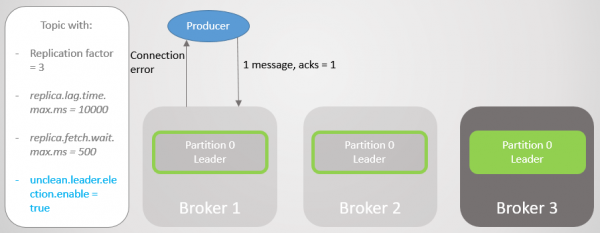
Fig. 11. Il broker 1 si guasta. In caso di guasto si perdono un gran numero di messaggi.
Il produttore stabilisce una connessione con l'ultimo broker e vede che ora è il leader della sezione. Inizia a inviare messaggi al broker 3.
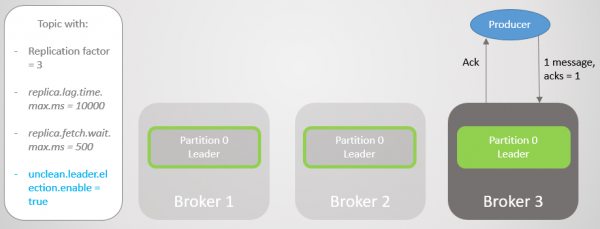
Fig. 12. Dopo una breve pausa, i messaggi vengono nuovamente inviati nella sezione 0
Abbiamo visto che, oltre ai brevi intervalli per stabilire nuove connessioni e cercare un nuovo leader, il produttore inviava continuamente messaggi. Questa configurazione garantisce la disponibilità a scapito della coerenza (sicurezza dei dati). Kafka ha perso migliaia di messaggi, ma ha continuato a ricevere nuove registrazioni.
Acks=all e ISR
Ripetiamo questo scenario ancora una volta, ma con acks=all. Il ritardo del broker 3 è in media di quattro secondi. Il produttore invia un messaggio con acks=all, e ora non riceve una risposta rapida. Il leader attende che il messaggio venga memorizzato da tutte le repliche in ISR.
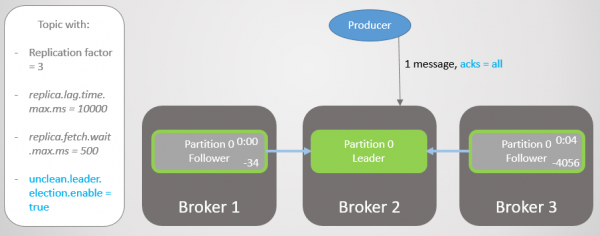
Fig. 13. ISR con tre repliche. Una è lenta, causando un ritardo nella registrazione
Dopo quattro secondi di ulteriore ritardo, il broker 2 invia ack. Tutte le repliche sono ora completamente aggiornate.
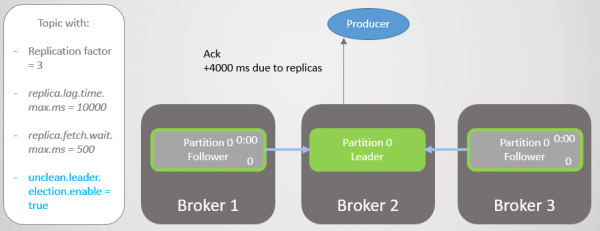
Fig. 14. Tutte le repliche memorizzano i messaggi e viene inviato ack
Il broker 3 ora è ulteriormente in ritardo e viene rimosso da ISR. Il ritardo diminuisce notevolmente, poiché non ci sono più repliche lente in ISR. Il broker 2 ora aspetta solo il broker 1, che ha un lag medio di 500 ms.
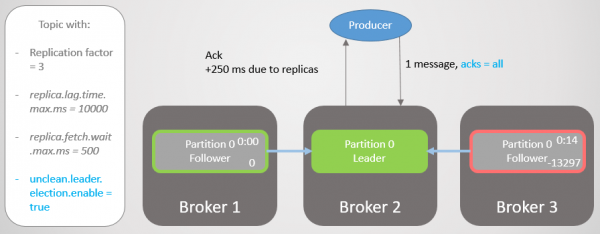
Fig. 15. La replica sul broker 3 viene rimossa da ISR
Poi il broker 2 viene a mancare e la leadership passa al broker 1 senza perdita di messaggi.
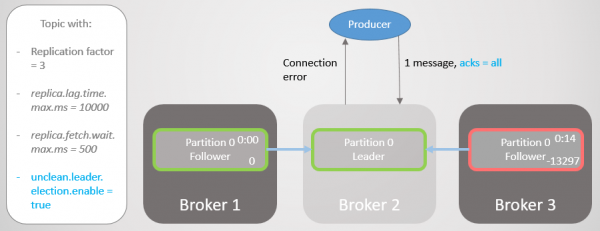
Fig. 16. Il broker 2 va in crash
Il produttore trova un nuovo leader e inizia a inviargli messaggi. Il ritardo diminuisce ulteriormente, poiché ora ISR consiste in una sola replica! Quindi l'opzione acks=all non aggiunge ridondanza.
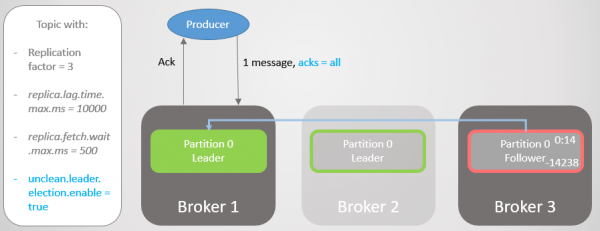
Fig. 17. La replica sul broker 1 assume la leadership senza perdita di messaggi
Poi il broker 1 va a mancare e la leadership passa al broker 3 con una perdita di 14238 messaggi!
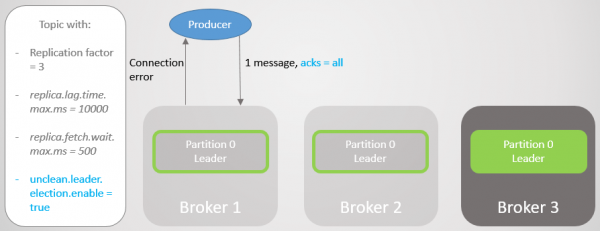
Fig. 18. Il broker 1 muore e il passaggio di leadership con l'impostazione unclean porta a una vasta perdita di dati
Potremmo non impostare l'opzione unclean.leader.election.enable a valore true. Per impostazione predefinita è false. L'impostazione acks=all con unclean.leader.election.enable=true garantisce la disponibilità con una certa sicurezza aggiuntiva dei dati. Ma, come vedete, possiamo comunque perdere messaggi.
Ma cosa succede se vogliamo aumentare la sicurezza dei dati? Possiamo impostare unclean.leader.election.enable = false, ma questo non proteggerà necessariamente dalla perdita di dati. Se il leader crolla in modo grave e porta via i dati, i messaggi andranno comunque persi, oltre a rendere inaccessibile il sistema finché l'amministratore non ripristina la situazione.
È meglio garantire la ridondanza di tutti i messaggi, altrimenti è consigliabile astenersi dalla registrazione. In questo modo, dal punto di vista del broker, la perdita di dati è possibile solo in caso di due o più guasti simultanei.
Acks=all, min.insync.replicas e ISR
Con la configurazione del topic min.insync.replicas aumentiamo il livello di sicurezza dei dati. Esaminiamo nuovamente l'ultima parte dello scenario precedente, ma questa volta con min.insync.replicas=2.
Quindi, il broker 2 ha un leader replica, mentre il follower sul broker 3 è rimosso dall'ISR.
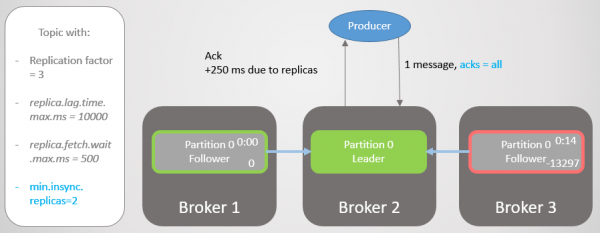
Fig. 19. ISR composto da due repliche
Il broker 2 crolla e la leadership passa al broker 1 senza perdita di messaggi. Ma ora l'ISR è composto solo da una replica. Ciò non soddisfa il numero minimo per la registrazione, e quindi il broker risponde a un tentativo di registrazione con un errore. NotEnoughReplicas.
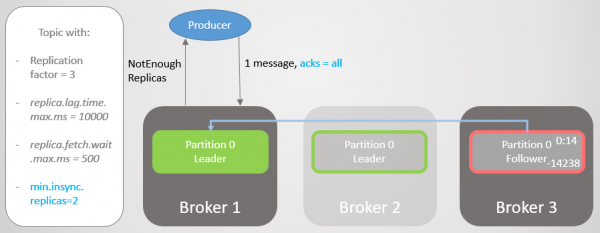
Fig. 20. Il numero di ISR è uno in meno rispetto a quanto specificato in min.insync.replicas
Questa configurazione sacrifica la disponibilità per la coerenza. Prima di confermare un messaggio, garantiamo che venga registrato su almeno due repliche. Ciò fornisce al produttore una maggiore sicurezza. Qui, la perdita di messaggi è possibile solo in caso di guasto simultaneo di due repliche in un breve intervallo di tempo, finché il messaggio non è stato replicato a un ulteriore follower, il che è improbabile. Ma se sei superparanoico, puoi impostare il fattore di replicazione a 5, e min.insync.replicas a 3. In questo caso, devono crollare simultaneamente tre broker per perdere una registrazione! Naturalmente, per tale affidabilità pagherai un ulteriore ritardo.
Quando la disponibilità è necessaria per la sicurezza dei dati
Come nel , a volte la disponibilità è necessaria per la sicurezza dei dati. Devi considerare questo:
- Può il publisher semplicemente restituire un errore, e il servizio superiore o l'utente riprovare in seguito?
- Il publisher può salvare il messaggio localmente o nel database per riprovare più tardi?
Se la risposta è negativa, allora l'ottimizzazione della disponibilità aumenta la sicurezza dei dati. Perderai meno dati se scegli la disponibilità rispetto al rifiuto della registrazione. In questo modo, si tratta di trovare un equilibrio, e la decisione dipende dalla situazione specifica.
Il senso di ISR
Il set ISR consente di scegliere il miglior equilibrio tra sicurezza dei dati e latenza. Ad esempio, garantire la disponibilità in caso di malfunzionamento della maggior parte delle repliche, minimizzando l'impatto delle repliche morte o lente in termini di latenza.
Scegliamo noi stessi il valore replica.lag.time.max.ms in base alle nostre esigenze. In sostanza, questo parametro indica quale latenza siamo disposti ad accettare durante acks=all. Il valore predefinito è dieci secondi. Se per te è troppo lungo, puoi ridurlo. Tuttavia, aumenterà la frequenza delle modifiche in ISR, poiché i follower verranno rimossi e aggiunti più frequentemente.
In RabbitMQ ci sono semplicemente un insieme di specchi che devono essere replicati. Gli specchi lenti introducono una latenza aggiuntiva, e per gli specchi morti si può attendere fino alla scadenza del tempo di vita dei pacchetti che verificano la disponibilità di ciascun nodo (net tick). ISR è un modo interessante per evitare questi problemi di aumento della latenza. Ma rischiamo di perdere ridondanza, poiché l'ISR può ridursi solo al leader. Per evitare questo rischio, utilizza la configurazione min.insync.replicas.
La garanzia di connessione dei clienti
Nelle impostazioni bootstrap.servers produttore e consumatore può specificare più broker per la connessione dei clienti. L'idea è che, se un nodo si disconnette, rimangano diversi backup a cui il cliente può collegarsi. Non devono necessariamente essere i leader delle partizioni, ma semplicemente un punto di riferimento per il caricamento iniziale. Il cliente può chiedere loro dove risiede il leader di partizione per lettura/scrittura.
In RabbitMQ, i clienti possono connettersi a qualsiasi nodo, e il routing interno invia la richiesta dove necessario. Questo significa che puoi posizionare un bilanciatore di carico davanti a RabbitMQ. Kafka richiede che i clienti si connettano al nodo in cui si trova il leader della rispettiva partizione. In tal caso, non è possibile installare un bilanciatore di carico. L'elenco bootstrap.servers è cruciale affinché i clienti possano accedere ai nodi necessari e trovarli dopo un guasto.
L'architettura di consenso di Kafka
Fino a ora non abbiamo considerato come il cluster apprenda il guasto di un broker e come venga scelto un nuovo leader. Per comprendere come Kafka gestisce le divisioni di rete, è necessario prima capire l'architettura di consenso.
Ogni cluster Kafka viene distribuito insieme a un cluster Zookeeper, che è un servizio di consenso distribuito che consente al sistema di raggiungere consenso su uno stato specifico, dando priorità alla coerenza piuttosto che alla disponibilità. Per approvare le operazioni di lettura e scrittura è necessario il consenso della maggioranza dei nodi Zookeeper.
Zookeeper memorizza lo stato del cluster:
- Elenco dei topic, partizioni, configurazione, repliche leader correnti, repliche preferenziali.
- Membri del cluster. Ogni broker invia un ping al cluster Zookeeper. Se non riceve un ping entro un determinato periodo di tempo, Zookeeper registra il broker come non disponibile.
- Scelta dei nodi principale e secondario per il controller.
Il nodo controller è uno dei broker Kafka che è responsabile dell'elezione dei leader delle repliche. Zookeeper invia al controller notifiche sui cambiamenti della membership nel cluster e dei topic, e il controller deve agire in base a queste modifiche.
Ad esempio, consideriamo un nuovo topic con dieci partizioni e un fattore di replica di 3. Il controller deve scegliere un leader per ogni partizione, cercando di ottimizzare la distribuzione dei leader tra i broker.
Per ogni partizione, il controller:
- aggiorna le informazioni in Zookeeper su ISR e leader;
- invia il comando LeaderAndISRCommand a ogni broker che ospita una replica di quella partizione, informando i broker su ISR e leader.
Quando un broker che è leader si guasta, Zookeeper invia una notifica al controller, che sceglie un nuovo leader. Anche in questo caso, il controller prima aggiorna Zookeeper e poi invia un comando a ogni broker, notificandoli del cambiamento di leadership.
Ogni leader è responsabile del set ISR. La configurazione replica.lag.time.max.ms determina chi ne farà parte. Quando ISR cambia, il leader comunica a Zookeeper le nuove informazioni.
Zookeeper è sempre informato di qualsiasi cambiamento, in modo che in caso di guasto la leadership possa passare senza problemi a un nuovo leader.
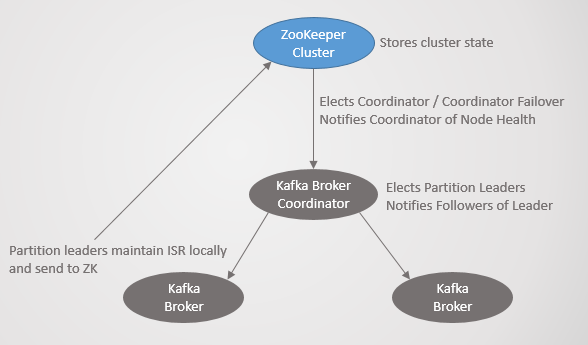
Fig. 21. Consenso Kafka
Protocollo di replicazione
Comprendere i dettagli della replicazione aiuta a capire meglio i potenziali scenari di perdita di dati.
Richieste di estrazione, Log End Offset (LEO) e Highwater Mark (HW)
Abbiamo esaminato come i follower inviano periodicamente al leader richieste di recupero (fetch). L'intervallo predefinito è di 500 ms. Questo si differenzia da RabbitMQ, in quanto in RabbitMQ la replica è avviata non da uno specchio della coda, ma dal master. Il master invia le modifiche agli specchi.
Il leader e tutti i follower mantengono l'offset della fine del log (Log End Offset, LEO) e il marcatore Highwater (HW). Il marcatore LEO conserva l'offset dell'ultimo messaggio nella replica locale, mentre HW rappresenta l'offset dell'ultimo commit. Ricordate che per lo stato 'commit' il messaggio deve essere memorizzato in tutte le repliche ISR. Questo significa che LEO di solito precede leggermente HW.
Quando il leader riceve un messaggio, lo memorizza localmente. Il follower invia una richiesta di recupero, passando il proprio LEO. Il leader quindi invia un pacchetto di messaggi, a partire da questo LEO, e fornisce anche l'attuale HW. Quando il leader riceve notizie che tutte le repliche hanno memorizzato il messaggio con l'offset specificato, sposta il marcatore HW. Solo il leader può spostare HW, e così tutti i follower apprendono il valore attuale nelle risposte alle loro richieste. Ciò significa che i follower possono rimanere indietro rispetto al leader sia nei messaggi che nella conoscenza di HW. I consumatori ricevono messaggi solo fino al corrente HW.
Si noti che 'persistito' (persisted) significa memorizzato in memoria, non su disco. Per motivi di prestazioni, Kafka esegue la sincronizzazione su disco a intervalli prestabiliti. Anche RabbitMQ ha tale intervallo, ma confermerà il publisher solo dopo che il master e tutti gli specchi hanno memorizzato il messaggio su disco. I programmatori di Kafka, per motivi di prestazioni, hanno deciso di inviare ack non appena il messaggio è memorizzato in memoria. Kafka scommette che la ridondanza compenserà il rischio di conservare temporaneamente i messaggi confermati solo in memoria.
Guasto del leader
Quando il leader cade, Zookeeper avvisa il controller, che sceglie una nuova replica leader. Il nuovo leader stabilisce un nuovo marcatore HW in base al proprio LEO. Le informazioni sul nuovo leader vengono quindi trasmesse ai follower. A seconda della versione di Kafka, il follower sceglierà uno dei due scenari:
- Tronca il log locale fino all'HW noto e invia al nuovo leader una richiesta di messaggi successivi a questo marcatore.
- Invia una richiesta al leader per conoscere l'HW al momento della sua elezione, quindi tronca il log a quel punto. Inizierà quindi a effettuare richieste periodiche per il campionamento, a partire da questo offset.
Il follower potrebbe dover troncare il log per le seguenti ragioni:
- Quando si verifica un guasto del leader, il primo follower del set ISR registrato in Zookeeper vince le elezioni e diventa il leader. Tutti i follower in ISR, sebbene considerati "sincronizzati", potrebbero non aver ricevuto copie di tutti i messaggi dal precedente leader. È possibile che il follower eletto non abbia la copia più aggiornata. Kafka garantisce che non ci siano discrepanze tra le repliche. Pertanto, per evitare discrepanze, ogni follower deve troncare il proprio log fino al valore HW del nuovo leader al momento della sua elezione. Questo è un ulteriore motivo per cui la configurazione acks=all è così importante per la coerenza.
- I messaggi vengono periodicamente scritti su disco. Se tutti i nodi del cluster falliscono contemporaneamente, sui dischi saranno salvate repliche con offset diversi. È possibile che quando i broker tornano in rete, il nuovo leader, che verrà eletto, risulti indietro rispetto ai suoi follower, poiché si è salvato su disco prima degli altri.
Riconnessione al cluster
Durante la riconnessione al cluster, le repliche si comportano come nel caso di un guasto del leader: controllano la replica del leader e troncano il proprio log fino al suo HW (al momento dell'elezione). A differenza, RabbitMQ considera i nodi riconnessi come completamente nuovi. In entrambi i casi, il broker scarta qualsiasi stato esistente. Se viene utilizzata la sincronizzazione automatica, il master deve replicare assolutamente tutto il contenuto corrente in un nuovo specchio in modalità "e lasciamo che il mondo aspetti". Durante questa operazione, il master non accetta alcuna operazione di lettura o scrittura. Questo approccio crea problemi in grandi code.
Kafka è un registro distribuito e, in generale, conserva più messaggi di una coda RabbitMQ, dove i dati vengono rimossi dalla coda dopo la lettura. Le code attive devono rimanere relativamente piccole. Ma Kafka è un registro con una propria politica di conservazione, che può stabilire un termine di giorni o settimane. L'approccio con il blocco della coda e la sincronizzazione completa è assolutamente inaccettabile per un registro distribuito. Invece, i follower di Kafka semplicemente accorciano il loro registro fino all'HW leader (al momento della sua elezione) nel caso in cui la loro copia superi il leader. Nel caso più probabile, in cui il follower è in ritardo, inizia semplicemente a fare richieste di polling, a partire dal proprio attuale LEO.
I nuovi follower o quelli ricostituiti iniziano al di fuori dell'ISR e non partecipano ai commit. Lavorano semplicemente a fianco del gruppo, ricevendo i messaggi il più velocemente possibile, finché non raggiungono il leader e non entrano nell'ISR. Non ci sono blocchi e non è necessario scartare tutti i propri dati.
Violazione della coerenza
Kafka ha più componenti rispetto a RabbitMQ, quindi qui c'è un insieme di comportamenti più complesso quando la connettività nel cluster viene compromessa. Ma Kafka è stato progettato fin dall'inizio per i cluster, quindi le soluzioni sono molto ben ponderate.
Di seguito sono riportati alcuni scenari di violazione della connettività:
- Scenario 1. Il follower non vede il leader, ma vede ancora Zookeeper.
- Scenario 2. Il leader non vede nessun follower, ma vede ancora Zookeeper.
- Scenario 3. Il follower vede il leader, ma non vede Zookeeper.
- Scenario 4. Il leader vede i follower, ma non vede Zookeeper.
- Scenario 5. Il follower è completamente isolato sia dagli altri nodi Kafka che da Zookeeper.
- Scenario 6. Il leader è completamente isolato sia dagli altri nodi Kafka che da Zookeeper.
- Scenario 7. Il nodo controller di Kafka non vede un altro nodo Kafka.
- Scenario 8. Il controller di Kafka non vede Zookeeper.
Ogni scenario prevede un comportamento specifico.
Scenario 1. Il follower non vede il leader, ma vede ancora Zookeeper
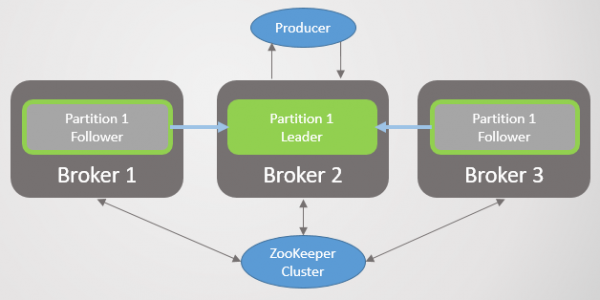
Fig. 22. Scenario 1. ISR di tre repliche
La violazione della connettività isola il broker 3 dai broker 1 e 2, ma non da Zookeeper. Il broker 3 non può più inviare richieste di polling. Al termine del tempo. replica.lag.time.max.ms viene rimosso dall'ISR e non partecipa ai commit dei messaggi. Non appena la connettività viene ripristinata, riprenderà le richieste di polling e si unirà all'ISR quando raggiungerà il leader. Zookeeper continuerà a ricevere i ping e considererà che il broker sia vivo e vegeto.
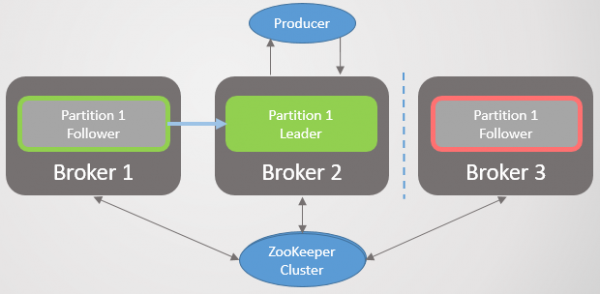
Fig. 23. Scenario 1. Il broker viene rimosso dall'ISR se non riceve una richiesta di polling entro l'intervallo replica.lag.time.max.ms
Non c'è alcuna separazione logica (split-brain) o pausa del nodo, come in RabbitMQ. Invece, si riduce la ridondanza.
Scenario 2. Il leader non vede alcun follower, ma vede ancora Zookeeper
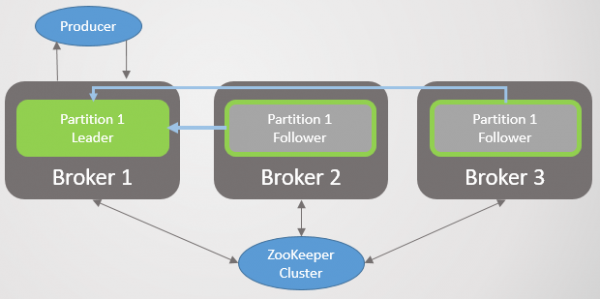
Fig. 24. Scenario 2. Il leader e due follower
Una perdita di connettività di rete separa il leader dai follower, ma il broker vede ancora Zookeeper. Come nel primo scenario, l'ISR si riduce, ma questa volta solo al leader, poiché tutti i follower smettono di inviare richieste di polling. Ancora una volta, non c'è alcuna separazione logica. Si verifica invece una perdita di ridondanza per i nuovi messaggi, fino a quando la connettività non viene ripristinata. Zookeeper continua a ricevere i ping e considera che il broker sia vivo e vegeto.
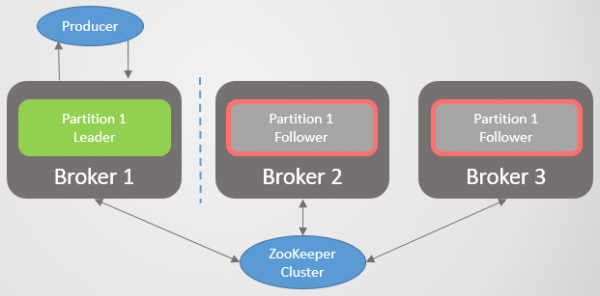
Fig. 25. Scenario 2. L'ISR si è compresso solo al leader
Scenario 3. Il follower vede il leader, ma non vede Zookeeper
Il follower è separato da Zookeeper, ma non dal broker con il leader. Di conseguenza, il follower continua a fare richieste di polling e a essere membro dell'ISR. Zookeeper non riceve più ping e registra il crash del broker, ma poiché è solo un follower, non ci sono conseguenze dopo il ripristino.
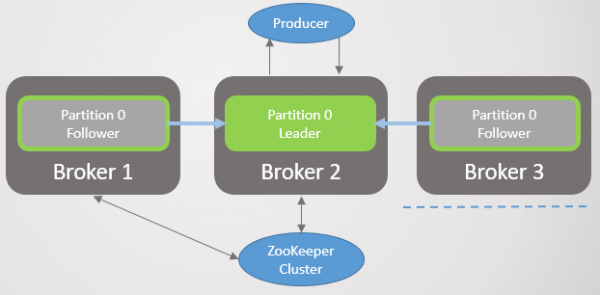
Fig. 26. Scenario 3. Il follower continua a inviare richieste di polling al leader
Scenario 4. Il leader vede i follower, ma non vede Zookeeper
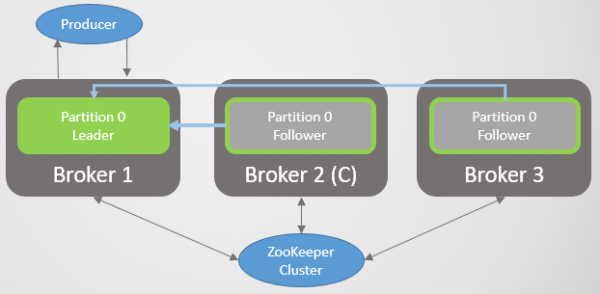
Fig. 27. Scenario 4. Il leader e due follower
Il leader è separato da Zookeeper, ma non dai broker con i follower.
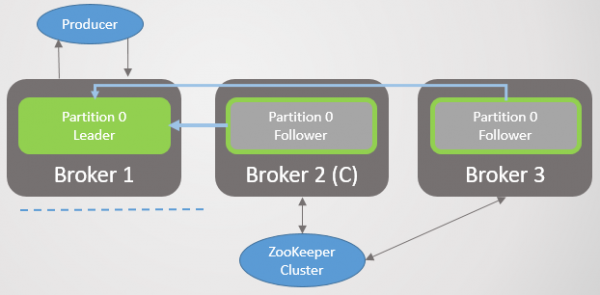
Fig. 28. Scenario 4. Il leader è isolato da Zookeeper
Dopo un po', Zookeeper registrerà il crash del broker e ne informerà il controller. Questi sceglierà un nuovo leader tra i follower. Tuttavia, il leader originale continuerà a pensare di essere il leader e continuerà a ricevere scritture con acks=1. I follower non gli inviano più richieste di polling, quindi li considererà morti e cercherà di comprimere l'ISR fino a se stesso. Ma poiché non ha alcuna connessione con Zookeeper, non sarà in grado di farlo, e a quel punto rinuncerà a ricevere ulteriori scritture.
Messaggi acks=all non riceveranno conferma, perché inizialmente ISR include tutte le repliche, e i messaggi non arrivano a loro. Quando il leader originale cercherà di rimuoverli dall'ISR, non sarà in grado di farlo e smetterà di ricevere qualsiasi messaggio.
I clienti si accorgono presto del cambio di leader e iniziano a inviare registrazioni al nuovo server. Non appena la rete si ripristina, il leader originale vede che non è più il leader e riduce il proprio log al valore HW che aveva il nuovo leader al momento del guasto, per evitare divergenze nei log. In seguito, inizierà a inviare richieste di accesso al nuovo leader. Tutte le registrazioni del leader originale, non replicate al nuovo leader, andranno perse. Ciò significa che andranno persi i messaggi non confermati dal leader originale in quei pochi secondi in cui c'erano due leader.
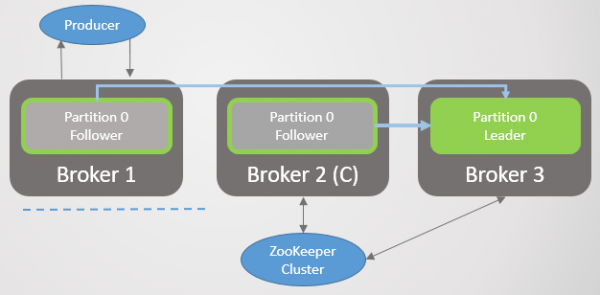
Fig. 29. Scenario 4. Il leader sul broker 1 diventa follower dopo la ripresa della rete
Scenario 5. Il follower è completamente isolato sia dagli altri nodi Kafka che da Zookeeper
Il follower è completamente isolato sia dagli altri nodi Kafka che da Zookeeper. Viene semplicemente rimosso dall'ISR fino a quando la rete non si ripristina, per poi recuperare gli altri.

Fig. 30. Scenario 5. Il follower isolato viene rimosso dall'ISR
Scenario 6. Il leader è completamente isolato sia dagli altri nodi Kafka che da Zookeeper
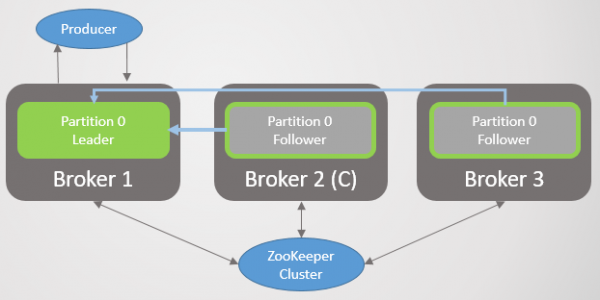
Fig. 31. Scenario 6. Leader e due follower
Il leader è completamente isolato dai suoi follower, dal controller e da Zookeeper. Per un breve periodo continuerà a ricevere registrazioni con acks=1.
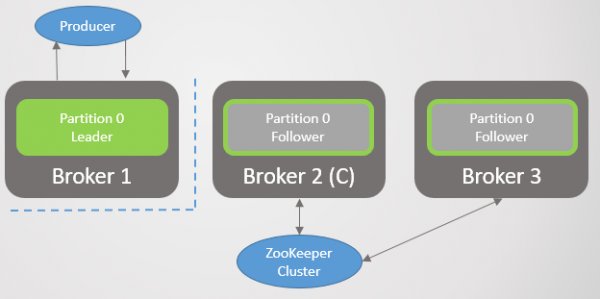
Fig. 32. Scenario 6. Isolamento del leader dagli altri nodi Kafka e Zookeeper
Non ricevendo richieste trascorso replica.lag.time.max.ms, tenterà di comprimere l'ISR fino a se stesso, ma non potrà farlo poiché non c'è connessione con Zookeeper, quindi smetterà di ricevere registrazioni.
Nel frattempo, Zookeeper segnalerà il broker isolato come morto, e il controller sceglierà un nuovo leader.
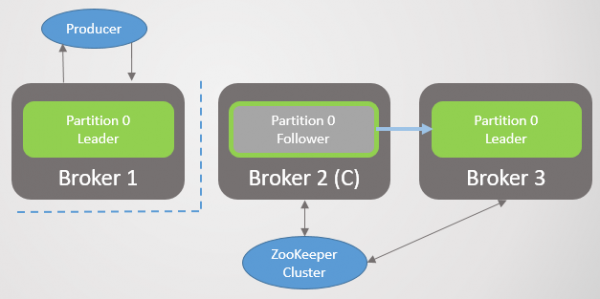
Fig. 33. Scenario 6. Due leader
Il leader originale può ricevere registrazioni per alcuni secondi, ma poi smette di ricevere qualsiasi messaggio. I clienti si aggiornano ogni 60 secondi con gli ultimi metadati. Saranno informati del cambio di leader e inizieranno a inviare registrazioni al nuovo leader.
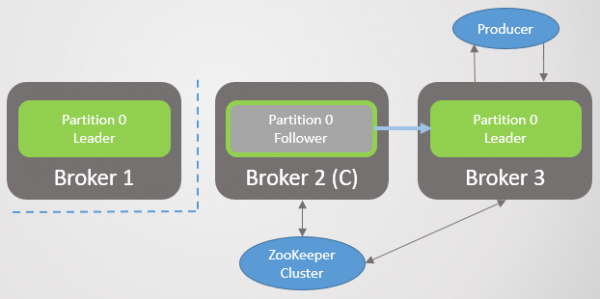
Fig. 34. Scenario 6. I produttori si spostano sul nuovo leader
Tutte le registrazioni confermate fatte dal leader iniziale dal momento della perdita di connettività andranno perse. Una volta ripristinata la rete, il leader iniziale tramite Zookeeper scoprirà di non essere più il leader. Quindi tratterà il suo registro fino all'HW del nuovo leader al momento dell'elezione e inizierà a inviare richieste come follower.
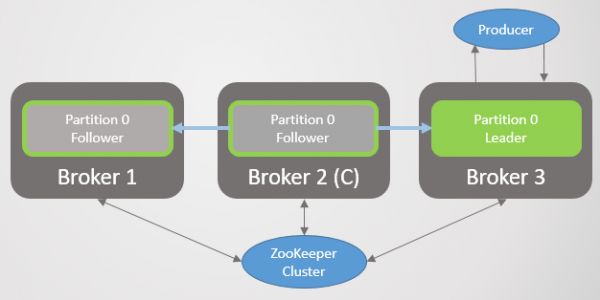
Fig. 35. Scenario 6. Il leader iniziale diventa follower dopo il ripristino della connettività di rete.
In questa situazione, per un breve periodo si può osservare una divisione logica, ma solo se acks=1 e min.insync.replicas anch'essa 1. La divisione logica si conclude automaticamente o dopo il ripristino della rete, quando il leader iniziale si rende conto di non essere più il leader, oppure quando tutti i client comprendono che il leader è cambiato e iniziano a scrivere al nuovo leader, a seconda di ciò che accade prima. In ogni caso ci sarà la perdita di alcuni messaggi, ma solo con acks=1.
C'è un'altra variante di questo scenario, quando direttamente prima della divisione della rete i follower sono rimasti indietro e il leader ha ristretto l'ISR a se stesso. Poi si isola a causa della perdita di connettività. Viene eletto un nuovo leader, ma il leader iniziale continua a ricevere registrazioni, anche acks=all, perché nell'ISR non c'è nessun altro oltre a lui. Queste registrazioni andranno perse dopo il ripristino della rete. L'unico modo per evitare questa variante è min.insync.replicas = 2.
Scenario 7. Il nodo controller Kafka non vede un altro nodo Kafka.
In generale, dopo la perdita di connessione con un nodo Kafka, il controller non sarà in grado di inviare alcuna informazione riguardante il cambio di leader. Nel peggiore dei casi, ciò porterà a una breve divisione logica, come nello scenario 6. Nella maggior parte dei casi, il broker non diventerà semplicemente un candidato alla leadership in caso di fallimento dell'ultimo.
Scenario 8. Il controller Kafka non vede Zookeeper.
Dallo Zookeeper isolato, il controller non riceverà ping e sceglierà un nuovo nodo Kafka come controller. Il controller originale può continuare a presentarsi come tale, ma non riceve notifiche da Zookeeper, quindi non avrà compiti da svolgere. Una volta ripristinata la rete, capirà di non essere più un controller, ma di essere diventato un nodo Kafka normale.
Conclusioni sugli scenari
Osserviamo che la perdita di connessione dei follower non porta alla perdita di messaggi, ma riduce temporaneamente la ridondanza finché la rete non si ripristina. Questo, ovviamente, può causare la perdita di dati se uno o più nodi vengono persi.
Se a causa della perdita di connessione il leader si disconnette da Zookeeper, questo può portare alla perdita di messaggi con acks=1. La mancanza di connessione a Zookeeper causa una temporanea divisione logica con due leader. Questo problema è risolvibile tramite il parametro acks=all.
Parametro min.insync.replicas in due o più repliche fornisce garanzie aggiuntive che tali scenari a breve termine non porteranno alla perdita di messaggi, come nel caso 6.
Riepilogo sulla perdita di messaggi
Elenciamo tutti i modi in cui è possibile perdere dati in Kafka:
- Qualsiasi guasto del leader, se i messaggi sono stati confermati tramite acks=1
- Qualsiasi passaggio di leadership sporco (unclean), quindi su un follower al di fuori dell'ISR, anche con acks=all
- Isolamento del leader da Zookeeper, se i messaggi sono stati confermati tramite acks=1
- Isolamento totale del leader, che ha già ridotto il gruppo ISR a se stesso. Verranno persi tutti i messaggi, anche acks=all. Questo è vero solo se min.insync.replicas=1.
- Guasti simultanei di tutti i nodi della partizione. Poiché i messaggi vengono confermati dalla memoria, alcuni potrebbero non essere ancora stati registrati su disco. Dopo il riavvio dei server, potrebbero mancare alcuni messaggi.
I passaggi di leadership sporchi possono essere evitati, sia vietandoli sia garantendo almeno una ridondanza di due. La configurazione più robusta è una combinazione di acks=all e min.insync.replicas superiore a 1.
Confronto diretto tra l'affidabilità di RabbitMQ e Kafka
Per garantire affidabilità e alta disponibilità, entrambe le piattaforme implementano un sistema di replica primaria e secondaria. Tuttavia, RabbitMQ ha un punto debole. Quando si riconnettono dopo un guasto, i nodi scartano i loro dati e la sincronizzazione viene bloccata. Questo doppio colpo mette in discussione la longevità delle grandi code in RabbitMQ. Dovrai accontentarti di una riduzione della ridondanza o di lunghi blocchi. La riduzione della ridondanza aumenta il rischio di una massiccia perdita di dati. Ma se le code sono piccole, la ridondanza con brevi periodi di inattività (qualche secondo) può essere gestita attraverso tentativi di riconnessione.
In Kafka non esiste questo problema. Scarta i dati solo dal punto di divergenza tra il leader e il follower. Tutti i dati comuni vengono mantenuti. Inoltre, la replica non blocca il sistema. Il leader continua ad accettare registrazioni mentre il nuovo follower lo raggiunge, rendendo l'aggiunta o il reinserimento del cluster un compito banale per gli sviluppatori DevOps. Certo, ci sono ancora problemi come la larghezza di banda di rete durante la replica. Se vengono aggiunti più follower contemporaneamente, si può incontrare il limite della larghezza di banda.
RabbitMQ supera Kafka in affidabilità nel caso di guasti simultanei di più server nel cluster. Come già detto, RabbitMQ invia una conferma al publisher solo dopo che il messaggio è stato scritto su disco dal master e da tutti i mirror. Ma questo aggiunge una latenza aggiuntiva per due motivi:
- fsync ogni poche centinaia di millisecondi
- I guasti dei mirror possono essere rilevati solo trascorrendo il tempo di vita dei pacchetti che controllano la disponibilità di ciascun nodo (net tick). Se un mirror rallenta o è caduto, ciò aggiunge latenza.
Kafka punta sul fatto che se un messaggio è memorizzato su più nodi, i messaggi possono essere confermati non appena arrivano in memoria. Questo comporta il rischio di perdita di messaggi di qualsiasi tipo (anche acks=all, min.insync.replicate=2) in caso di guasto simultaneo.
In generale, Kafka dimostra prestazioni più elevate e inizialmente è progettato per cluster. Il numero di follower può aumentare fino a 11, se necessario per l'affidabilità. Un rapporto di replica di 5 e il numero minimo di repliche in stato sincronizzato min.insync.replicas=3 renderanno la perdita di messaggi un evento molto raro. Se la tua infrastruttura è in grado di garantire tale rapporto di replica e livello di ridondanza, puoi scegliere questa opzione.
La clusterizzazione di RabbitMQ è buona per piccole code. Ma anche piccole code possono crescere rapidamente con un alto volume di traffico. Una volta che le code diventano grandi, sarà necessario fare una scelta difficile tra disponibilità e affidabilità. La clusterizzazione di RabbitMQ è più adatta a situazioni non comuni, dove i vantaggi della flessibilità di RabbitMQ superano eventuali svantaggi della sua clusterizzazione.
Uno dei rimedi per la vulnerabilità di RabbitMQ riguardo alle code di grandi dimensioni è suddividerle in molteplici più piccole. Se non è necessario mantenere un ordinamento completo di tutta la coda, ma solo dei messaggi rilevanti (ad esempio, messaggi di un cliente specifico), oppure non ordinare affatto, questa soluzione è accettabile: dai un'occhiata al mio progetto per suddividere la coda (il progetto è ancora in fase iniziale).
Infine, non dimenticate una serie di bug nei meccanismi di clustering e replica sia di RabbitMQ che di Kafka. Con il tempo, i sistemi sono diventati più maturi e stabili, ma nessun messaggio sarà mai completamente protetto dalla perdita! Inoltre, nei data center si verificano eventi catastrofici su vasta scala!
Se ho trascurato qualcosa, commesso errori o non siete d'accordo con uno qualsiasi dei punti, non esitate a lasciare un commento o a contattarmi.
Mi viene spesso chiesto: «Cosa scegliere, Kafka o RabbitMQ?», «Quale piattaforma è migliore?». La verità è che dipende davvero dalla vostra situazione, dall'esperienza attuale, ecc. Non mi sento di esprimere un'opinione, poiché sarebbe un'eccessiva semplificazione raccomandare una piattaforma unica per tutti gli usi e le possibili limitazioni. Ho scritto questo ciclo di articoli affinché possiate formarvi un'opinione personale.
Voglio dire che entrambi i sistemi sono leader in questo campo. Forse sono un po' di parte, perché per esperienza nei miei progetti tendo a valutare di più aspetti come l'ordinamento garantito dei messaggi e l'affidabilità.
Vedo altre tecnologie che mancano di questa affidabilità e di un ordinamento garantito, poi guardo a RabbitMQ e Kafka — e comprendo l'incredibile valore di entrambi questi sistemi.
Fonte: habr.com
