

A Chelyabinsk si tengono i meet-up degli amministratori di sistema Sysadminka, e nell'ultimo di essi ho tenuto una relazione sulla nostra soluzione per far funzionare le applicazioni su 1C-Bitrix in Kubernetes.
Bitrix, Kubernetes, Ceph: una miscela eccellente?
Vi racconterò come abbiamo raccolto tutto questo in una soluzione funzionante.
Andiamo!
Il meet-up si è svolto il 18 aprile a Chelyabinsk. Potete leggere dei nostri meet-up su e guardarli su .
Se volete venire da noi con una presentazione o come ascoltatore — siete i benvenuti, scrivete a vadim.isakanov@gmail.com e su Telegram t.me/vadimisakanov.
La mia relazione
Soluzione 'Bitrix in Kubernetes, versione Southbridge 1.0'
Parlerò della nostra soluzione in un formato 'per principianti in Kubernetes', come è stato presentato nel meet-up. Ma presumo che conoscete già i termini Bitrix, Docker, Kubernetes e Ceph, almeno a livello di articoli su Wikipedia.
Cosa c'è di già pronto per Bitrix in Kubernetes?
Su tutta Internet ci sono pochissime informazioni sul funzionamento delle applicazioni su Bitrix in Kubernetes.
Ho trovato solo questi materiali:
Relazione di Aleksandr Serbul, 1C-Bitrix, e Anton Tuzlukov di Qsoft:
Ve lo consiglio.
Sviluppo di una propria soluzione dal punto di vista dell'utente .
Ho trovato anche .
E insomma, tutto qui.
Avviso che non abbiamo verificato la qualità delle soluzioni nei link sopra 🙂
A proposito, durante la preparazione della nostra soluzione ho parlato con Aleksandr Serbul, e all'epoca la sua relazione non era ancora disponibile, quindi nelle mie slide c'è un punto 'Bitrix non utilizza Kubernetes'.
Tuttavia, esistono già molti immagini Docker pronte per utilizzare Bitrix in Docker:
È sufficiente questo per creare una soluzione completa per Bitrix in Kubernetes?
No. Ci sono molti problemi da risolvere.
Quali sono i problemi con Bitrix in Kubernetes?
Il primo: le immagini pronte da Dockerhub non sono adatte per Kubernetes.
Se vogliamo costruire un'architettura a microservizi (e in Kubernetes di solito vogliamo farlo), l'applicazione in Kubernetes deve essere divisa in contenitori, e bisogna garantirsi che ogni contenitore svolga una piccola funzione (e la faccia bene). Perché solo una? In breve, più è semplice, più è affidabile.
Se volete approfondire, per favore guardate questo articolo e video:
Le immagini Docker su Dockerhub sono principalmente costruite secondo il principio 'tutto in uno', quindi abbiamo dovuto comunque inventare la nostra bicicletta e persino creare le immagini da zero.
Il secondo: il codice del sito viene modificato dalla dashboard di amministrazione.
Abbiamo creato una nuova sezione sul sito: il codice è stato aggiornato (è stata aggiunta una directory con il nome della nuova sezione).
Abbiamo modificato le proprietà del componente dal pannello di amministrazione: il codice è cambiato.
Kubernetes «di default» non sa lavorare così, i contenitori devono essere immutabili (Stateless).
Motivo: ogni contenitore (pod) nel cluster gestisce solo una parte del traffico. Se si modifica il codice solo in un contenitore (pod), il codice sarà diverso in diversi pod, il sito funzionerà in modo diverso, diversi utenti vedranno diverse versioni del sito. Non si può vivere così.
Terzo: bisogna risolvere la questione del deployment.
Se abbiamo un monolite e un server «classico», è tutto molto semplice: implementiamo una nuova base di codice, eseguiamo la migrazione del DB, dirottiamo il traffico sulla nuova versione del codice. Il passaggio avviene istantaneamente.
Se il nostro sito è in Kubernetes, suddiviso in microservizi, i contenitori con il codice sono molti: oh. Bisogna assemblare i contenitori con la nuova versione del codice, deployarli al posto dei precedenti, eseguire correttamente la migrazione del DB, e idealmente farlo in modo invisibile per i visitatori. Per fortuna, in questo Kubernetes ci aiuta, supportando una moltitudine di diversi tipi di deployment.
Quarto: bisogna risolvere la questione dell'archiviazione della staticità.
Se il tuo sito pesa «solo» 10 gigabyte e decidi di deployarlo completamente in contenitori, otterrai contenitori dal peso di 10 gigabyte, che verranno deployati per un'eternità.
È necessario conservare le parti «più pesanti» del sito al di fuori dei contenitori, e sorge la questione di come farlo correttamente.
Cosa non è presente nella nostra soluzione.
Tutto il codice di Bitrix non è suddiviso in microfunzioni/microservizi (in modo tale che la registrazione sia separata, il modulo del negozio online separato, ecc.). Conserviamo l'intera base di codice in ciascun contenitore.
Non archiviamo il database in Kubernetes (anche se ho implementato soluzioni con il database in Kubernetes per gli ambienti di sviluppo, ma non per la produzione).
Gli amministratori del sito noteranno che il sito funziona in Kubernetes. La funzione «verifica sistema» non funziona correttamente, per modificare il codice del sito dal pannello di amministrazione è necessario prima cliccare sul pulsante «voglio modificare il codice».
Abbiamo identificato i problemi e la necessità di implementare la microservizi. L'obiettivo è chiaro: creare un sistema operativo per le applicazioni su Bitrix in Kubernetes, mantenendo sia le funzionalità di Bitrix che i vantaggi di Kubernetes. Iniziamo l'implementazione.
Architettura
Molti pod 'worker' con server web.
Un pod con attività cron (obbligatorio solo uno).
Un pod di aggiornamento per modificare il codice del sito dalla dashboard (anche questo soltanto uno è obbligatorio).
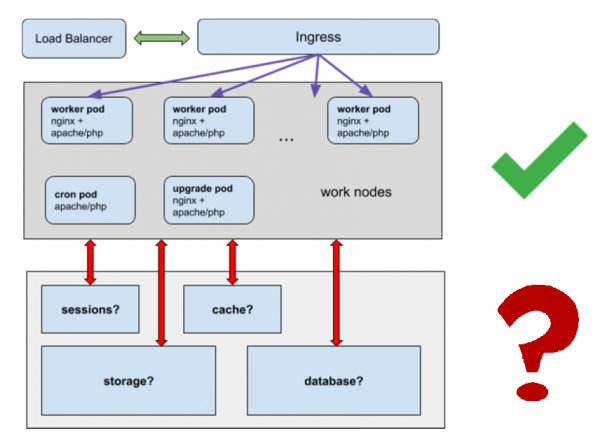
Affrontiamo le seguenti questioni:
- Dove memorizzare le sessioni?
- Dove memorizzare la cache?
- Dove memorizzare la statica, non possiamo mettere gigabyte di statica in una moltitudine di contenitori?
- Come funzionerà il database?
Immagine Docker
Iniziamo costruendo l'immagine Docker.
L'opzione ideale è avere un'unica immagine universale, sulla quale otteniamo sia i pod worker, sia i pod con cron job, sia i pod di aggiornamento.
.
Include nginx, apache/php-fpm (puoi scegliere durante la costruzione), msmtp per l'invio di email e cron.
Durante la costruzione dell'immagine, l'intera base di codice del sito viene copiata nella directory /app (eccezion fatta per le parti che sposteremo in uno storage condiviso separato).
Microservizi, servizi
Pod worker:
- Contenitore con nginx + contenitore apache/php-fpm + msmtp
- Non siamo riusciti a separare msmtp in un microservizio differente, Bitrix inizia a lamentarsi perché non riesce a inviare email direttamente.
- In ogni contenitore c'è l'intera base di codice.
- Divieto di modificare il codice nei contenitori.
Pod cron:
- Contenitore con apache, php, cron
- Include l'intera base di codice
- Divieto di modificare il codice nei contenitori
Pod di aggiornamento:
- Contenitore con nginx + contenitore apache/php-fpm + msmtp
- Non ci sono divieti di modifica del codice nei contenitori
Storage delle sessioni
Storage della cache di Bitrix
È importante: le password per l'accesso a tutto, dal database alla posta, vengono memorizzate nei segreti di Kubernetes. Otteniamo un vantaggio: le password sono visibili solo a coloro ai quali diamo accesso ai segreti, e non a tutti quelli che hanno accesso alla base di codice del progetto.
Storage per la statica
È possibile utilizzare qualsiasi cosa: ceph, nfs (ma non raccomandiamo nfs per la produzione), storage di rete da fornitori 'cloud', ecc.
Lo storage dovrà essere connesso nei contenitori nella directory /upload/ del sito e in altre directory con la statica.
Qui la scelta è stata molto più semplice, Simple SCADA offre due prodotti da utilizzare: MS SQL Server e MySQL. Il secondo mi è sembrato più vicino, poiché avevo già lavorato con esso, quindi mi sono fermato lì.
Per semplificare, raccomandiamo di estrarre il database al di fuori di Kubernetes. Un database in Kubernetes è un compito complesso e rende lo schema molto più difficile.
Storage delle sessioni
Utilizziamo memcached 🙂
Gestisce bene la memorizzazione delle sessioni, si clusterizza e viene supportato "nativamente" come session.save_path in php. Questo sistema è stato ben collaudato nella classica architettura monolitica, quando costruivamo cluster con un gran numero di server web. Per il deploy utilizziamo helm.
$ helm install stable/memcached --name sessionphp.ini — qui nell'immagine sono impostate le configurazioni per la memorizzazione delle sessioni in memcached
Abbiamo utilizzato le Environment Variables per trasmettere i dati sugli host di memcached .
Questo consente di utilizzare lo stesso codice negli ambienti dev, stage, test, prod (i nomi degli host di memcached in essi saranno diversi, quindi per ogni ambiente dobbiamo fornire un nome host unico per le sessioni).
Cache store di Bitrix
Abbiamo bisogno di uno storage resiliente in cui tutti i pod possano scrivere e da cui possano leggere.
Utilizziamo anche memcached.
Questa soluzione è raccomandata da Bitrix stesso.
$ helm install stable/memcached --name cachebitrix/.settings_extra.php — qui in Bitrix viene specificato dove abbiamo la cache
Utilizziamo anche le Environment Variables.
Cron jobs
Ci sono vari approcci all'esecuzione di cron jobs in Kubernetes.
- un deployment separato con un pod per l'esecuzione dei cron jobs
- cronjob per eseguire i cron jobs (se è un'app web — con wget , o kubectl exec all'interno di uno dei pod worker, ecc.)
- ecc.
Si può discutere su quale sia il più corretto, ma in questo caso abbiamo scelto l'opzione "deployment separato con pod per cron jobs"
Come è stato fatto:
- aggiungiamo i cron jobs tramite ConfigMap oppure attraverso il file config/addcron
- in un'istanza eseguiamo il container, identico al pod worker + consentiamo l'esecuzione dei cron jobs in esso
- viene utilizzato lo stesso codice sorgente, grazie all'unificazione la costruzione del container è semplice
Cosa otteniamo di buono:
- abbiamo cron jobs funzionanti in un ambiente identico a quello degli sviluppatori (docker)
- i cron jobs non devono essere "riscritti" per Kubernetes, funzionano così come sono e nella stessa codebase di prima
- i cron jobs possono essere aggiunti da tutti i membri del team con diritti di commit nel branch di produzione, non solo dagli admin
Modulo Southbridge K8SDeploy e modifica del codice dalla dashboard di amministrazione
Ne abbiamo parlato dell'upgrade del pod?
E come indirizzare il traffico lì?
Evviva, abbiamo scritto un modulo per questo in php 🙂 È un piccolo modulo classico per Bitrix. Non è ancora disponibile pubblicamente, ma intendiamo renderlo accessibile.
Il modulo è installato come un normale modulo in Bitrix:
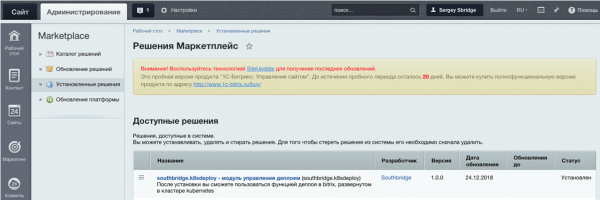
E appare in questo modo:
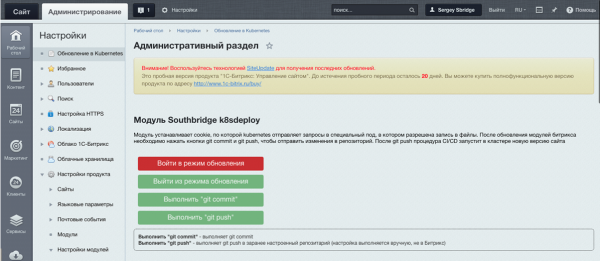
Permette di impostare un cookie che identifica l'amministratore del sito e consente a Kubernetes di inviare traffico al pod di upgrade.
Quando le modifiche sono complete, è necessario premere git push; le modifiche al codice verranno inviate a git, e successivamente il sistema compilerà un'immagine con la nuova versione del codice e la distribuirà nel cluster, sostituendo i vecchi pod.
Sì, un po' macchinoso, ma in questo modo manteniamo l'architettura microservizi e non togliamo agli utenti di Bitrix la possibilità di modificare il codice dall'amministratore. Dopotutto, questa è un'opzione; possiamo risolvere la modifica del codice in un altro modo.
Chart Helm
Per compilare applicazioni in Kubernetes, di solito utilizziamo il gestore di pacchetti Helm.
Per la nostra soluzione Bitrix in Kubernetes, Sergey Bondarev, il nostro principale amministratore di sistema, ha scritto un chart Helm speciale.
Questo gestisce la costruzione dei worker, degli upgrade, dei cron pod, configura ingress, servizi, e trasmette variabili dai segreti di Kubernetes ai pod.
Conserviamo il codice in Gitlab, e anche la costruzione di Helm viene avviata da Gitlab.
In breve, appare così
$ helm upgrade --install project .helm --set image=registrygitlab.local/k8s/bitrix -f .helm/values.yaml --wait --timeout 300 --debug --tiller-namespace=productionHelm consente anche di effettuare un rollback "senza soluzione di continuità" nel caso in cui qualcosa vada storto durante il deployment. È piacevole sapere che non ti trovi in panico a "sistemare il codice via ftp perché il prod è andato giù", mentre Kubernetes lo fa automaticamente e senza downtime.
Deploy
Sì, siamo fan di Gitlab & Gitlab CI, lo utilizziamo 🙂
Quando si effettua un commit in Gitlab nel repository del progetto, Gitlab avvia una pipeline che implementa il rilascio della nuova versione dell'ambiente.
Fasi:
- build (creiamo una nuova immagine Docker)
- test (testiamo)
- clean up (rimuoviamo l'ambiente di test)
- push (inviamo l'immagine al Docker registry)
- deploy (distribuiamo l'applicazione in Kubernetes tramite Helm).
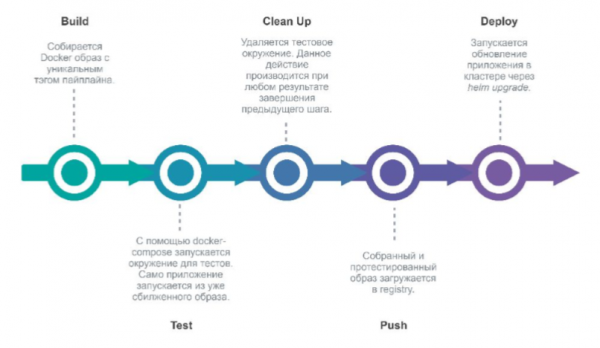
Evvi, fatto, implementiamo!
Oppure poniamo domande, se ci sono.
Quindi, cosa abbiamo fatto
Dal punto di vista tecnico:
- abbiamo dockerizzato Bitrix;
- "abbiamo suddiviso" Bitrix in contenitori, ciascuno con funzioni minime;
- abbiamo raggiunto uno stato stateless per i contenitori;
- abbiamo risolto il problema con l'aggiornamento di Bitrix in Kubernetes;
- tutte le funzionalità di Bitrix hanno continuato a funzionare (quasi tutte);
- abbiamo completato il deployment in Kubernetes e il rollback tra le versioni.
Dal punto di vista aziendale:
- tolleranza ai guasti;
- strumenti Kubernetes (integrazione semplice con Gitlab CI, deployment senza soluzione di continuità, ecc.);
- le password sono nei segreti (visibili solo a coloro a cui è stato specificamente concesso l'accesso alle password);
- è comodo creare ambienti aggiuntivi (per sviluppo, test, ecc.) all'interno di un'unica infrastruttura.
Fonte: habr.com
