

Mi chiamo Yuri, sono il responsabile del gruppo di amministrazione di sistema in SitiMobil. Oggi condividerò la mia esperienza con la tecnologia di thin provisioning dei file system Linux e spiegherò come può essere applicata nei processi CI/CD tecnologici dell'azienda. Analizzeremo la situazione in cui, per il test automatico del codice durante la consegna in produzione, abbiamo bisogno il prima possibile di copie del database MySQL, il più simili possibile alla versione "live", disponibili per la lettura e la scrittura.
Introduzione: perché dare consigli dannosi?
È una domanda legittima, poiché esistono meccanismi collaudati per le migrazioni degli schemi del database negli ambienti di test. Perché portare un database relazionale principale non sharded a tali volumi? E per il testing non sono necessari tutti i dati. Cercherò di spiegare.
Circa un anno fa, a causa della rapida crescita del nostro aggregatore taxi (nel 2018 siamo aumentati di circa 15 volte in base alle corse completate), sono aumentati i volumi di dati, il carico sui server e la frequenza dei deploy. Ci siamo trovati nella seguente situazione:
- Il database MySQL principale è aumentato a circa 1000 tabelle con un volume totale di 2,5 TB e continuava a crescere.
- Non c'era la possibilità di sharding rapido e di distribuire il database. Questo non era possibile a causa del vecchio approccio "scrivo nel database quello che voglio e come voglio", con un sacco di JOIN e dipendenze interne tra le tabelle.
- Non c'era un meccanismo per migrare lo schema del database negli ambienti di test.
- Non c'era testing automatico del codice durante il deploy in produzione.
L'ultimo problema volevo risolverlo il prima possibile. Erano già stati scritti test Postman per verificare il principale monolite PHP, ma mancava un database aggiornato. Allo stesso tempo, non potevamo creare di notte una replica, farla diventare master e metterla a disposizione durante il giorno: il numero molto elevato di deploy e modifiche, inclusi i dati e lo schema del database, avrebbe reso l'ambiente non funzionante già a metà giornata. Inoltre, limitare i deploy solo a ore lavorative sarebbe stato inefficace.
Tuttavia, il compito è stato svolto: abbiamo ottenuto il primo ambiente di produzione operativo già dopo due settimane. Nel corso dell'anno passato ha subito molte modifiche e continua ad essere utilizzato.
Di seguito descriverò nei dettagli tutti i passaggi e le fasi di sviluppo della nostra soluzione. Vi renderete conto che questo metodo merita di esistere.
Che cos'è il "thin provisioning"?
Questa è una tecnologia hardware o software (altra denominazione — volumi sparsi), che permette di allocare una maggiore quantità di risorse richieste rispetto a quelle disponibili. L'allocazione deve soddisfare i criteri just-enough (quanto basta) e just-in-time (nel tempo necessario). Fondamentalmente, il thin provisioning è utilizzato in vari sistemi di archiviazione, al fine di fornire spazio su disco in volumi necessari che superano quelli effettivamente disponibili. La tecnologia è supportata da vari file system, ad esempio, LVM2, ZFS, BTRFS. È ampiamente utilizzata negli hypervisor di virtualizzazione. Il thin provisioning ci ha permesso di creare rapidamente quante più copie di una partizione principale dati dal suo snapshot, quanto necessario (directory dati del DBMS MySQL).
Primo stand, tecnologia Thin LVM
Questa sezione può essere anche intitolata "Come realizzare snapshot estremamente veloci di grandi volumi di dati usando , riducendo la stabilità del file system e del DBMS MySQL a livelli inaccettabili."
Poiché avevamo già utilizzato LVM per costruire le partizioni principali del sistema operativo, abbiamo deciso di partire proprio da essa. Per iniziare, avevamo bisogno di una macchina fisica separata — una replica del nostro database MySQL principale, su cui potevamo creare snapshot della replica su richiesta e avviarlo come una istanza separata di MySQL. Durante il periodo di test, abbiamo consentito operazioni modificanti su questa istanza, e al termine dei test l'abbiamo eliminata con successo. La configurazione del server era la seguente:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD in RAID-controller Adaptec in RAID-10
Potremmo scrivere un articolo separato sulla scelta tra un controller RAID e un RAID software MD. Dico solo che la nostra scelta è stata influenzata da due fattori:
- All'epoca in cui abbiamo posto la questione, installavamo tutti i DBMS su controller RAID, quindi si può dire che è stata una scelta storica.
- La differenza di performance nei test sintetici del file system e nei test con varie operazioni in MySQL era minima.
Abbiamo suddiviso il RAID-10 ottenuto: abbiamo creato un'unica Volume Group (VG) per l'intero volume (con costi aggiuntivi di circa 6,7 GB) e abbiamo creato una partizione logica (Logical Volume, LV) per il sistema di 50 GB. In una situazione normale, riserviamo il resto dello spazio per la partizione con MySQL. Ma avevamo bisogno di un'allocazione fine, quindi inizialmente abbiamo creato un pool, all'interno del quale abbiamo creato una partizione per /var/lib/mysql di 3,5 TB (basata sulle dimensioni previste del DB):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Abbiamo formattato la partizione in ext4, l'abbiamo montata, abbiamo scritto una replica e ottenuto l'ambiente iniziale. Poi abbiamo creato un'API che deve generare snapshot, avviare un'istanza di MySQL su una porta specifica e rimuovere l'istanza creata. Poiché utilizziamo esclusivamente chiamate di sistema, abbiamo scelto come linguaggio per la scrittura degli script il bash ordinario, e per la connessione API HTTP → bash abbiamo implementato una soluzione open source. , scritta in Go.
Un giorno pubblicheremo i nostri script bash in open source, ma per ora descriverò semplicemente l'algoritmo principale:
Creazione dello snapshot principale snapmain:
- Fermiamo la replica principale.
- Imponiamo un blocco sulle operazioni con lo snapshot snapmain.
- Creiamo un nuovo snapshot snapmain.
- Avviamo MySQL e rimuoviamo il blocco.
Creazione di un DB su una porta arbitraria da snapmain:
- Imponiamo un blocco su un'istanza specifica di DB (porta).
- Controlliamo se esiste un blocco per la creazione dello snapshot principale. Se esiste, attendiamo e ricontrolliamo ogni 5 secondi.
- Controlliamo se esiste una vecchia partizione LV dell'istanza.
3.1 Se esiste, fermiamo l'istanza di MySQL usando kill -9 e rimuoviamo la partizione LV. - Creiamo una nuova istanza da snapmain.
- Prepariamo e montiamo le directory per questa istanza.
- Rimuoviamo i segni di slave (file) e avviamo l'istanza di MySQL.
- La rendiamo master.
- Rimuoviamo il blocco.
Cancellazione del DB su una porta arbitraria:
- Imponiamo un blocco su un'istanza specifica di DB (porta).
- Terminare l'istanza di MySQL usando kill -9.
- Smontiamo le directory.
- Rimuoviamo la partizione LV e rimuoviamo il blocco.
Esempio di comandi per clonare le partizioni della nuova istanza di DB:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Ora vi parlerò del problema principale che abbiamo incontrato utilizzando il thin provisioning. Ci siamo scontrati con le prestazioni degli SSD. Questo è successo a causa delle caratteristiche del Thin LVM: funziona fondamentalmente a livello di dispositivo con chunk a basso livello di default da 4 MB. Ecco come si presentava:
- Creiamo uno snapshot dalla partizione principale /var/lib/mysql.
- Avviamo la replica per recuperare il master.
- Qualsiasi modifica nelle tabelle della replica costringe a mantenere i vecchi chunk di dati invariati nella sezione dello snapshot.
- Qualsiasi modifica nell'esemplare di test attivo costringe a mantenere i vecchi chunk di dati invariati nella sezione dello snapshot clonato per questo esemplare.
- Otteniamo un carico di operazioni di input-output al 100% sul dispositivo, un rallentamento di qualsiasi operazione e un progressivo distacco della replica.
- Alla fine della giornata lavorativa abbiamo un'istanza in ritardo di diverse ore.
Come abbiamo affrontato questo per ottenere un risultato più ragionevole (punti principali):
Controller RAID:
- Abbiamo disattivato tutte le forme di caching di default.
- Abbiamo impostato il writeback (quando i dati vengono memorizzati nel buffer, la scrittura termina prima che il salvataggio effettivo su disco venga eseguito).
File system:
- Nel punto di montaggio /var/lib/mysql abbiamo indicato noatime,nodiratime,data=writeback
- Abbiamo disattivato il journaling ext4 con tune2fs.
MySQL:
- Abbiamo specificato innodb_flush_method = O_DSYNC (aumentando la velocità di scrittura, aumentando così l'affidabilità).
- Abbiamo disattivato il journaling, non ci servono i log.
- Abbiamo specificato innodb_buffer_pool_size = 4G (minore è la dimensione del pool InnoDB, più velocemente MySQL si fermerà al momento dell'arresto e più rapidamente creeremo lo snapshot).
Questa non è affatto una lista completa, specialmente per MySQL. Tuttavia, le altre modifiche sono minori e spesso non applicabili sempre e in modo preciso. Ad esempio, nel tentativo di alleggerire i dischi, abbiamo persino spostato innodb_parallel_doublewrite_path in /dev/shm, il che in alcuni casi, in fase di avvio di un'istanza non terminata correttamente, ci ha fatto risparmiare fino a 5 secondi.
Perché fermiamo MySQL prima di fare uno snapshot? Infatti, possiamo scattarlo da una replica in esecuzione. È vero, solo che il nuovo esemplare del DB su questo snapshot sarà considerato danneggiato di default e richiederà una scansione completa all'avvio. Fermare la replica è sicuramente più veloce, anche se alla fine risulta essere l'operazione più lunga dell'intero processo.
Di conseguenza, abbiamo ottenuto tempistiche più accettabili e uno stand pronto all'uso. Tuttavia, come si può vedere dall'eloquente grafico dei ritardi di replicazione della replica principale, la situazione è ancora lontana dall'ideale:
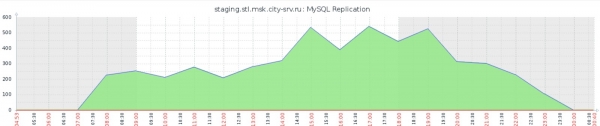
Tra gli altri svantaggi, va segnalata la quasi impossibilità di monitorare il pool Thin LVM: oltre alle funzioni standard di sistema come iostat, è impossibile capire, ad esempio, quale elemento del pool sta attualmente causando il maggiore carico sul file system.
Vale la pena evidenziare un grande svantaggio legato all'ottimizzazione sopra descritta: abbiamo ottenuto uno stand YOLO. Circa una volta ogni uno-due mesi, ext4 non riusciva a sopportare tali maltrattamenti e si guastava in modo irreversibile, richiedendo una riformattazione e un nuovo caricamento della replica. Guadagnando in velocità, abbiamo compromesso irrimediabilmente la stabilità.
Quali metriche tenere sotto controllo durante l'uso di Thin LVM:
- Percentuale di dati del pool thin
- Percentuale di metadati del pool thin
Se il nostro stand riesce a sopravvivere all'esaurimento dello spazio per i dati (è sufficiente pulire i dischi), l'esaurimento dello spazio per i metadati porterà a un completo collasso del pool e alla necessità di ricrearlo da zero.
Il file system all'interno del pool si frammenta notevolmente nel tempo. Raccomando di eseguire quotidianamente il comando tramite cron fstrim -v /var/lib/mysql.
Resoconto intermedio:
- La tecnologia è facilmente applicabile, così come l'LVM stesso, e non richiede competenze particolari da parte dell'ingegnere.
- È adatta a database di piccole dimensioni e non eccessivamente caricati. Più il database è piccolo, meno chunk vengono spostati nel file system all'interno del pool, e minore è il carico sui dischi.
- Per il nostro compito abbiamo iniziato a cercare altre soluzioni, di cui parleremo nel prossimo capitolo.
Secondo stand, tecnologia ZFS
Molto tempo fa ho avuto a che fare con il file system ZFS, ma all'epoca ZFS funzionava bene sul suo sistema operativo nativo Solaris. Esisteva una versione portata su FreeBSD con un livello di implementazione abbastanza buono. C'era anche un port incompleto su Linux, che era poco utilizzato. A causa della struttura di archiviazione dei dati B-tree (che è anche la stessa struttura utilizzata da InnoDB MySQL) ZFS ha mostrato prestazioni scarse in installazioni con un numero molto elevato di file. Tutto ciò, insieme alla necessità di approfondire la materia prima di utilizzarlo, ha fatto sì che questo file system fosse escluso dalla mia pratica per lungo tempo. Sono emersi ext4 e xfs, che sono diventati lo standard. Tuttavia, considerando che ZFS si adatta perfettamente al nostro compito e dato che la versione Linux, secondo le recensioni, è cresciuta in un prodotto del tutto ragionevole (anche se non completamente supportato, il che significa che è possibile installare ZFS da zero solo con vari rituali), abbiamo deciso di provarlo.
Per motivi comprensibili, abbiamo scelto un banco di prova con una configurazione analoga (eccetto il controller RAID). Abbiamo installato otto dischi SSD da 1920 GB. Non c'era voglia di scrivere la propria immagine di rete per caricare il server su ZFS puro, quindi abbiamo tolto 50 GB da ogni disco e creato un MD RAID-10 per il sistema. I restanti 1950 GB di ogni disco sono stati uniti in un equivalente ZFS di RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Abbiamo creato partizioni per MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Nota che abbiamo attivato la compressione dei dati gzip standard. Abbiamo molte risorse di elaborazione sul server e non sono completamente utilizzate. Di conseguenza, 3 TB del nostro DB si sono trasformati in 1,6 TB e poiché il collo di bottiglia, come nel caso precedente, è la massima prestazione dei dischi, meno dati abbiamo, meglio è; fin dall'inizio otteniamo un ottimo vantaggio da ZFS! Durante i picchi, il mantenimento del gzip richiede fino a 4 core, ma non ci dispiace.
Successivamente, l'implementazione è andata più velocemente. Abbiamo trasferito in modo identico le impostazioni della replica MySQL dal banco di prova LVM. Abbiamo dovuto spendere un po' di tempo per riscrivere gli script con i comandi ZFS, ma in generale gli algoritmi sono rimasti gli stessi. Ecco un esempio di creazione di uno snapshot:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
Dalla messa a punto aggiuntiva: abbiamo trasferito in memoria le partizioni ZFS con i metadati e i log l2arc e zil. Per il nostro compito, come si è rivelato successivamente, era superfluo, ma per ora abbiamo mantenuto questa ottimizzazione; cambiarla in futuro non è difficile. Tra gli effetti negativi c'è il fatto che dopo il riavvio del server è necessario ricreare le aree di memoria corrispondenti. I dati non vengono persi. Estratto di zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
In questa configurazione abbiamo iniziato a testare il banco e abbiamo ottenuto risultati eccellenti: con due istanze di DB funzionanti simultaneamente (e una replica principale attiva) sui snapshot, abbiamo ottenuto un utilizzo dei dischi del 50-60%.
Abbiamo risolto il nostro problema principale, come si può vedere nel grafico del ritardo della replicazione (confronta con il grafico precedente nella sezione Thin LVM):
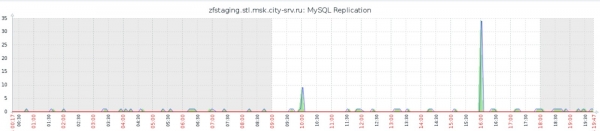
Oltre a questo, grazie a ciò, abbiamo notevolmente accelerato tutte le operazioni: la creazione completa di uno snapshot con fermo e avvio della replica richiede fino a 40 secondi, mentre il deployment di una nuova istanza MySQL dallo snapshot richiede fino a 20 secondi. Questo soddisfa ampiamente sia le nostre esigenze che i nostri test del codice.
Resoconto intermedio:
- I risultati hanno completamente soddisfatto la nostra necessità di ottenere una copia del DB di produzione per testare il codice.
- La tecnologia richiede un'introduzione: è necessario comprendere cos'è ZFS e come lavorarci.
- Non abbiamo verificato lo stato attuale del funzionamento di ZFS con un gran numero (da 1 milione) di piccoli file. Ma supponiamo che il problema persista, quindi non consiglierei questo file system per alcun tipo di storage di file.
Cosa succede dopo?
All'interno dello stand non faremo altro, il risultato ci soddisfa. Potremmo, in futuro, aggiungere nelle impostazioni di replica dello stand delle eccezioni per le tabelle non necessarie ai test, questo ridurrebbe ulteriormente il volume del database. Non abbiamo testato il sistema BTRFS e la sua implementazione della tecnologia del salvataggio sottile. Tuttavia, non è più una priorità, poiché l'obiettivo principale è stato raggiunto. In generale, vorremmo allontanarci dall'approccio descritto sopra: implementare migrazioni funzionanti del database nell'ambiente di test, creare un circuito di test del database separato e occuparci del partizionamento del database principale. Molti di questi aspetti li stiamo già realizzando, di cui parleremo sicuramente nei prossimi articoli.
Conclusioni
Il compito iniziale è stato risolto, anche se in modo insolito. Nei risultati intermedi sono stati descritti i pregi e i difetti di ciascuna delle tecnologie applicate, quindi vediamo di decidere quale tecnologia e quando utilizzare:
- Thin LVM — per piccoli database e quando non si desidera o non si ha tempo di studiare ZFS.
- ZFS — se si ha esperienza con essa o se si ha la possibilità di dedicare tempo all'apprendimento in qualsiasi situazione.
A un livello più alto, questo articolo non è solo un confronto tra le tecnologie di due file system. L'idea principale che desidero trasmettere e consolidare è che non bisogna avere paura di pensare in modo non convenzionale in situazioni critiche per il business e di utilizzare solo ricette già pronte. Una volta avremmo potuto scuotere la testa con tutto il dipartimento tecnico e dire che creare copie del database da tre terabyte in meno di un minuto era impossibile, e che non avevamo bisogno di tecnologie rischiose, basta fare come si deve. Era possibile, ma avremmo perso circa sei mesi o un anno e molte visite dei clienti (le visite sono il nostro principale indicatore di business) senza test e durante l'implementazione. Pensando fuori dagli schemi, abbiamo perso meno tempo nell'implementazione, guadagnato esperienza in nuove e dimenticate tecnologie, e fornito test esattamente nel momento in cui ne avevamo molto bisogno. Questo ha avuto sicuramente un impatto positivo su tutti i nostri indicatori. La scelta è sempre vostra, e noi continueremo a raccontare nel nostro blog le attuali e future realizzazioni interessanti.
Fonte: habr.com
