

Per padroneggiare completamente Kubernetes, è necessario conoscere i vari metodi di scalabilità delle risorse del cluster: secondo , questo è uno dei compiti principali di Kubernetes. Abbiamo preparato una panoramica di alto livello dei meccanismi di autoscalabilità orizzontale e verticale e di ridimensionamento dei cluster, oltre a raccomandazioni su come utilizzarli in modo efficace.
L'articolo è stato tradotto da un team che ha implementato l'autoscalabilità in .
Perché è importante pensare alla scalabilità
— uno strumento per la gestione delle risorse e l'orchestrazione. Certamente, non è male sperimentare con le fantastiche funzioni di distribuzione, monitoraggio e gestione dei pod (un pod è un gruppo di contenitori avviati in risposta a una richiesta).
Tuttavia, è importante considerare anche domande come:
- Come scalare i moduli e le applicazioni?
- Come mantenere i contenitori in uno stato operativo ed efficiente?
- Come rispondere ai continui cambiamenti nel codice e nei carichi di lavoro degli utenti?
La configurazione dei cluster Kubernetes per bilanciare le risorse e le prestazioni può essere un compito complesso, richiede una conoscenza approfondita del funzionamento interno di Kubernetes. Il carico di lavoro della tua applicazione o dei tuoi servizi può fluttuare durante il giorno o anche in un'ora, quindi la bilanciatura dovrebbe essere vista come un processo continuo.
Livelli di autoscalabilità di Kubernetes
Un'autoscalabilità efficace richiede coordinamento tra due livelli:
- Il livello dei pod, che include l'autoscalabilità orizzontale (Horizontal Pod Autoscaler, HPA) e l'autoscalabilità verticale (Vertical Pod Autoscaler, VPA). Questa scalabilità riguarda le risorse esistenti per i tuoi contenitori.
- Il livello del cluster, gestito dal sistema di autoscalabilità del cluster (Cluster Autoscaler, CA), che aumenta o diminuisce il numero di nodi all'interno del cluster.
Il modulo di autoscalabilità orizzontale (HPA)
Come suggerisce il nome, l'HPA scala il numero di repliche dei pod. Come attivatori per modificare il numero di repliche, la maggior parte dei DevOps utilizza il carico della CPU e della memoria. Tuttavia, è possibile scalare il sistema basandosi su , la loro o addirittura .
Schema di funzionamento di alto livello dell'HPA:
- L'HPA controlla continuamente i valori delle metriche specificati durante l'installazione, con un intervallo predefinito di 30 secondi.
- L'HPA cerca di aumentare il numero di pod se viene raggiunta la soglia prevista.
- L'HPA aggiorna il numero di repliche all'interno del controller di distribuzione/replica.
- Il controller di distribuzione/replica quindi distribuisce tutti i pod aggiuntivi necessari.
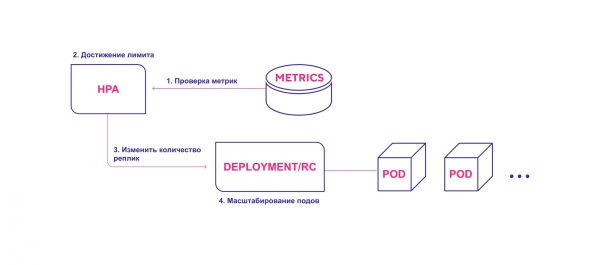
L'HPA avvia il processo di distribuzione dei pod al raggiungimento della soglia delle metriche.
Quando si utilizza l'HPA, tenere presente quanto segue:
- L'intervallo di controllo dell'HPA per impostazione predefinita è di 30 secondi. È impostato tramite il flag horizontal-pod-autoscaler-sync-period nel gestore del controller.
- L'errore relativo predefinito è pari al 10%.
- Dopo l'ultimo aumento del numero di pod, l'HPA aspetta che le metriche si stabilizzino per tre minuti. Questo intervallo è impostato tramite il flag horizontal-pod-autoscaler-upscale-delay.
- Dopo l'ultimo decremento del numero di pod, l'HPA attende la stabilizzazione per cinque minuti. Questo intervallo è impostato tramite il flag horizontal-pod-autoscaler-downscale-delay.
- L'HPA funziona meglio con oggetti di distribuzione piuttosto che con i controller di replica. L'autoscaling orizzontale non è compatibile con l'aggiornamento rolling, che manipola direttamente i controller di replica. Durante il deployment, il numero di repliche dipende direttamente dagli oggetti di distribuzione.
Autoscaling verticale dei pod
L'autoscaling verticale (VPA) assegna più (o meno) tempo di CPU o memoria ai pod esistenti. È adatto per pod a stato (stateful) o senza stato (stateless), ma principalmente destinato ai servizi stateful. Tuttavia, è possibile applicare il VPA anche ai pod senza stato, se è necessario regolare automaticamente il volume delle risorse inizialmente allocate.
Il VPA risponde anche agli eventi OOM (out of memory, esaurimento memoria). Per modificare il tempo di CPU e la quantità di memoria è necessaria la riavvio dei pod. Durante il riavvio, il VPA rispetta il budget di distribuzione (), per garantire il numero minimo necessario di pod.
Puoi impostare una quantità minima e massima di risorse per ogni modulo. Ad esempio, puoi limitare la quantità massima di memoria allocata a 8 GB. Questo è utile se i nodi attuali non possono allocare più di 8 GB di memoria per il contenitore. Specifiche dettagliate e il meccanismo di funzionamento sono descritti in .
Inoltre, VPA ha una funzionalità interessante di raccomandazione (VPA Recommender). Tiene traccia dell'utilizzo delle risorse e degli eventi OOM di tutti i moduli, per suggerire nuovi valori di memoria e tempo di CPU basati su un algoritmo intelligente che considera le metriche storiche. È disponibile anche un'interfaccia API che accetta il descrittore del pod e restituisce i valori di risorse suggeriti.
Vale la pena notare che VPA Recommender non tiene traccia del "limite" delle risorse. Questo può portare a una monopolizzazione delle risorse all'interno dei nodi. È meglio impostare un limite a livello di namespace per evitare un eccessivo consumo di memoria o tempo di CPU.
Schema di funzionamento ad alto livello di VPA:
- VPA controlla continuamente i valori delle metriche specificati durante l'installazione, con un intervallo predefinito di 10 secondi.
- Se viene raggiunta la soglia impostata, VPA tenta di modificare la quantità di risorse allocate.
- VPA aggiorna la quantità di risorse all'interno del controller di distribuzione/replicazione.
- Al riavvio dei moduli, tutte le nuove risorse vengono applicate alle istanze create.
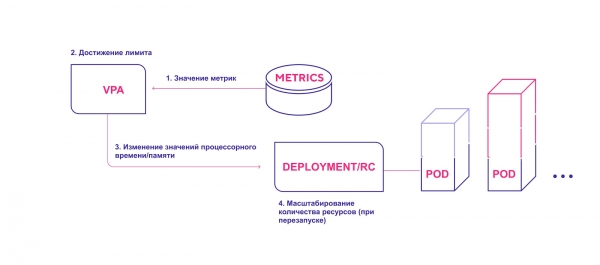
VPA aggiunge la quantità necessaria di risorse
Considera i seguenti aspetti quando utilizzi VPA:
- La scalabilità richiede il riavvio obbligatorio del pod. Questo è necessario per evitare un funzionamento instabile dopo le modifiche. Per affidabilità, i moduli vengono riavviati e distribuiti sui nodi in base alle nuove risorse allocate.
- VPA e HPA non sono ancora compatibili tra loro e non possono funzionare sugli stessi pod. Se utilizzi entrambi i meccanismi di scalabilità in un cluster, assicurati che le impostazioni non permettano loro di attivarsi sugli stessi oggetti.
- VPA configura le richieste dei contenitori per le risorse basandosi solo sul loro utilizzo passato e attuale. Non imposta limiti all'utilizzo delle risorse. Possono sorgere problemi con il funzionamento delle applicazioni, che inizieranno a occupare sempre più risorse, il che porterà a una disattivazione del pod da parte di Kubernetes.
- VPA è ancora in fase di sviluppo iniziale. Siate pronti a possibili cambiamenti nel sistema nei prossimi tempi. È possibile leggere riguardo a e . In particolare, si prevede di realizzare la cooperazione tra VPA e HPA, nonché il deployment dei moduli insieme alla politica di scalabilità verticale per loro (ad esempio, un'etichetta speciale 'requires VPA').
Scalabilità automatica del cluster Kubernetes
L'autoscalabilità del cluster (Cluster Autoscaler, CA) modifica il numero di nodi in base al numero di moduli pod in attesa. Il sistema controlla periodicamente la presenza di moduli in attesa e aumenta le dimensioni del cluster se sono necessarie più risorse e se il cluster non supera i limiti stabiliti. CA interagisce con il fornitore di servizi cloud, richiedendo nodi aggiuntivi o liberando quelli inattivi. La prima versione pubblica di CA è stata presentata in Kubernetes 1.8.
Schema di funzionamento ad alto livello di CA:
- CA controlla la presenza di moduli in stato di attesa con un intervallo di default di 10 secondi.
- Se uno o più moduli sono in attesa a causa della mancanza di risorse disponibili nel cluster per la loro distribuzione, tenta di preparare uno o più nodi aggiuntivi.
- Quando il fornitore di servizi cloud allocca il nodo necessario, esso si unisce al cluster e diventa pronto per gestire i moduli pod.
- Il pianificatore di Kubernetes distribuisce i moduli in attesa sul nuovo nodo. Se dopo ciò alcuni moduli rimangono ancora in attesa, il processo si ripete e nuovi nodi vengono aggiunti al cluster.
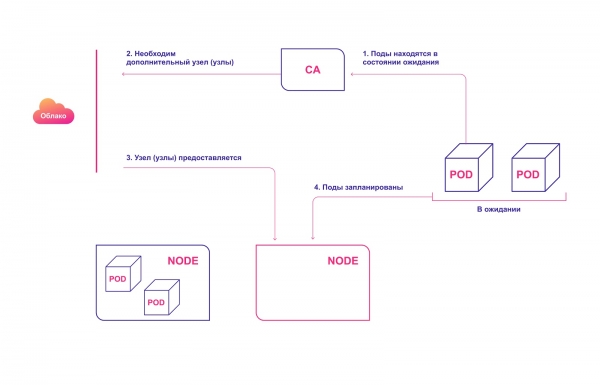
Assegnazione automatica di nodi del cluster nel cloud
Tenete presente quanto segue quando utilizzate CA:
- CA garantisce che tutti i moduli nel cluster abbiano uno spazio per l'esecuzione, indipendentemente dal carico della CPU. Inoltre, cerca di garantire che nel cluster non ci siano nodi non necessari.
- CA registra la necessità di scalare dopo circa 30 secondi.
- Dopo che un nodo diventa non necessario, CA attende per impostazione predefinita 10 minuti prima di scalare il sistema.
- Nel sistema di autoscalabilità ci sono concetti di espansori (expanders). Queste sono diverse strategie per selezionare il gruppo di nodi a cui verranno aggiunti nuovi.
- Utilizza responsabilmente l'opzione cluster-autoscaler.kubernetes.io/safe-to-evict (true). Se vengono avviati troppi pod o se molti di essi sono distribuiti su tutti i nodi, perderai in larga misura la possibilità di scalare il cluster.
- Usa , per prevenire la rimozione dei pod, il che potrebbe causare il malfunzionamento di parte della tua applicazione.
Come i sistemi di autoscalabilità Kubernetes interagiscono tra loro
Per un'armonia ideale, è opportuno applicare l'autoscalabilità sia a livello di pod (HPA/VPA) che a livello di cluster. Questi interagiscono relativamente facilmente tra loro:
- HPA o VPA aggiornano le repliche dei pod o le risorse allocate per i pod esistenti.
- Se non ci sono nodi sufficienti per la scalabilità pianificata, CA nota la presenza di pod in stato di attesa.
- CA assegna nuovi nodi.
- I moduli vengono distribuiti sui nuovi nodi.
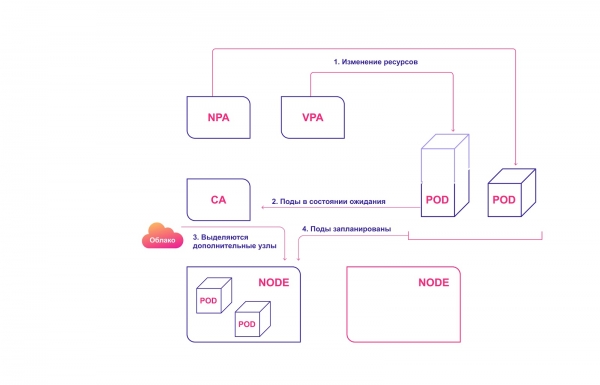
Sistema di scaling collaborativo di Kubernetes
Errori comuni nell'autoscalabilità di Kubernetes
Ci sono diversi problemi comuni che i DevOps affrontano quando cercano di implementare l'autoscalabilità.
HPA e VPA dipendono da metriche e alcune informazioni storiche. Se non sono disponibili risorse sufficienti, i moduli verranno ridotti e non saranno in grado di generare metriche. In questo caso, l'autoscalabilità non avverrà mai.
L'operazione di scalabilità stessa è sensibile al tempo. Vogliamo che i moduli e il cluster si scalino rapidamente — prima che gli utenti notino eventuali problemi e guasti. Pertanto, è importante considerare il tempo medio di scalabilità dei pod e del cluster.
Lo scenario ideale è di 4 minuti:
- 30 secondi. Aggiornamento delle metriche target: 30−60 secondi.
- 30 secondi. HPA controlla i valori delle metriche: 30 secondi.
- Meno di 2 secondi. I moduli pod vengono creati e passano allo stato di attesa: 1 secondo.
- Meno di 2 secondi. CA vede i moduli in attesa e invia richieste per preparare i nodi: 1 secondo.
- 3 minuti. Il fornitore di cloud sta allocando nodi. K8s aspetta che siano pronti: fino a 10 minuti (dipende da diversi fattori).
Lo scenario peggiore (più realistico) è di 12 minuti:
- 30 secondi. Aggiornamento delle metriche target.
- 30 secondi. L'HPA verifica i valori delle metriche.
- Meno di 2 secondi. I moduli pod sono stati creati e passano allo stato di attesa.
- Meno di 2 secondi. Il CA vede i moduli in attesa e invia richieste per preparare i nodi.
- 10 minuti. Il fornitore di cloud sta allocando nodi. K8s aspetta che siano pronti. Il tempo di attesa dipende da diversi fattori, come la latenza del fornitore, la latenza del sistema operativo e il funzionamento degli strumenti ausiliari.
Non confondete i meccanismi di scaling dei fornitori di cloud con il nostro CA. L'ultimo opera all'interno del cluster Kubernetes, mentre il meccanismo del fornitore di cloud si basa sulla distribuzione dei nodi. Non sa cosa sta succedendo con i vostri pod o applicazioni. Questi sistemi operano in parallelo.
Come gestire lo scalamento in Kubernetes
- Kubernetes è uno strumento di gestione delle risorse e orchestrazione. Le operazioni di gestione dei pod e delle risorse del cluster sono una pietra miliare fondamentale per padroneggiare Kubernetes.
- Imparate la logica della scalabilità dei pod tenendo conto dell'HPA e del VPA.
- Il CA dovrebbe essere utilizzato solo se comprendete bene le esigenze dei vostri pod e contenitori.
- Per una configurazione ottimale del cluster, è necessario capire come i vari sistemi di scaling lavorano insieme.
- Quando valutate il tempo di scaling, tenete a mente gli scenari migliori e peggiori.
Fonte: habr.com
