

Introduzione
Esiste nel mondo un'utile e semplice utilità — , e così è accaduto che si è radicata nel nostro processo produttivo da molto tempo (anche se non sono riuscito a installare la sua versione, era sicuramente precedente all'ultima disponibile). La utilizziamo per il suo scopo principale — la creazione di patch binari. Se si guarda cosa c'è nel repository, diventa un po' triste: in sostanza è stato abbandonato da tempo e molte cose sono diventate obsolete (una volta il mio ex-collega ha fatto alcune modifiche, ma è passato molto tempo). In generale, ho deciso di riportarla in vita: ho fatto un fork, ho eliminato ciò che non intendo usare, ho trasferito il progetto su , ho inlined le microfunzioni “calde”, ho rimosso grandi array dallo stack (e array di lunghezza variabile, che onestamente mi danno fastidio), ho fatto girare nuovamente il profiler — e ho scoperto che circa il 40% del tempo viene speso su …
Cosa c'è con fwrite?
Nel codice attuale fwrite (nel mio specifico caso: creazione di un patch tra file da quasi 300 MB, i dati di input sono completamente in memoria) viene chiamato milioni di volte con un buffer di piccole dimensioni. È evidente che questa cosa sarà lenta, e quindi vorrei trovare un modo per influenzare questo problema senza complicazioni. Non ho voglia di implementare fonti di dati di vario genere o input/output asincroni, volevo trovare una soluzione più semplice. La prima cosa che mi è venuta in mente è stata aumentare la dimensione del buffer
setvbuf(file, nullptr, _IOFBF, 64* 1024)ma non ho ottenuto un miglioramento significativo (ora fwrite richiedeva circa il 37% del tempo) — significa che il problema non è nella scrittura frequente dei dati su disco. Guardando “sotto il cofano” di fwrite si può vedere che all’interno avviene un lock/unlock della struttura FILE più o meno così (pseudocodice, tutta l'analisi è stata effettuata con Visual Studio 2017):
size_t fwrite (const void *buffer, size_t size, size_t count, FILE *stream)
{
   size_t retval = 0;
   _lock_str(stream);
   __try
   {
      retval = _fwrite_nolock(buffer, size, count, stream);
   }
   __finally
   {
       _unlock_str(stream);
   }
   return retval;
}
Se si crede al profiler, solo il 6% del tempo viene speso su _fwrite_nolock, il resto è overhead. Nel mio caso specifico la sicurezza del thread è un chiaro superfluo, e farò a meno di essa, sostituendo la chiamata a fwrite con — non c'è bisogno di complicare le cose nemmeno con argomenti. In sintesi: questa semplice manipolazione ha ridotto drasticamente i costi di registrazione del risultato, che nella versione originale costituivano quasi la metà del tempo speso. A proposito, nel mondo POSIX esiste una funzione analoga — . In effetti, lo stesso vale per fread. Così, con un paio di #define, è possibile ottenere una soluzione abbastanza cross-platform senza blocchi superflui nel caso in cui non siano necessari (ed è una situazione abbastanza comune).
fwrite, _fwrite_nolock, setvbuf
Asturiamo dall'originale e occupiamoci del test di un caso specifico: registrazione di un grande file (512 MB) in porzioni estremamente piccole — 1 byte. Sistema di prova: AMD Ryzen 7 1700, 16 GB di RAM, HDD 7200 rpm con 64 MB di cache, Windows 10 1809, binario costruito a 32 bit, ottimizzazioni abilitate, libreria collegata staticamente.
Esempio per eseguire l'esperimento:
#include <chrono>
#include <cstdio>
#include <inttypes.h>
#include <memory>

#ifdef _MSC_VER
#define fwrite_unlocked _fwrite_nolock
#endif

using namespace std::chrono;

int main()
{
    std::unique_ptr<FILE, int(*)(FILE*)> file(fopen("test.bin", "wb"), fclose);
    if (!file)
        return 1;

    constexpr size_t TEST_BUFFER_SIZE = 256 * 1024;
    if (setvbuf(file.get(), nullptr, _IOFBF, TEST_BUFFER_SIZE) != 0)
        return 2;

    auto start = steady_clock::now();
    const uint8_t b = 77;
    constexpr size_t TEST_FILE_SIZE = 512 * 1024 * 1024;
    for (size_t i = 0; i < TEST_FILE_SIZE; ++i)
        fwrite_unlocked(&b, 1, sizeof(b), file.get());

    auto end = steady_clock::now();
    auto interval = duration_cast<microseconds>(end - start);
    printf("Time: %lldn", interval.count());

    return 0;
}
Come variabili utilizzeremo TEST_BUFFER_SIZE e per un paio di casi sostituiremo fwrite_unlocked con fwrite. Iniziamo con il caso di fwrite senza un'impostazione esplicita della dimensione del buffer (commentiamo setvbuf e il codice correlato): tempo 27048906 µs, velocità di scrittura — 18.93 MB/s. Ora impostiamo la dimensione del buffer a 64 KB: tempo — 25037111 µs, velocità — 20.44 MB/s. Ora testeremo il funzionamento di _fwrite_nolock senza chiamare setvbuf: 7262221 µs, velocità — 70.5 MB/s!
Procediamo quindi a sperimentare con la dimensione del buffer (setvbuf):
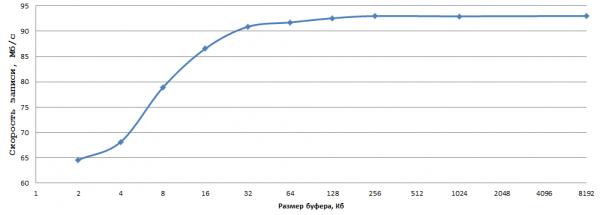
I dati sono stati ottenuti come media di 5 esperimenti, non mi sono preso la briga di calcolare gli errori. A mio avviso, 93 MB/s durante la scrittura di 1 byte su un normale HDD è un risultato davvero buono, basta semplicemente scegliere la dimensione del buffer ottimale (nel mio caso 256 KB è perfetto) e sostituire fwrite con _fwrite_nolock/fwrite_unlocked (nel caso in cui la sicurezza dei thread non sia necessaria, ovviamente).
Analogamente per fread in condizioni simili. Poiché non ho una macchina 'reale' con linux a disposizione (i single board non contano), ho deciso di condurre un esperimento limitato su una macchina virtuale (Hyper-V, OpenSUSE 15, GCC 8.3.1) — la regola è sostanzialmente la stessa: fwrite 'puro' 20 MB/s, fwrite + buffer di 256 KB ha reso 23 MB/s, fwrite_unlocked con lo stesso buffer — 35 MB/s (binario a 64 bit, compilato con g++ -o2 -s -static-libgcc -static-libstdc++ fwrite_test.cpp -o fwrite_test).
Postfazione
L'obiettivo di questo articolo era descrivere un metodo semplice ed efficace che funziona in molti casi (non avevo mai incontrato le funzioni _fwrite_nolock/fwrite_unlocked, non sono molto popolari — e sarebbe un peccato). Non pretendo di portare novità, ma spero che l'articolo si riveli utile alla comunità.
Fonte: habr.com
