

Zabbix è un sistema di monitoraggio. Come qualsiasi altro sistema, affronta tre problemi principali di tutti i sistemi di monitoraggio: raccolta e elaborazione dei dati, archiviazione della cronologia e la sua pulizia.
Le fasi di acquisizione, elaborazione e registrazione dei dati richiedono tempo. Poco, ma per un sistema di grandi dimensioni questo può tradursi in ritardi considerevoli. Il problema della memorizzazione è una questione di accesso ai dati. Questi sono utilizzati per report, verifiche e trigger. I ritardi nell'accesso ai dati influenzano anche le prestazioni. Man mano che i database crescono, i dati obsoleti devono essere rimossi. La rimozione è un'operazione pesante, che consuma anche parte delle risorse.
I problemi di latenza nella raccolta e nell'archiviazione in Zabbix vengono risolti con la cache: diversi tipi di cache, caching nel database. Per affrontare il terzo problema, il caching non è sufficiente, quindi in Zabbix è stato implementato TimescaleDB. Di questo parlerà Andrej Guščin — ingegnere del supporto tecnico . Andrej è nel supporto di Zabbix da oltre 6 anni e si occupa direttamente delle prestazioni.
Come funziona TimescaleDB, quali prestazioni può offrire rispetto a PostgreSQL ordinario? Che ruolo gioca Zabbix per il database TimescaleDB? Come avviare da zero e come migrare da PostgreSQL e quale configurazione offre le migliori prestazioni? Di tutto ciò parleremo di seguito.

Sfide delle prestazioni
Ogni sistema di monitoraggio si trova di fronte a determinate sfide prestazionali. Parlerò di tre di esse: raccolta e elaborazione dei dati, archiviazione, pulizia della cronologia.
Raccolta ed elaborazione rapida dei dati. Un buon sistema di monitoraggio deve acquisire rapidamente tutti i dati e elaborarli in base alle espressioni trigger — secondo i propri criteri. Dopo l'elaborazione, il sistema deve anche salvare rapidamente questi dati nel database, per poterli utilizzare successivamente.
Archiviazione della cronologia. Un buon sistema di monitoraggio deve memorizzare la cronologia nel database e fornire un accesso conveniente alle metriche. La storia è necessaria per utilizzarla in report, grafici, trigger, valori soglia ed elementi dati calcolati per le notifiche.
Pulizia della cronologia. A volte arriva un giorno in cui non è necessario conservare le metriche. Perché dovresti avere dati raccolti 5 anni fa, un mese o due fa: alcuni nodi sono stati rimossi, alcuni host o metriche non sono più necessari perché obsoleti e smettono di essere raccolti. Un buon sistema di monitoraggio dovrebbe conservare i dati storici e di tanto in tanto eliminarli, per evitare che il database cresca troppo.
La pulizia dei dati obsoleti è una questione critica che ha un forte impatto sulle prestazioni del database.
Cache in Zabbix
In Zabbix, la prima e la seconda invocazione vengono gestite tramite caching. La memoria operativa è utilizzata per raccogliere e trattare i dati. Per la memorizzazione ci sono storie nei trigger, nei grafici e negli elementi di dati calcolati. A livello di database esiste un certo caching per le principali query, come i grafici.
Caching lato server Zabbix:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Esaminiamoli più nel dettaglio.
ConfigurationCache
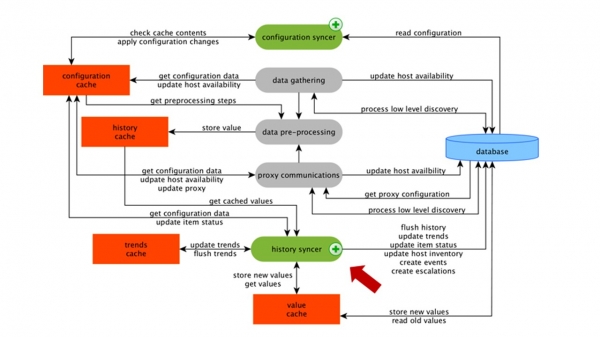
Questo è il cache principale in cui memorizziamo metriche, host, elementi di dati, trigger - tutto ciò che è necessario per il PreProcessing e la raccolta dei dati.
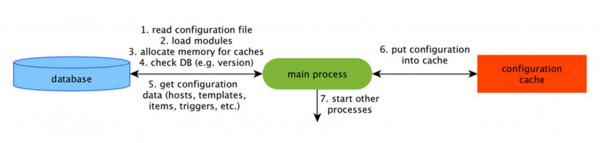
Tutto questo è conservato in ConfigurationCache, per evitare richieste superflue al database. Dopo l'avvio del server, aggiorniamo questo cache, creiamo e aggiorniamo periodicamente le configurazioni.
Raccolta dati
Lo schema è abbastanza grande, ma la cosa principale è che ci sono raccoltori. Sono diversi "poller" - processi di raccolta. Sono responsabili di diversi tipi di raccolta: raccolgono dati tramite SNMP, IPMI, e trasmettono tutto al PreProcessing.
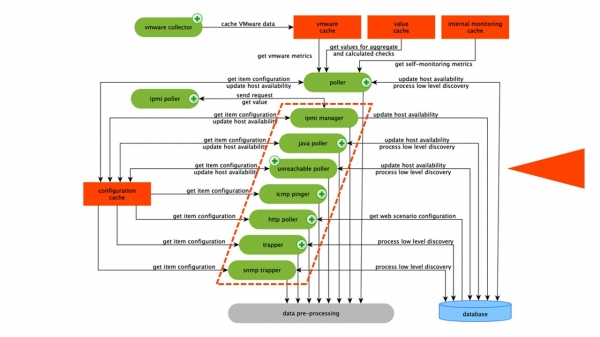 I raccoglitori sono evidenziati da una linea arancione.
In Zabbix ci sono elementi di dati aggregati calcolati, necessari per aggregare le verifiche. Se li abbiamo, preleviamo i dati per loro direttamente da ValueCache.
PreProcessing HistoryCache
Tutti i raccoglitori utilizzano ConfigurationCache per ricevere incarichi. Successivamente, li trasferiscono al PreProcessing.
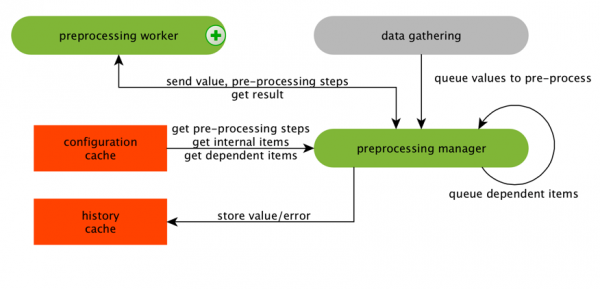
Il PreProcessing utilizza ConfigurationCache per ottenere i passi del PreProcessing. Elabora questi dati in vari modi.
Dopo l'elaborazione dei dati tramite il PreProcessing, li memorizziamo in HistoryCache per ulteriori elaborazioni. Qui termina la raccolta dei dati e passiamo al processo principale in Zabbix - history syncer, poiché si tratta di un'architettura monolitica.
Nota: il PreProcessing è un'operazione piuttosto pesante. A partire da v 4.2 è stato spostato su proxy. Se hai un Zabbix molto grande con un elevato numero di elementi di dati e frequenza di raccolta, questo facilita notevolmente il lavoro.
ValueCache, cronologia e cache delle tendenze
History syncer è il processo principale che elabora atomicamente ogni elemento di dati, ovvero ogni valore.
History syncer prende i valori da HistoryCache e verifica nella Configurazione la presenza di trigger per i calcoli. Se ci sono, esegue il calcolo.
History syncer crea un evento, un'escalation, per generare allerta se richiesto dalla configurazione, e registra. Se ci sono trigger per un'elaborazione successiva, questo valore viene memorizzato in ValueCache, per non dover accedere alla tabella della cronologia. Così ValueCache si riempie di dati necessari per il calcolo dei trigger e degli elementi calcolati.
History syncer registra tutti i dati nel DB e questo li scrive su disco. Il processo di elaborazione si conclude qui.
Caching nel DB
Sul lato del DB ci sono vari cache quando si desidera visualizzare grafici o rapporti sugli eventi:
Innodb_buffer_poolsul lato di MySQL;shared_bufferssul lato di PostgreSQL;effective_cache_sizesul lato di Oracle;shared_poolsul lato di DB2.
Ci sono molti altri cache, ma questi sono i principali per tutti i DB. Permettono di mantenere in memoria i dati che sono spesso necessari per le query. Hanno le proprie tecnologie per questo.
Le prestazioni del DB sono critiche
Il server Zabbix raccoglie continuamente dati e li registra. Durante il riavvio, legge anche dalla cronologia per riempire ValueCache. Utilizza Zabbix API, che si basa sull'interfaccia Web. Zabbix API accede al database e ottiene i dati necessari per grafici, rapporti, liste di eventi e ultimi problemi.
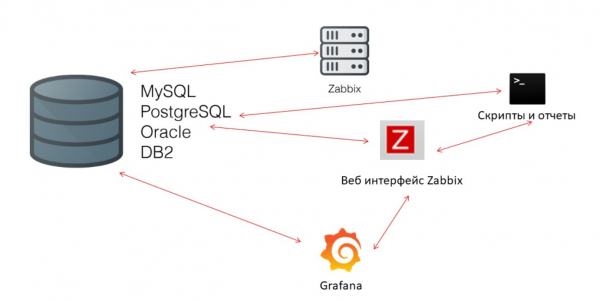
Per la visualizzazione — Grafana. Tra i nostri utenti è una soluzione popolare. È in grado di inviare direttamente richieste tramite Zabbix API sia al DB, creando una certa concorrenza per ottenere dati. Pertanto, è necessaria una configurazione più fine e accurata del DB per garantire un rapido rilascio dei risultati e test.
Housekeeper
La terza chiamata di prestazione in Zabbix è la pulizia della cronologia tramite Housekeeper. Rispetta tutte le impostazioni — nei dati è indicato quanto conservare la dinamica delle modifiche (tendenze) in giorni.
TrendsCache lo calcoliamo al volo. Quando arrivano i dati, li aggregiamo per un'ora e li registriamo nelle tabelle per la dinamica delle modifiche delle tendenze.
Housekeeper si avvia ed elimina informazioni dal DB utilizzando normali «select». Questo non è sempre efficiente, come si può comprendere dai grafici delle prestazioni dei processi interni.
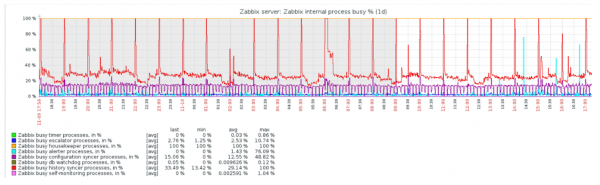
Il grafico rosso mostra che il History syncer è costantemente occupato. Il grafico arancione in alto è il Housekeeper, che si avvia continuamente. Aspetta che il DB elimini tutte le righe che ha impostato.
Quando è opportuno disattivare il Housekeeper? Ad esempio, se ci sono «Item ID» e si devono eliminare le ultime 5.000 righe in un determinato periodo di tempo. Certamente, ciò avviene attraverso gli indici. Ma di solito il dataset è molto grande e il DB continua a leggere dal disco e a caricare nella cache. Questa è sempre un'operazione molto costosa per il DB e, a seconda delle dimensioni del database, può portare a problemi di prestazioni.
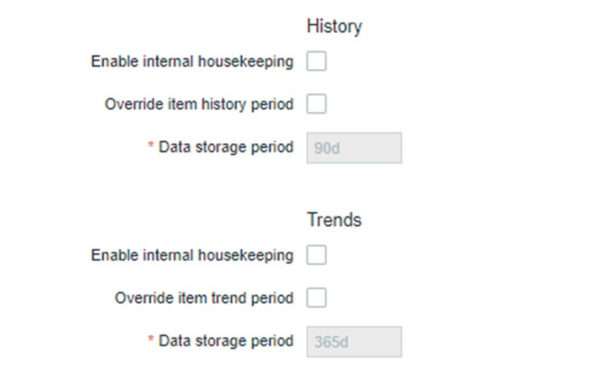
Disattivare semplicemente il Housekeeper. Nell'interfaccia Web esiste un'impostazione in «Administration general» per il Housekeeper. Disattiviamo il housekeeping interno per la cronologia interna delle tendenze e non gestisce più questo.
Il Housekeeper è stato disattivato, i grafici si sono allineati — quali potrebbero essere i problemi in questo caso e cosa potrebbe aiutare a risolvere la terza chiamata alle prestazioni?
Partizionamento — sezione oppure partizionamento
Di solito, il partizionamento viene configurato in modi diversi su ciascun DB relazionale che ho elencato. Ognuno ha la propria tecnologia, ma sono simili, in generale. La creazione di una nuova partizione porta spesso a determinati problemi.
Di solito, le partizioni vengono configurate in base al «setup» — quantità di dati creati in un giorno. In generale, il Partizionamento viene impostato per un giorno, questo è il minimo. Per le tendenze le nuove partizioni — per 1 mese.
I valori possono variare in caso di «setup» molto grande. Se il «setup» è piccolo — fino a 5.000 nvps (nuovi valori al secondo), medio — da 5.000 a 25.000, grande — oltre 25.000 nvps. Queste sono installazioni grandi e molto grandi, che richiedono una configurazione attenta proprio del database.
In installazioni molto grandi, un intervallo di un giorno potrebbe non essere ottimale. Ho visto su MySQL partizioni di 40 GB o più al giorno. Questo è un volume di dati molto grande, che può portare a problemi, e deve essere ridotto.
Quali vantaggi offre il Partizionamento?
Partizionamento delle tabelle. Spesso si tratta di file separati sul disco. Il piano delle query sceglie in modo più ottimale una partizione. Di solito, la partizione viene utilizzata per intervallo: questo è vero anche per Zabbix. Utilizziamo lì «timestamp» — il tempo dall'inizio dell'epoca. Per noi sono numeri normali. Si impostano l'inizio e la fine del giorno — questa è la partizione.
Eliminazione rapida — DELETE. Viene scelto un file/sottotabella, e non un campione di righe da eliminare.
Accelera notevolmente l'estrazione dei dati SELECT — utilizza una o più partizioni, e non l'intera tabella. Se si richiedono dati di due giorni fa, vengono estratti dal database più rapidamente, perché è necessario caricare in cache e restituire solo un file, e non un grande tavolo.
Spesso molte banche dati accelerano anche INSERISCI — le inserzioni nella tabella child.
TimescaleDB
Per la versione 4.2, abbiamo prestato attenzione a TimescaleDB. Questo è un'estensione per PostgreSQL con un'interfaccia nativa. L'estensione funziona in modo efficace con dati time series, senza perdere i vantaggi delle banche dati relazionali. TimescaleDB partiziona automaticamente.
In TimescaleDB c'è il concetto di iper-tabella (hypertable), che si crea. In essa ci sono chunk — partizioni. I chunk sono frammenti della iper-tabella gestiti automaticamente, il che non influisce su altri frammenti. Per ogni chunk c'è un intervallo di tempo proprio.
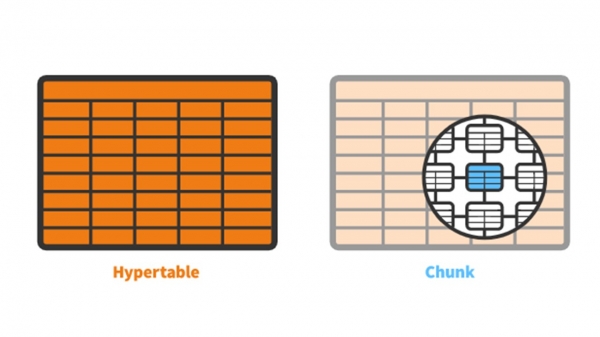
TimescaleDB vs PostgreSQL
TimescaleDB funziona davvero in modo efficiente. I produttori dell'estensione affermano di utilizzare un algoritmo di elaborazione delle query più corretto, in particolare, inserts. Quando le dimensioni delle inserzioni del dataset aumentano, l'algoritmo mantiene prestazioni costanti.
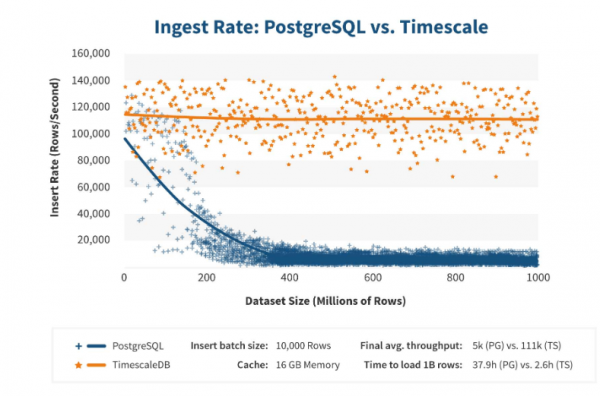
Dopo 200 milioni di righe, PostgreSQL di solito inizia a rallentare e perde prestazione fino a 0. TimescaleDB consente di inserire 'inserts' in modo efficace con qualsiasi volume di dati.
Installazione
Installare TimescaleDB è abbastanza semplice per qualsiasi pacchetto. In tutto è descritto dettagliatamente — dipende dai pacchetti ufficiali di PostgreSQL. TimescaleDB può anche essere assemblato e compilato manualmente.
Per il database Zabbix attiviamo semplicemente l'estensione:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Attivi l'estensione e la crei per il database Zabbix. L'ultimo passaggio è la creazione dell'iper-tabella.
Migrazione delle tabelle storiche su TimescaleDB
A tal fine c'è una funzione speciale create_hypertable:
SELECT create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
La funzione ha tre parametri. Il primo — la tabella nel DB, per la quale è necessario creare una hypertable. Il secondo — il campo, su cui deve essere creata chunk_time_interval — l'intervallo dei chunk delle partizioni da utilizzare. Nel mio caso, l'intervallo è di un giorno — 86.400.
Il terzo parametro — migrare_dati. Se impostato true, tutti i dati correnti vengono spostati nei chunk creati in anticipo. Io ho utilizzato migrare_dati. Avevo circa 1 TB, il che ha richiesto più di un'ora. Anche in alcuni casi durante il test ho cancellato i dati storici non necessari di tipo stringa per non trasferirli.
L'ultimo passo — UPDATE: in db_extension impostiamo timescaledb, affinché il DB comprenda che esiste questa estensione. Zabbix la attiva e utilizza correttamente la sintassi e le query già al DB — quelle funzioni necessarie per TimescaleDB.
Configurazione hardware
Ho utilizzato due server. Il primo — una macchina VMware. È abbastanza piccola: 20 processori Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB di RAM e un disco SSD da 200 GB.
Vi ho installato PostgreSQL 10.8 con sistema operativo Debian 10.8-1.pgdg90+1 e filesystem xfs. Ho effettuato tutte le configurazioni minime per utilizzare proprio questo database, tranne per il fatto che verrà utilizzato da Zabbix.
Sulla stessa macchina era installato il server Zabbix, PostgreSQL e gli agenti di carico. Avevo 50 agenti attivi, che utilizzavano LoadableModule, per generare molto rapidamente risultati vari: numeri, stringhe. Ho riempito il database con una grande quantità di dati.
Inizialmente, la configurazione conteneva 5.000 elementi di dati per ogni host. Quasi ogni elemento conteneva un trigger, per essere simile a installazioni reali. In alcuni casi c'erano più di un trigger. Su un nodo della rete c'erano 3.000-7.000 trigger.
L'intervallo di aggiornamento degli elementi dati è di 4-7 secondi. Ho regolato il carico non solo utilizzando 50 agenti, ma aggiungendone anche altri. Inoltre, grazie agli elementi dei dati, ho regolato dinamicamente il carico e ho ridotto l'intervallo di aggiornamento a 4 secondi.
PostgreSQL. 35.000 nvps
Il primo avvio su questa macchina è stato con PostgreSQL puro — 35.000 valori al secondo. Come si può vedere, l'inserimento dei dati richiede frazioni di secondo — tutto va bene e veloce. L'unica cosa è che il disco SSD da 200 GB si riempie rapidamente.
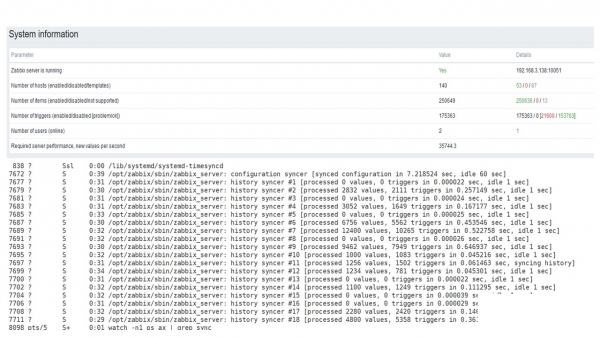
Questo è il dashboard standard delle prestazioni di Zabbix — server.
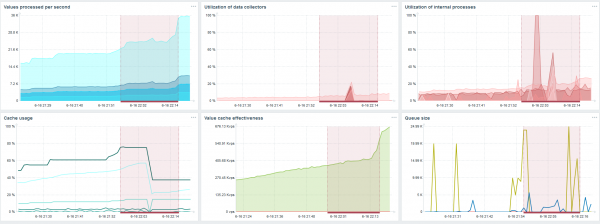
Il primo grafico blu mostra il numero di valori al secondo. Il secondo grafico a destra mostra il carico dei processi di raccolta. Il terzo — il carico dei processi interni di raccolta: history syncers e Housekeeper, che qui è stato eseguito per un tempo sufficiente.
Il quarto grafico mostra l'utilizzo di HistoryCache. Questo è un buffer prima dell'inserimento nel DB. Il quinto grafico verde mostra l'utilizzo di ValueCache, cioè quanti colpi di ValueCache ci sono per i trigger — si tratta di alcune migliaia di valori al secondo.
PostgreSQL. 50.000 nvps
Poi ho aumentato il carico fino a 50.000 valori al secondo su questa stessa macchina.
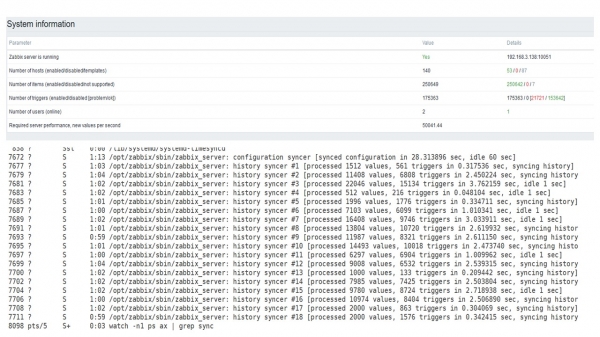
Durante il caricamento con Housekeeper, l'inserimento di 10.000 valori è stato registrato in 2-3 secondi.
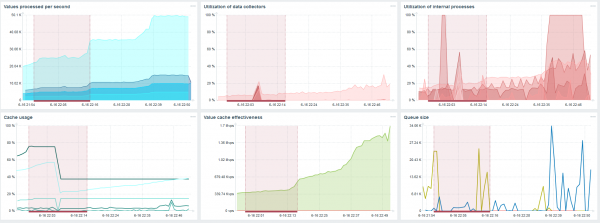
Housekeeper inizia a interferire con il lavoro.
Dal terzo grafico si può vedere che, in generale, il carico di trappole e history syncers è ancora al 60%. Nel quarto grafico, HistoryCache inizia a riempirsi piuttosto attivamente durante il lavoro di Housekeeper. Si è riempito al 20% — circa 0,5 GB.
PostgreSQL. 80.000 nvps
Poi ho aumentato il carico fino a 80.000 valori al secondo. Questo corrisponde a circa 400.000 elementi di dati e 280.000 trigger.
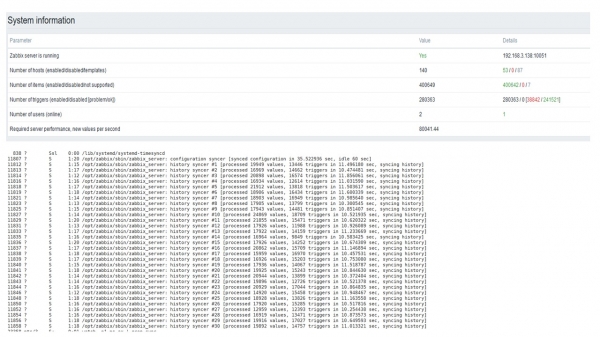
L'inserimento con un caricamento di trenta history syncers è già piuttosto elevato.
Inoltre, ho aumentato vari parametri: history syncers, cache.
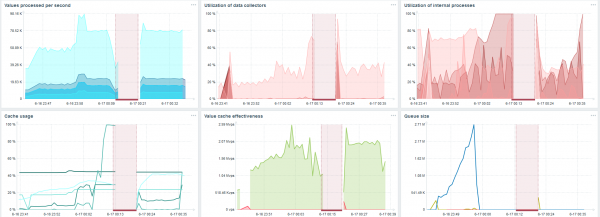
Sulla mia macchina, il carico degli history syncers è aumentato al massimo. HistoryCache si è rapidamente riempito di dati — nel buffer si sono accumulati dati da elaborare.
Per tutto questo tempo ho osservato come venivano utilizzati la CPU, la memoria RAM e altri parametri di sistema, e ho scoperto che l'utilizzo dei dischi era massimo.
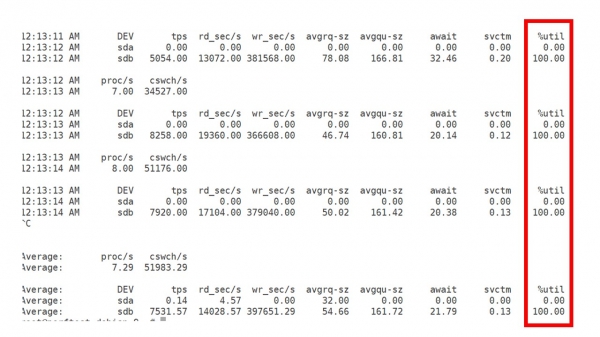
Ho raggiunto l'utilizzo delle massime capacità del disco su questa macchina e su questa macchina virtuale. Con tale intensità, PostgreSQL ha iniziato a svuotare i dati piuttosto attivamente, e il disco non riusciva più a gestire le operazioni di scrittura e lettura.
Secondo server
Ho preso un altro server, che aveva già 48 processori e 128 GB di memoria RAM. L'ho ottimizzato — ho messo 60 history syncer, e ho raggiunto un'adeguata velocità di esecuzione.
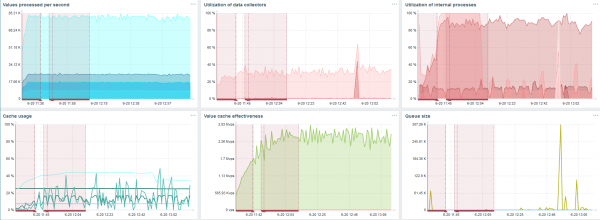
In effetti, questo è già il limite delle prestazioni, dove è necessario prendere misure.
TimescaleDB. 80.000 nvps
Il mio obiettivo principale è verificare le capacità di TimescaleDB sotto il carico di Zabbix. 80.000 valori al secondo sono molti, la frequenza di raccolta delle metriche (a parte Yandex, ovviamente) e un 'setup' piuttosto grande.
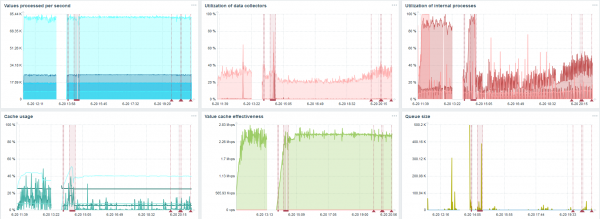
In ogni grafico c'è un calo — questo è proprio il momento della migrazione dei dati. Dopo i cali, nel server Zabbix, il profilo di carico dell'history syncer è cambiato drasticamente — è diminuito di tre volte.
TimescaleDB consente di inserire dati praticamente tre volte più velocemente e di utilizzare meno HistoryCache.
Di conseguenza, i dati saranno forniti in tempo utile.
TimescaleDB. 120.000 nvps
Poi ho aumentato il numero di elementi dati a 500.000. L'obiettivo principale era testare le capacità di TimescaleDB — ho ottenuto un valore stimato di 125.000 valori al secondo.
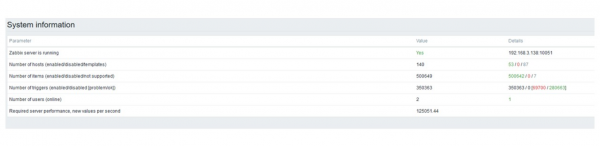
Questo è un 'setup' operativo, che può funzionare a lungo. Ma poiché il mio disco era solo di 1,5 TB, l'ho riempito in pochi giorni.
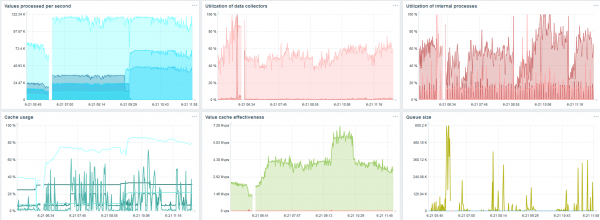
La cosa più importante è che nel frattempo sono state create nuove partizioni TimescaleDB.
Per le prestazioni ciò è completamente invisibile. Quando le partizioni vengono create in MySQL, ad esempio, tutto è diverso. Di solito avviene di notte, perché blocca l'inserimento complessivo, il lavoro con le tabelle e può causare degradazione del servizio. Nel caso di TimescaleDB, questo non avviene.
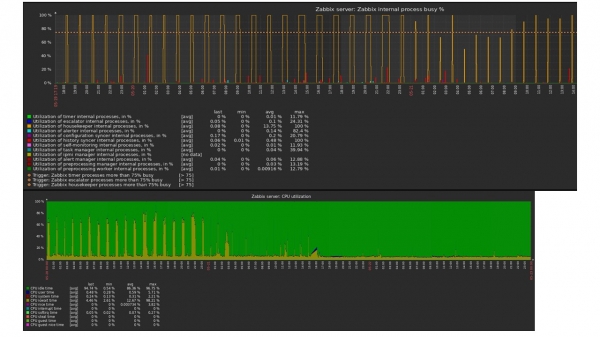
Per esempio, mostrerò un grafico tra i tanti nella community. Nell'immagine è attivato TimescaleDB, grazie al quale il carico sullo utilizzo di io.weight della CPU è diminuito. Anche l'uso degli elementi dei processi interni è sceso. Inoltre, si tratta di una normale macchina virtuale con normali dischi a piatto, non SSD.
Conclusioni
TimescaleDB è una buona soluzione per piccoli 'setup', che si bloccano sulle prestazioni del disco. Permetterà di continuare a lavorare bene fino alla migrazione del database su hardware più veloce.
TimescaleDB è semplice da configurare, offre un aumento delle prestazioni, funziona bene con Zabbix e ha vantaggi rispetto a PostgreSQL.
Se utilizzate PostgreSQL e non prevedete di cambiarlo, consiglio di utilizzare PostgreSQL con l'estensione TimescaleDB in combinazione con Zabbix. Questa soluzione funziona efficacemente fino a 'setup' di media dimensione.
Parlando di "alta prestazione" — intendiamo . Aspettare di conoscere le tecnologie e le pratiche che permettono ai servizi di gestire milioni di utenti non richiederà molto tempo. Elenco per il 7 e 8 novembre lo abbiamo già preparato, ma possono essere ulteriormente proposti.
Seguiteci nel nostro e , in cui sveliamo le novità della conferenza in arrivo e scopri come ottenere il massimo beneficio.
Fonte: habr.com
