

VictoriaMetrics, TimescaleDB e InfluxDB sono stati confrontati in base a un insieme di dati con un miliardo di punti dati, appartenenti a 40K serie temporali uniche.
Alcuni anni fa, c'era l'era di Zabbix. Ogni server bare metal aveva non più di alcuni indicatori: utilizzo della CPU, utilizzo della memoria, utilizzo del disco e utilizzo della rete. In questo modo, le metriche di migliaia di server possono essere contenute in 40k serie temporali uniche, e Zabbix può utilizzare MySQL come backend per i dati delle serie temporali 🙂
Attualmente, un con le configurazioni di default fornisce più di 500 metriche su un host medio. Ci sono molti per vari database, server web, sistemi hardware, ecc. Tutti offrono molte informazioni utili. Sempre iniziano a esporre vari indicatori su di sé. C'è Kubernetes con cluster e pod che espongono molte metriche. Questo porta a fatto che i server espongono migliaia di metriche uniche per host. Pertanto, una serie temporale unica di 40K non è più un grande carico. Diventa mainstream e deve essere facilmente gestibile da qualsiasi TSDB moderna su un singolo server.
Qual è attualmente un grande numero di serie temporali uniche? Probabilmente 400K o 4M? O 40M? Confrontiamo le moderne TSDB con questi numeri.
Impostazione del benchmark
è uno strumento eccellente per il benchmarking delle TSDB. Permette di generare un numero arbitrario di metriche, passando il numero richiesto di serie temporali, suddivise per 10 — il flag (precedentemente -scale-var). 10 è il numero di misurazioni (metriche) generate su ogni host, server. I seguenti set di dati sono stati creati utilizzando TSBS per il benchmark:
- 400K serie temporali uniche, intervallo di 60 secondi tra i punti dati, i dati coprono un'intera durata di 3 giorni, ~1.7B numero totale di punti dati.
- 4M serie temporali uniche, intervallo di 600 secondi, i dati coprono un'intera durata di 3 giorni, ~1.7B numero totale di punti dati.
- 40M serie temporali uniche, intervallo di 1 ora, i dati coprono un'intera durata di 3 giorni, ~2.8B numero totale di punti dati.
Il client e il server sono stati eseguiti su istanze dedicate nel cloud di Google. Questi istanze avevano le seguenti configurazioni:
- vCPUs: 16
- RAM: 60 GB
- Storage: disco rigido standard da 1 TB. Offre una larghezza di banda di lettura/scrittura di 120 Mbit/s, 750 operazioni di lettura al secondo e 1,5K operazioni di scrittura al secondo.
Le TSDB sono state estratte dalle immagini ufficiali di Docker e sono state eseguite in Docker con le seguenti configurazioni:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsI valori di InfluxDB (- e sono necessari per supportare alta potenza. Ulteriori dettagli possono essere trovati in ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (la configurazione è stata presa da file):
MEM=`free -m | grep "Mem" | awk '{print $7}'`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
Il caricatore dati è stato avviato con 16 thread paralleli.
Questo articolo contiene solo i risultati per i metriche di inserimento. I risultati del benchmark campionato saranno pubblicati in un altro articolo.
400K serie temporali uniche
Iniziamo con elementi semplici — 400K. Risultati del benchmark:
- VictoriaMetrics: 2,6M punti dati al secondo; utilizzo della memoria: 3 GB; dimensione finale dei dati su disco: 965 MB
- InfluxDB: 1.2M punti dati al secondo; utilizzo della memoria: 8.5 GB; dimensione finale dei dati su disco: 1.6 GB
- Timescale: 849K punti dati al secondo; utilizzo della memoria: 2,5 GB; dimensione finale dei dati su disco: 50 GB
Come puoi vedere dai risultati sopra, VictoriaMetrics vince in prestazioni di inserimento e grado di compressione. Timescale vince in utilizzo della memoria, ma utilizza molto spazio su disco — 29 byte per punto dati.
Di seguito sono riportati i grafici di utilizzo della CPU per ciascuna delle TSDB durante il benchmark:
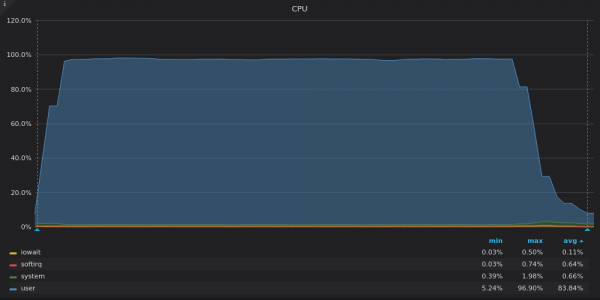
Screenshot sopra: VictoriaMetrics — Carico CPU durante il test di inserimento per la metrica unica 400K.
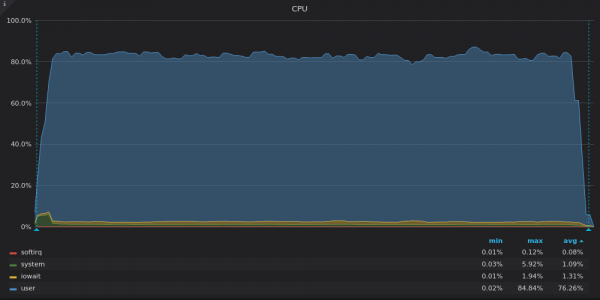
Screenshot sopra: InfluxDB — Carico CPU durante il test di inserimento per la metrica unica 400K.
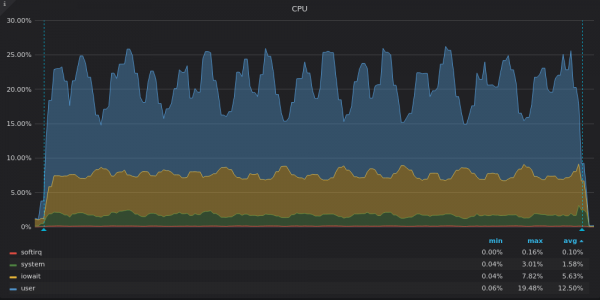
Screenshot sopra: TimescaleDB — Carico della CPU durante il test di inserimento per una metrica unica di 400K.
VictoriaMetrics utilizza tutte le vCPUs disponibili, mentre InfluxDB sfrutta poco ~2 su 16 vCPUs.
Timescale utilizza solo 3-4 su 16 vCPUs. Le alte percentuali di iowait e system nel grafico di TimescaleDB indicano un collo di bottiglia nel sottosistema di input-output (I/O). Diamo un'occhiata ai grafici di utilizzo della larghezza di banda del disco:
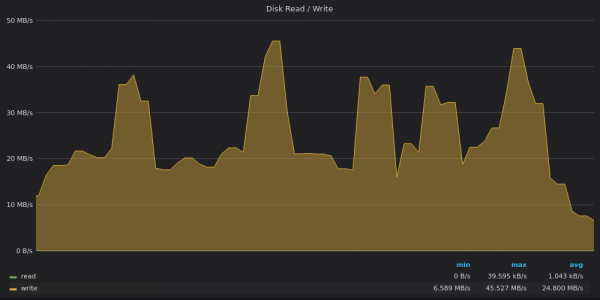
Screenshot sopra: VictoriaMetrics — Utilizzo della larghezza di banda del disco durante il test di inserimento per metriche uniche di 400K.
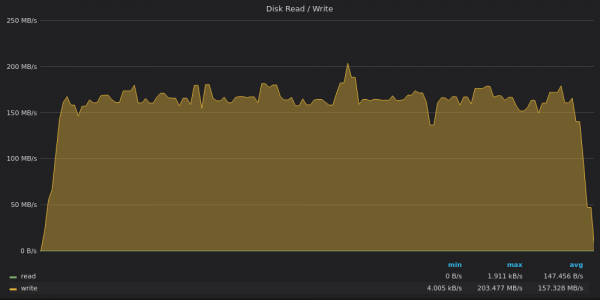
Screenshot sopra: InfluxDB — Utilizzo della larghezza di banda del disco durante il test di inserimento per metriche uniche di 400K.
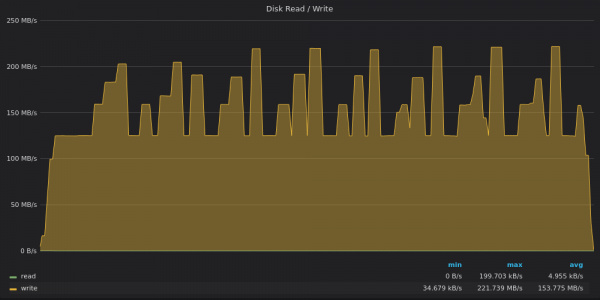
Screenshot sopra: TimescaleDB — Utilizzo della larghezza di banda del disco durante il test di inserimento per metriche uniche di 400K.
VictoriaMetrics registra dati a una velocità di 20 Mbit/s con picchi fino a 45 Mbit/s. I picchi corrispondono a grandi fusioni parziali nell'albero .
InfluxDB registra dati a una velocità di 160 MB/s, mentre un disco da 1 TB alla larghezza di banda di scrittura di 120 MB/s.
TimescaleDB è limitata dalla larghezza di banda di scrittura di 120 Mbit/s, ma a volte supera questo limite e raggiunge 220 Mbit/s in valori di picco. Questi picchi corrispondono a cali di carico della CPU nel grafico precedente.
Diamo un'occhiata ai grafici di utilizzo di input-output (I/O):
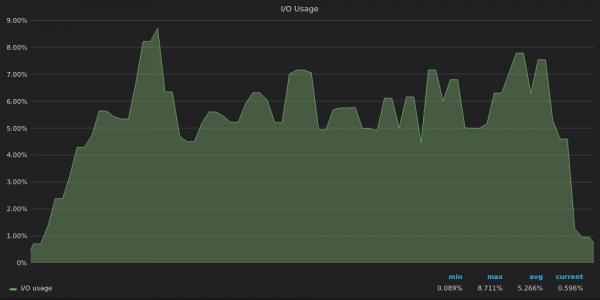
Screenshot sopra: VictoriaMetrics — Utilizzo di input-output durante il test di inserimento per 400K metriche uniche.
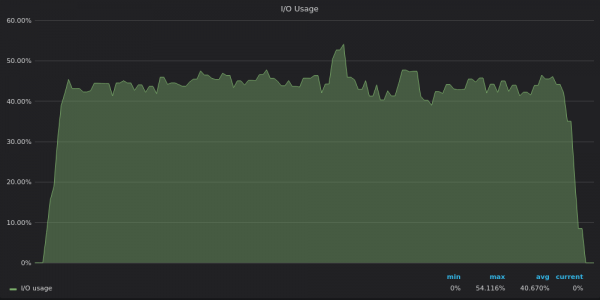
Screenshot sopra: InfluxDB — Utilizzo di input-output durante il test di inserimento per 400K metriche uniche.
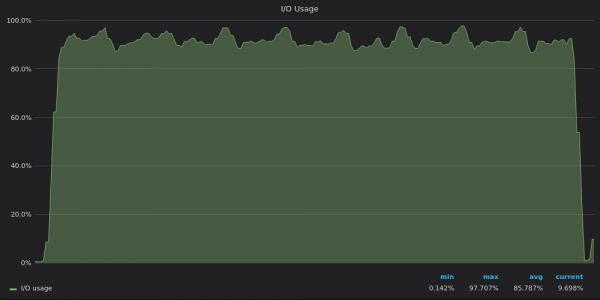
Screenshot sopra: TimescaleDB — Utilizzo di input-output durante il test di inserimento per 400K metriche uniche.
Ora è chiaro che TimescaleDB raggiunge il limite di input-output, quindi non può utilizzare le rimanenti 12 vCPUs.
4M serie temporali uniche
4M serie temporali sembrano un po' provocatorie. Ma i nostri concorrenti superano con successo questo test. Risultati del benchmark:
- VictoriaMetrics: 2,2M punti dati al secondo; utilizzo della RAM: 6 GB; dimensione finale dei dati su disco: 3 GB.
- InfluxDB: 330K punti dati al secondo; utilizzo della RAM: 20,5 GB; dimensione finale dei dati su disco: 18,4 GB.
- TimescaleDB: 480K punti dati al secondo; utilizzo della memoria operativa: 2,5 GB; dimensione finale dei dati su disco: 52 GB.
Le prestazioni di InfluxDB sono scese da 1,2 milioni di punti dati al secondo per 400K serie temporali a 330.000 punti dati al secondo per 4 milioni di serie temporali. Questa è una perdita significativa di prestazioni rispetto ai concorrenti. Diamo un'occhiata ai grafici di utilizzo della CPU per capire le cause principali di questa perdita:
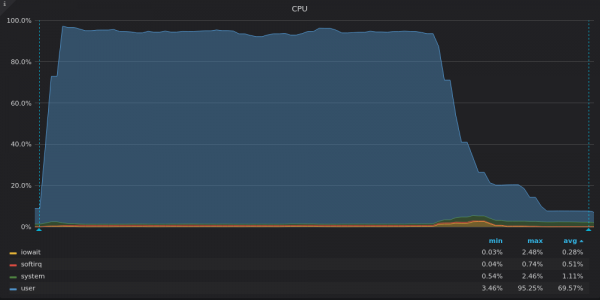
Sopra screenshot: VictoriaMetrics — Utilizzo della CPU durante il test di inserimento per una serie temporale unica di 4 milioni.
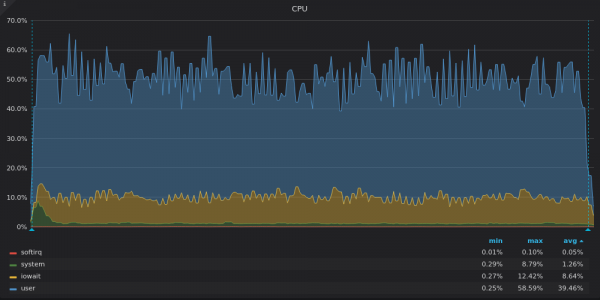
Sopra screenshot: InfluxDB — Utilizzo della CPU durante il test di inserimento per una serie temporale unica di 4 milioni.
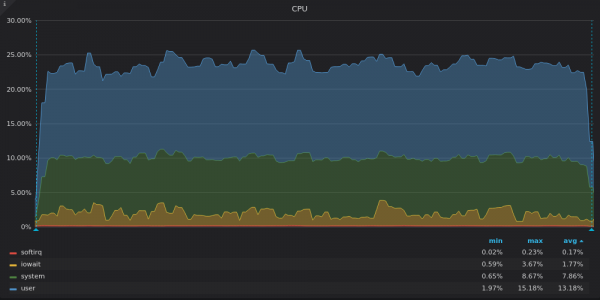
Sopra screenshot: TimescaleDB — Utilizzo della CPU durante il test di inserimento per una serie temporale unica di 4 milioni.
VictoriaMetrics utilizza quasi tutta la potenza della CPU. La diminuzione alla fine corrisponde alle fusioni LSM rimanenti dopo l'inserimento di tutti i dati.
InfluxDB utilizza solo 8 di 16 vCPU, mentre TimescaleDB utilizza 4 di 16 vCPU. Qual è la somiglianza nei loro grafici? Alta percentuale di iowait, che, ancora una volta, indica un collo di bottiglia nell'I/O.
TimescaleDB ha una alta percentuale di system. Presumiamo che l'alta potenza abbia portato a molte chiamate di sistema o a molti .
Diamo un'occhiata ai grafici di throughput del disco:
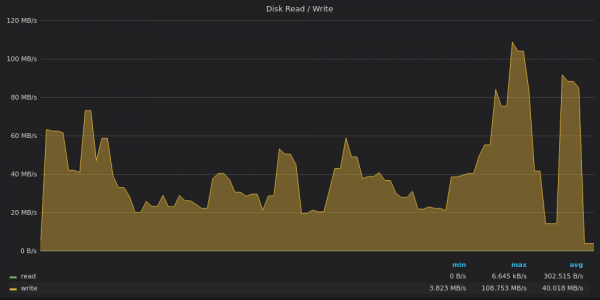
Sopra screenshot: VictoriaMetrics — Utilizzo della larghezza di banda del disco per l'inserimento di 4 milioni di metriche uniche.
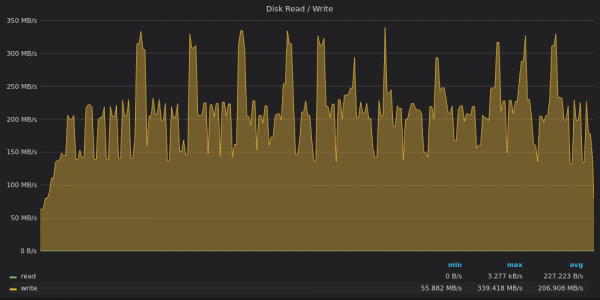
Sopra screenshot: InfluxDB — Utilizzo della larghezza di banda del disco per l'inserimento di 4 milioni di metriche uniche.
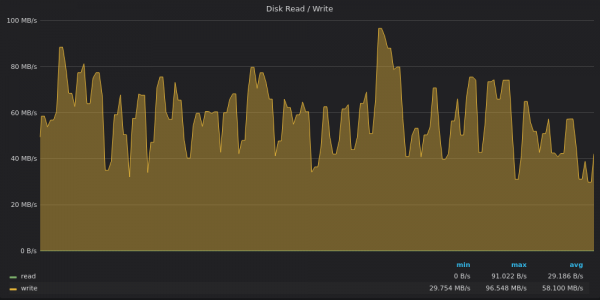
Sopra screenshot: TimescaleDB — Utilizzo della larghezza di banda del disco per l'inserimento di 4 milioni di metriche uniche.
VictoriaMetrics ha raggiunto un massimo di 120 MB/s durante i picchi, mentre la velocità media di scrittura è stata di 40 MB/s. Probabilmente durante i picchi sono state eseguite alcune pesanti fusioni LSM.
InfluxDB continua a raggiungere una media di throughput di scrittura di 200 MB/s con picchi fino a 340 MB/s su un disco con limitazione di scrittura di 120 MB/s 🙂
TimescaleDB non è più limitato dal disco. Sembra che sia limitato da qualcos'altro, legato all'alta percentuale di carico sulla CPU.
Diamo un'occhiata ai grafici di utilizzo dell'I/O:
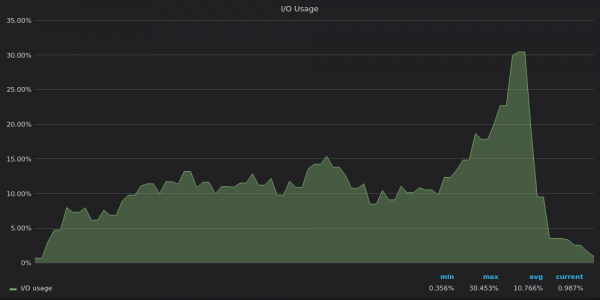
Sopra screenshot: VictoriaMetrics — Utilizzo dell'I/O durante il test di inserimento per una serie temporale unica di 4 milioni.
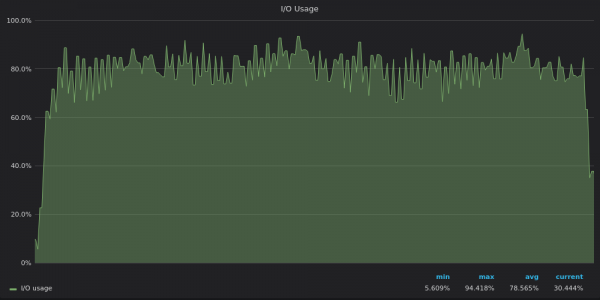
Sopra screenshot: InfluxDB — Utilizzo dell'I/O durante il test di inserimento per una serie temporale unica di 4 milioni.
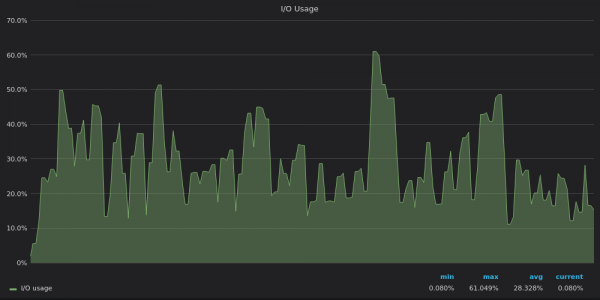
Screenshot sopra: TimescaleDB — Utilizzo dell'input-output durante il test di inserimento per una serie temporale unica di 4M.
I grafici dell'uso dell'IO seguono i grafici dell'uso della larghezza di banda del disco: InfluxDB è limitato dall'IO, mentre VictoriaMetrics e TimescaleDB hanno risorse di input-output di riserva.
40M serie temporali uniche
40M serie temporali uniche erano troppo grandi per InfluxDB 🙁
Risultati del benchmark:
- VictoriaMetrics: 1,7M punti dati al secondo; utilizzo della RAM: 29 GB; utilizzo dello spazio su disco: 17 GB.
- InfluxDB: non completato, perché richiedeva più di 60 GB di RAM.
- TimescaleDB: 330K punti dati al secondo, utilizzo della RAM: 2,5 GB; utilizzo dello spazio su disco: 84 GB.
TimescaleDB mostra un utilizzo della RAM eccezionalmente basso e stabile – 2,5 GB – tanto quanto per metriche uniche di 4M e 400K.
VictoriaMetrics è aumentata lentamente a una velocità di 100.000 punti dati al secondo, fino a quando non sono stati elaborati tutti i 40M nomi metrici con etichette. Ha quindi raggiunto una velocità di inserimento sostenuta di 1,5-2,0M punti dati al secondo, portando a un risultato finale di 1,7M punti dati al secondo.
I grafici per 40M serie temporali uniche sono simili ai grafici per 4M serie temporali uniche, quindi saltiamo questa parte.
Conclusioni
- Le moderne TSDB sono in grado di elaborare inserimenti per milioni di serie temporali uniche su un singolo server. Nel prossimo articolo verificheremo quanto bene le TSDB eseguono selezioni su milioni di serie temporali uniche.
- Un carico insufficiente della CPU di solito indica un collo di bottiglia in input-output. Inoltre, può indicare una cancellazione troppo grossolana, quando solo pochi thread possono operare contemporaneamente.
- Il collo di bottiglia in input-output esiste realmente, soprattutto in archiviazioni senza SSD, come i dispositivi di blocco virtualizzati dei fornitori di cloud.
- VictoriaMetrics fornisce la migliore ottimizzazione per archiviazioni lente con basso input-output. Offre la migliore velocità e il miglior tasso di compressione.
Scarica e provala sui tuoi dati. Il file binario statico appropriato è disponibile su .
Scopri di più su VictoriaMetrics in questo .
Aggiornamento: pubblicato con risultati riproducibili.
Aggiornamento #2: Leggi anche .
Aggiornamento #3: !
Chat Telegram:
Fonte: habr.com
