

27 maggio nell'aula principale della conferenza DevOpsConf 2019, che si svolge nell'ambito del festival , all'interno della sezione "Continuous Delivery", è stata presentata la relazione "werf — il nostro strumento per CI/CD in Kubernetes". In essa si parla di quelli problemi e sfide che tutti affrontano durante il deploy in Kubernetes, così come delle sfumature che potrebbero non essere subito evidenti. Analizzando possibili soluzioni, mostriamo come ciò sia implementato nello strumento Open Source .
Dalla presentazione, il nostro strumento (precedentemente noto come dapp) ha superato una pietra miliare storica di 1000 stelle su GitHub — speriamo che la crescente comunità di utenti ne semplifichi la vita a molti ingegneri DevOps.
Quindi, presentiamo (~47 minuti, molto più informativo dell'articolo) e un riepilogo principale in forma testuale. Andiamo!
Consegna del codice in Kubernetes
La relazione parlerà più di CI/CD in Kubernetes, implicando che il nostro software è confezionato in container Docker (ne ho parlato nella ), con K8s usato per il suo avvio in produzione (di questo ne parlo nella ).
Com'è la consegna in Kubernetes?
- Esiste un repository Git con il codice e le istruzioni per la sua compilazione. L'applicazione viene compilata in un'immagine Docker e pubblicata nel Docker Registry.
- Nel medesimo repository ci sono anche istruzioni su come eseguire il deploy e avviare l'applicazione. Durante la fase di deploy, queste istruzioni vengono inviate a Kubernetes, il quale preleva l'immagine necessaria dal registry e la avvia.
- Inoltre, di solito ci sono test. Alcuni di essi possono essere eseguiti al momento della pubblicazione dell'immagine. È anche possibile (seguendo le stesse istruzioni) distribuire una copia dell'applicazione (in uno spazio dei nomi K8s separato o in un cluster separato) e eseguire test lì.
- Infine, è necessario un sistema CI che riceve eventi da Git (o clic su pulsanti) e attiva tutte le fasi designate: build, publish, deploy, test.
Qui ci sono alcune osservazioni importanti:
- Poiché abbiamo un'infrastruttura immutabile (immutable infrastructure), l'immagine dell'applicazione, utilizzata in tutte le fasi (staging, production, ecc.), deve essere unica. Ho parlato di questo e fornito esempi .
- Poiché seguiamo l'approccio dell'infrastruttura come codice (IaC), il codice dell'applicazione, le istruzioni per la sua compilazione e avvio devono trovarsi esattamente nello stesso repository. Maggiore attenzione a questo — vedi nella .
- Catena di consegna (consegna) di solito la vediamo così: l'app è stata assemblata, testata, rilasciata (fase di rilascio) e tutto — la consegna è avvenuta. Ma in realtà, l'utente riceve ciò che hai distribuito, non quando l'hai consegnato in produzione, ma quando è riuscito a entrarvi e quella produzione ha funzionato. Perciò considero che la catena di consegna finisca solo nella fase di sfruttamento (esecuzione), e per essere più precisi, addirittura nel momento in cui il codice è stato rimosso dalla produzione (sostituendolo con uno nuovo).
Torniamo allo schema di consegna descritto sopra in Kubernetes: non lo abbiamo inventato solo noi, ma praticamente chiunque si sia occupato di questo problema. In sostanza, questo modello è ora chiamato GitOps (magari puoi leggere di più sul termine e sulle idee che lo supportano ). Diamo un'occhiata alle fasi dello schema.
Fase di assemblaggio
Sembrerebbe che cosa si possa dire nel 2019 riguardo all'assemblaggio delle immagini Docker, quando tutti sanno scrivere Dockerfile e avviare docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- Il peso dell'immagine è importante, quindi usa , per mantenere nell'immagine solo ciò che è realmente necessario per il funzionamento dell'applicazione.
- Il numero di livelli deve essere minimizzato, unendo le catene di
comandi RUNper significato. - Tuttavia, questo aggiunge problemi al debug, poiché quando si verifica un errore durante l'assemblaggio è necessario trovare il comando giusto nella catena che ha causato il problema.
- La velocità di assemblaggio è importante, perché vogliamo rilasciare rapidamente le modifiche e vedere i risultati. Ad esempio, non vogliamo ricompilare le dipendenze delle librerie del linguaggio ad ogni assemblaggio dell'app.
- Spesso da un unico repository Git sono necessari molte immagini, cosa che può essere risolta utilizzando un insieme di Dockerfile (o fasi nominate in un singolo file) e uno script Bash per la loro assemblaggio sequenziale.
Questo era solo la punta dell'iceberg con cui tutti si scontrano. Ma ci sono anche altri problemi, in particolare:
- Spesso nella fase di assemblaggio abbiamo bisogno di montare qualcosa (ad esempio, memorizzare il risultato di un comando come apt in una directory esterna).
- Vogliamo Ansible invece di dover scrivere in shell.
- Vogliamo assemblare senza Docker (perché dovremmo avere una macchina virtuale aggiuntiva in cui dover configurare tutto questo, quando abbiamo già un cluster Kubernetes che può eseguire i contenitori?).
- Assemblaggio parallelo, che può essere interpretato in vari modi: diverse istruzioni nel Dockerfile (se si utilizza multi-stage), più commit di un singolo repository, più Dockerfile.
- Build distribuito: vogliamo costruire qualcosa nei pod, che sono «effimeri», poiché perdono la cache, il che significa che deve essere memorizzata da qualche parte separatamente.
- Infine, ho chiamato il culmine dei desideri automagia: sarebbe ideale entrare nel repository, digitare un comando e ricevere un'immagine pronta, costruita comprendendo come e cosa fare correttamente. Tuttavia, personalmente non sono sicuro che tutti i dettagli possano essere previsti in questo modo.
Ecco i progetti:
- — un builder della società Docker Inc (già integrato nelle versioni attuali di Docker), che cerca di risolvere tutti questi problemi;
- — un builder di Google, che consente di costruire senza Docker;
- — un tentativo della CNCF di creare automagia e, in particolare, una soluzione interessante con rebase per i layer;
- e un sacco di altre utilità, come , …
… e guarda quante stelle hanno su GitHub. Quindi, da un lato, docker build c'è e può fare qualcosa, ma in realtà la questione non è ancora risolta — la prova di ciò è lo sviluppo parallelo di builder alternativi, ognuno dei quali affronta una parte dei problemi.
Costruzione in werf
Così siamo arrivati a (precedentemente come dapp) — un'utility open source della società Flant, che stiamo sviluppando da molti anni. Tutto è iniziato circa 5 anni fa con script Bash che ottimizzavano la costruzione dei Dockerfile, e negli ultimi 3 anni è in corso uno sviluppo completo all'interno di un progetto unico con il proprio repository Git (inizialmente in Ruby, poi in Go, e nel frattempo anche rinominata). Quali problemi di costruzione sono stati risolti in werf?
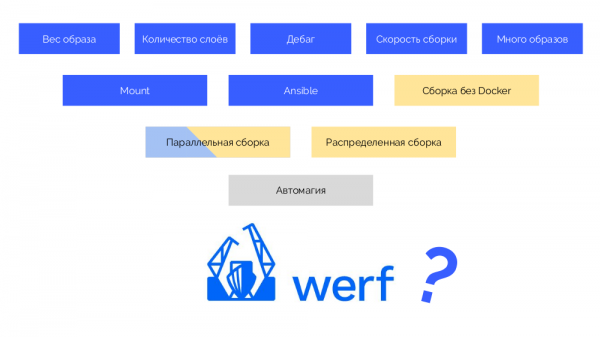
I problemi contrassegnati in blu sono già stati implementati, la costruzione parallela è stata realizzata all'interno di un singolo host, e le questioni evidenziate in giallo intendiamo completarle entro la fine dell'estate.
Fase di pubblicazione nel registry (publish)
Abbiamo raccolto docker push… — cosa potrebbe esserci di difficile nel caricare un'immagine nel registry? E qui sorge la domanda: «Quale tag assegnare all'immagine?» Nasce per il motivo che abbiamo Gitflow (o un'altra strategia di Git) e Kubernetes, e l'industria tende a far sì che ciò che avviene in Kubernetes segua ciò che viene fatto in Git. Infatti Git è la nostra unica fonte di verità.
Cosa c'è di difficile in questo? Garantire la riproducibilità: dal commit in Git, che per sua natura è immutabile (immutabile), all'immagine Docker che deve rimanere la stessa.
È anche importante per noi definire l'origine, perché vogliamo capire da quale commit è stata assemblata l'applicazione eseguita in Kubernetes (così possiamo fare diff e cose simili).
Strategie di tagging
La prima è un semplice git tag. Abbiamo un registro con un'immagine etichettata come 1.0. In Kubernetes ci sono stage e production dove è stata distribuita quest'immagine. In Git facciamo commit e a un certo punto impostiamo un tag 2.0. Lo assemblamo secondo le istruzioni del repository e lo posizioniamo nel registro con il tag 2.0. Lo distribuiamo su stage e, se va tutto bene, poi su production.
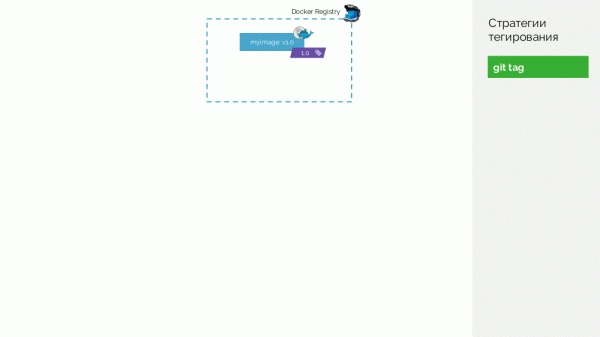
Il problema di questo approccio è che prima abbiamo impostato il tag e solo dopo abbiamo testato e distribuito. Perché? Innanzitutto, è semplicemente illogico: stiamo rilasciando una versione di software che non abbiamo nemmeno verificato (non possiamo fare diversamente, perché per testare è necessario impostare un tag). In secondo luogo, questo percorso non si sposa bene con Gitflow.
La seconda opzione è git commit + tag. Nel ramo master c'è un tag 1.0; per esso nel registro c'è l'immagine distribuita in production. Inoltre, nel cluster Kubernetes ci sono i contorni preview e staging. Successivamente seguiamo Gitflow: nel ramo principale di sviluppo (develop.) implementiamo nuove funzionalità, creando così un commit con l'identificativo #c1. Lo assemblamo e lo pubblichiamo nel registro utilizzando questo identificativo (#c1). Con lo stesso identificativo lo distribuiamo in preview. Facciamo la stessa cosa con i commit #c2 e #c3.
Quando capiamo che le funzionalità sono sufficienti, iniziamo a stabilizzare tutto. In Git creiamo un ramo release_1.1 (basato su #c3 da develop.). Non sarà necessario assemblare questa release, poiché è stata già completata nella fase precedente. Pertanto, possiamo semplicemente distribuirla su staging. Correggiamo i bug in #c4 e distribuiamo analogamente su staging. Nel frattempo, nello stesso momento, prosegue lo sviluppo in develop., dove periodicamente vengono apportate modifiche da release_1.1. A un certo punto otteniamo un commit assemblato e distribuito su staging, di cui siamo soddisfatti (#c25).
Allora facciamo merge (con fast-forward) del ramo di release (release_1.1) in master. Impostiamo su questo commit un tag con una nuova versione (1.1). Ma quest'immagine è già stata assemblata nel registro, quindi, per non doverla assemblare di nuovo, aggiungiamo semplicemente un secondo tag all'immagine esistente (ora nel registro ha i tag #c25 e 1.1). Dopo di ciò, la distribuiamo in production.
C'è uno svantaggio: su staging è stata distribuita un'immagine (#c25), mentre in production c'è come se fosse un'altra (1.1), ma sappiamo che «fisicamente» è la stessa immagine del registry.
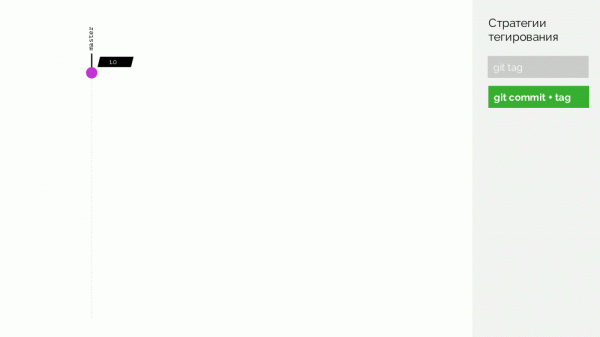
Il vero svantaggio è che non c'è supporto per i commit di merge, bisogna eseguire un fast-forward.
Possiamo andare oltre e fare un trucco... Consideriamo l'esempio di un semplice Dockerfile:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Costruiamo un file secondo questo principio, prendendo:
- SHA256 degli identificatori delle immagini utilizzate (
ruby:2.3enginx:alpine), che sono le somme di controllo del loro contenuto; - tutti i comandi (
comandi RUN,CMDecc.); - SHA256 dei file che sono stati aggiunti.
... e prendiamo la somma di controllo (ancora una volta SHA256) di tale file. Questa è la firma di tutto ciò che determina il contenuto dell'immagine Docker.
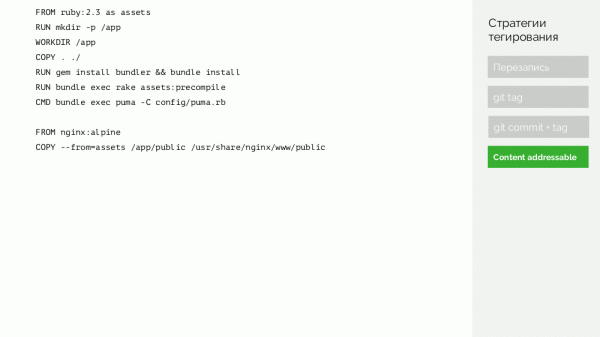
Torniamo allo schema e invece dei commit utilizzeremo tali firme, cioè taggheremo le immagini con le firme.
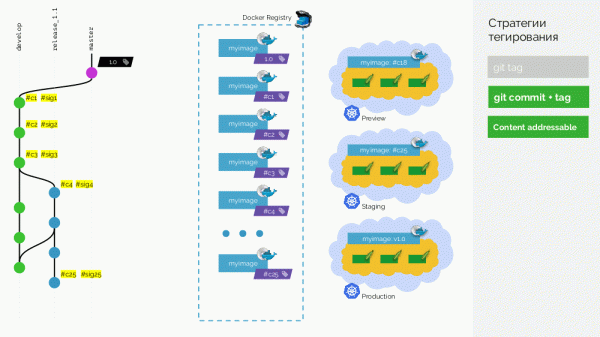
Ora, quando sarà necessario, ad esempio, fare un 'merge' delle modifiche dalla release nel master, possiamo effettuare un vero merge commit: avrà un identificatore diverso, ma la stessa firma. Con lo stesso identificatore pubblicheremo l'immagine anche in produzione.
Lo svantaggio è che ora non sarà possibile determinare quale commit è stato pubblicato in produzione: le somme di controllo funzionano solo in un senso. Questo problema si risolve con uno strato aggiuntivo di metadati — parlerò di più in seguito.
Tagging in werf
In werf siamo andati ancora oltre e ci stiamo preparando per una build distribuita con una cache che non è memorizzata su un'unica macchina... Quindi, stiamo preparando immagini Docker di due tipi, che chiamiamo stage e image.
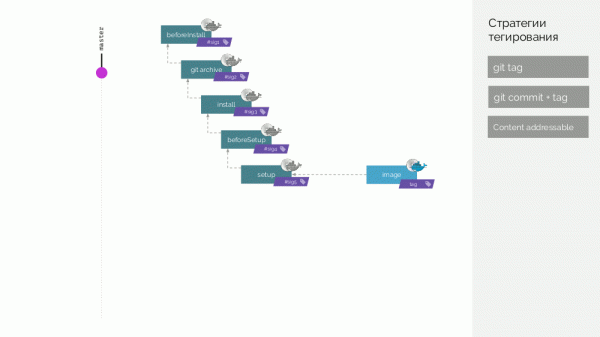
Nel repository Git di werf sono memorizzate istruzioni specifiche per la build, che descrivono diverse fasi della compilazione (beforeInstall, install, beforeSetup, setup). La prima immagine stage la costruiamo con una firma definita come somma di controllo dei primi passaggi. Poi aggiungiamo il codice sorgente, per la nuova immagine stage consideriamo la sua somma di controllo... Queste operazioni vengono ripetute per tutte le fasi, risultando in un insieme di immagini stage. Poi creiamo l'immagine finale, contenente anche metadati sulla sua origine. E questa immagine la tagghiamo in vari modi (i dettagli più avanti).
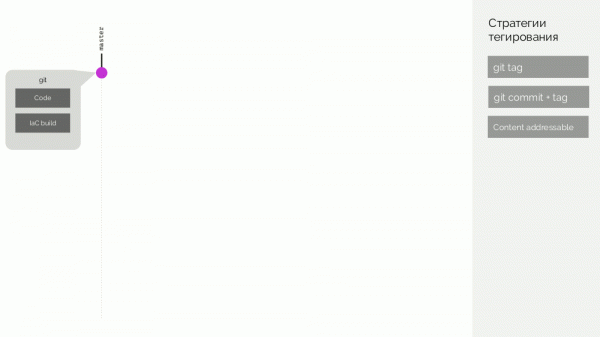
Dopo ciò, dovrebbe apparire un nuovo commit in cui è stato modificato solo il codice dell'applicazione. Cosa succederà? Per le modifiche al codice verrà creato un patch, e verrà preparata una nuova immagine stage. La sua firma sarà definita come l'hash dell'immagine stage precedente e del nuovo patch. Da questa immagine, verrà formata una nuova immagine finale.
In questo modo, le immagini stage sono una cache che possono essere memorizzate in modo distribuito, mentre le immagini create da esse vengono caricate nel Docker Registry.
Pulizia del registry
Non si tratta di eliminare i layer rimasti sospesi dopo la rimozione di tag, questo è un'opzione standard del Docker Registry stesso. Si tratta della situazione in cui si accumulano numerosi tag Docker e ci rendiamo conto che una parte di essi non ci serve più, occupando spazio (e/o di cui paghiamo).
Quali sono le strategie di pulizia?
- Si può semplicemente non pulire. A volte è davvero più semplice pagare un po' di più per spazio extra, piuttosto che districare un grosso gomitolo di tag. Ma questo funziona solo fino a un certo punto.
- Reset completo. Se si eliminano tutte le immagini e si ricompilano solo quelle attuali nel sistema CI, potrebbe sorgere un problema. Se nel production viene riavviato un contenitore, per esso verrà caricato una nuova immagine - che non è stata ancora testata da nessuno. Questo stravolge l'idea di un'infrastruttura immutabile.
- Blue-green. Un registry ha iniziato a riempirsi - carichiamo le immagini in un altro. Stessa problematica del metodo precedente: quando possiamo pulire quel registry che ha iniziato a riempirsi?
- Nel tempo. Eliminare tutte le immagini più vecchie di 1 mese? Ma troveremo sicuramente un servizio che non è stato aggiornato per un mese intero...
- Manualmente determinare cosa può essere già eliminato.
In realtà ci sono solo due opzioni praticabili: non pulire oppure una combinazione di blue-green + manuale. In quest'ultimo caso, quando si comprende che è il momento di pulire il registry, si crea un nuovo registry e si aggiungono tutte le nuove immagini in esso per un mese, ad esempio. Dopo un mese si controlla quali pod in Kubernetes continuano a utilizzare il vecchio registry e si trasferiscono anche essi nel nuovo registry.
A cosa siamo giunti in werf? Мы собираем:
- Git head: tutti i tag, tutti i rami, supponendo che tutto ciò che è taggato in Git ci serva anche nelle immagini (e se non è così, bisogna eliminarlo in Git);
- tutti i pod' attualmente estratti in Kubernetes;
- i vecchi ReplicaSet (quello che è stato recentemente estratto), e stiamo anche pianificando di scansionare i rilascio Helm e selezionare le ultime immagini lì.
… e facciamo da questo insieme un whitelist — un elenco di immagini che non elimineremo. Tutto il resto viene ripulito, dopodiché troviamo le immagini stage orfane e le rimuoviamo anche.
Fase di deploy
Affidabile dichiaratività
Il primo punto su cui vorrei attirare l'attenzione nel deploy è il rilascio della configurazione aggiornata delle risorse, dichiarata in modo dichiarativo. Il documento YAML originale con la descrizione delle risorse Kubernetes è sempre molto diverso dal risultato, effettivamente in funzione nel cluster. Perché Kubernetes aggiunge alla configurazione:
- identificatori;
- informazioni di servizio;
- numerosi valori predefiniti;
- una sezione con lo stato attuale;
- modifiche effettuate nell'ambito del funzionamento del webhook di ammissione;
- il risultato del lavoro di vari controller (e del programmatore).
Pertanto, quando appare una nuova configurazione della risorsa (new), non possiamo semplicemente riscrivere l'attuale configurazione "viva" (live). Per questo dobbiamo confrontare new con la precedente configurazione applicata (last-applied) e applicare live la patch ottenuta.
Questo approccio è conosciuto come 2-way merge. Viene utilizzato, ad esempio, in Helm.
C'è anche 3-way merge, che si differenzia per il fatto che:
- confrontando last-applied e new, guardiamo cosa è stato rimosso;
- confrontando new e live, guardiamo cosa è stato aggiunto o modificato;
- applichiamo la patch sommata su live.
Deployiamo oltre 1000 applicazioni con Helm, quindi in sostanza viviamo con 2-way merge. Tuttavia, presenta una serie di problemi che abbiamo risolto con le nostre patch, che aiutano Helm a funzionare correttamente.
Stato reale del rilascio
Dopo che il nostro sistema CI ha generato una nuova configurazione per Kubernetes in seguito a un evento, la invia per l'applicazione (apply) nel cluster — tramite Helm o kubectl apply. Successivamente avviene il già descritto N-way merge, a cui l'API di Kubernetes risponde favorevolmente al sistema CI, e questo — al suo utente.
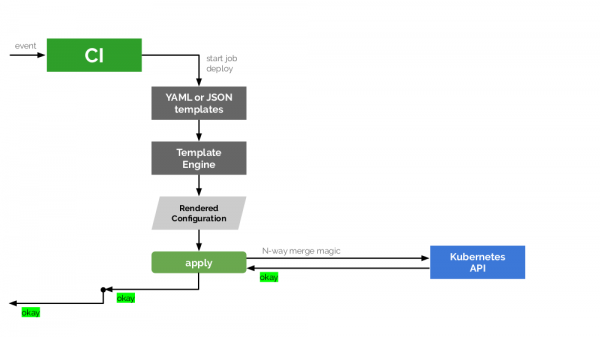
Tuttavia, c'è un enorme problema: infatti un'applicazione riuscita non significa un rilascio riuscito.Se Kubernetes capisce quali modifiche devono essere applicate, le applica — non sappiamo ancora quale sarà il risultato. Ad esempio, l'aggiornamento e il riavvio dei pod nel frontend possono riuscire, mentre nel backend no, e otterremo versioni diverse delle immagini dell'applicazione in esecuzione.
Per fare tutto correttamente, in questo schema si rende necessario un ulteriore elemento: un tracker speciale che riceverà informazioni sullo stato dall'API di Kubernetes e le trasmetterà per un'analisi più approfondita della situazione reale. Abbiamo creato una libreria Open Source in Go - (vedi il suo annuncio ), - che risolve questo problema ed è integrata in werf.
Il comportamento di questo tracker a livello di werf è configurabile tramite annotazioni che vengono applicate ai Deployments o agli StatefulSets. L'annotazione principale è fail-mode che comprende i seguenti valori:
-
IgnoreAndContinueDeployProcesssi ignorano i problemi di distribuzione di questo componente e si continua con il deploy; -
FailWholeDeployProcessImmediatelyun errore in questo componente ferma il processo di deploy; -
HopeUntilEndOfDeployProcesssi spera che questo componente funzioni entro la fine del deploy.
Ad esempio, questa combinazione di risorse e valori dell'annotazione fail-mode:
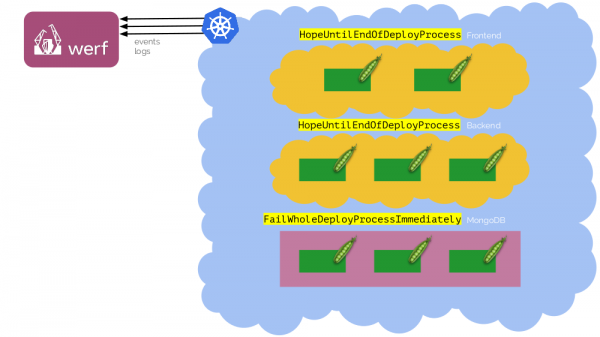
Quando si esegue il deploy per la prima volta, il database (MongoDB) potrebbe non essere ancora pronto: i Deployment potrebbero fallire. Ma si può aspettare che si avvii, e il deploy andrà comunque a buon fine.
Ci sono altre due annotazioni per kubedog in werf:
-
failures-allowed-per-replicail numero di fallimenti consentiti per ciascuna replica; -
show-logs-untilregola il punto fino al quale werf mostra (in stdout) i log di tutti i pod distribuiti. Per impostazione predefinita èPodIsReady(per ignorare i messaggi probabilmente non necessari quando il pod inizia a ricevere traffico), ma sono consentiti anche i seguenti valoriControllerIsReadyeEndOfDeploy.
Cosa vogliamo ancora dal deploy?
Oltre ai due punti già descritti, ci piacerebbe:
- vedere log ma solo quelli necessari, non tutti in generale;
- monitorare il progressoperché se un processo di lavoro rimane "silenzioso" per diversi minuti, è importante capire cosa sta accadendo;
- avere un rollback automatico nel caso in cui qualcosa vada storto (ed è quindi fondamentale conoscere lo stato reale del deploy). Il deploy deve essere atomico: o viene completato fino alla fine, o tutto torna allo stato precedente.
Conclusioni
Per noi come azienda, per implementare tutte queste sfumature in diverse fasi di consegna (build, publish, deploy) è sufficiente un sistema CI e uno strumento .
In conclusione:
Grazie a werf, abbiamo fatto notevoli progressi nella risoluzione di numerosi problemi per gli ingegneri DevOps e saremo lieti se una comunità più ampia provasse almeno questo strumento nel suo lavoro. Raggiungere buoni risultati insieme sarà più facile.
Video e slide
Video della presentazione (~47 minuti):
Presentazione della relazione:
P.S.
Altre relazioni su Kubernetes nel nostro blog:
- «» (Dmitrij Stolyarov; 27 aprile 2019 a "Stachka");
- «» (Andrey Polovov; 8 aprile 2019 a Saint HighLoad++);
- «» (Dmitrij Stolyarov; 8 novembre 2018 a HighLoad++);
- «» (Dmitrij Stolyarov; 28 maggio 2018 a RootConf);
- «» (Dmitrij Stolyarov; 7 novembre 2017 a HighLoad++);
- «» (Dmitrij Stolyarov; 6 giugno 2017 a RootConf).
Fonte: habr.com
