

Sveiki visiem! Mani sauc Pāvels Agalecskis. Es strādāju par komandas vadītāju komandā, kas izstrādā Lamoda piegādes sistēmu. 2018. gadā es uzstāju uz konferences HighLoad++, un šodien vēlos piedāvāt sava ziņojuma transkripciju.
Mans temats ir veltīts mūsu uzņēmuma pieredzei sistēmu un pakalpojumu izvietošanā dažādās vidēs. Sāksim no mūsu pirmsvēstures, kad mēs visu sistēmu izvietojumu veicām parastajos virtuālajos serveros, un noslēdzot ar pakāpenisku pāreju no Nomad uz izvietošanu Kubernetes. Pastāstīšu, kāpēc mēs to darījām un kādas problēmas mums radās šajā procesā.

Lietojumprogrammu izvietošana uz VM
Sāksim ar to, ka pirms 3 gadiem visas uzņēmuma sistēmas un pakalpojumi tika izvietoti uz parastajiem virtuālajiem serveriem. Tehniski tas tika organizēts tā, ka visa mūsu sistēmu kods atradās un tika uzbūvēts automātiskās būvēšanas veidā, izmantojot Jenkins. Ar Ansible tas tika pārvietots no mūsu versiju kontroles sistēmas uz virtuālajiem serveriem. Pie tam katra sistēma, kas bija mūsu uzņēmumā, tika izvietota vismaz uz 2 serveriem: viens no tiem — uz head, otrs — uz tail. Šiem diviem serveriem bija pilnīgi identiskas konfigurācijas, jaudas un citi uzstādījumi. Atšķirība starp tiem bija tikai tāda, ka head saņēma lietotāju trafiku, bet tail nekad saņēma lietotāju trafiku.
Kāpēc tas tika darīts?
Kad mēs izvietojām jaunus mūsu lietojumprogrammas laidienus, mēs vēlējāmies nodrošināt iespējami nemanāmu izvietošanu, tas ir, bez acīmredzamām sekām lietotājiem. Tas tika panākts, uzstādot nākamo sagatavoto laidienu uz tail ar Ansible. Tur cilvēki, kas veica izvietošanu, varēja pārbaudīt un pārliecināties, ka viss ir kārtībā: visas metriskas, sadaļas un lietojumprogrammas darbojas; tiek palaisti pareizie skripti. Tikai pēc tam, kad viņi pārliecinājās, ka viss ir kārtībā, tvertne tika pārslēgta. Trafiks sāka iet uz serveri, kas līdz tam bija tail. Savukārt tas, kas iepriekš bija head, palika bez lietotāju trafika, tomēr ar iepriekšējo mūsu lietojumprogrammas versiju.
Tādējādi lietotājiem tas bija nevainojami. Pārslēgšanās notika acumirklī, jo tā ir tikai slodzes līdzsvarotāja pārslēgšana. Ļoti viegli var atgriezties pie iepriekšējās versijas, vienkārši atgriežot slodzes līdzsvarotāju atpakaļ. Mēs arī varējām pārliecināties par lietojumprogrammas sagatavotību ražošanā vēl pirms lietotāju satiksmes iesaistes, kas bija ļoti ērti.
Kādus ieguvumus mēs redzējām visā šajā procesā?
- Pirmkārt, tas ir diezgan vienkārši darbojas. Visiem ir skaidrs, kā darbojas šāda izvietošanas shēma, jo lielākā daļa cilvēku kādreiz ir izvietojuši parastos virtuālos serverus.
- Tas ir diezgan uzticami, jo izvietošanas tehnoloģija ir vienkārša, ko izmantojušas tūkstošiem uzņēmumu. Miljoniem serveru tiek izvietoti tieši šādā veidā. Grūti kaut ko salauzt.
- Un visbeidzot, mēs varējām iegūt atomārus izvietojumus. Izvietojumi, kas lietotājiem notiek acumirklī, bez manāmas pārejas posma starp veco un jauno versiju.
Bet visā šajā procesā mēs arī redzējām dažus trūkumus:
- Papildus ražošanas videi, izstrādes videi, ir vēl citas vides. Piemēram, qa un iepriekšējā ražošanā. Tajā brīdī mums bija daudz serveru un apmēram 60 pakalpojumu. Tāpēc bija nepieciešams katram pakalpojumam uzturēt aktuālo versiju virtuālajā mašīnā. Turklāt, ja vēlaties atjaunināt bibliotēkas vai instalēt jaunas atkarības, jums tas jādara visās vidēs. Tāpat bija nepieciešams sinhronizēt laiku, kad plānojat izvietot nākamo jauno versiju savai lietojumprogrammai, ar laiku, kad devops veiks nepieciešamos vides konfigurācijas. Šādā gadījumā ir viegli nonākt situācijā, kad vide mums vairākās secīgās vidēs atšķiras. Piemēram, QA vidē būs citas bibliotēku versijas, bet ražošanā — citas, kas radīs problēmas.
- Grūtības, atjauninot atkarības jūsu lietojumprogrammai. Tas nav atkarīgs no jums, bet no citas komandas. Proti, no devops komandas, kas uztur serverus. Jums ir jāuzdod viņiem atbilstošs uzdevums un jādod apraksts par to, ko vēlaties paveikt.
- Tajā laikā mēs arī vēlējāmies sadalīt mūsu lielos monolītos mazākās atsevišķās pakalpojumu daļās, saprazdami, ka to kļūs arvien vairāk. Tajā brīdī mums jau bija vairāk nekā 100. Katram jaunajam pakalpojums nepieciešams izveidot atsevišķu jaunu virtuālo mašīnu, kuru arī jāpārvalda un jāizvieto. Turklāt, nepieciešamas ne viena, bet vismaz divas mašīnas. Tam visam klāt nāk QA vide. Tas rada problēmas un apgrūtina jaunu sistēmu izveidi un palaišanu. Tādējādi tas padara procesu sarežģītāku, dārgāku un ilgāku.
Tāpēc mēs pieņēmām lēmumu, ka būs ērtāk pāriet no parasto virtuālo mašīnu izvietošanas uz mūsu lietotņu izvietošanu Docker konteinerā. Esot Docker, ir nepieciešama sistēma, kas varēs palaist lietotni klasterī, jo konteineru vienkārši tāpat nevar pacelt. Parasti ir vēlme uzraudzīt, cik konteineru ir pacelti, lai tie tiktu pacelti automātiski. Tāpēc mums bija jāizvēlas pārvaldības sistēma.
Mēs ilgi domājām par to, kuru no tām varētu izvēlēties. Patiesībā tajā laikā mūsu izplatīšanas tehnoloģiju steks uz parastajām virtuālajām serverēm bija nedaudz novecojis, jo tur bija ne pašu jaunāko operāciju sistēmu versijas. Kādā brīdī pat tika izmantota FreeBSD, kuru nebija ērti apkalpot. Mēs sapratām, ka jāveic migrācija uz Docker pēc iespējas ātrāk. Mūsu DevOps speciālisti aplūkoja savu esošo pieredzi ar dažādajiem risinājumiem un izvēlējās sistēmu, kas tiek saukta par Nomad.
Pāreja uz Nomad
Nomad ir uzņēmuma “HashiCorp” produkts. Viņi ir pazīstami arī ar citiem risinājumiem:
«Consul» — tā ir līdzeklis pakalpojumu atklāšanai.
«Terraform» — tā ir sistēma serveru pārvaldībai, kas ļauj jums tos konfigurēt caur konfigurāciju, kas tiek saukta par infrastruktūru kā kodu.
«Vagrant» ļauj jums izvietot virtuālās mašīnas lokāli vai mākoņos, izmantojot noteiktus konfigurācijas failus.
Nomad mums tajā brīdī šķita pietiekami vienkāršs risinājums, uz kuru varēja ātri pāriet, nesasniedzot visu infrastruktūru. Turklāt to ir diezgan viegli apgūt. Tāpēc tieši to mēs izvēlējāmies kā mūsu konteineru pārvaldības sistēmu.
Kas nepieciešams, lai vispār izvietotu savu sistēmu Nomad?
- Pirmkārt, nepieciešams docker attēls jūsu lietotnes. Ir nepieciešams to uzbūvēt un ievietot docker attēlu krātuvē. Mūsu gadījumā tas ir artifactory - šāda sistēma, kas ļauj tajā izmantot dažādus artefaktus dažādos veidos. Tā spēj glabāt arhīvus, docker attēlus, PHP composer pakotnes, NPM pakotnes un tā tālāk.
- Tāpat nepieciešams konfigurācijas fails, kas pateiks Nomad, ko, kur un kādā daudzumā vēlaties izvietot.
Kad mēs runājam par Nomad, informācijas failu formātā tas izmanto HCL valodu, kas tiek īsināta kā HashiCorp Configuration Language. Tas ir supersets pār Yaml, kas ļauj jums aprakstīt savu pakalpojumu Nomad terminos.
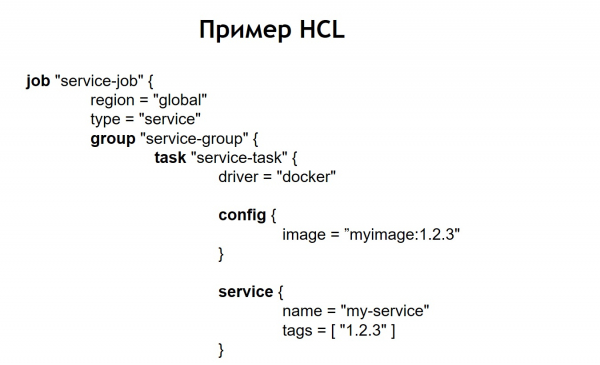
Tas ļauj pateikt, cik konteinerus vēlaties izvietot, no kādiem attēliem nodot tiem dažādus parametrus izvietošanas laikā. Tādējādi jūs piegādājat šo failu Nomad, un tas palaidīs konteinerus ražošanā saskaņā ar to.
Mūsu gadījumā mēs sapratām, ka vienkārši rakstīt pilnīgi identiskus HCL failus katram pakalpojumam nebūtu diezgan ērti, jo pakalpojumu ir daudz un dažreiz vēlas tos atjaunināt. Ir gadījumi, kad viens pakalpojums tiek izvietots ne vienā eksemplārā, bet vairākos dažādos. Piemēram, viens no mūsu ražošanas sistēmām ir vairāk nekā 100 instanču ražošanā. Tie tiek palaisti no vieniem un tiem pašiem attēliem, bet atšķiras ar konfigurācijas iestatījumiem un konfigurācijas failiem.
Tādēļ mēs nolēmām, ka mums būs ērti glabāt visus mūsu izvietošanas konfigurācijas failus vienā kopīgā repozitorijā. Tādējādi tie kļūst redzami: tos bija viegli atbalstīt un varēja redzēt, kādi sistēmas mums ir. Ja nepieciešams, arī nebūs grūti kaut ko atjaunināt vai mainīt. Jaunas sistēmas pievienošana arī nesagādās grūtības — pietiek ar to, ka tiek izveidots konfigurācijas fails jaunā direktorijā. Tajā atrodas faili: service.hcl, kas satur mūsu pakalpojuma aprakstu, un vairāki env faili, kas ļauj šim pakalpojumam, būdams izvietots ražošanā, tikt konfigurētam.
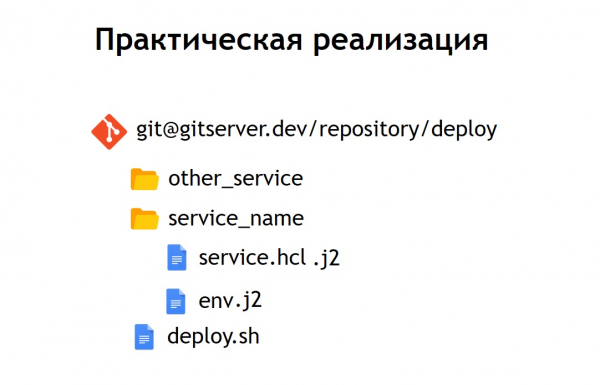
Tomēr dažas mūsu sistēmas ir izvietotas ražošanā ne vienā eksemplārā, bet vairākos uzreiz. Tāpēc mēs nolēmām, ka mums būs ērti glabāt ne konfigurāciju nesakārtotā veidā, bet to veidotos paraugus. Un kā veidņu valodu mēs izvēlējāmies jinja 2. Šādā formātā mēs glabājam gan paša pakalpojuma konfigurācijas, gan env-failus, kas ir nepieciešami tam.
Turklāt mēs pievienojām kopīgu skriptu-izvietotāju repozitorijā visiem projektiem, kas ļauj palaist un izvietot jūsu pakalpojumu ražošanā, pareizajā vidē un mērķī. Gadījumā, ja mēs pārvēršam savu HCL konfigurāciju par veidni, tad HCL fails, kas agrāk bija parasta Nomad konfigurācija, šajā gadījumā sāk izskatīties nedaudz citādāk.
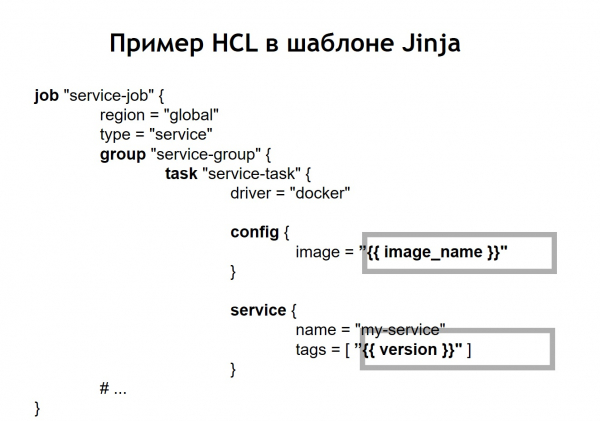
Tas nozīmē, ka mēs aizvietojām dažas vietas konfigurācijas ar mainīgo ievietojumiem, kas tiek ņemti no env-failiem vai citām avotiem. Turklāt mēs ieguvām iespēju dinamiski veidot HCL failus, tas ir, mēs varam izmantot ne tikai parastos mainīgo ievietojumus. Tā kā jinja atbalsta ciklus un nosacījumus, tajā var izveidot konfigurācijas failus, kas mainās atkarībā no tā, kur tieši jūs izvietojat savas lietotnes.
Piemēram, jūs vēlaties izvietot savu pakalpojumu pirms ražošanas un ražošanā. Pieņemsim, ka pirms ražošanas jūs nevēlaties palaist cron-skriptus, bet vienkārši vēlaties redzēt pakalpojumu uz atsevišķa domēna, lai pārliecinātos, ka tas darbojas. Ikvienam, kurš izvieto pakalpojumu, process izskatās ļoti vienkārši un caurredzami. Pietiek veikt faila deploy.sh izpildi, norādot, kuru pakalpojumu vēlaties izvietot un kādā mērķī. Piemēram, ja vēlaties izvietot kādu sistēmu Krievijā, Baltkrievijā vai Kazahstānā. Tam pietiek tikai mainīt vienu no parametriem, un jums tiks izveidots pareizais konfigurācijas fails.
Kad pakalpojums Nomad jau ir izvietots jūsu klasterī, tas izskatās šādi.
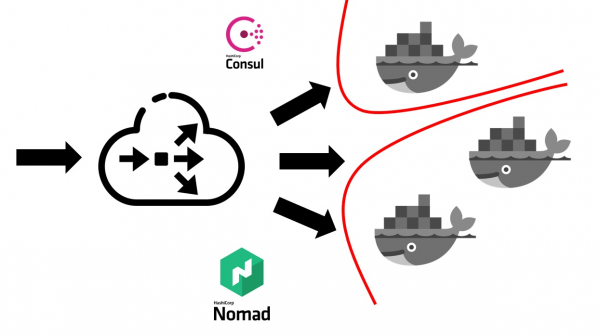
Vispirms jums nepieciešams kāds balansētājs ārpusē, kas uzņem visu lietotāju trafiku. Tas darbosies kopā ar Consul un uzzinās no tā, kur, uz kuras mezgls atrodas konkrētais pakalpojums, kas atbilst attiecīgajam domēna vārdam. IP adresi Pakalpojumi Consul parādās no paša Nomad. Tā kā šie ir vienas un tās pašas kompānijas produkti, tie ir diezgan cieši saistīti. Var teikt, ka Nomad noklusējumā spēj reģistrēt visus tajā palaistos pakalpojumus Consul iekšienē.
Pēc tam, kad jūsu ārējais līdzsvarotājs uzzina, uz kuru servisu nepieciešams novirzīt trafiku, viņš to novirza uz attiecīgo konteineru vai vairākiem konteineriem, kas atbilst jūsu lietojumprogrammai. Protams, ir jādomā arī par drošību. Pat ja visi servisi tiek palaisti uz vienām un tām pašām virtuālajām mašīnām konteineros, parasti ir nepieciešams aizliegt brīvu piekļuvi no jebkura servisa uz jebkuru citu. Mēs sasniedzām šo ar segmentāciju. Katrs serviss tika palaists savā virtuālajā tīklā, kurā bija noteikti maršrutēšanas noteikumi un noteikumi par piekļuves atļaušanu/aizliegšanu citām sistēmām un servisiem. Tie varēja atrasties gan šajā klasterī, gan ārpus tā. Piemēram, ja vēlaties aizliegt servisam piekļūt konkrētai datubāzei, to var izdarīt, segmentējot tīkla līmenī. Tādējādi pat nepareizi jūs nevarat nejauši pieslēgties no testēšanas vides jūsu ražošanas datubāzei.
Cik cilvēkresursu mums izmaksāja pārejas process?
Aptuveni 5-6 mēnešus aizņēma visas kompānijas pāreja uz Nomad. Mēs pārgājām pakalpojumu līmenī, bet diezgan ātrā tempā. Katrai komandai bija jāizveido savi konteineri saviem servisiem.
Mums ir pieņemts tāds pieejas modelis, ka katra komanda pati atbild par savu sistēmu docker attēliem. DevOps nodrošina kopējo infrastruktūru, kas nepieciešama izvietošanai, t.i., atbalstu pašu klasterim, atbalstu CI sistēmai un tā tālāk. Un tajā brīdī mums vairāk nekā 60 sistēmas bija pārgājušas uz Nomad, radot apmēram 2000 konteineru.
DevOps atbild par kopējo infrastruktūru, kas saistīta ar izvietošanu, ar serveriem. Savukārt katra izstrādes komanda atbild par savu konkrēto sistēmu konteineru īstenošanu, jo tieši komanda zina, kas tai vispār nepieciešams attiecīgajā konteinerā.
Iemesli atteikšanās no Nomad
Kādus ieguvumus mēs guvām, pārejot uz izvietošanu, izmantojot Nomad un docker, tostarp?
- Mēs nodrošinājām vienādus apstākļus visām vidēm. Izstrādē, QA vidē, priekšprodukcijā un ražošanā tiek izmantoti vieni un tie paši konteineru attēli ar vienām un tām pašām atkarībām. Līdz ar to jums praktiski nav iespēju, ka ražošanā nokļūs kaut kas cits, ko iepriekš esat testējuši lokāli vai testēšanas vidē.
- Kā arī mēs noskaidrojām, ka ir pietiekami viegls jaunā pakalpojuma pievienošanas process. Jebkuras jaunas sistēmas attiecībā uz izvietošanu tiek palaistas ļoti vienkārši. Pietiek doties uz repozitoriju, kurā tiek glabāti konfigurācijas faili, pievienot tur jaunu konfigurāciju jūsu sistēmai, un jums viss ir gatavs. Jūs varat izvietot savu sistēmu ražošanā bez papildu piepūles no devops puses.
- Viss konfigurācijas faili vienā kopējā repozitorijā izrādījās pārskatāmi. Tajā brīdī, kad mēs izvietojām mūsu sistēmas ar virtuālos serverus, mēs izmantojām Ansible, kurā konfigurācijas faili atradās vienā un tajā pašā repozitorijā. Tomēr vairumam izstrādātāju strādāt ar to bija nedaudz grūtāk. Tagad konfigurāciju un koda apjoms, ko nepieciešams pievienot, lai izvietotu pakalpojumu, kļuva daudz mazāks. Plus, devops ir ļoti viegli to labot vai mainīt. Pārveidojumu gadījumā, piemēram, uz jauno Nomad versiju, viņi var ņemt un masveidā atjaunināt visus operācijas failus, kas atrodas vienā un tajā pašā vietā.
Tomēr mēs saskārāmies arī ar dažiem trūkumiem:
Izrādījās, ka mēs nevarējām sasniegt nevainojamu izvietojumu gadījumā ar Nomad. Izvietojot konteinerus no dažādām vidēm, varēja gadīties, ka tas tika palaists, un Nomad to uzskatīja par gatavu pieņemt trafiku. Tas notika vēl pirms aplikācija iekšā bija paspējusi startēt. Šī iemesla dēļ sistēma uz īsu laiku sāka izsniegt 500. kļūdas, jo trafiks sāka plūst uz konteineru, kuru vēl nebija gatavs pieņemt.
Mēs saskārāmies ar vairākiem kļūdām. Visbūtiskākais kļūdas punkts ir tas, ka Nomad ne īpaši labi uztver lielu klasteri, ja jums ir daudz sistēmu un konteineru. Kad vēlaties izņemt apkalpošanā vienu no serveriem, kas ir iekļauts Nomad klasterī, pastāv pietiekami liela iespēja, ka klasteris jūtas slikti un sabrūk. Daļa konteineru var, piemēram, nokrist un neuzcelties — tas jums vēlāk izmaksās ļoti dārgi, ja visas jūsu sistēmas atrodas ražošanā tieši klasterī, ko pārvalda Nomad.
Tāpēc mēs nolēmām padomāt, kur mēs dosimies tālāk. Tajā brīdī mēs daudz labāk apzinājāmies, ko vēlamies sasniegt. Proti: mēs vēlamies uzticamību, nedaudz vairāk funkciju, nekā sniedz Nomad, un nobriedušu, stabilāku sistēmu.
Šajā ziņā mūsu izvēle krita uz Kubernetes kā uz vispopulārāko platformu klasteru palaišanai. Īpaši ņemot vērā, ka mūsu konteineru izmērs un skaits bija pietiekami liels. Šādiem mērķiem Kubernetes šķita vispiemērotākā sistēma no tām, kuras mēs varējām apskatīt.
Pāreja uz Kubernetes
Nedaudz pastāstīšu par to, kādi ir galvenie Kubernetes jēdzieni un kā tie atšķiras no Nomad.
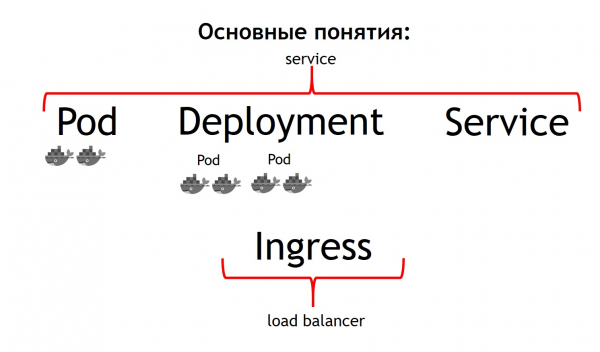
Vispirms pats pamata jēdziens Kubernetes ir pod. Pod — tā ir viena vai vairāku konteineru grupa, kas vienmēr tiek palaista kopā. Un tie darbojas tā, it kā vienmēr būtu stingri vienā virtuālā mašīnā. Tie ir pieejami viens otram pa IP adresi 127.0.0.1 uz dažādiem portiem.
Pieņemot, ka jums ir PHP lietojumprogramma, kas sastāv no nginx un php-fpm – klasiskā shēma. Drīzāk jūs vēlēsieties, lai gan nginx, gan php-fpm konteineri vienmēr būtu kopā. Kubernetes ļauj to sasniegt, aprakstot tos kā vienu kopīgu pod. Tieši to mēs nevarējām iegūt, izmantojot Nomad.
Otrs jēdziens ir deployment. Proti, pod pats par sevi ir efemēra lieta, tā tiek palaista un pazūd. Vai vēlaties vispirms nogalināt visus savus iepriekšējos konteinerus, un pēc tam uzreiz palaist jaunās versijas, vai tomēr vēlaties tās izlaižot pakāpeniski – tieši par šo procesu atbild jēdziens deployment. Tas apraksta, kā jūs izvieto savus podus, kādā daudzumā un kā tos atjaunot.
Trešais jēdziens ir service. Jūsu service faktiski ir jūsu sistēma, kas pieņem noteiktu datu plūsmu un pēc tam novirza to uz vienu vai vairākiem podiem, kas atbilst jūsu servisam. Tas nozīmē, ka tas ļauj norādīt, ka visa ienākošā datu plūsma uz konkrētu servisu ar noteiktu nosaukumu ir jānosūta tieši uz šiem podiem. Turklāt tas nodrošina jums datu plūsmas balansēšanu. Tas nozīmē, ka jūs varat palaist divus jūsu lietojumprogrammas podus, un visa ienākošā datu plūsma tiks vienmērīgi līdzsvarota starp attiecīgajiem šī servisa podiem.
Un ceturtā pamatjēdziena — Egress. Tas ir serviss, kas tiek palaists Kubernetes klasterī. Tas kalpo kā ārējais slodzes balansētājs, kas pieņem visus pieprasījumus. Izmantojot Kubernetes Ingress API, var noteikt, kur šos pieprasījumus nosūtīt. Turklāt viņš to dara ļoti elastīgi. Jūs varat pateikt, ka visi pieprasījumi uz šo hostu un tādu URL tiek nosūtīti uz šo servisu. Savukārt šos pieprasījumus, kas nāk uz šo hostu un citu URL, nosūtām uz citu servisu.
Visvairāk satriecošais no izstrādātāja perspektīvas ir tas, ka jūs varat patstāvīgi vadīt visu šo procesu. Norādot Ingress konfigurāciju, varat visu ienākošo datu plūsmu, kas nāk uz noteiktu API, nosūtīt uz atsevišķiem konteineriem, kas piemēram, ir uzrakstīti Go. Bet šo datu plūsmu, kas nāk uz to pašu domēnu, bet uz citu URL, nosūtīt uz konteineriem, kas uzrakstīti PHP, kur ir daudz loģikas, bet tie nav ļoti ātri.
Ja salīdzina visus šos jēdzienus ar Nomad, var teikt, ka pirmie trīs jēdzieni kopumā veido Service. Savukārt pēdējais jēdziens Nomad iekšienē nebūt nav. Mēs to aizvietojām ar ārēju slodzes balansētāju: tas var būt haproxy, nginx, nginx+ un tā tālāk. Gadījumā ar Kubernetes jums nav jāievieš šis papildu jēdziens atsevišķi. Tomēr, ja paskatās uz Ingress iekšienē, tad tas ir vai nu nginx, vai haproxy, vai traefik, bet kāda veidā iebūvēts Kubernetes.
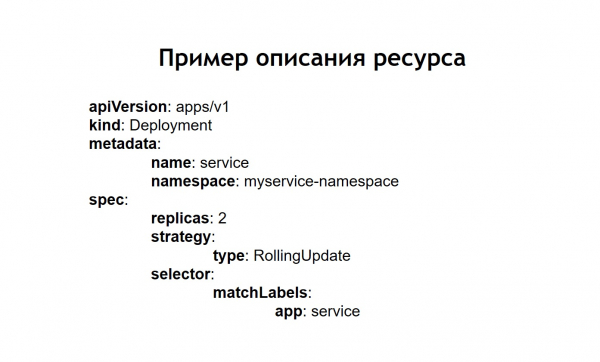
Visi manis aprakstītie jēdzieni ir, būtībā, resursi, kas pastāv Kubernetes klasterī. To aprakstīšanai Kubernetes izmanto yaml formātu, kas ir lasāmāks un ierastāks nekā HCL faili Nomad gadījumā. Taču strukturāli tie apraksta, piemēram, podu, to pašu. Viņi saka — vēlos izvietot noteiktus podus tur, ar noteiktiem attēliem, noteiktā daudzumā.
Turklāt mēs sapratām, ka nevēlamies manuāli izveidot katru resursu: deployment, pakalpojumus, Ingress un citus. Tā vietā mēs vēlējāmies, lai izvietošanas laikā katru mūsu sistēmu aprakstītu Kubernetes terminoloģijā, lai nebūtu nepieciešams roku darbs, atkārtojot visas nepieciešamās resursu atkarības. Šādai sistēmai, kas ļāva mums to paveikt, tika izvēlēts Helm.
Pamata jēdzieni Helm
Helm – tas ir pakotņu pārvaldnieks Kubernetes. Tas ir ļoti līdzīgs tam, kā darbojas pakotņu pārvaldnieki programmēšanas valodās. Tie ļauj jums uzglabāt pakalpojumu, kas sastāv, piemēram, no deployment nginx, deployment php-fpm, konfigurācijas Ingress, configmaps (tās ir entitātes, kas ļauj jums norādīt env un citus parametrus jūsu sistēmai) kā tā dēvētos chart. Turklāt Helm darbojas virs Kubernetes. Tas nav kāda sistēma, kas stāv malā, bet drīzāk vēl viens pakalpojums, kas darbojas kubā. Jūs mijiedarbojaties ar to caur tā API, izmantojot konsoles komandu. Tās ērtums un priekšrocība ir tāda, ka pat ja helm sabojājas vai jūs to izdzēsīsiet no klastera, jūsu pakalpojumi nepazudīs, jo helm pamatā kalpo tikai sistēmas palaišanai. Par pakalpojumu darbību un stāvokli tālāk atbild pats Kubernetes.
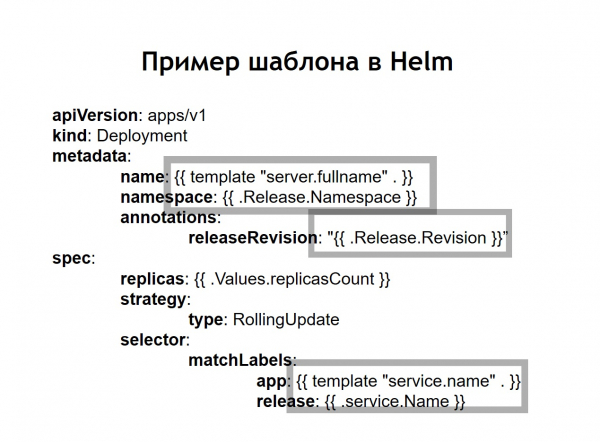
Mēs arī sapratām, ka šablonēšana, ko līdz šim bijām spiesti veikt paši, ieviešot jinja mūsu konfigurācijās, ir viena no galvenajām helm funkcijām. Visas konfigurācijas, kuras izveidojat savām sistēmām, tiek uzglabātas helm šablonu veidā, kas nedaudz atgādina jinja, taču patiesībā izmanto Go valodas šablonēšanu, kurā ir uzrakstīts helm, tāpat kā Kubernetes.
Helm pievieno vēl dažas papildu definīcijas.
Chart — tas ir jūsu pakalpojuma apraksts. Citos pakotņu pārvaldniekos to dēvētu par pakotni, bundle vai kaut ko tamlīdzīgu. Šeit tas tiek dēvēts par chart.
Values – tās ir mainīgās vērtības, kuras vēlaties izmantot, lai izveidotu savus konfigurācijas no šabloniem.
IzlaidumsKatru reizi, kad pakalpojums, kas tiek izvietots ar helm palīdzību, saņem inkrementālo versiju. Helm atceras, kāds bija pakalpojuma konfigurācija iepriekšējā, pāris iepriekšējā izdevumā un tā tālāk. Tāpēc, ja nepieciešams atgriezties atpakaļ, pietiek izpildīt komandu helm callback, norādot iepriekšējo versiju. Pat ja attiecīgā konfigurācija jūsu krātuvē brīdi atgriešanās nav pieejama, helm tomēr atceras, kā tā bija, un atgriezīs jūsu sistēmu tajā stāvoklī, kādā tā bija iepriekšējā izdevumā.
Ja gadījumā, kad mēs izmantojam helm, parastās konfigurācijas Kubernetes arī pārvēršas par šabloniem, kuros ir iespēja izmantot mainīgās, funkcijas, piemērot nosacījumus. Tādējādi, jūs varat veidot sava pakalpojuma konfigurāciju atkarībā no vides.
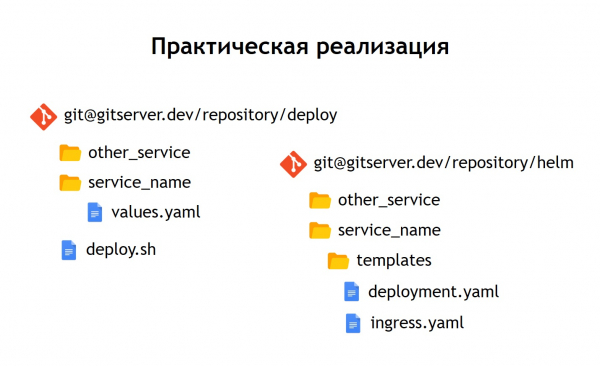
Praktiski mēs izlemām rīkoties nedaudz citādi, nekā to darījām gadījumā ar Nomad. Ja Nomad vienā krātuvē tika glabātas gan konfigurācijas izvietošanai, gan n-mainīgie, kas nepieciešami mūsu pakalpojuma izvietošanai, tad šeit mēs nolēmām tos sadalīt divās atsevišķās krātuvēs. Krātuvē "deploy" tiek glabāti tikai n-mainīgie, kas nepieciešami izvietošanai, bet krātuvē "helm" tiek glabātas konfigurācijas vai charti.
Ko tas mums deva?
Neskatoties uz to, ka pašos konfigurācijas failos mēs neglabājam kādus patiesi jutīgus datus, piemēram, paraugus uz datubāzēm. Tie tiek glabāti kā secrets Kubernetes, tomēr tur joprojām ir atsevišķas lietas, pie kurām mēs negribam ļaut piekļūt visiem. Tāpēc piekļuve krātuvēm "deploy" ir ierobežotāka, bet krātuve "helm" satur tikai pakalpojuma aprakstu. Šī iemesla dēļ tajā droši var pieksties plašākam personu lokam.
Ņemot vērā, ka mums ir ne tikai ražošanas, bet arī citas vides, tādējādi, pateicoties šādai sadalei, mēs varam atkārtoti izmantot mūsu helm chartus, lai izvietotu pakalpojumus ne tikai ražošanā, bet arī, piemēram, QA vidē. Pat tādā veidā, lai tos izveidotu lokāli, izmantojot Minikube — tā ir šāda lieta lokālai Kubernetes palaišanai.
Katrs repozitorijs satur atsevišķas direktorijas katram pakalpojumam. Tas nozīmē, ka katrā direktorijā atrodas veidnes, kas saistītas ar konkrēto diagrammu un apraksta resursus, kas jāizvieto, lai uzsāktu mūsu sistēmu. Repzitorijā „deploy” mēs esam atstājuši tikai envs. Šajā gadījumā mēs neizmantojām jinja veidņu veidošanu, jo helm nodrošina veidņu veidošanu tieši iebūvētā veidā – tā ir viena no tā galvenajām funkcijām.
Mēs esam atstājuši izvietošanas skriptu – deploy.sh, kas vienkāršo un standartizē izvietošanas palaišanu ar helm. Tādējādi, ikvienam, kurš vēlas izvietot, izvietošanas saskarne izskatās tieši tāpat kā bija gadījumā, ja to veica ar Nomad. Tāds pats deploy.sh, jūsu pakalpojuma nosaukums un vieta, kur vēlaties to izvietot. Tas noved pie tā, ka tiek palaists helm. Tas savukārt apkopo konfigurācijas no veidnēm, aizvieto tajās nepieciešamās values-failes un pēc tam izvieto, palaidams tās Kubernetes.
Secinājumi
Kubernetes pakalpojums izskatās sarežģītāks nekā Nomad.
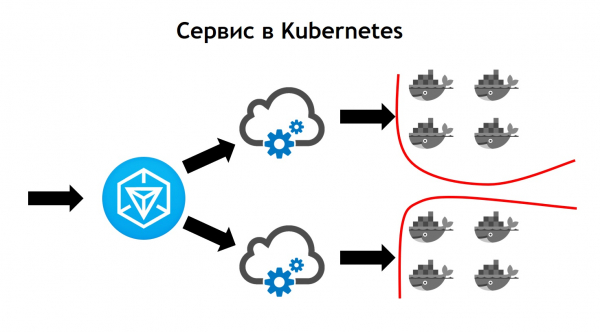
Šeit izejošais datu plūsma nonāk Ingress. Tas ir tieši priekšējais kontrolieris, kas pieņem visus pieprasījumus un pēc tam sūta tos uz attiecīgajiem pakalpojumiem, kas atbilst pieprasījumam. Tas tos nosaka, pamatojoties uz konfigurācijām, kas ir daļa no jūsu lietojumprogrammas apraksta helm un kuras izstrādātāji nosaka paši. Pakalpojums pēc tam sūta pieprasījumus uz saviem podiem, tas ir, konkrētām konteinerēm, līdzsvarojot ienākošo datu plūsmu starp visām konteinēriem, kas pieder šim pakalpojumam. Un, protams, nevajadzētu aizmirst par to, ka no tīkla drošības viedokļa mēs nedrīkstam doties nekur. Tādēļ Kubernetes klastra iekšienē darbojas segmentācija, kas balstās uz marķēšanu. Visām pakalpojumiem ir noteikti marķējumi, pie kuriem ir saistītas pakalpojumu piekļuves tiesības attiecībā uz dažādiem ārējiem / iekšējiem resursiem iekšpusē vai ārpus klastera.
Pārejā gadījumā mēs redzējām, ka Kubernetes piedāvā visas iespējas, ko iepriekš nodrošināja Nomad, ko mēs izmantojām, kā arī pievieno daudz jauna. To var paplašināt, izmantojot spraudņus, praktiski caur pielāgotajiem resursu veidiem. Tas nozīmē, ka jums ir iespēja ne tikai izmantot to, kas nāk kopā ar Kubernetes, bet arī izveidot savu resursu un pakalpojumu, kas lasīs jūsu resursu. Tas sniedz papildu iespējas jūsu sistēmas paplašināšanai bez nepieciešamības pārinstalēt Kubernetes un bez vajadzības veikt izmaiņas.
Piemērs tādai izmantošanai ir Prometheus, kas darbojas mūsu Kubernetes klasterī. Lai tas sāktu vākt metrikas no kāda pakalpojuma, mums jāpapildina pakalpojuma apraksts ar papildu resursu veidu, tā saucamo pakalpojuma monitoru. Prometheus, spējot lasīt pielāgoto resursu veidus, automātiski sāk vākt metrikas no jaunās sistēmas. Tas ir diezgan ērti.
Pirmais nolikums, ko mēs veicām Kubernetes, bija 2018. gada martā. Un kopš tā laika mēs nekad neesam saskārušies ar nekādas problēmām. Tas darbojas diezgan stabilīgi bez būtiskiem kļūdām. Turklāt mēs to varam tālāk paplašināt. Šodien mums pietiek ar iespējām, kas tajā ir, un mums ļoti patīk Kubernetes attīstības temps. Pa šodienai vairāk nekā 3000 konteineru ir Kubernetes. Klasteris aptver vairākus mezglus. Tajā pašā laikā tas ir apkalpots, stabils un ļoti kontrolēts.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish