

Linux ir liels skaits rīku, lai debugētu kodolu un lietojumprogrammas. Lielākā daļa no tiem negatīvi ietekmē lietojumprogrammu veiktspēju un tos nevar izmantot ražošanā.
Pirms dažiem gadiem tika izstrādāts vēl viens rīks Šobrīd jau pastāv daudzi lietojumprogrammu rīki, kas izmanto eBPF, un šajā rakstā mēs apskatīsim, kā uzrakstīt savu profila rīku, pamatojoties uz bibliotēku
PythonBCC Ceph ir lēns
Cehā Ceph pievienots jauns hosts. Pēc datu daļas migrācijas uz to mēs pamanījām, ka rakstīšanas pieprasījumu apstrādes ātrums ir ievērojami zemāks nekā citos serveros.
Atšķirībā no citām platformām, šajā hostā tika izmantots bcache un jauns linux kodols 4.15. Šādas konfigurācijas hosts šeit tika izmantots pirmo reizi. Un brīdī, kad tas notika, bija skaidrs, ka problēmu cēlonis teorētiski varētu būt jebkas.
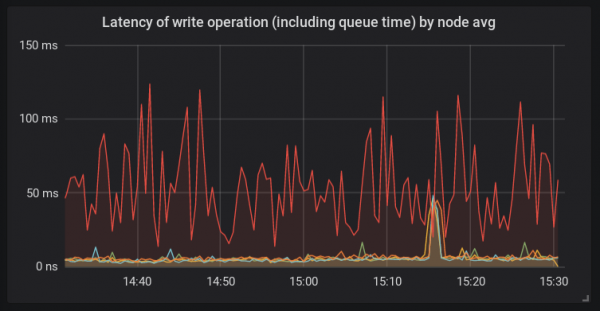
Izpētot hostu
Sāksim ar to, ka paskatīsimies, kas notiek ceph-osd procesā. Lai to izdarītu, mēs izmantosim
perf un Attēls norāda, ka funkcija ):
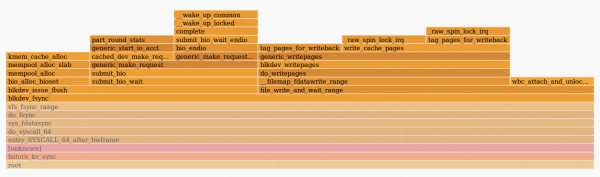
tērēja daudz laika pieprasījuma nosūtīšanā funkcijā fdatasync() generic_make_request() . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi.Pārbaudot hostu, mēs atklājām, ka dema systemd-udevd patērē lielu CPU laiku — apmēram 20% vairākos kodolos. Šī ir dīvaina uzvedība, tāpēc nepieciešams noskaidrot tās iemeslu. Tā kā Systemd-udevd darbojas ar uevent'iem, mēs nolēmām tos izvērtēt, izmantojot
udevadm monitor . Izrādījās, ka sistēmā tika ģenerēts liels skaits change notikumu katram blokēšanas ierīcei. Tas ir diezgan neparasti, tāpēc būs jāskatās, kas ģenerē visus šos gadījumus.Izmantojot BCC rīku komplektu
Kā jau mēs noskaidrojām, kodols (un ceph dema sistēmas izsaukumā) tērē daudz laika
. Mēģināsim izmērīt šīs funkcijas darbības ātrumu. Jau . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi.pastāv lielisks rīks — funclatency funclatency. Mēs izsekosim demonam pēc tā PID ar intervālu starp informācijas izvadēm 1 sekunde un izvadīsim rezultātu milisekundēs.
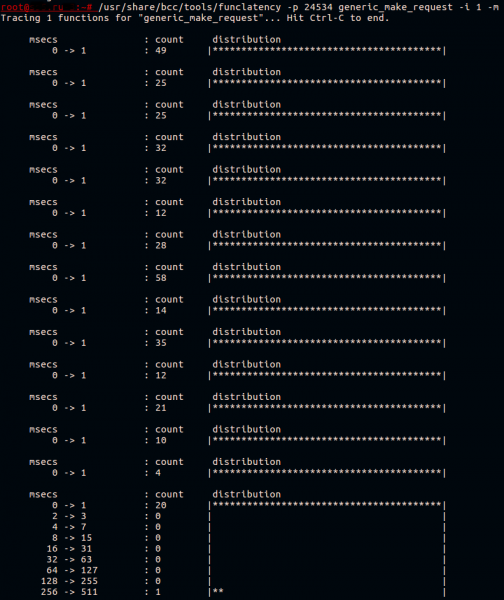
Parasti šī funkcija darbojas ātri. Viss, ko tā dara – pārsūta pieprasījumu uz ierīces draivera rindu.
Bcache ir kompleksa ierīce, kas faktiski sastāv no trim diskdziņiem:
- backing device (kešējams disks), šajā gadījumā tas ir lēns HDD;
- caching device (kešējošais disks), šeit tas ir viens NVMe ierīces nodalījums;
- virtuālo ierīci bcache, ar kuru darbojas lietotne.
Mēs zinām, ka pieprasījuma pārsūtīšana aizkavējas, bet kura no šīm ierīcēm? Par to runāsim nedaudz vēlāk.
Šobrīd mēs zinām, ka uevent'i, iespējams, izraisa problēmas. Atrast, kas tieši izraisa to ģenerāciju, nav tik viegli. Pieņemam, ka tas ir kāds softs, ko periodiski palaidz. Apskatīsim, kurš softs tiek palaidīts sistēmā, izmantojot skriptu execsnoop no tā paša . Palaidīsim to un novirzīsim izvadi uz failu.
Piemēram, šādi:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Neizvirzīsim šeit pilnu execsnoop izvadi, bet viena interesējoša rinda izskatījās šādi:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Trešā kolonna ir PPID (vecāku PID) procesa. Process ar PID 5802 izrādījās viens no mūsu uzraudzības sistēmas pavedieniem. Pārbaudot uzraudzības sistēmas konfigurāciju, tika atrastas nepareizi iestatītas parametru vērtības. HBA adaptera temperatūra tika nolasīta katras 30 sekundes, kas bija daudz biežāk nekā nepieciešams. Pēc pārbaudes intervāla pagarināšanas mēs atklājām, ka pieprasījumu apstrādes aizture šajā hostā vairs nav izteikta, salīdzinot ar pārējiem hostiem.
Bet joprojām nav skaidrs, kāpēc bcache ierīce tik aizkavējās. Mēs izveidojām testēšanas platformu ar identisku konfigurāciju un mēģinājām reproducēt problēmu, palaidzot fio uz bcache, periodiski palaidzot udevadm trigger ģenerācijai.
Rakstīt BCC bāzētus rīkus
Mēģināsim uzrakstīt vienkāršu utilītu izsekošanai un ekrānā izvadīšanai vislēnākajiem zvaniem . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi.. Mūs arī interesē diska nosaukums, kuram tika izsaukta šī funkcija.
Plāns ir vienkāršs:
- Reģistrējam kprobe uz . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi.:
- Saglabājam atmiņā diska nosaukumu, kas pieejams caur funkcijas argumentu;
- Saglabājam laika zīmogu.
- Reģistrējam kretprobe uz atgriešanos no . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi.:
- Saņemam pašreizējo laika zīmogu;
- Meklējam saglabāto laika zīmogu un salīdzinām to ar pašreizējo;
- Ja, ja rezultāts ir lielāks par noteikto, tad atrodam saglabāto diska nosaukumu un izvadām to terminālā.
Kprobes un kretprobes izmanto punktu pārtraukšanas mehānismu, lai dinamiski mainītu funkciju kodu. Jūs varat izlasīt un rakstu par šo tēmu. Ja aplūko dažādu utilītu kodu, tad var pamanīt, ka tām ir identiska struktūra. Tādēļ šajā rakstā mēs izlaidīsim skripta argumentu parsēšanu un pāriesim pie pašas BPF programmas. Teksts eBPF iekš python skripta izskatās šādi:
bpf_text = """ # Šeit būs bpf programmas kods """
Lai apmainītos ar datiem starp funkcijām, eBPF programmas izmanto
hash-tabulas struct data_t { u64 pid; u64 ts; char comm[TASK_COMM_LEN]; u64 lat; char disk[DISK_NAME_LEN]; };BPF_HASH(p, u64, struct data_t); BPF_PERF_OUTPUT(events);
Šeit mēs reģistrējam hash-tabulu, kas saucas
, ar atslēgas tipu pun vērtību tipu u64 struct data_t . Tabula būs pieejama mūsu BPF programmas kontekstā. Makro BPF_PERF_OUTPUT reģistrē citu tabulu, kas saucas, un tā tiek izmantota eventsdatenu pārsūtīšanai Izmērot aizturi starp funkcijas izsaukumu un tās atgriešanos, vai starp dažādu funkciju izsaukumiem, jāņem vērā, ka iegūtajiem datiem jāpieder vienam kontekstam. Citiem vārdiem sakot, jāatceras par iespējamu funkciju paralēlu izpildi. Mums ir iespēja izmērīt aizturi starp funkcijas izsaukumu viena procesa kontekstā un atgriešanos no šīs funkcijas cita procesa kontekstā, bet tas, visticamāk, būs bezjēdzīgi. Labi piemērs var būt
utilita biolatency struct request , kas atspoguļo vienu pieprasījumu uz disku.Pēc tam mums jāuzraksta kods, kas tiks izpildīts, kad tiek izsaukta pētāmā funkcija:
void start(struct pt_regs *ctx, struct bio *bio) { u64 pid = bpf_get_current_pid_tgid(); struct data_t data = {}; u64 ts = bpf_ktime_get_ns(); data.pid = pid; data.ts = ts; bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name); p.update(&pid, &data); }
Šeit kā otrais arguments tiks aizvietots ar pirmo izsauktās funkcijas argumentu.
Pēc tam mēs iegūstam procesa PID, kurā darbojamies, un pašreizējo laika zīmogu nanosekundēs. Viss tiek ierakstīts jaunizveidotajā struct data_t data struct data_t dataDisku nosaukumu iegūstam no struktūras bio, kas tiek nodota izsaukuma laikā . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi., un saglabājam to tajā pašā struktūrā data. Pēdējais solis ir ieraksta pievienošana iepriekš minētajā hash tabulā.
Nākamā funkcija tiks izsaukta atgriežoties no . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi.:
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts) / 1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Šī funkcija ir līdzīga iepriekšējai: mēs uzzinām procesa PID un laika zīmogu, bet neizveidojam jaunu data struktūru. Tā vietā mēs meklējam esošo struktūru hash tabulā, izmantojot atslēgu == pašreizējo PID. Ja struktūra tiek atrasta, mēs uzzinām palaistā procesa nosaukumu un pievienojam to tai.
Binārais pārvietojums, ko mēs šeit izmantojam, ir nepieciešams, lai iegūtu pavediena GID, t.i., PID galvenajam procesam, kas uzsāka pavedienu, kurā mēs strādājam. Mūsu izsauktā funkcija atgriež gan pavediena GID, gan tā PID vienā 64-bit vērtībā.
Izvades terminālī mūs pašlaik neinteresē pavediena, bet interesē galvenais process. Pēc saņemtās kavēšanās salīdzināšanas ar noteikto slieksni mēs nododam savu struktūru data lietotāja telpā caur tabulu events, pēc tam dzēšam ierakstu no p.
Python skriptā, kas ielādēs šo kodu, mums būs jāaizvieto MIN_US un FACTOR ar kavēšanās sliekšņiem un laika vienībām, kuras mēs nodosim caur argumentiem:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Tagad mums jāpreparē BPF programma caur un jāreģistrē mēri:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Mums arī būs jādefinē . Tabula būs pieejama mūsu BPF programmas kontekstā. Makro BPF_PERF_OUTPUT reģistrē citu tabulu, kas saucas mūsu skriptā, pretējā gadījumā neko nevarēsim izlasīt:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Pēdējais solis — datu izvade uz termināla:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Scripts ir pieejams . Mēģināsim to palaist izmēģinājuma platformā, kur darbojas fio, rakstot uz bcache, un izsaukt udevadm monitor:
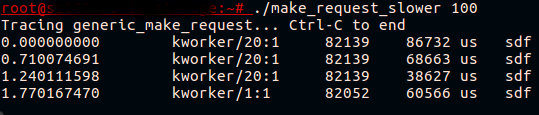
Beidzot! Tagad mēs redzam, ka tas, kas izskatījās kā bcache ierīces aizkave, patiesībā ir aizkave, kas notiek . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi. kā rezultātā no kešotā diska.
Iedziļinieties Kernel
Kas tieši aizkavē pieprasījuma nodošanu? Mēs redzam, ka aizkave rodas pat pirms pieprasījuma kontā, t.i., konkrēta pieprasījuma uzskaitīšana turpmākai statistikas izsniegšanai (/,proc/,diskstats vai iostat) vēl nav sākusies. To ir viegli pārbaudīt, palaist iostat problēmas reproducēšanas laikā, vai , kas balstās uz pieprasījuma kontēšanas sākumu un beigām. Neviens no šiem rīkiem neparādīs problēmas pieprasījumiem uz kešoto disku.
Ja mēs paskatāmies uz funkciju . Tas nozīmē, ka, visticamāk, problēmu cēlonis atrodas ārpus paša osd dema. Tas var būt gan kodols, gan diski. iostat izvade parādīja augstu bcache disku pieprasījumu apstrādes aizturi., mēs redzam, ka pirms pieprasījuma konta tiek izsauktas vēl divas funkcijas. Pirmā — generic_make_request_checks(), veic pieprasījuma likumības pārbaudes attiecībā uz diska iestatījumiem. Otrā — , kurā ir interesants izsaukums, :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Šajā funkcijā kodols gaida, kad queue tiek atkausēta. Mēs izmērīsim aizkavi blk_queue_enter():
~# /usr/share/bcc/tools/funclatency blk_queue_enter -i 1 -m
Izsekoju 1 funkciju "blk_queue_enter"... Nospiediet Ctrl-C, lai pabeigtu.

 	msecs           	: skaits 	distribūcija
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: skaits 	distribūcija
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: skaits 	distribūcija
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Izskatās, ka mēs esam tuvu atminējuma. Funkcijas, kas tiek izmantotas "iesaldēšanai/atkausēšanai" rindā — tas ir un . Tās tiek izmantotas, kad nepieciešams mainīt rindas pieprasījumu iestatījumus, kas ir potenciāli bīstami pieprasījumiem, kas jau atrodas šajā rindā. Izsaucot blk_mq_freeze_queue() funkciju tiek palielināts skaitītājs q->mq_freeze_depth. Pēc tam kods gaida, līdz rinda ir iztukšota .
Šīs rindas iztukšošanas gaidīšanas laiks ir ekvivalents diska kavēšanās laikam, jo kods gaida, līdz tiek pabeigtas visas iepriekš ieplānotās operācijas. Tiklīdz rinda ir tukša, tiek piemēroti iestatījumi. Pēc tam tiek izsaukts , kas samazina skaitītāju freeze_depth.
Tagad mēs zinām pietiekami, lai novērstu situāciju. Komanda udevadm trigger rezultātā noved pie iestatījumu piemērošanas blokierīcei. Šie iestatījumi ir aprakstīti udev noteikumos. Mēs varam noskaidrot, kuri iestatījumi «iesaldē» rindu, mēģinot tos mainīt caur sysfs vai apskatot kodu. Varam arī izmēģināt BCC , kas parādīs terminālī kodu steka pēdas un lietotāja telpu katram izsaukumam blk_freeze_queue, piemēram:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev noteikumi mainās diezgan reti un parasti tas notiek kontrolēti. Tāpēc mēs redzam, ka pat iepriekš noteikto vērtību izmantošana izraisa pieprasījuma sūtīšanas kavēšanās pie diska pieaugumu. Protams, ģenerēt udev notikumus, kad nav izmaiņu disku konfigurācijā (piemēram, ierīce netiek pievienota/atslēgta), nav īpaši laba prakse. Tomēr mēs varam palīdzēt kodam neveikt nevajadzīgu darbu un ne«iesaldēt» pieprasījumu rindu, ja tam nav vajadzības. novērš situāciju.
Secinājums
eBPF ir ļoti elastīgs un jaudīgs rīks. Šajā rakstā mēs apskatījām vienu praktisku gadījumu un demonstrējām nelielu daļu no tā, ko ir iespējams izdarīt. Ja jūs interesē BCC rīku izstrāde, noteikti ieskatieties , kas labi apraksta darba pamatus.
Ir arī citi interesanti rīki atkļūdošanai un profilēšanai, kas balstīti uz eBPF. Viens no tiem ir , kas ļauj rakstīt jaudīgus vienrindas skriptus un mazas programmas uz awk līdzīgas valodas. Cits — , ļauj vācēt augstas izšķirtspējas zemu līmeņa metriku tieši uz jūsu prometheus serveri, ar iespēju vēlāk iegūt skaistu vizualizāciju un pat brīdinājumus.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish