

Šodien IT infrastruktūrā, plaši izmantojot virtualizāciju, datu glabāšanas sistēmas ir kodols, kurā tiek saglabātas visas virtuālās mašīnas. Šī mezgla atteice var pilnībā apstādināt datu centru darbu. Lai arī ievērojai daļai serveru aprīkojuma ir kļūdu tolerances iespējas «pa noklusējumu», tieši dēļ īpašās lomas DGU datu centrā, tam tiek izvirzītas paaugstinātas prasības attiecībā uz «noturību».
Visefektīvākais veids, kā nodrošināt kļūdu toleranci IT, ir vairāku aprīkojuma un programmatūras kopiju izmantošana (vienkāršākajā gadījumā – dublēšana). Protams, DGU var pilnībā dublēt. Un tieši šāds piegājiens tiek izmantots katastrofu atjaunošanā. Taču ne visām uzņēmumiem šāds risinājums ir pa kabatai. Runa nav tikai par aprīkojuma dubulto izmaksu, bet arī par citiem izdevumiem, organizējot šādu risinājumu un tā turpmāku uzturēšanu.
Tomēr iespēja dublēt aprīkojumu neizslēdz nepieciešamību nodrošināt kļūdu toleranci komponentu līmenī. Īpaši DGU pielieto rezerves izejvielām, dzesēšanas moduļiem, krātuvei un, protams, kontrolieriem. Viss tas jau sen ir kļuvis par ikdienišķu standartu. Grūti atrast DGU, kas neizmanto šādu dizainu. šis – nav izņēmums. Bet šajā rakstā mēs vēlamies runāt par to, kas nekavējoties neizceļas, un tajā pašā laikā ir vērsts galvenokārt uz sistēmas kopējās kļūdu tolerances uzlabošanu.
Dzesēšanas moduļi
Ļoti bieži ar 2U-3U korpusiem tiek izmantoti kombinētie moduļi, kas apvieno barošanas blokus un ventilatorus. No vienas puses, tas ir ērti, jo jākopj tikai viens bloks. No otras puses, ja dzesēšanas sistēma izsistīs, var tikt piespiedu kārtā atslēgts barošanas bloks, lai izvairītos no pārkaršanas. Un šķiet, ka tas nav kritisks gadījums, taču pievienot ievainojamību DGU noteikti nav vērts.
Qsan datu glabātuves dzesēšana ir veidota kā atsevišķu moduļu sistēma ar „karsto” nomaiņu, kas ir neatkarīga no strāvas blokiem. Tieši strāvas blokos ir savi ventilatori, kas paredzēti ventilācijas nodrošināšanai pašiem blokiem. Dzesēšanas mods satur divus neatkarīgus ventilatorus, kas papildina viens otru. Šādu moduļu ir divi: pa labi un pa kreisi – efektīvai visu komponentu ventilācijai. Ja viens no ventilatoriem neizdodas, visi pārējie automātiski palielina apgriezienus, lai kompensētu radušos gaisa plūsmas trūkumu. Tieši tāpēc ventilatora bojājums nerada draudus visa ierīces pārkaršanai.
Paplašināšanas plauktu pieslēgšanas topoloģija
Klasiskā pieslēgšanas shēma datubāzu glabātavā nozīmē topoloģiju, ko sauc par kaskādi. Šajā gadījumā attiecīgie plauktu un datu glabātuves kontrolieri tiek savienoti ar vienu SAS kabeli. Tā rezultātā divu kontrolieru sistēmai ir nepieciešami 2 kabeļi. Ja ir nepieciešams pievienot otro, to pievieno tādā pašā veidā pirmajam plauktam. Un tā tālāk. Šīs topoloģijas priekšrocība ir ierīču vienkāršība. Savukārt mīnus ir zināma neaizsargātība pret pēkšņu SAS ķēdes pārtraukumu, ja tiek bojāti nesavienotie datu glabātuves un plauktu kontrolieri vai ja viena no paplašināšanas plauktiem tiek atslēgta ķēdes vidū. Tas var novest pie piekļuves zuduma daļai no diskiem un iespējamas RAID grupas bojāejas, ja tā ir „izkliedēta” pa vairākiem korpusiem.
No krusteniskā kontrolieru bojājuma Qsan ir aizsardzība iekšējās loģiskās saiknes veidā starp kontrolieriem, izmantojot datu glabātuves bāku. T.i., datu glabātuves kontrolieris redz ne tikai JBOD kontrolieri, kas ir tieši pievienots, bet arī „kaimiņu” kontrolieri caur speciālu saiti bākā. Rezultātā, ja šāda situācija notiek un neviens fiziski neizņem SAS kabeļus starp datu glabātuvi un plauktu, piekļuve visiem diskiem tiks saglabāta.
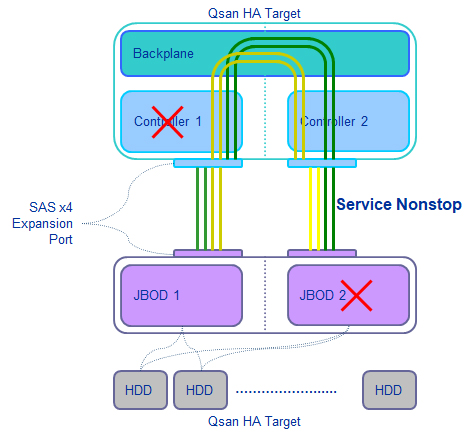
Lai aizsargātu no SAS ķēdes pārtraukuma, piemēram, ja viena no paplašināšanas plauktiem tiek izslēgta, parasti tiek izmantota cita pieslēgšanas topoloģija – apgrieztais kaskāde. Šajā gadījumā datu glabātuve tiek pieslēgta gan pirmajai, gan pēdējai plaukta ķēdē, iegūstot piekļuvi diskiem gan no vienas, gan otras puses.
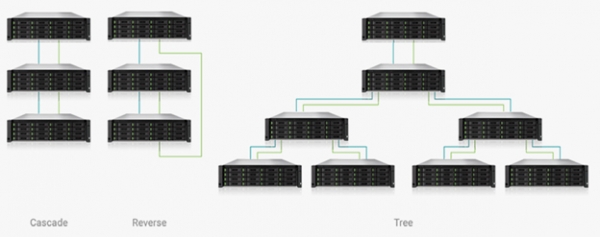
Ja, ja vēlaties spēcīgāku aizsardzību, tad var izveidot plašākas konfigurācijas, izmantojot, piemēram, koka topoloģiju. Var arī sarežģīt, apvienojot iepriekš minētās topoloģijas. To iespējams īstenot, pateicoties lielajam SAS pieslēgvietu skaitam ierīcēs (2 katram SCSI kontrollerim un 5 katram JBOD kontrollerim) ar automātisku I/O režīmu noteikšanu. Svarīgi, lai pats administrators nepārlocītos. Savukārt SCSI kontrolleris spēs pareizi konfigurēt uzstādījumus.
Ātra atkārtošana
Rekuperācijas disku klātbūtne sistēmā ar „karsto” maiņu (hot spare) būtiski palielina informācijas glabāšanas uzticamību. Tomēr pati disku rezervēšana vēl nenozīmē absolūtu aizsardzību. Problēma ir tajā, ka atjaunošanas process (rebildings) ir diezgan laikietilpīgs un bieži vien ilgst ilgi. Laikietilpīgums rodas no nepārtrauktā piekļuves būtiskajiem datiem. Tā rezultātā sistēmai, paralēli aktīvai darbībai, jāīsteno datu kopēšana uz jauno disku. Turklāt rebildinga ilgums tieši atkarīgs no krātuves ietilpības un tās ātruma rādītājiem. Tā kā sistēma neko nezin par reāli izmantotajiem laukumiem diskos, tā rebildinga procesā vienkārši kopē visu: blokiem pa blokiem.
Tādējādi mūsdienu lielas ietilpības diska atjaunošana, kas pārsniedz 10 TB, pie ievērojamas slodzes uz SCSI kontrolleri var viegli ilgt nedēļu vai ilgāk. Jāņem vērā arī tas, ka rebildinga laikā ievērojami palielinās citu krātuves ierīču atteices risks, jo to slodze palielinās. Tas var radīt nopietnas briesmas, piemēram, izmantojot RAID5.
Kā risinājumu šai problēmai daudzi SCSI kontrolleru izstrādātāji ir pievērsušies atjaunošanas procesa paātrināšanai. Var izmantot dažādas pieejas, taču būtība paliek viena – rebilding procesā tiek kopēti tikai reāli aizņemtie bļokes. Arī Qsan nav palicis malā no šīs problēmas. Šī piegādātāja SCSI kontrolleriem aktīvas opcijas sistēma izseko aizņemšanas diskus, tādējādi spējot attiecīgā gadījumā diska atteices rezultātā kopēt uz jauno krātuvi tikai tos.
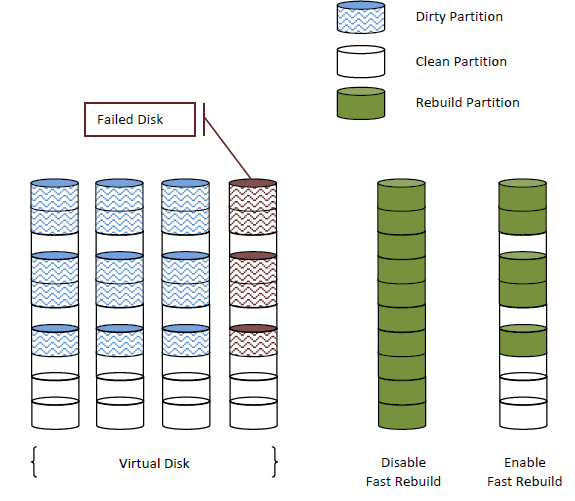
Opcija Fast Rebuild netiek aktivizēta kā noklusējums jaunajās apjoma izveidē, jo tās izmantošana ietekmē veiktspēju, īpaši random write operāciju laikā, jo:
- Ir nepieciešams veikt ierakstu izsekošanu blokos;
- Veicot rekonstrukciju, netiek pārskaitītas kontroles summas nesadzītajai telpai, tāpēc jaunā ieraksta veikšanai šajā apgabalā vispirms ir jā"inicializē" tas.
Tāpēc nav ieteicams izmantot Fast Rebuild apjomiem, piemēram, ar augsti noslogotām datu bāzēm vai videonovērošanas sistēmām, kur apjoms galu galā tiks aizpildīts par 100%. Taču failu vai pasta serveriem šī opcija būs patiešām noderīga.
Noslēgumā
Katrs ražotājs uzskata, ka tā ierīces ir uzticamas. Un, ja nav fatālu trūkumu ierīču izstrādē un neticamas tieksmes uz ietaupījumiem to ražošanas un testēšanas procesā, tad kopumā var piekrist piegādātājam. Tomēr jāizprot:
- bāzes kļūdu tolerance tajos ir vispirms veids, kā turpināt piekļuvi datiem, ja kāda komponenta(-u) darbojas nepareizi;
- papildu iespējas kļūdu tolerancē (piemēram, minētās iepriekš) ir dažu bojājumu variantu izslēgšana un palielinājums jūsu iespēju piekļūt datiem;
- 100% uzticamība, diemžēl, nepastāv. Bet, lai pēc iespējas tuvāk pie tās nonāktu, vairākums saprātīgu piegādātāju (un tajā skaitā) pieliek maksimumu pūļu, lai nepārtraukti uzlabotu savus produktus gan aparatūras, gan programmatūras daļā.
Tajā pašā laikā arī nevajadzētu aizmirst, ka nekāda absolūta uzticamība neizslēdz rezerves kopiju esamību, skaidras un iepriekš izspēlētas krīzes atjaunošanas plānus un operatīvu piegādātāja tehnisko atbalstu.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish