

LINQ .NET ir ienācis kā jauna spēcīga datu manipulācijas valoda. LINQ to SQL kā tā daļa ļauj ērti komunicēt ar DBMS, piemēram, izmantojot Entity Framework. Tomēr, bieži to lietojot, izstrādātāji aizmirst paskatīties, kāds SQL vaicājums tiks ģenerēts queryable provider, šajā gadījumā — Entity Framework.
Apskatīsim divus galvenos punktus piemērā.
Tāpēc SQL Server izveidosim datu bāzi Test, un tajā izveidosim divas tabulas, izmantojot sekojošo vaicājumu:
Tabulu izveide
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Tagad piepildīsim tabulu Ref, palaižot sekojošo skriptu:
Tabulas Ref piepildīšana
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Līdzīgi piepildīsim tabulu Customer, izmantojot sekojošo skriptu:
Tabulas Customer piepildīšana
IZMANTO [TEST]
IET AL

DEKLARĒ @ind INT=1;
DEKLARĒ @ind_ref INT=1;

KAMĒR(@ind<=12000000)
SĀKT
	JA(@ind%3=0) IESTATĪT @ind_ref=1;
	CITA JA (@ind%5=0) IESTATĪT @ind_ref=2;
	CITA JA (@ind%7=0) IESTATĪT @ind_ref=3;
	CITA JA (@ind=0) IESTATĪT @ind_ref=4;
	CITA JA (@ind=0) IESTATĪT @ind_ref=5;
	CITA JA (@ind=0) IESTATĪT @ind_ref=6;
	CITA JA (@ind=0) IESTATĪT @ind_ref=7;
	CITA JA (@ind=0) IESTATĪT @ind_ref=8;
	CITA JA (@ind=0) IESTATĪT @ind_ref=9;
	CITA JA (@ind=0) IESTATĪT @ind_ref=10;
	CITA JA (@ind=0) IESTATĪT @ind_ref=11;
	CITA IESTATĪT @ind_ref=@ind90000;

	IERAKSTĪT [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 IZVĒLĒTIES
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	IESTATĪT @ind=@ind+1;
BEIDZ
IET AL
Tādējādi mēs esam ieguvuši divas tabulas, vienā no kurām ir vairāk nekā 1 miljons datu rindu, bet otrā — vairāk nekā 10 miljons datu rindu.
Tagad Visual Studio ir nepieciešams izveidot testa projektu Visual C# Console App (.NET Framework):
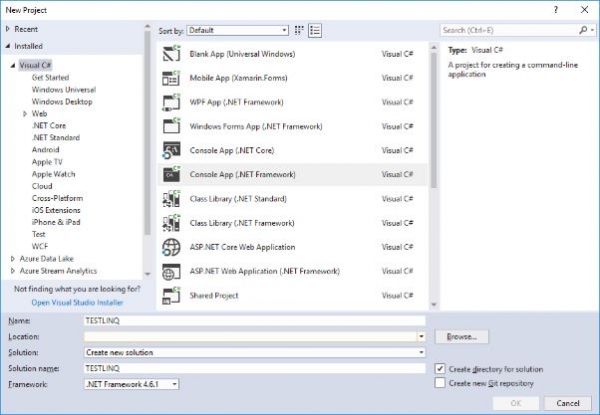
Tālāk, nepieciešams pievienot bibliotēku datu bāzei, lai veiktu mijiedarbību ar Entity Framework.
Lai to pievienotu, ar peles labo pogu noklikšķināsim uz projekta un izvēlēsimies konteksta izvēlnē Manage NuGet Packages:
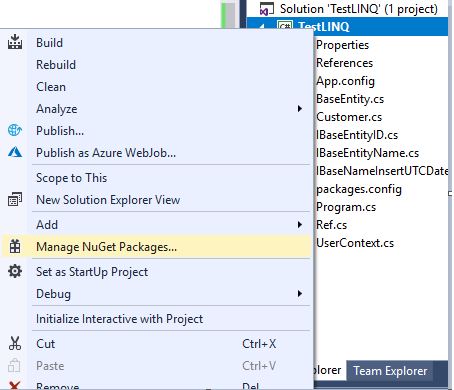
Tad parādījušajā NuGet pakotņu pārvaldības logā meklēšanas laukā ievadīsim vārdu "Entity Framework" un izvēlēsimies Entity Framework pakotni, pēc tam to instalēsim:
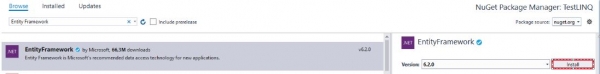
Tālāk failā App.config pēc configSections elementa noslēgšanas nepieciešams pievienot sekojošu bloku:
connectionString jāievada savienojuma virkne.
Tagad izveidosim atsevišķos failos trīs interfeisus:
- IbaseEntityID interfeisa realizācija
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - IbaseEntityName interfeisa realizācija
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - IbaseNameInsertUTCDate interfeisa realizācija
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
Un atsevišķā failā izveidosim bāzes klasi BaseEntity, kurā būs iekļauti kopīgie lauki:
Bāzes klases BaseEntity realizācija
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Tālāk, atsevišķos failos izveidosim mūsu divas entitātes:
- Klases Ref realizācija
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Klases Customer realizācija
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Tagad izveidosim atsevišķā failā kontekstu UserContext:
Klases UserContext realizācija
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Saņēmām gatavu risinājumu testiem par optimizāciju ar LINQ to SQL caur EF MS SQL Server:
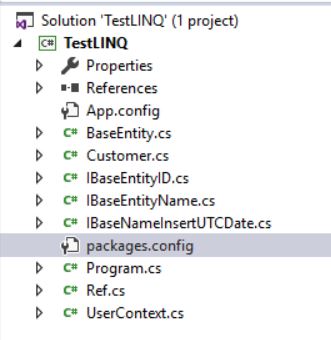
Tagad failā Program.cs ievadīsim sekojošo kodu:
Fails Program.cs
izmantojot System;
izmantojot System.Collections.Generic;
izmantojot System.Linq;

nosaukums TestLINQ
{
    klase Program
    {
        statiska void Main(string[] args)
        {
            izmantojot (UserContext db = jauns UserContext())
            {
                vari dblog = jauna Saraksts<string>();
                db.Database.Log = dblog.Add;

                vari vaicājums = no e1 db.Customer
                            no e2 db.Ref
                            kur (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            izvēlēties jaunu { Data1 = e1.Name, Data2 = e2.Name };

                vari rezultāts = vaicājums.Ņem(1000).ToList();

                Konsoles.WriteLine(dblog[1]);

                Konsoles.ReadKey();
            }
        }
    }
}
Tālāk palaidīsim mūsu projektu.
Darba beigās konsolē tiks izvada:
Ģenerētais SQL vaicājums
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    NO  [dbo].[Customer] KĀ [Extent1]
    PĀRĒJIE IENĀK [dbo].[Ref] KĀ [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) UN ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Tas ir, kopumā LINQ vaicājums ir ģenerējis diezgan labu SQL vaicājumu MS SQL Server datu bāzei.
Tagad mainīsim nosacījumu UN uz VAI LINQ vaicājumā:
LINQ vaicājums
vari vaicājums = no e1 db.Customer
                            no e2 db.Ref
                            kur (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            izvēlēties jaunu { Data1 = e1.Name, Data2 = e2.Name };
Un atkal palaidīsim mūsu lietotni.
Izpildīšana izraisīs kļūdu, kas saistīta ar izpildes laika pārsniegšanu 30 sekunžu laikā:
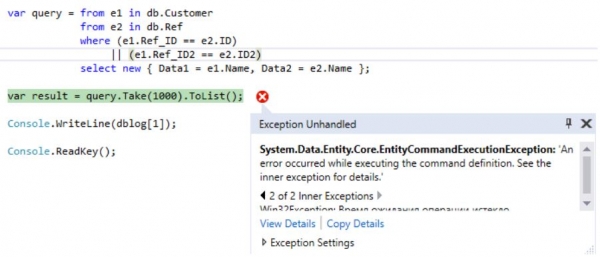
Ja paskatāmies, kāds vaicājums šajā gadījumā tika ģenerēts ar LINQ:
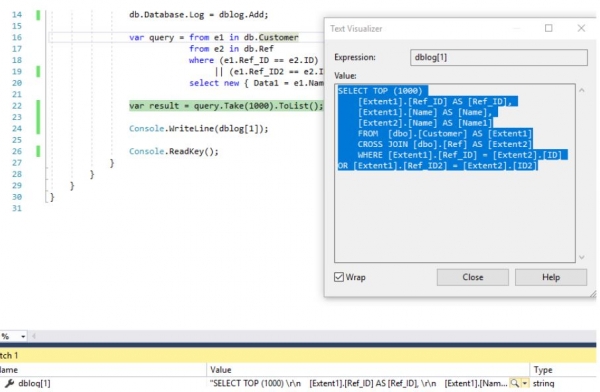
, tad varam pārliecināties, ka atlase notiek, izmantojot dekartisko reizinājumu starp divām kopām (tabulām):
Ģenerētais SQL vaicājums
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    NO  [dbo].[Customer] KĀ [Extent1]
    KRUSTA JAU UN [dbo].[Ref] KĀ [Extent2]
    KUR [Extent1].[Ref_ID] = [Extent2].[ID] VAI [Extent1].[Ref_ID2] = [Extent2].[ID2]
Pieņemsim, ka pārrakstam LINQ vaicājumu šādi:
Optimizēts LINQ vaicājums
vari vaicājums = (no e1 db.Customer
                   pievienot e2 db.Ref
                   uz e1.Ref_ID ir vienāds e2.ID
                   izvēlēties jaunu { Data1 = e1.Name, Data2 = e2.Name }).Savienot(
                        no e1 db.Customer
                        pievienot e2 db.Ref
                        uz e1.Ref_ID2 ir vienāds e2.ID2
                        izvēlēties jaunu { Data1 = e1.Name, Data2 = e2.Name });
Tad iegūsim šādu SQL vaicājumu:
SQL vaicājums
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Diemžēl LINQ vaicājumos savienojuma nosacījums var būt tikai viens, tāpēc šeit ir iespējams veikt ekvivalentu vaicājumu caur diviem vaicājumiem katram nosacījumam, pēc tam apvienojot tos ar Union, lai noņemtu dublikātus starp rindām.
Jā, vaicājumi kopumā iznāks neekvivalenti, ņemot vērā, ka var tikt atgriezti pilnīgi dublēti rindi. Tomēr reālajā dzīvē pilni dublējošie rindi nav nepieciešami, un no tiem cenšas atbrīvoties.
Tagad salīdzināsim šo divu vaicājumu izpildes plānus:
- CROSS JOIN vidēji izpildes laiks ir 195 sek:

- INNER JOIN-UNION vidēji izpildes laiks ir mazāk par 24 sek:

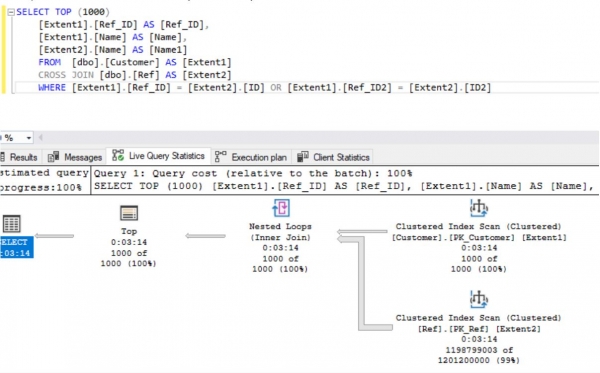
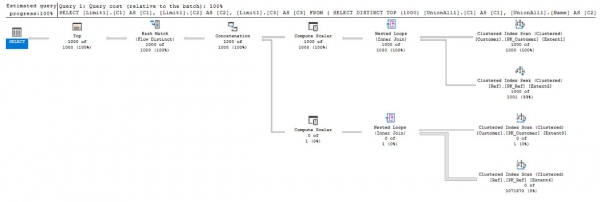
Kā redzams no rezultātiem, optimizētais LINQ vaicājums darbojas daudzkārt ātrāk nekā neoptimizētais, strādājot ar divām datu bāzēm, kurām ir miljoniem ierakstu.
Par variantu ar un LINQ vaicājumā, kas izskatās šādi:
LINQ vaicājums
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
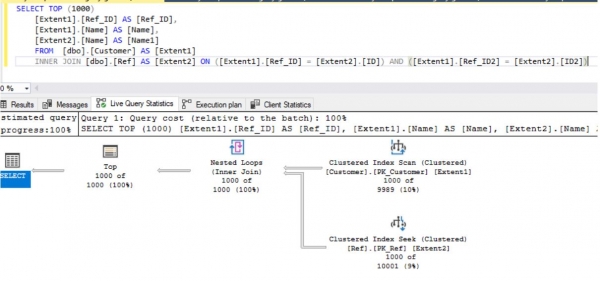
pēdējo reizi tiks ģenerēts pareizs SQL vaicājums, kas tiks izpildīts vidēji apmēram 1 sek:
Tāpat, veicot operācijas ar LINQ to Objects, aizvietojot vaicājumu ar:
LINQ vaicājums (1. variants)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1 == e2.Key1)
                               && (e1.Key2 == e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
var izmantot vaicājumu, kas izskatās šādi:
LINQ vaicājums (2. variants)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
kur:
Divu masīvu noteikums
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, un Para tips ir definēts kā:
Para tipa definējums
class Para
{
        public int Key1, Key2;
        public string Data;
}
Tādējādi mēs apskatījām dažus aspektus LINQ vaicājumu optimizācijā MS SQL Server.
Diemžēl pat pieredzējuši un vadošie .NET izstrādātāji aizmirst par to, ka ir jāizprot, ko tieši dara secinājumi, kurus viņi izmanto. Pretējā gadījumā viņi kļūst par konfigurētājiem un var ievietot laika sprādzienu, būvējot programmatūras risinājumu, kā arī veicot niecīgas izmaiņas vides ārējos nosacījumos.
Tika veikts arī neliels pārskats un .
Iezīmes testam — pats projekts, datu bāzes TEST tabulu izveidošana un šo tabulu datu piepildīšana ir atrodama .
Tāpat šajā repozitorijā mapē Plans atrodas plāni vaicājumu izpildei ar nosacījumiem VAI.
Avots: habr.com
