

Līdz nesenam laikam sociālā tīkla Odnoklassniki ir uzkrāti ap 50 TB datu, ko apstrādā reāllaikā SQL Server. Šāda apjoma ātras un uzticamas, kā arī kļūdu noturīgas datu centra piekļuves nodrošināšana, izmantojot SQL DB, ir praktiski neiespējama. Parasti šādos gadījumos izmanto vienu no NoSQL glabātuvēm, taču ne viss var tikt pārnests uz NoSQL: daži objekti prasa ACID transakciju garantijas.
Tas noveda pie lēmuma izmantot NewSQL glabātuvi, proti, datu bāzi, kas nodrošina kļūdu noturību, mērogojamību un ātrdarbību, ko piedāvā NoSQL sistēmas, bet skaidri saglabā klasisko sistēmu ACID garantijas. Vairums šī jaunā klases ražošanas sistēmu ir maz, tāpēc mēs izstrādājām tādu paši un palaidām to ražošanas vidē.
Kā tas darbojas un kādi rezultāti ir sasniegti – lasi zemāk.
Šodien mēneša auditorija «Odnoklassniki» pārsniedz 70 miljonus unikālu apmeklētāju. Mēs lielākajām sociālo tīklu platformām pasaulē un twidzot zemākajām 20 mājaslapām, kurās lietotāji pavada visvairāk laika. «OK» infrastruktūra apstrādā ļoti augstu slodzi: vairāk nekā miljonu HTTP pieprasījumu/s uz punktiem. Daļa serveru parka, kas sastāv vairāk nekā no 8000 serveriem, ir izvietota tuvāk viens otram – četru Maskavas datu centros, kas ļauj nodrošināt tīkla kavēšanos mazāk par 1 ms starp tiem.
Mēs izmantojam Cassandra kopš 2010. gada, sākot ar 0.6 versiju. Šodien ekspluatācijā ir vairākas desmiti klasteru. Visstraujākais klasteris apstrādā vairāk nekā 4 miljonus darbību sekundē, bet lielākais glabā 260 TB.
Tomēr tas viss ir parasti NoSQL klasteri, kas tiek izmantoti vājās saskaņotības datu glabāšanai. augstu saskaņotību. .
particionēšanu. (sharding). Vēsturiski mēs esam izmantojuši vienkāršu datu šardēšanas shēmu: katrai entītijai tika piešķirts tokens — funkcija, kas ņem ID entītijas. Entītijas ar vienu un to pašu token tika novietotas vienā SQL serverī. Master-detail attiecības tika īstenotas tā, lai galvenās un izrietošās ierakstu tokeni vienmēr sakristu un atrastos vienā serverī. Sociālās tīklos gandrīz visi ieraksti tiek radīti lietotāja vārdā — tas nozīmē, ka visi lietotāja dati vienā funkcionālā apakšsistēmā tiek glabāti vienā serverī. Tas nozīmē, ka biznesa darījumos gandrīz vienmēr piedalījās tabulas no viena SQL servera, kas nodrošināja datu konsekvenci, izmantojot lokālas ACID darījumu, bez nepieciešamības izmantot izplatītos ACID darījumus.
Pateicoties šardēšanai, un, lai paātrinātu SQL darbību:
- Neizmantojam Foreign key ierobežojumus, jo pie šardēšanas entītijas ID var atrasties citā serverī.
- Neizmantojam glabātas procedūras un trigerus, jo tas rada papildu slodzi uz DBMS CPU.
- Neizmantojam JOINs, ņemot vērā visu iepriekš minēto un daudzus nejaušus lasījumus no diska.
- Ārpus darījuma, lai samazinātu mirkļu bloķēšanu, izmantojam Read Uncommitted izolācijas līmeni.
- Izpildām tikai īsus darījumus (vidēji īsāki par 100 ms).
- Neizmantojam vairāku rindu UPDATE un DELETE dēļ lielā skaita mirkļu bloķēšanas — atjaunojam tikai vienu ierakstu.
- Vaicājumus vienmēr izpildām tikai pēc indeksam — vaicājums ar visaptverošu tabulas skatījumu nozīmē datu bāzes pārslodzi un tās atteikšanos.
Šie soļi ļāva izspiest no SQL serveriem gandrīz maksimālu veiktspēju. Tomēr problēmu kļuva arvien vairāk. Apskatīsim tās.
SQL problēmas
- Tā kā mēs izmantojām pašizstrādātu šardēšanu, jaunu shardu pievienošana tika veikta manuāli ar administratoriem. Viss šo laiku mērogojamie datu kopijas neveica pieprasījumus.
- Pieaugot ierakstu skaitam tabulā, samazinās ievietošanas un modificēšanas ātrums; pievienojot indeksus esošajai tabulai, ātrums krasi samazinās, indeksu izveide un rekonstrukcija notiek ar dīkstāvi.
- Nelielā Windows SQL Server skaita esamība ražošanas vidē apgrūtina infrastruktūras pārvaldību.
Bet galvenā problēma —
Izmaksu noturība
Klasiskajam SQL serverim ir slikta drošība pret kļūdām. Pieņemiet, ka jums ir tikai viens datu bāzes serveris, un tas kļūst nelietojams reizi trijos gados. Šajā laikā mājas lapa nedarbojas 20 minūtes, kas ir pieņemami. Ja jums ir 64 serveri, tad mājas lapa nedarbojas jau reizi trijās nedēļās. Un, ja jums ir 200 serveri, tad mājas lapa nedarbojas katru nedēļu. Tas ir problēma.
Ko var darīt, lai palielinātu SQL servera drošību pret kļūdām? Vikipēdija mums piedāvā izveidot : kur, ja kāda no sastāvdaļām kļūst nelietojama, ir dublējoša.
Tas prasa dārga aprīkojuma parku: daudz dublēšanās, šķiedru optiku, koplietošanas krātuves, un rezerves ieslēgšana darbojas nedroši: apmēram 10% ieslēgšanas gadījumu beidzas ar rezerves mezgla neizdošanos, kā galvenā mezgla apvienojumā.
Bet galvenā trūkuma šādam augstāk pieejamam klasterim ir nulle pieejamība, ja kļūst nelietojams datu centrs, kurā tas atrodas. «Odnoklassniki» ir četri datu centri, un mums ir nepieciešams nodrošināt darbību, kad vienā no tiem iestājas pilnīga avārija.
Lai to izdarītu, varētu izmantot replikāciju, kas ir iebūvēta SQL Server. Šis risinājums ir daudz dārgāks dēļ programmatūras izmaksām un cieš no labi zināmām problēmām ar replikāciju — neparedzamiem transakciju aizkavējumiem sinhronā replikācijā un aizkavējumiem replikāciju piemērošanā (un, kā secinājums, zaudētām modifikācijām) asimhronajā. Iespciešamās padara šo variantu pilnīgi piemērojamam mums.
Visas šīs problēmas prasīja radikālu risinājumu, un mēs sākām detalizētu analīzi. Šeit mums jāsaprot, ko galvenokārt veic SQL Server — transakcijas.
Vienkārša transakcija
Apskatīsim vienkāršāko, no pielietojamā SQL programmista viedokļa, transakciju: fotoattēla pievienošana albumam. Albumi un fotoattēli tiek glabāti dažādās tabulās. Albumam ir publisko fotoattēlu skaitītājs. Tādējādi šī transakcija tiek sadalīta sekojošos soļos:
- Bloķējam albumu pēc atslēgas.
- Izveidojam ierakstu fotoattēlu tabulā.
- Ja fotoattēlam ir publisks statuss, tad palielinām albumā publisko fotoattēlu skaitītāju, atjauninām ierakstu un apstiprinām transakciju.
Vai arī pseido kodā:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Mēs redzam, ka visizplatītākais biznesa darījumu scenārijs ir izlasīt datus no datubāzes un ielādēt tos lietojumservera atmiņā, veikt izmaiņas un saglabāt jaunās vērtības atpakaļ datubāzē. Parasti šādā darījumā mēs atjauninām vairākas entitātes, vairākas tabulas.
Transaction executing var notikt konkurējoša modifikācija tiem pašiem datiem no cita sistēmas. Piemēram, pretspams var izlemt, ka lietotājs ir aizdomīgs, un tāpēc visas lietotāja bildes vairs nedrīkst būt publiskas, tās ir jānosūta moderācijai, tādējādi jāmaina photo.status uz citu vērtību un jāatgriež attiecīgie skaitītāji. Acīmredzami, ka, ja šī operācija notiks bez atomiskuma un konkurējošo modifikāciju izolācijas garantijām, tad rezultāts nebūs tāds, kāds nepieciešams — vai nu foto skaitītājs rādīs nepareizu vērtību, vai arī ne visas bildes tiks nosūtītas moderācijai. , tad rezultāts nebūs tāds, kā vajadzīgs — vai nu foto skaitītājs rādīs nepareizu vērtību, vai arī ne visas bildes tiks nosūtītas moderācijai.
Tāda veida kods, kas manipulē ar dažādām biznesa entitātēm vienā darījumā, ir rakstīts ļoti daudz laikā, kad pastāvēja Odnoklassniki. Tomēr, ņemot vērā migrāciju uz NoSQL, mēs zinām, ka vislielākās grūtības (un laika izmaksas) rodas, kad jāizstrādā kods, kas vērsts uz datu konsekvences uzturēšanu. Tādēļ galvenais prasība jaunai uzglabāšanas sistēmai bija nodrošināt patieso ACID darījumu atbalstu lietojumloģikai.
Citas, ne mazāk svarīgas prasības bija:
- Datacentra atteikuma gadījumā ir jābūt pieejamiem gan lasīšanai, gan rakstīšanai jaunajā uzglabāšanas sistēmā.
- Jānodrošina esošās izstrādes ātrums. Tas ir, strādājot ar jauno uzglabāšanas sistēmu, koda apjomam jābūt aptuveni tādam pašam, nevajadzētu rasties vajadzībai rakstīt kaut ko jaunu uzglabāšanai, izstrādāt konfliktu risināšanas algoritmus, sekunģu indeksu uzturēšanu utt.
- Jaunās uzglabāšanas sistēmas darba ātrumam jābūt pietiekami augstam, gan lasot datus, gan apstrādājot darījumus, kas efektīvi nozīmē akadēmiski stingru, vispārēju, bet lēnu risinājumu piemērošanas neiespējamību, kā, piemēram, .
- Automātiska mērogošana reālā laikā.
- Parasto lēto serveru izmantošana, bez nepieciešamības iegādāties eksotiskas iekārtas.
- Iespēja paplašināt krātuvi uzņēmuma izstrādātāju spēkiem. Citiem vārdiem sakot, prioritāte tika piešķirta saviem vai atvērtā koda risinājumiem, vēlams, uz Java bāzes.
Risinājumi, risinājumi
Analizējot iespējamos risinājumus, mēs nonācām pie divām iespējām arhitektūras izvēlē:
Pirmais — ņemt jebkuru SQL serveri un īstenot nepieciešamo pārrāvuma noturību, mērogošanas mehānismu, pārrāvuma noturīgu klasteri, konfliktu risināšanu un izplatītas, uzticamas un ātras ACID transakcijas. Mēs novērtējām šo variantu kā diezgan netradicionālu un laikietilpīgu.
Otrais variants — ņemt gatavu NoSQL krātuvi ar īstenotu mērogošanu, pārrāvuma noturīgu klasteri, konfliktu risināšanu un realizēt transakcijas un SQL paši. Pirmajā mirklī pat SQL realizēšanas uzdevums, nerunājot par ACID transakcijām, izskatās kā ilgs darbs. Bet tad mēs sapratām, ka SQL iespēju komplekts, ko mēs izmantojam praksē, ir tālu no ANSI SQL, tikpat tālu kā tālu no ANSI SQL. Pētot CQL tuvāk, mēs sapratām, ka tas ir pietiekami tuvs tam, kas mums nepieciešams.
Cassandra un CQL
Tātad, kas ir interesants par Cassandra, kādas iespējas tai ir?
Pirmkārt, šeit var izveidot tabulas, kas atbalsta dažāda veida datus, var veikt SELECT vai UPDATE pēc primārā atslēga.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Lai nodrošinātu datu saskaņotību replikās, Cassandra izmanto . Vienkāršākajā gadījumā tas nozīmē, ka, ievietojot trīs viena un tā paša rinda replikas dažādās klastera nodaļās, ieraksts tiek uzskatīts par veiksmīgu, ja lielākā daļa nodaļu (t.i., divas no trim) apstiprina šīs ierakstīšanas operācijas veiksmīgumu. Rinda tiek uzskatīta par konsekventu, ja, veicot lasīšanu, lielākā daļa nodaļu tika aptaujāta un tās to apstiprināja. Tādējādi, ja ir trīs replikas, tiek garantēta pilnīga un nekavējoša datu konsekvenca vienas nodaļas iznīkšanas gadījumā. Šāda pieeja ļāva mums ieviest vēl drošāku shēmu: vienmēr nosūtīt pieprasījumus visām trim replikām, gaidot atbildi no divām ātrākajām. Novēlota trešās replikas atbilde šajā gadījumā tiek noraidīta. Novēlotai atbildei no nodaļas var būt nopietnas problēmas — kavēšanās, garbage collection JVM, direct memory reclaim linux kernel, aparatūras kļūme, atslēgšanās no tīkla. Tomēr tas nekādi neietekmē klienta darbības un datus.
Pieeja, kurā mēs piekļūstam trim nodaļām un saņemam atbildi no divām, tiek dēvēta par : pieprasījums uz liekajām replikām tiek nosūtīts vēl pirms tās «atvairs nav».
Vēl viens no Cassandra priekšrocībām ir Batchlog — mehānisms, kas garantē vai nu pilnīgu izpildi, vai pilnīgu neizpildi jūsu izmaiņu paketei. Tas ļauj mums risināt A ACID — atomiskumu no kastes.
Visvairāk līdzīgs darījumiem Cassandra ir tā sauktie «». Tomēr no «īstiem» ACID darījumiem tie ir tālu: patiesībā tas ir iespēja veikt uz datiem tikai vienam ierakstam, izmantojot konsensu smagā protokola Paxos ietvaros. Tādēļ šādu darījumu ātrums nav liels.
Ko mums trūka Cassandra
Tātad, mums bija jāpaveic īstas ACID darījumu realizācija Cassandra. Ar kuru palīdzību mēs varētu viegli īstenot divas citas ērtas iespējas klasiskajām DBMS: konsekventus ātrus indeksus, kas ļautu mums veikt datu izgūšanu ne tikai pēc primārā atslēga un parastā monotona automātiska inkrementāla ID ģeneratora.
C*One
Tā tika radīta jauna DBMS C*One, kas sastāv no trim servera nodaļu veidiem:
- Glabātāji — (gandrīz) standarta Cassandra serveri, kas atbild par datu glabāšanu vietējās diskos. Pieaugot slodzei un datu apjomam, to skaitu ir viegli palielināt līdz desmitiem un simtiem.
- Transakciju koordinatori — nodrošina transakciju izpildi.
- Klienti — lietojumserveri, kas veic biznesa operācijas un iniciē transakcijas. Šādu klientu var būt tūkstošiem.
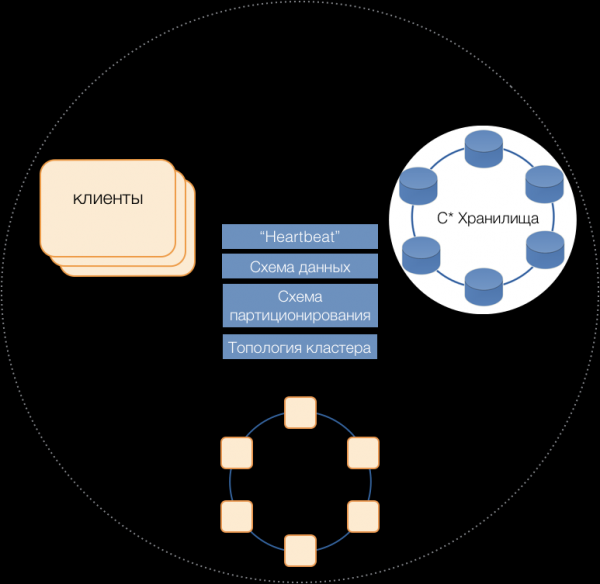
Visu veidu serveri ir daļa no kopēja klastera, izmantojot iekšējo ziņojumu protokolu Cassandra savstarpējai saziņai un lai apmainītos ar klastera informāciju. Ar Heartbeat serveri uzzina par savstarpējām avārijām, uztur vienotu datu shēmu — tabulas, to struktūru un replikāciju; nodalījuma shēmu, klastera topoloģiju un tml.
Klienti
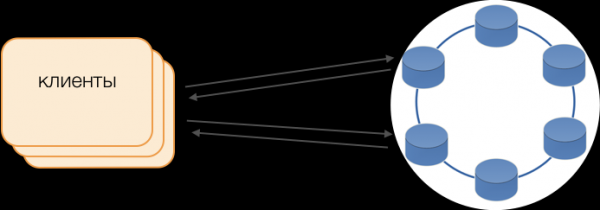
Tiek izmantots Fat Client režīms, nevis standarta draiveri. Šāds mezgls neuzglabā datus, bet var darboties kā pieprasījumu izpildes koordinators, proti, klients pats veic koordinācijas funkciju saviem pieprasījumiem: jautā glabātāju replikām un risina konfliktus. Tas ir ne tikai drošāk un ātrāk nekā standarta draiveris, kas prasa saziņu ar attālu koordinatoru, bet arī ļauj kontrolēt pieprasījumu nodošanu. Ārpus uz klienta atvērtas transakcijas pieprasījumi tiek virzīti uz glabātavām. Ja klients ir atvēris transakciju, tad visi pieprasījumi transakcijas ietvaros tiek virzīti uz transakciju koordinatoru.
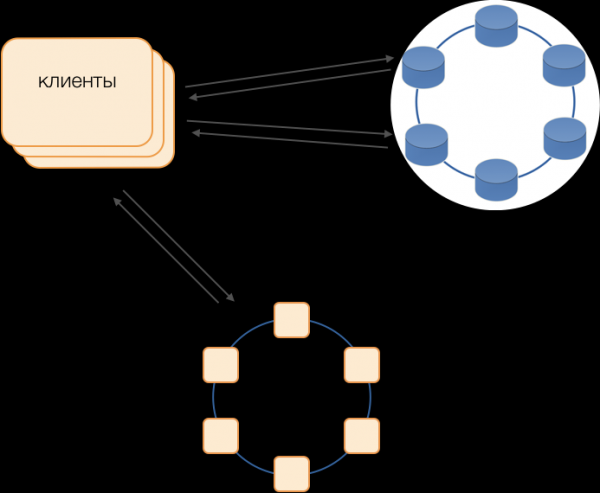
C*One transakciju koordinators
Koordinators — tas, ko mēs esam izstrādājuši C*One no nulles. Tas ir atbildīgs par transakciju, bloķēšanas un transakciju izpildes secības pārvaldību.
Katrai apkalpotajai transakcijai koordinators ģenerē laika zīmogu: katrs nākamais ir lielāks par iepriekšējo transakciju. Tā kā Cassandrā konfliktu risināšanas sistēma balstās uz laika zīmoga (no divām konfliktējošām ierakstēm derīga tiek uzskatīta ar vēlāk laika zīmogu), pretruna vienmēr tiks atrisināta par labu nākamajai transakcijai. Tādējādi mēs esam īstenojuši — lēts veids, kā risināt konfliktus izplatītā sistēmā.
Bloķēšanas
Lai nodrošinātu izolāciju, mēs nolēmām izmantot visvienkāršāko veidu — pesimistiskās bloķēšanas pēc ieraksta primārā atslēga. Citiem vārdiem sakot, transakcijā ieraksts vispirms ir jābloķē, tikai tad jāizlasa, jāmodificē un jāglabā. Tikai pēc veiksmīgas apstiprināšanas ieraksts var tikt atbloķēts, lai konkurējošās transakcijas varētu to izmantot.
Šādas bloķēšanas īstenošana ir vienkārša neizplatītā vidē. Izplatītā sistēmā ir divi galvenie ceļi: vai nu īstenot izplatītu bloķēšanu klasterī, vai arī sadalīt transakcijas tā, lai transakcijas, kurās iesaistīta viena ieraksts, vienmēr apkalpotu tas pats koordinators.
Tā kā mūsu gadījumā dati jau ir izplatīti pa grupām lokālajām transakcijām SQL, tika nolemts piešķirt koordinētājiem grupu lokālo transakciju: viens koordinators veic visas transakcijas ar tokenu no 0 līdz 9, otrais - ar tokenu no 10 līdz 19, un tā tālāk. Rezultātā katrs koordinators kļūst par transakciju grupas meistaru.
Tādējādi bloķēšanas var tikt īstenotas kā elementārs HashMap koordinatora atmiņā.
Koordinatoru atteikumi
Tā kā viens koordinators ekskluzīvi apkalpo transakciju grupu, ir ļoti svarīgi ātri noteikt viņa atteikumu, lai atkārtota transakcijas izpilde iekļautos laika limitā. Lai to paveiktu ātri un droši, mēs izmantojām pilnībā saistītu kvoruma heartbeata protokolu:
Katram datu centram jāsatur vismaz divas koordinācijas mezgli. Periodiski katrs koordinators nosūta heartbeata ziņojumu pārējiem koordinatoriem un informē viņus par savu darbību, kā arī par to, no kuriem koordinatoriem viņš pēdējo reizi bija saņēmis heartbeata ziņojumus.
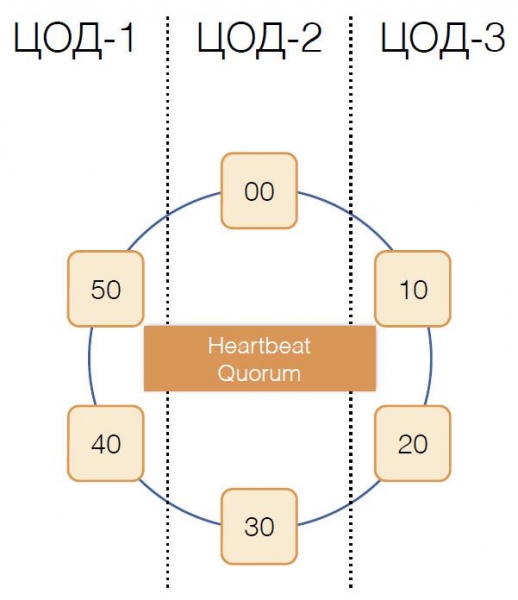
Saņemot līdzīgu informāciju no pārējiem viņu heartbeata ziņojumos, katrs koordinators izlemj, kuri klastera mezgli darbojas, bet kuri ne, vadoties pēc kvoruma principa: ja mezgls X saņēma no lielākās daļas mezglu klasterī informāciju par normālu ziņojumu saņemšanu no mezgla Y, tad Y darbojas. Un otrādi, tiklīdz lielākā daļa paziņo par ziņojumu zudumu no mezgla Y, tas nozīmē, ka Y ir atteicis. Interesanti, ka, ja kvorums informē mezglu X, ka vairs nesaņem no tās ziņojumus, tas pats mezgls X uzskatīs sevi par atteicēju.
Heartbeat ziņojumi tiek izsūtīti ar lielu biežumu, aptuveni 20 reizes sekundē, ar intervālu 50 ms. Java ir grūti nodrošināt lietojumprogrammas atbildes laiku 50 ms dēļ salīdzināmām pauzēm, ko izraisa atkritumu savācējs. Mums izdevās sasniegt šādu atbildes laiku, izmantojot G1 atkritumu savācēju, kas ļauj norādīt mērķi par GC paužu ilgumu. Tomēr dažreiz, diezgan reti, atkritumu savācēju pauzes pārsniedz 50 ms, kas var radīt nepatiesu sistēmas darbības traucējumu atpazīšanu. Lai tas nenotiktu, koordinators neziņo par attālinātās mezgla darbības traucējumiem pie pirmā heartbeat ziņojuma zuduma, tikai tad, ja tiek zaudēti vairāki pēc kārtas. Tādējādi mums izdevās sasniegt koordinējošā mezgla darbības traucējumu atpazīšanu 200 ms.
Bet nav pietiekami ātri saprast, kurš mezgls ir pārstājis darboties. Jāveic kaut kas šajā sakarā.
Rezervēšana
Klasiskā shēma paredz, ka, ja rastos galvenā mezgla bojājums, tiek ieviests jauna mezgla vēlēšanu process, izmantojot vienu no algoritmiem. Tomēr šiem algoritmiem ir labi zināmas problēmas attiecībā uz konverģenci laikā un pašas vēlēšanu procesa ilgumu. Šādas papildu aizkavēšanās mums izdevās izvairīties, izmantojot koordināciju aizvietošanas shēmu pilnībā savienotā tīklā:
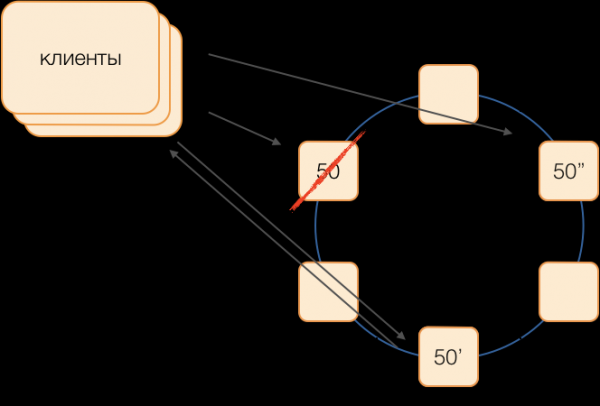
Pieņemsim, ka mēs vēlamies veikt darījumu grupā 50. Iepriekšnosakām aizvietošanas shēmu, tas ir, kuri mezgli izpildīs 50 grupas darījumus galvenā koordinatora neizdošanās gadījumā. Mūsu mērķis ir saglabāt sistēmas darbību datu centra atteikuma gadījumā. Nosakām, ka pirmais rezervē būs mezgls no cita datu centra, bet otrais rezervē — mezgls no trešā. Šī shēma tiek izvēlēta vienu reizi un nemainās, kamēr netiek mainīta klastera topoloģija, proti, kamēr pie tā neienāk jauni mezgli (kas notiek ļoti reti). Jaunā aktīvā galvenā mezgla izvēles kārtība bojājuma gadījumā vienmēr būs šāda: aktīvais meistars kļūs par pirmo rezervi, un, ja arī tas ir pārstājis darboties, tad par otro rezervi.
Šāda shēma ir drošāka par universālo algoritmu, jo jauna meistara aktivizācijai pietiek ar vecā bojājuma faktu noteikšanu.
Bet kā klienti sapratīs, kurš meistars šobrīd strādā? 50 ms ir par maz, lai izsūtītu informāciju tūkstošiem klientu. Pastāv iespēja, ka klients nosūta pieprasījumu par darījuma atvēršanu, vēl nezinot, ka šis meistars jau vairs nestrādā, un pieprasījums iestrēgst timeout laikā. Lai tam novērstu, klienti spekulatīvi nosūta pieprasījumus par darījuma atvēršanu uzreiz grupas meistaram un abiem viņa rezervēm, bet atbildēs uz šo pieprasījumu tikai tas, kurš šobrīd ir aktīvais meistars. Visi turpmākie sakari darījuma ietvaros tiks veikti tikai ar aktīvo meistaru.
Rezerves meistari saņemtos pieprasījumus par svešiem darījumiem ievieto nerakstīto darījumu rindā, kur tie tiek uzglabāti noteiktu laiku. Ja aktīvais meistars mirst, tad jaunais meistars apstrādā pieprasījumus par darījumu atvēršanu no savas rindas un atbild klientam. Ja klients jau paspējis atvērt darījumu ar veco meistaru, tad otrā atbilde tiek ignorēta (un, acīmredzot, šāds darījums netiks pabeigts un tiks atkārtots no klienta puses).
Kā darbojas darījums
Pieņemsim, ka klients nosūtīja koordinātora pieprasījumu par darījuma atvēršanu konkrētai entītijai ar konkrētu primāro atslēgu. Koordinators bloķē šo entītiju un ievieto to neatļauto bloķēšanas tabulā atmiņā. Ja nepieciešams, koordinators nolasa šo entītiju no krātuves un saglabā iegūtos datus koordinātora darījuma stāvoklī.
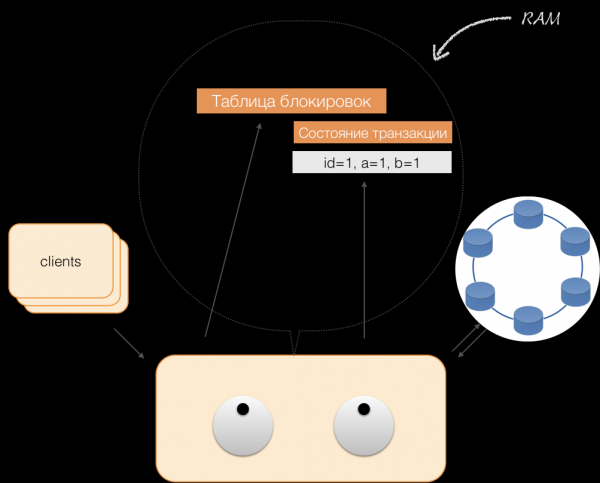
Kad klients vēlas mainīt datus darījumā, viņš nosūta koordinētājam pieprasījumu par entītijas modifikāciju, un tas ievieto jaunus datus darījumu stāvokļa tabulā atmiņā. Uz šī brīža ieraksts ir pabeigts — ieraksts krātuvē netiek veikts.
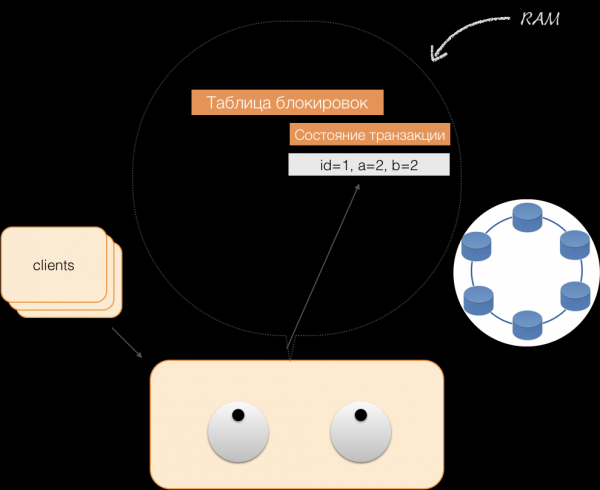
Kad klients pieprasa savus mainītos datus aktīvā darījuma ietvaros, koordinators rīkojas tā:
- ja ID jau ir darījumā, tad dati tiek ņemti no atmiņas;
- ja ID atmiņā nav, tad trūkstošie dati tiek nolasīti no mezglu krātuvēm, apvienoti ar jau esošajiem atmiņā un rezultāts tiek atdots klientam.
Tādējādi klients var izlasīt savus labojumus, bet citi klienti šos labojumus neredz, jo tie tiek glabāti tikai koordinātora atmiņā, mezglos Cassandra tos vēl nav.
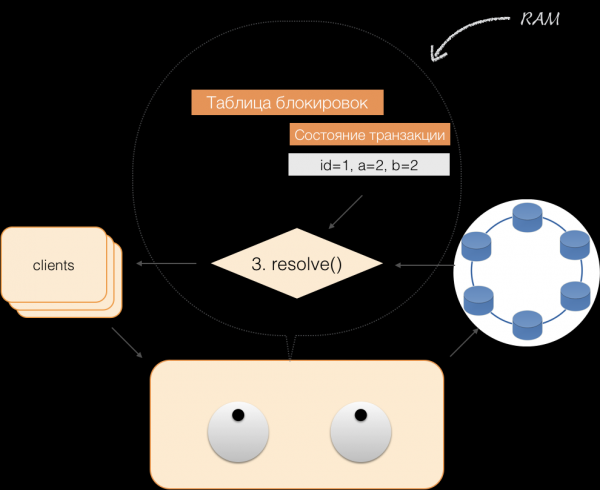
Kad klients nosūta commit, pakalpojuma atmiņā esošais stāvoklis tiek saglabāts koordinējošā komponentē logged batch formātā, un pēc tam šis logged batch tiek nosūtīts uz Cassandra krātuvēm. Krātuvēs tiek veikti visi nepieciešamie pasākumi, lai šis pakets tiktu atomiski (pilnībā) piemērots, un tās atgriež atbildi koordinējošajam komponentam, kurš atbrīvo bloķējumus un apstiprina darījuma veiksmīgumu klientam.
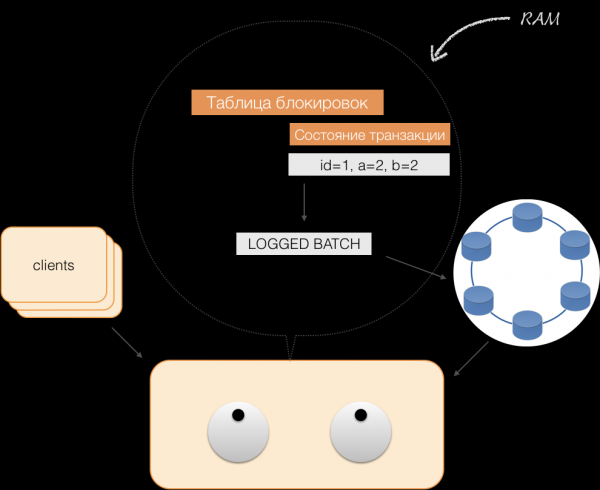
Koordinējošajam komponentam atcelšanai ir pietiekami atbrīvot atmiņu, kas aizņemta ar darījuma stāvokli.
Kā rezultātā iepriekš aprakstītajiem uzlabojumiem, mēs esam īstenojuši ACID principus:
- Atomaritāte. Tas nodrošina, ka nekāda darījuma daļa netiks sistēmā reģistrēta daļēji; visi tās apakšdarījumi tiks izpildīti vai netiks izpildīti vispār. Mums šis princips tiek ievērots, pateicoties logged batch Cassandra.
- Sakritība. Katrs veiksmīgs darījums pēc definīcijas reģistrē tikai atļautus rezultātus. Ja pēc darījuma atvēršanas un daļas operāciju izpildes tiek konstatēts, ka rezultāts nav atļauts, tiek veikta atcelšana.
- Izolācija. Veicot darījumu, paralēlie darījumi nedrīkst ietekmēt tā rezultātu. Konkurējošie darījumi ir izolēti ar pesimistiskām bloķēšanām koordinējošajā komponentē. Lasīšana ārpus darījuma ievēro izolācijas principus Read Committed līmenī.
- Noturība. Neatkarīgi no problēmām zemākajos līmeņos — elektrības traucējumi, aparatūras kļūmes — izmaiņām, kas veiktas veiksmīgi pabeigtā darījumā, jāpaliek saglabātām pēc sistēmas darbības atjaunošanas.
Lasīšana pēc indeksiem
Apskatīsim vienkāršu tabulu:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Tai ir ID (primārais atslēga), īpašnieks un izmaiņu datums. Jāveido ļoti vienkāršs vaicājums — izvēlēties datus pēc īpašnieka ar izmaiņu datumu "pēdējo 24 stundu laikā".
SELECT *
WHERE owner=?
AND modified>?
Lai šāds vaicājums ātri izpildītos, klasiskajā SQL DB jāizveido indekss kolonnām (owner, modified). Mēs varam to izdarīt diezgan vienkārši, jo tagad mums ir ACID garantijas!
Indeksi C*One
Ir sākotnējā tabula ar fotogrāfijām, kurā ieraksta ID ir primārā atslēga.
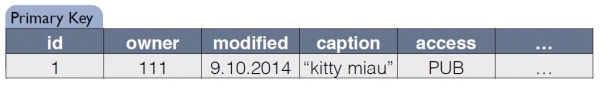
Indeksam C*One izveido jaunu tabulu, kas ir sākotnējās tabulas kopija. Atslēga sakrīt ar indeksu izteiksmēm, turklāt tā ietver arī ieraksta primāro atslēgu no sākotnējās tabulas:
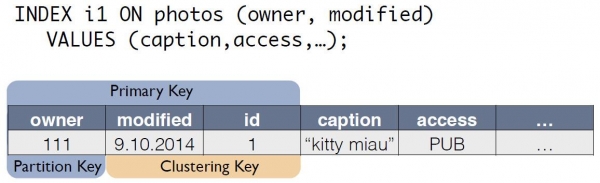
Tagad pieprasījumu par "īpašnieku pēdējās dienas laikā" var pārrakstīt kā atlasi no citas tabulas:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Datu saderību sākotnējā tabulā photos un indeksu i1 automātiski uztur koordinatora. Balstoties tikai uz datu shēmu, saņemot izmaiņas, koordinatora ģenerē un atceras izmaiņas ne tikai galvenajā tabulā, bet arī kopiju izmaiņas. Nav nepieciešamas papildu darbības ar indeksa tabulu, žurnāli netiek lasīti, bloķēšana netiek izmantota. Tas nozīmē, ka indeksu pievienošana gandrīz nepatērē resursus un praktiski neietekmē modificēšanas ātrumu.
Izmantojot ACID, mēs spējam realizēt indeksus "kā SQL". Tie nodrošina saderību, var tikt mērogoti, darbojas ātri, var būt sastatāmi un iebūvēti CQL vaicājumu valodā. Lai atbalstītu indeksus, nav nepieciešams veikt izmaiņas lietojumprogrammas kodā. Viss ir vienkārši, kā SQL. Un kas ir vissvarīgākais, indeksi neietekmē izmaiņu izpildes ātrumu sākotnējā darījumu tabulā.
Kas izdevās
Mēs izstrādājām C*One pirms trim gadiem un uzsākām to ražošanā.
Ko mēs esam ieguvuši beigās? Apskatīsim to uz fotoattēlu apstrādes un uzglabāšanas apakšsistēmas piemēra, kas ir viens no vissvarīgākajiem datu veidiem sociālajā tīklā. Runājam nevis par pašu fotoattēlu ķermeņiem, bet par visdažādāko meta informāciju. Pašlaik "Klasesbiedros" ir ap 20 miljardi šādu ierakstu, sistēma apstrādā 80 tūkstošus lasīšanas pieprasījumu sekundē, līdz 8 tūkstošiem ACID darījumu sekundē, kas saistīti ar datu modificēšanu.
Kad mēs izmantojām SQL ar replikācijas faktoru = 1 (bet RAID 10), fotoattēlu meta informācija tika uzglabāta augstas pieejamības klasterī no 32 mašīnām ar Microsoft SQL Server (plus 11 rezerves). Tika piešķirtas arī 10 serveri dublējumu glabāšanai. Kopā 50 dārgas mašīnas. Šajā procesā sistēma darbojās nominālās slodzes apstākļos, bez rezeres.
Pēc migrācijas uz jauno sistēmu mēs ieguvām replikācijas faktoru = 3 — pa kopijai katrā datu centrā. Sistēma sastāv no 63 Cassandra krātuves mezgliem un 6 koordinatora mašīnām, kopā 69 serveri. Bet šīs mašīnas ir ievērojami lētākas, to kopējā cena ir ap 30 % no SQL sistēmas izmaksām. Šajā laikā slodze saglabājas pie 30 %.
Arī kavējumi ir samazinājušies, ieviešot C*One: SQL rakstīšanas operācija aizņēma apmēram 4,5 ms. C*One — apmēram 1,6 ms. Transakcijas ilgums vidēji ir mazāks par 40 ms, komits tiek veikts 2 ms laikā, lasīšanas un rakstīšanas ilgums vidēji ir 2 ms. 99. percentils ir tikai 3-3,1 ms, laika pārsniegumu skaits samazinājies simt reizes — viss, pateicoties plašai spekulāciju pielietošanai.
Uz doto brīdi no ekspluatācijas ir izņemta lielākā daļa SQL Server mezglu, jauni produkti tiek izstrādāti tikai, izmantojot C*One. Mēs esam pielāgojuši C*One, lai tas darbotos mūsu mākoņos. , kas ļāva paātrināt jaunu klasteru izvēršanu, vienkāršot konfigurāciju un automatizēt ekspluatāciju. Bez avota koda to izdarīt būtu daudz grūtāk un sarežģītāk.
Patlaban mēs strādājam pie citu mūsu glabātuves pārcelšanas uz mākoni — bet tā jau ir pavisam cita stāsts.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish