

Sveiki, Habr!
Pēc Ziemassvētku brīvdienām mēs atjaunojām katastrofu izturīgu mākoņu uz divām vietām. Šodien pastāstīsim, kā tas ir iekārtots, un parādīsim, kas notiek ar klientu virtuālajām mašīnām, ja atsevišķi klastera elementi neizdodas vai vesela vieta sabrūk (spoilers – ar viņiem viss kārtībā).
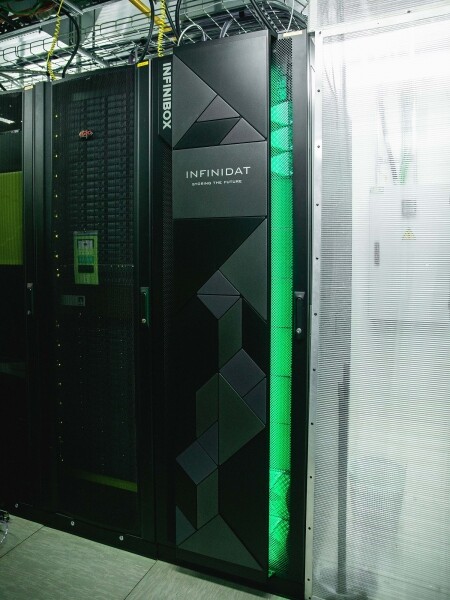
Katastrofu izturīgs mākoņa SĀDOSTOSTEDE pie OST vietas.
Kas iekšā
Klāsterī atrodas Cisco UCS serveri ar VMware ESXi hipervizoru, divi INFINIDAT InfiniBox F2240 SĀDOSTOSTEDE, Cisco Nexus tīkla aprīkojums, kā arī Brocade SAN slēdži. Klāsteris ir izkliedēts uz divām vietām – OST un NORD, tādējādi katrā datu centrā ir identisks aprīkojuma kopums. Šis ir tas, kas to padara katastrofu izturīgu.
Viens un tajā pašā vietā galvenie elementi arī ir dubultoti (hosti, SAN slēdži, tīkli).
Divas vietas ir savienotas ar atsevišķiem optiskās šķiedras maršrutiem, kas arī ir rezervēti.
Daži vārdi par SĀDOSTOSTEDE. Pirmajā katastrofu izturīgā mākoņa variantā mēs būvējam uz NetApp. Šeit izvēlējāmies INFINIDAT, un šeit ir iemesli:
- Active-Active replikācijas opcija. Tā ļauj virtuālajai mašīnai palikt funkcionālā stāvoklī pat pilna atsevišķās SĀDOSTOSTEDE neveiksmē. Par replikāciju pastāstīšu detalizētāk vēlāk.
- Trīs disku kontrolieri, lai uzlabotu sistēmas izturību. Parasti ir divi.
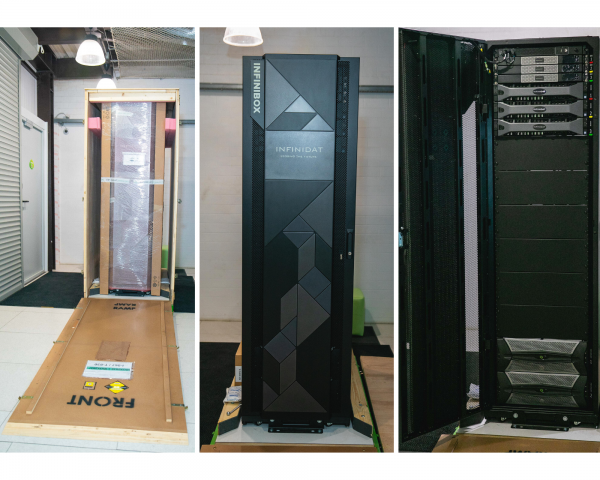
- Gatava risinājuma. Pie mums ieradās jau salikta stenda, kuru tikai jāpiešķir tīklam un jāiestata.
- Rūpīga tehniskā atbalsta komanda. INFINIDAT inženieri nepārtraukti analizē SĀDOSTOSTEDE žurnālus un notikumus, instalē jaunas versijas operētājsistēmā, palīdz ar iestatījumiem.
Šeit ir nedaudz bildes no unpacking’a:
Kā tas darbojas
Mākoņi jau ir katastrofu izturīgi sevī. Tas aizsargā klientu no individuāliem aparatūras un programmatūras neveiksmēm. Katrastrofu izturīgs mākoņi palīdzēs aizsargāt pret masveida traucējumiem vienas vietas ietvaros: piemēram, SĀDOSTOSTEDE (vai SDS klastera) kļūme, kas notiek diezgan bieži 🙂 , masveida kļūdas glabāšanas tīklā un citiem. Un pats galvenais: šāds mākonis glābs, kad visa vieta kļūst nepieejama ugunsgrēka, blackout, reideru ieņemšanas, vai svešzemju iekšlietu dēļ.
Visos šajos gadījumos klientu virtuālās mašīnas turpinās strādāt, un šeit ir iemesli.
Klastera shēma ir izveidota tā, lai jebkurš ESXi viesis ar klientu virtuālajām mašīnām varētu piekļūt jebkurai no divām SĶD. Ja SĶD vietā OST iziet no ierindas, virtuālās mašīnas turpinās darboties: viesi, uz kuriem tās darbojas, pieprasīs datus no SĶD NORD.
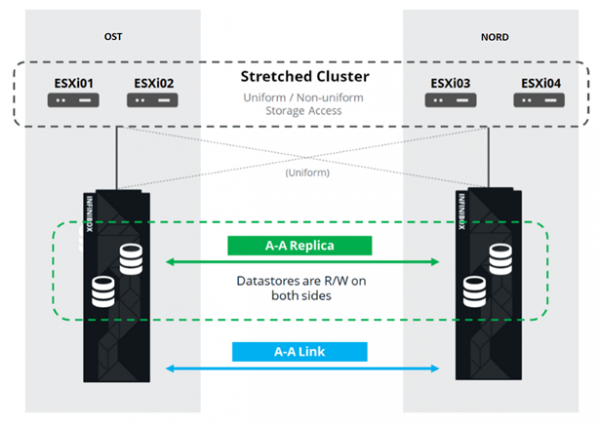
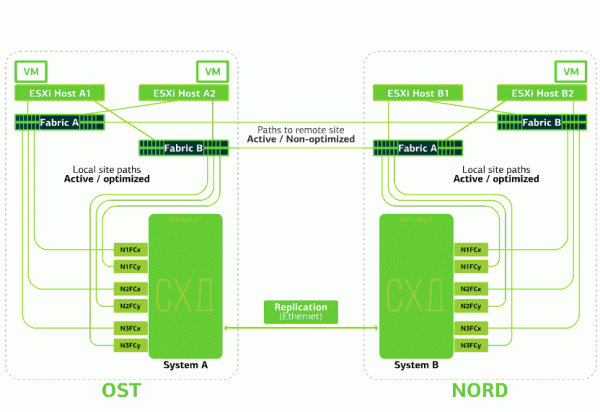
Tā izskatās pieslēguma shēma klasterī.
Tas ir iespējams, pateicoties tam, ka starp divu vietu SAN fabrikām ir iestatīts Inter-Switch Link: SAN slēdzis Fabric A OST ir savienots ar SAN slēdzi Fabric A NORD, un līdzīgi arī SAN slēdžiem Fabric B.
Lai visām šīm sarežģītajām SAN fabrikām būtu jēga, starp abām SĶD ir iestatīta Aktīva-Aktīva replikācija: informācija praktiski vienlaicīgi tiek ierakstīta lokālajā un attālajā SĶD, RPO=0. Tādējādi uz vienas SĶD ir oriģinālie dati, uz otras - to replikācija. Dati tiek replikēti līmenī, kas attiecas uz SĶD apjomu, un uz tiem tiek glabāti VM dati (tās diski, konfigurācijas fails, swap fails utt.).
ESXi viesis redz galveno apjomu un tā replikātu kā vienu diska ierīci (Storage Device). No ESXi viesa uz katru diska ierīci ir 24 ceļi:
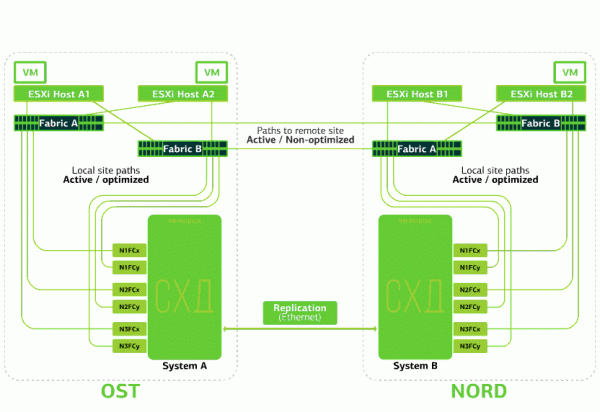
12 ceļi savieno to ar lokālo SĶD (optimālie ceļi), bet atlikušais 12 - ar attālo (neoptimālie ceļi). Parastā situācijā ESXi piekļūst datiem lokālajā SĶD, izmantojot “optimālos” ceļus. Kad šī SĶD iziet no ierindas, ESXi zaudē optimālos ceļus un pārslēdzas uz “neoptimālajiem”. Šādi tas izskatās shēmā.
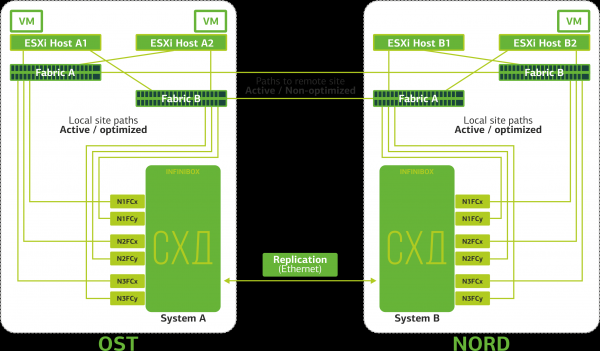
Katrastropu izturīga klastera shēma.
Visas klientu tīklu līnijas ir savienotas uz abām vietām caur kopēju tīkla fabriku. Katru vietu pārvalda Provider Edge (PE), kurā tiek terminēti klienta tīkli. PE ir apvienoti kopējā klasterī. Ja PE iziet no ierindas vienā vietā, viss satiksme tiek pārvirzīta uz otro vietu. Pateicoties tam, virtuālās mašīnas no vietas, kas palikusi bez PE, paliek pieejamas tīklā klientam.
Tagad aplūkosim, kas notiks ar klienta virtuālajām mašīnām dažādu avāriju gadījumā. Sāksim ar vieglākajiem variantiem un beigsim ar visnopietnākajiem - visas vietas avāriju. Piemēra galvenā vieta būs OST, bet rezerves, ar datu replikām, - NORD.
Kas notiek ar klienta virtuālo mašīnu, ja…
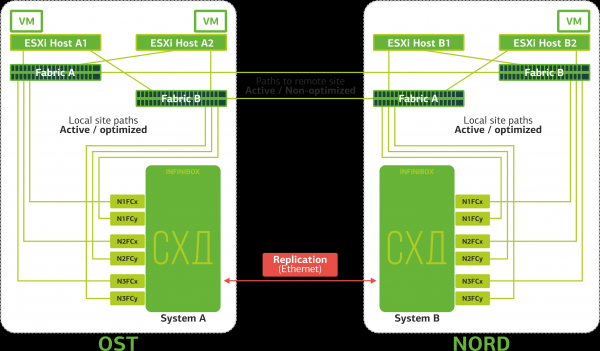
Aiziet no ierindas Replikācijas saite. Replikācija starp divu vietu SĶD tiek pārtraukta.
ESXi darbos tikai ar lokālajiem diska ierīcēm (optimizētajos ceļos).
Virtuālās mašīnas turpina darboties.
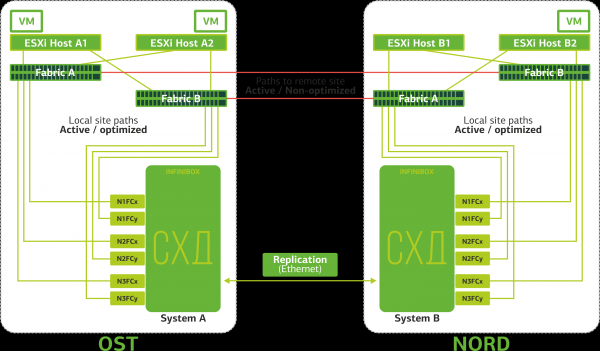
Notiek ISL (Inter-Switch Link) atslēgšana. Gadījums ir maz ticams. Maksimums, kāds varētu notikt, ir, ja kāds traks ekskavators pārrakstītu vairākas optiskās līnijas, kas iet pa neatkarīgiem ceļiem un ir pievienotas laukumiem caur dažādiem ievadiem. Taču tomēr. Šajā gadījumā ESXi hosti zaudē pusi ceļu un var piekļūt tikai savām lokālajām SCSI. Replikas tiek izveidotas, bet hosti tām nevar piekļūt.
Virtuālās mašīnas darbojas normāli.
Izbeidzas SAN slēdzis vienā no laukumiem. ESXi hosti zaudē daļu ceļu uz SCSI. Šajā gadījumā hosti laukumā, kur slēdzis izbeidz darbu, strādās tikai caur vienu savu HBA.
Virtuālās mašīnas šajā gadījumā turpina darboties normāli.
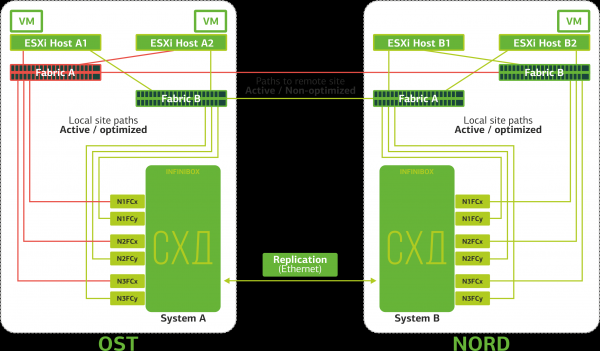
Visi SAN slēdži vienā no laukumiem ir neaktīvi. Pieņemot, ka tāda nelaime notikusi laukā OST. Šajā gadījumā ESXi hosti šajā laukā zaudē visus ceļus uz savām diska ierīcēm. Iestājas standarta VMware vSphere HA mehānisms: viņš restartēs visas virtuālās mašīnas laukā OST NORD’ā maksimums 140 sekunžu laikā.
Virtuālās mašīnas, kas darbojas uz laukuma NORD hostiem, darbojas normāli.
Izbeidzas ESXi hosti vienā laukā. Šeit atkal darbojas vSphere HA mehānisms: virtuālās mašīnas no neaktīvā hosta tiek restartētas uz citiem hostiem – vai nu tajā pašā laukā, vai arī attālinātā laukā. Virtuālās mašīnas restartēšanas laiks – līdz 1 minūtei.
Ja visi ESXi hosti laukā OST tiek neaktīvi, šajā gadījumā nav variantu: VM tiek restartētas uz citu. Restartēšanas laiks ir tas pats.
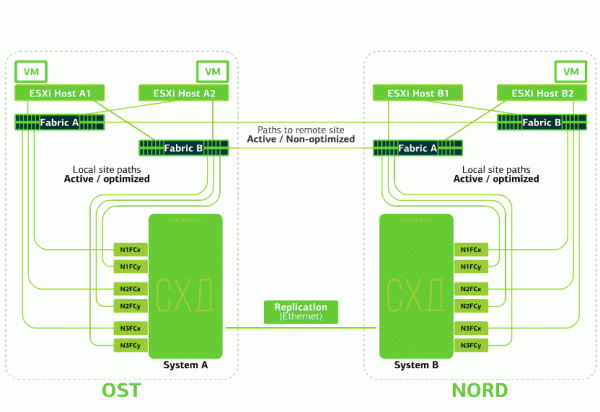
Izbeidzas SCSI vienā laukā. Pieņemot, ka SCSI izbeidz darbu laukā OST. Tad ESXi hosti laukā OST pāriet uz darbu ar replikām SCSI NORD’ā. Pēc nedarbīgās SCSI atgriešanās darbā notiks spēka replikācija, ESXi hosti OST atkal sāks piekļūt lokālajai SCSI.
Virtuālās mašīnas visu šo laiku strādā normāli.
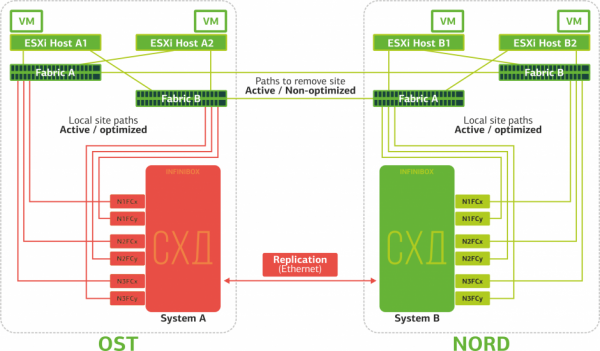
Izbeidzas viens no laukiem. Šajā gadījumā visas virtuālās mašīnas tiks restartētas uz rezerves laukumu caur vSphere HA mehānismu. Virtuālās mašīnas restartēšanas laiks ir 140 sekundes. Tajā pašā laikā visas virtuālās mašīnas tīkla iestatījumi tiks saglabāti, un tās paliek pieejamas klientam caur tīklu.
Lai nodrošinātu, ka mašīnu pārstartēšana rezerves vietnē notiek bez problēmām, katra vietne ir aizpildīta tikai uz pusi. Otrā puse ir rezerves variants gadījumam, ja visas virtuālās mašīnas jāpārvieto no otrās, cietušās vietnes.
No šādām atteikšanās situācijām pasargā katastrofu izturīgs mākonis, kas balstīts uz diviem datu centriem.
Šī bauda nav lēta, jo, papildus galvenajiem resursiem, ir nepieciešama rezerve otrajā vietnē. Tādēļ šādā mākoņī tiek izvietoti biznesam kritiski pakalpojumi, kuru ilgs dīkstāves periods nes lielus finansiālus un reputācijas zaudējumus, vai ja informācijas sistēmai ir prasības attiecībā uz katastrofu izturību no regulatoriem vai uzņēmuma iekšējiem noteikumiem.
Avoti:
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish