

Datu zinātne sākumam
1. Noskaņojuma analīze (Teksta analīze, lai noteiktu noskaņojumus)
Apskatiet pilnu Datu zinātnes projekta realizāciju, izmantojot avota kodu — .
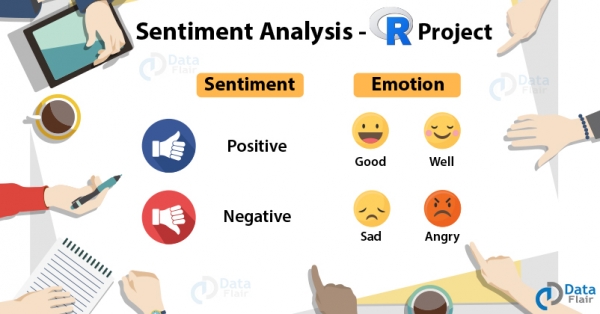
Noskaņojuma analīze ir vārdu analīze, lai noteiktu noskaņojumus un viedokļus, kas var būt pozitīvi vai negatīvi. Tas ir klasifikācijas veids, kurā klases var būt bināras (pozitīvas un negatīvas) vai daudzveidīgas (laimīgas, dusmīgas, skumjas, nepatīkamas...). Mēs realizēsim šo Datu zinātnes projektu R valodā un izmantosim datu kopu no pakotnes "janeaustenR". Mēs izmantosim vispārējus vārdnīcas, piemēram, AFINN, bing un loughran, veiksim iekšējo savienojumu, un beigās izveidosim vārdu mākoni, lai attēlotu rezultātu.
Valoda: R
Datu kopas / Pakotne: janeaustenR
Raksts tulkots ar EDISON Software atbalstu, kas , kā arī .
2. Viltus ziņu atklāšana (Fake News Detection)
Iepazīstieties ar savām prasmēm, strādājot pie Datu zinātnes projekta sākumam — .
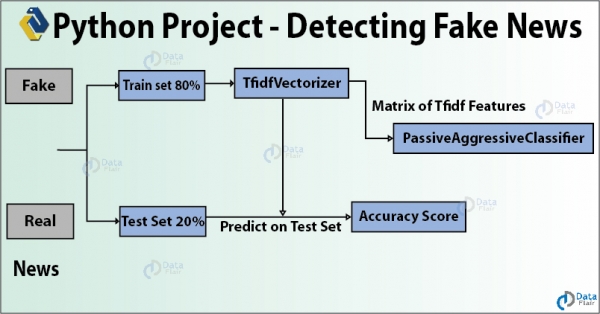
Viltus ziņas ir nepatiesa informācija, kas tiek izplatīta caur sociālajiem tīkliem un citiem tīmekļa plašsaziņas līdzekļiem, lai sasniegtu politiskus mērķus. Šajā Datu zinātnes projekta idejā mēs izmantosim Python, lai izveidotu modeli, kas precīzi noteiktu, vai ziņa ir īsta vai viltota. Mēs izveidosim TfidfVectorizer un izmantosim PassiveAggressiveClassifier, lai klasificētu ziņas par "īstām" un "viltotām". Mēs izmantosim datu kopu ar 7796 × 4 formātu un veiksim visu Jupyter Lab.
Valoda: Python
Datu kopas / Pakotne: news.csv
3. Parkinsona slimības atklāšana (Detecting Parkinson’s Disease)
Virzieties uz priekšu, strādājot pie Datu zinātnes projekta idejas — .
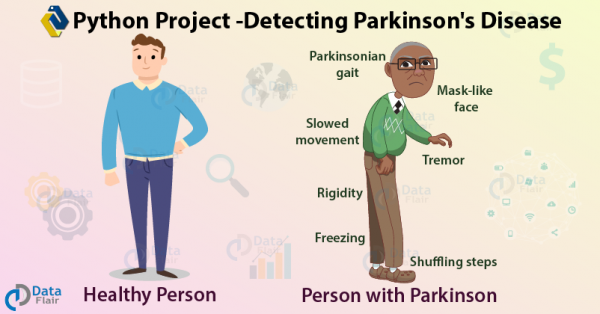
Mēs esam sākuši izmantot Datu zinātni, lai uzlabotu veselības aprūpi un pakalpojumus — ja mēs varam prognozēt slimību agrīnā stadijā, mums būs daudz priekšrocību. Tātad, šajā Datu zinātnes projekta idejā mēs iemācīsimies noteikt Parkinsona slimību, izmantojot Python. Tā ir neirodeģeneratīva, progresējoša centrālās nervu sistēmas slimība, kas ietekmē kustību un izraisa trīci un stīvumu. Tā ietekmē dopamīnu ražojošos neuronus smadzenēs, un katru gadu tā skar vairāk nekā 1 miljonu cilvēku Indijā.
Valoda: Python
Datu kopas / Pakotne: UCI ML Parkinsons datu kopums
Vidējā grūtības pakāpe Datu zinātnes projektiem
4. Runas emociju atpazīšana (Speech Emotion Recognition)
Iepazīstieties ar pilnīgu Data Science projekta piemēra realizāciju — .
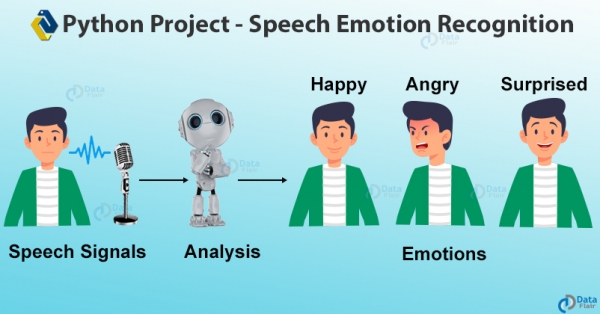
Tagad mēs iemācīsimies izmantot dažādas bibliotēkas. Šis Data Science projekts izmanto librosa, lai veiktu balss atpazīšanu. SER ir process, kas nosaka cilvēku emocijas un afektīvās stāvokļus pēc balss. Tā kā mēs izmatojam toni un toņu augstumu, lai izteiktu emocijas ar balsi, SER ir svarīgs. Tomēr, ņemot vērā emociju subjektivitāti, skaņas anotācija ir sarežģīta uzdevums. Mēs izmantosim funkcijas mfcc, chroma un mel un izmantosim RAVDESS datu kopu, lai atpazītu emocijas. Mēs izveidosim MLPC klasifikatoru šim modelim.
Valoda: Python
Datu kopas / Pakotne: RAVDESS datu kopums
5. Dzimuma un vecuma noteikšana (Gender and Age Detection)
Pārsteidziet darba devējus ar jauno Data Science projektu — .
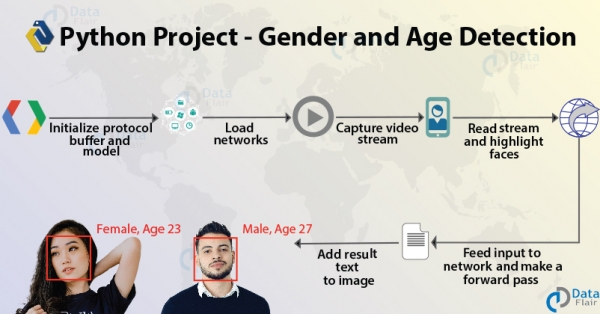
Tas ir interesants Data Science projekts ar Python. Izmantojot tikai vienu attēlu, jūs iemācīsieties paredzēt cilvēka dzimumu un vecumu. Šajā projektā jūs iepazīstināsim ar datorredzi un tās principiem. Mēs uzbūvēsim un izmantosim modeli, ko apmācījusi Tal Hassner un Gil Levi Adience datu kopai. Ceļojuma laikā mēs izmantosim dažus .pb, .pbtxt, .prototxt un .caffemodel failus.
Valoda: Python
Datu kopas / Pakotne: Adience
6. Uber datu analīze (Uber Data Analysis)
Paskatieties pilnu Data Science projekta realizāciju ar avota kodu — .
Tas ir datu vizualizācijas projekts ar ggplot2, kurā mēs izmantosim R un tā bibliotēkas, analizējot dažādus parametrus. Mēs izmantosim Uber Pickups datu kopu Ņujorkā un veidosim vizualizācijas dažādiem gada laikiem. Tas noregulē laika ietekmi uz klientu braucieniem.
Valoda: R
Datu kopas / Pakotne: Uber Pickups in New York City datu kopums
7. Vadītāja miegainības noteikšana (Driver Drowsiness detection)
Uzlabojiet savas prasmes, strādājot pie Top Data Science projekta — .
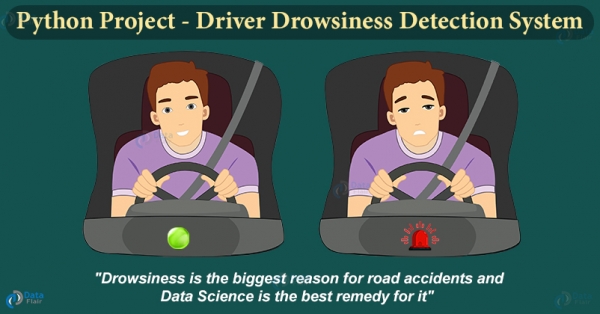
Miegains brauciens ir ārkārtīgi bīstams, un katru gadu notiek ap tūkstoš negadījumu, kad vadītāji aizmieg brauciena laikā. Šajā Python projektā mēs izveidosim sistēmu, kas spēs noteikt miegainus vadītājus un brīdināt viņus ar skaņas signālu.
Šis projekts tiek īstenots, izmantojot Keras un OpenCV. Mēs izmantosim OpenCV, lai atklātu sejas un acis, bet, izmantojot Keras, mēs klasificēsim acu stāvokli (Atvērta vai Aizvērta), izmantojot dziļo neira tīklu metodes.
8. Čatbots
Izveidojiet čatbotu, izmantojot Python, un speriet soli uz priekšu savā karjerā — .
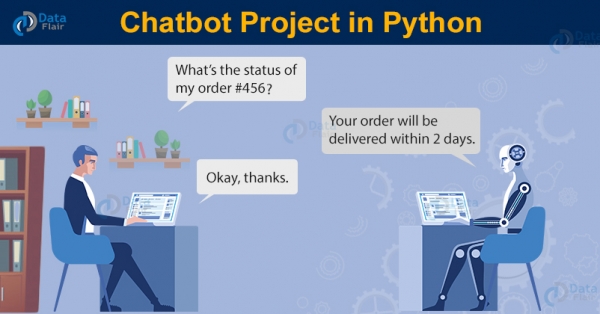
Čatboti ir neatņemama daļa no biznesa. Daudziem uzņēmumiem ir jāsniedz pakalpojumi saviem klientiem, un to apkalpošanai ir nepieciešama liela darba spēka, laika un pūļu izlietojums. Čatboti var automatizēt lielāko daļu mijiedarbības ar klientiem, atbildot uz dažiem bieži uzdotajiem jautājumiem. Galvenokārt ir divi čatbotu veidi: specifiskā joma un atvērta joma. Specifiskās jomas čatbots bieži tiek izmantots konkrētas problēmas risināšanai. Tāpēc jūs to jāpielāgo efektīvai darbībai jūsu jomā. Atvērtās jomas čatbotiem var uzdot jebkurus jautājumus, tāpēc to apmācībai ir nepieciešami milzīgi dati.
Datu kopums: Intents json fails
Valoda: Python
Augstas klases datu zinātnes projekti
9. Attēla aprakstu ģenerators
Pārbaudiet pilnu projekta realizāciju ar avota kodu — .
Aprakstīt, kas attēlā ir, cilvēkiem ir vienkārša, bet datoriem attēls ir tikai skaitļu kopums, kas attēlo katra pikseļa krāsas vērtību. Tas ir grūts uzdevums datoriem. Saprast, kas atrodas attēlā, un pēc tam izveidot aprakstu dabiskajā valodā (piemēram, angļu valodā) ir cits grūts uzdevums. Šis projekts izmanto dziļās mācīšanās metodes, kur mēs realizēsim konvolūcijas neira tīklu (CNN) ar atkārtotu neira tīklu (LSTM), lai izveidotu attēla aprakstu ģeneratoru.
Datu kopums: Flickr 8K
Valoda: Python
Rāmis: Keras
10. Kredītkartes krāpšanas atklāšana
Izdariet visu iespējamo, strādājot pie datu zinātnes projekta idejas — .
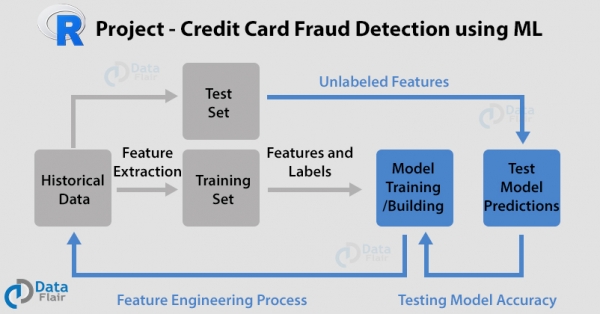
Līdz šim jūs esat sākuši saprast metodes un koncepcijas. Pārslēgsimies pie dažiem augstākajiem datu zinātnes projektiem. Šajā projektā mēs izmantosim R valodu ar tādiem algoritmiem kā , loģistikas regresija, mākslīgie neironu tīkli un gradienta palielināšanas klasifikators. Mēs izmantosim darījumu ar kartēm datu kopu, lai klasificētu kredītkaršu darījumus par krāpnieciskiem un īstiem. Mēs izvēlēsimies dažādus modeļus un izveidosim veiktspējas līknes.
Valoda: R
Datu kopas / Pakotne: Kartes darījumu datu kopas
11. Filmu ieteikumu sistēma
Iepazīstieties ar labākā Data Science projekta realizāciju ar Avota kodu —
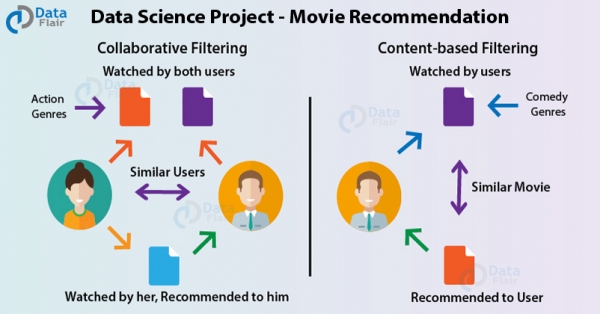
Šajā Data Science projektā mēs izmantosim R, lai veiktu filmu ieteikumus, izmantojot mašīnmācīšanos. Ieteikumu sistēma piedāvā lietotājiem ieteikumus, balstoties uz citu lietotāju izvēlēm un skatīšanās vēsturi. Ja A un B patīk "Mājās vieni", bet B mīl "Meitenes no Mean", tad A varētu tikt ieteikts — viņam tas varētu patikt. Tas ļauj klientiem mijiedarboties ar platformu.
Valoda: R
Datu kopas / Pakotne: MovieLens datu kopa
12. Klientu segmentācija
Aizraujiet darba devējus ar Data Science projekta palīdzību (ietverot avota kodu) — .
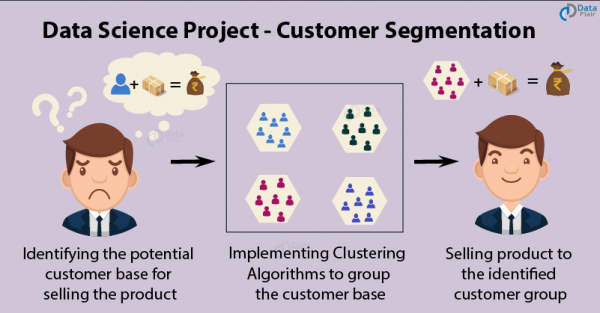
Klientu segmentācija ir populāra . Izmantojot klasterizāciju, uzņēmumi nosaka klientu segmentus, ar kuriem strādāt ar potenciālo lietotāju bāzi. Viņi sadala klientus grupās, pamatojoties uz kopīgām iezīmēm, piemēram, dzimumu, vecumu, interesēm un izdevumu paradumiem, lai efektīvi tirgotu sava produkta katrai grupai. Mēs izmantosim , kā arī vizualizēsim sadalījumu pēc dzimuma un vecuma. Tad mēs analizēsim viņu gada ienākumus un izdevumu līmeni.
Valoda: R
Datu kopas / Pakotne: Mall_Customers datu kopa
13. Krūts vēža klasifikācija
Izskatiet pilnu Data Science projekta realizāciju Python valodā — .
Atgriežoties pie medicīnas datu zinātnes ieguldījuma, mācīsimies atklāt krūts vēzi, izmantojot Python. Mēs izmantosim IDC_regular datu kopu, lai identificētu invazīvo ductal karcinomu, visizplatītāko krūts vēža formu. Tā attīstās piena kanālos, ieaugot piena dziedzeru saistaudu vai tauku audos ārpus kanāla. Šajā datu vākšanas zinātniskā projekta idejā mēs izmantosim un Keras bibliotēku klasifikācijai.
Valoda: Python
Datu kopas / Pakotne: IDC_regular
14. Ceļu zīmju atpazīšana
Lai sasniegtu precizitāti automašīnas autonomajā braukšanas tehnoloģijā, izmantojot datu zinātnes projektu par ar atvērtā koda risinājumiem.
Ceļu zīmes un ceļu satiksmes noteikumi ir ļoti svarīgi ikvienam autovadītājam, lai izvairītos no negadījumiem. Lai ievērotu noteikumu, vispirms jāizprot, kā izskatās ceļu zīme. Cilvēkam jāiemācās visas ceļu zīmes, pirms viņam tiek dotas tiesības vadīt jebkuru transportlīdzekli. Tomēr šobrīd autonoma transportlīdzekļu skaits pieaug, un tuvākajā nākotnē cilvēks vairs nevadīs automašīnu pats. Projektā “Ceļu zīmju atpazīšana” jūs uzzināsiet, kā programma var atpazīt ceļu zīmju tipu, pieņemot attēlu kā ieejas signālu. Vācijas ceļu zīmju atpazīšanas datu kopa (GTSRB) tiek izmantota, lai izveidotu dziļo neironu tīklu ceļu zīmes klases atpazīšanai. Mēs arī izveidojam vienkāršu grafisko saskarni mijiedarbībai ar lietojumprogrammu.
Valoda: Python
Datu kopums: GTSRB (Vācijas ceļu zīmju atpazīšanas novērtējums)
Lasīt vairāk
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish